Compare commits
| Author | SHA1 | Date | |
|---|---|---|---|
 ascoders |
53ae9e077e | ||
|
ascoders
|
30bdcf13dd | ||
|
黄子毅
|
12b1b02539 | ||
|
黄子毅
|
2a92487a5e | ||
|
ascoders
|
b6487f8754 | ||
|
vivaxy
|
7a8e1b25dd | ||
|
vivaxy
|
44683fa1dc | ||
|
ascoders
|
3a4b82bc76 | ||
|
ascoders
|
4f2ed7b3cb | ||
|
黄子毅
|
a72795b099 | ||
|
ascoders
|
dea2acc384 | ||
|
ascoders
|
74f539cc34 | ||
|
程方
|
1947b9c08c | ||
|
黄子毅
|
e84c85cc1d | ||
|
ascoders
|
170c0f4525 | ||
|
ascoders
|
c836848228 | ||
|
曾浩
|
7b87d5c3c4 | ||
|
黄子毅
|
add5bdd01e | ||
|
曾浩
|
0633764a44 | ||
|
黄子毅
|
fcc183d523 | ||
|
ascoders
|
627db8a249 | ||
|
ascoders
|
b41530b37c | ||
|
ascoders
|
2062b652dd | ||
|
黄子毅
|
365997863e | ||
|
黄子毅
|
ab6978da4a | ||
|
leoxu
|
f37d496f1b | ||
|
Kerminate
|
3bf34602b4 | ||
|
ascoders
|
274ffc0a9f | ||
|
ascoders
|
72e8b69dd7 | ||
|
黄子毅
|
62ac1d76b9 | ||
|
leoxu
|
e537efe7bd | ||
|
ascoders
|
f1871f59e5 | ||
|
ascoders
|
5d08eabde3 | ||
|
黄子毅
|
7e79c60a12 | ||
|
leoxu
|
9c051f6ab5 | ||
|
ascoders
|
065fab1546 | ||
|
ascoders
|
88cd38685d | ||
|
黄子毅
|
7de3c77c3b | ||
|
Cong Zhang
|
09978602c0 | ||
|
ascoders
|
fcb42f2dcf | ||
|
ascoders
|
0ef3cf16a9 | ||
|
黄子毅
|
baf666dbf8 | ||
|
ludy.hxy
|
74f1884f78 | ||
|
黄子毅
|
4f815df5ab | ||
|
Kerminate
|
35a8ee0a9e | ||
|
ascoders
|
37fbb981d4 | ||
|
ascoders
|
1cd6722352 | ||
|
ascoders
|
e14a9e8f9b | ||
|
黄子毅
|
f3e2892982 | ||
|
kaiye
|
bd8c58a938 |
@@ -164,11 +164,11 @@ async function mount() {
|
||||
|
||||
```javascript
|
||||
async function mount() {
|
||||
const result = await Promise.all(
|
||||
const result = await Promise.all([
|
||||
fetch('a.json'),
|
||||
fetch('b.json'),
|
||||
fetch('c.json')
|
||||
);
|
||||
]);
|
||||
|
||||
render(...result);
|
||||
}
|
||||
@@ -96,7 +96,7 @@
|
||||
|
||||
最后考察候选人的发展潜力与工作态度,我们一般通过询问简单的算法问题,进一步了解候选人是否对技术真正感兴趣,而不只是对前端工程感兴趣。同时,算法问题也考察候选人解决抽象问题的能力,或者让候选人设计一个组件,通过对组件需求的不断升级,考察候选人是否能及时给出解决方案。
|
||||
|
||||
最后时工作态度,首先会考察人品,对不懂的知识点装懂是违背诚信的行为,任何团队都不会要的。同时,**不正视自己技术存在的盲点,将是技术发展的最大阻碍**。不过这里也不怕被候选人套路,如果全部都回答不懂那也不用考虑了。
|
||||
最后是工作态度,首先会考察人品,对不懂的知识点装懂是违背诚信的行为,任何团队都不会要的。同时,**不正视自己技术存在的盲点,将是技术发展的最大阻碍**。不过这里也不怕被候选人套路,如果全部都回答不懂那也不用考虑了。
|
||||
|
||||
# 3 总结
|
||||
|
||||
@@ -98,7 +98,7 @@ foo();
|
||||
|
||||
我们谈到了一些意外情况下定义的全局变量, 代码中也有一些我们明确定义的全局变量. 如果使用这些全局变量用来暂存大量的数据, 记得在使用后, 对其重新赋值为 null.
|
||||
#### 2. 未销毁的定时器和回调函数
|
||||
在很多库中, 如果使用了观察着模式, 都会提供回调方法, 来调用一些回调函数. 要记得回收这些回调函数. 举一个 setInterval的例子.
|
||||
在很多库中, 如果使用了观察者模式, 都会提供回调方法, 来调用一些回调函数. 要记得回收这些回调函数. 举一个 setInterval的例子.
|
||||
```javascript
|
||||
var serverData = loadData();
|
||||
setInterval(function() {
|
||||
@@ -174,4 +174,4 @@ JS 这类高级语言,隐藏了内存管理功能。但无论开发人员是
|
||||
|
||||
|
||||
|
||||
参考文章: [MDN 的内存管理介绍](https://developer.mozilla.org/zh-CN/docs/Web/JavaScript/Memory_Management)
|
||||
参考文章: [MDN 的内存管理介绍](https://developer.mozilla.org/zh-CN/docs/Web/JavaScript/Memory_Management)
|
||||
@@ -87,7 +87,7 @@ function getTokenBlockComment(restStr: string) {
|
||||
```typescript
|
||||
while (sqlStr) {
|
||||
token =
|
||||
getTokenWhitespace(sqlStr, token) | getTokenBlockComment(sqlStr, token);
|
||||
getTokenWhitespace(sqlStr, token) || getTokenBlockComment(sqlStr, token);
|
||||
|
||||
sqlStr = sqlStr.substring(token.value.length);
|
||||
|
||||
@@ -2,7 +2,7 @@
|
||||
|
||||
重回 “手写 SQL 编辑器” 系列。这次介绍如何利用缓存优化编译器执行性能。
|
||||
|
||||
可以利用 **Frist 集** 与 **Match 节点缓存** 这两种方式优化。
|
||||
可以利用 **First 集** 与 **Match 节点缓存** 这两种方式优化。
|
||||
|
||||
本文会用到一些图做解释,下面介绍图形规则:
|
||||
|
||||
@@ -44,7 +44,7 @@ Match 节点缓存,指在运行时,缓存节点到其第一个终结符的
|
||||
|
||||
拿 `select a, b, c, d from e` 这个语句做测试:
|
||||
|
||||
| node 节点访问次数 | Frist 集优化 | First 集 + Match 节点缓存优化 |
|
||||
| node 节点访问次数 | First 集优化 | First 集 + Match 节点缓存优化 |
|
||||
| ----------------- | ------------ | ----------------------------- |
|
||||
| 784 | 669 | 652 |
|
||||
|
||||
@@ -422,7 +422,7 @@ function Article({ id }) {
|
||||
return () => {
|
||||
didCancel = true;
|
||||
};
|
||||
}, [fetchArticle]);
|
||||
}, [API.fetchArticle]);
|
||||
|
||||
// ...
|
||||
}
|
||||
@@ -101,8 +101,8 @@ function SearchResults({ query }) {
|
||||
const [data, setData] = useState(null);
|
||||
const [currentPage, setCurrentPage] = useState(0);
|
||||
|
||||
const fetchResults = useCallback(() => {
|
||||
return "http://myapi/results?query" + query + "&page=" + currentPage;
|
||||
const getFetchUrl = useCallback(() => {
|
||||
return "http://myapi/results?query=" + query + "&page=" + currentPage;
|
||||
}, [currentPage, query]);
|
||||
|
||||
useEffect(() => {
|
||||
@@ -114,7 +114,7 @@ function SearchResults({ query }) {
|
||||
}
|
||||
```
|
||||
|
||||
Function Component 对 `props` 与 `state` 的数据都一视同仁,且可以将取数逻辑与 “更新判断” 通过 `useCallback` 完全封装在一个函数内,再将这个函数作为整体依赖项添加到 `useEffect`,如果未来再新增一个参数,只要修改 `fetchResults` 这个函数即可,而且还可以通过 `eslint-plugin-react-hooks` 插件静态分析是否遗漏了依赖项。
|
||||
Function Component 对 `props` 与 `state` 的数据都一视同仁,且可以将取数逻辑与 “更新判断” 通过 `useCallback` 完全封装在一个函数内,再将这个函数作为整体依赖项添加到 `useEffect`,如果未来再新增一个参数,只要修改 `getFetchUrl` 这个函数即可,而且还可以通过 `eslint-plugin-react-hooks` 插件静态分析是否遗漏了依赖项。
|
||||
|
||||
Function Component 不但将依赖项聚合起来,还解决了 Class Component 分散在多处生命周期的函数判断,引发的无法静态分析依赖的问题。
|
||||
|
||||
@@ -409,7 +409,7 @@ const App = memo(function App() {
|
||||
const [state, dispatch] = useReducer(appReducer, new State())
|
||||
|
||||
return (
|
||||
<AppDispatch.Provider value={dispaych}>
|
||||
<AppDispatch.Provider value={dispatch}>
|
||||
<Count count={count}/>
|
||||
<Name name={name}/>
|
||||
</AppDispatch.Provider>
|
||||
@@ -0,0 +1,204 @@
|
||||
# 1. 引言
|
||||
|
||||
这次介绍的文章是 [scheduling-in-react](https://philippspiess.com/scheduling-in-react/),简单来说就是 React 的调度系统,为了得到更顺滑的用户体验。
|
||||
|
||||
毕竟前端做到最后,都是体验优化,前端带给用户的价值核心就在于此。
|
||||
|
||||
# 2. 概述
|
||||
|
||||
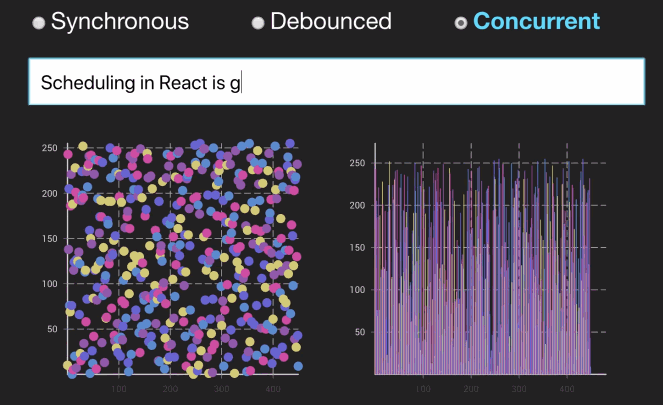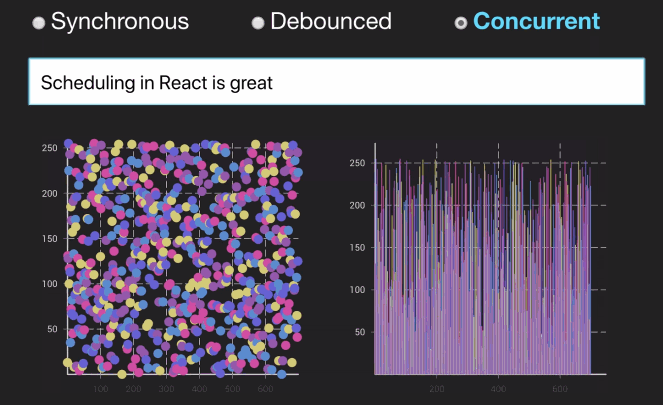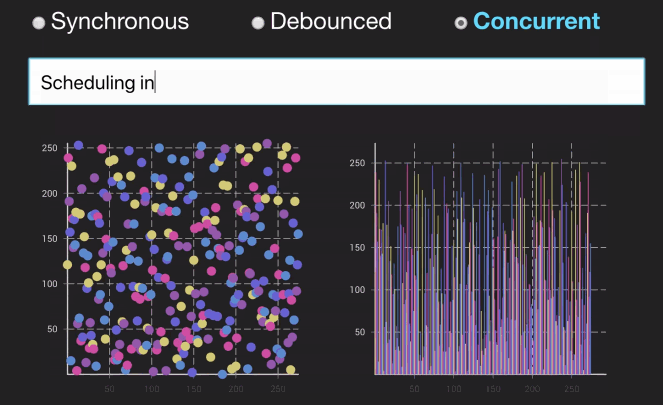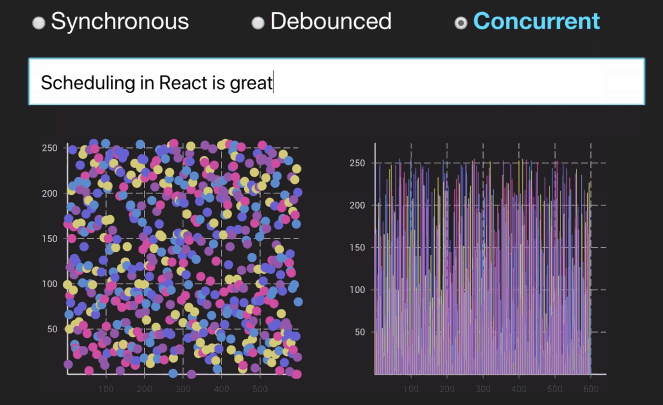
文章从 Dan 在 [JSConf](https://reactjs.org/blog/2018/03/01/sneak-peek-beyond-react-16.html) 提到的 Demo 说起:
|
||||
|
||||
|
||||
|
||||
这是一个测试性能的 Demo,随着输入框字符的增加,下方图表展示的数据量会急速提升。在 Synchronous 与 Debounced 模式下的效果都不尽如人意,只有 Concurrent 模式下看起来是顺畅的。
|
||||
|
||||
那么为什么普通的 Demo 会很卡呢?
|
||||
|
||||
这就涉及到浏览器 Event Loop 规则了。
|
||||
|
||||
JS 是单线程的,浏览器同一时间只能做一件事情,而肉眼能识别的刷新频率在 60FPS 左右,这意味着我们需要在 16ms 之内完成 Demo 中的三件事:响应用户输入,做动画,Dom 渲染。
|
||||
|
||||
然而目前几乎所有框架都使用同步渲染模式,这意味着如果一个渲染函数执行时间超过了 16ms,则不可避免的发生卡顿。
|
||||
|
||||
总结一下有两个主要问题:
|
||||
|
||||
1. 长时间运行的任务造成页面卡顿,我们需要保证所有任务能在几毫秒内完成,这样才能保证页面的流畅。
|
||||
2. 不同任务优先级不同,比如响应用户输入的任务优先级就高于动画。这个很好理解。
|
||||
|
||||
## React 调度机制
|
||||
|
||||
为了解决这个问题,React16 通过 Concurrent(并行渲染) 与 Scheduler(调度)两个角度解决问题:
|
||||
|
||||
- **Concurrent:** 将同步的渲染变成可拆解为多步的异步渲染,这样可以将超过 16ms 的渲染代码分几次执行。
|
||||
- **Scheduler:** 调度系统,支持不同渲染优先级,对 Concurrent 进行调度。当然,调度系统对低优先级任务会不断提高优先级,所以不会出现低优先级任务总得不到执行的情况。
|
||||
|
||||
为了保证不产生阻塞的感觉,调度系统会将所有待执行的回调函数存在一份清单中,在每次浏览器渲染时间分片间尽可能的执行,并将没有执行完的内容 Hold 住留到下个分片处理。
|
||||
|
||||
Concurrent 的正式 API 会在 2019 Q2 发布,现在可以通过 `<React.unstable_ConcurrentMode>` API 方式调用:
|
||||
|
||||
```jsx
|
||||
ReactDOM.render(
|
||||
<React.unstable_ConcurrentMode>
|
||||
<App />
|
||||
</React.unstable_ConcurrentMode>,
|
||||
rootElement
|
||||
);
|
||||
```
|
||||
|
||||
只申明这个是不够的,因为我们还没有申明各函数执行的优先级。我们可以通过 `npm i scheduler` 包来申明函数的优先级:
|
||||
|
||||
```jsx
|
||||
import { unstable_next } from "scheduler";
|
||||
|
||||
function SearchBox(props) {
|
||||
const [inputValue, setInputValue] = React.useState();
|
||||
|
||||
function handleChange(event) {
|
||||
const value = event.target.value;
|
||||
|
||||
setInputValue(value);
|
||||
unstable_next(function() {
|
||||
props.onChange(value);
|
||||
sendAnalyticsNotification(value);
|
||||
});
|
||||
}
|
||||
|
||||
return <input type="text" value={inputValue} onChange={handleChange} />;
|
||||
}
|
||||
```
|
||||
|
||||
在 `unstable_next()` 作用域下的代码优先级是 `Normal`,那么产生的效果是:
|
||||
|
||||
1. 如果 `props.onChange(value)` 可以在 16ms 内执行完,则与不使用 `unstable_next` 没有区别。
|
||||
2. 如果 `props.onChange(value)` 的执行时间过长,可能这个函数会在下次几次的 Render 中陆续执行,不会阻塞后续的高优先级任务。
|
||||
|
||||
## 调度带来的限制
|
||||
|
||||
调度系统也存在两个问题。
|
||||
|
||||
1. 调度系统只能有一个,如果同时存在两个调度系统,就无法保证调度正确性。
|
||||
2. 调度系统能力有限,只能在浏览器提供的能力范围内进行调度,而无法影响比如 Html 的渲染、回收周期。
|
||||
|
||||
为了解决这个问题,Chrome 正在与 React、Polymer、Ember、Google Maps、Web Standars Community 共同创建一个 [浏览器调度规范](https://github.com/WICG/main-thread-scheduling),提供浏览器级别 API,可以让调度控制更底层的渲染时机,也保证调度器的唯一性。
|
||||
|
||||
# 3. 精读
|
||||
|
||||
关于 React 调度系统的剖析,可以读 [深入剖析 React Concurrent](https://zhuanlan.zhihu.com/p/60307571) 这篇文章,感谢我们团队的 淡苍 提供。
|
||||
|
||||
简单来说,一次 Render 一般涉及到许多子节点,而 Fiber 架构在 Render 阶段可以暂停,一个一个节点的执行,从而实现了调度的能力。
|
||||
|
||||
## React 调度能力的限制
|
||||
|
||||
> 这意味着,如果你的 React 应用目前是流畅的,开启 Concurrent 并不会对你的应用带来性能体验上的提升,如果你的 React 应用目前是卡顿的,或者在某些场景下是卡顿的,那么 Concurrent 或许可以挽救你一下,带来一些改变。
|
||||
|
||||
正如《深入剖析 React Concurrent》一文提到的,如果你的应用没有性能问题,就不要指望 React 调度能力有所帮助了。
|
||||
|
||||
这也是在说,如果一段代码逻辑不存在性能问题,就不需要使用 Concurrent 优化,因为这种优化是无效的。我们需要能分辨哪些逻辑需要优化,哪些逻辑不要。
|
||||
|
||||
## 从现在开始尝试 Function Component
|
||||
|
||||
为了配合 React Schedule 的实现,学会使用 Function Component 模式编写组件是很重要的,因为:
|
||||
|
||||
1. Class Component 的生命周期概念阻碍了 React 调度系统对任务的拆分。
|
||||
2. 调度系统可能对 `componentWillMount` 重复调用,使得 Class Component 模式下很容易写出错误的代码。
|
||||
3. Function Component 遵循了更严格的副作用分离,这使得 Concurrent 执行过程不会引发意外效果。
|
||||
|
||||
## React.lazy
|
||||
|
||||
与 Concurrent 一起发布的,还有 React 组件动态 import 与载入方案。正常的组件载入是这样的:
|
||||
|
||||
```jsx
|
||||
import OtherComponent from "./OtherComponent";
|
||||
|
||||
function MyComponent() {
|
||||
return (
|
||||
<div>
|
||||
<OtherComponent />
|
||||
</div>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
但如果使用了 `import()` 动态载入,可以使用 `React.lazy` 让动态引入的组件像普通组件一样被使用:
|
||||
|
||||
```jsx
|
||||
const OtherComponent = React.lazy(() => import("./OtherComponent"));
|
||||
|
||||
function MyComponent() {
|
||||
return (
|
||||
<div>
|
||||
<OtherComponent />
|
||||
</div>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
如果要加入 Loading,就可以配合 `Suspense` 一起使用:
|
||||
|
||||
```jsx
|
||||
import React, { lazy, Suspense } from "react";
|
||||
const OtherComponent = lazy(() => import("./OtherComponent"));
|
||||
|
||||
function MyComponent() {
|
||||
return (
|
||||
<Suspense fallback={<div>Loading...</div>}>
|
||||
<OtherComponent />
|
||||
</Suspense>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
和 Concurrent 类似,React.lazy 方案也是一种对性能有益的组件加载方案。
|
||||
|
||||
## 调度分类
|
||||
|
||||
调度分 4 个等级:
|
||||
|
||||
- **Immediate**:立即执行,最高优先级。
|
||||
- **render-blocking**:会阻塞渲染的优先级,优先级类似 `requestAnimationFrame`。如果这种优先级任务不能被执行,就可能导致 UI 渲染被 block。
|
||||
- **default**:默认优先级,普通的优先级。优先级可以理解为 `setTimeout(0)` 的优先级。
|
||||
- **idle**:比如通知等任务,用户看不到或者不在意的。
|
||||
|
||||
目前建议的 API 类似如下:
|
||||
|
||||
```js
|
||||
function mytask() {
|
||||
...
|
||||
}
|
||||
|
||||
myQueue = TaskQueue.default("render-blocking")
|
||||
```
|
||||
|
||||
先创建一个执行队列,并设置队列的优先级。
|
||||
|
||||
```js
|
||||
taskId = myQueue.postTask(myTask, <list of args>);
|
||||
```
|
||||
|
||||
再提交队列,拿到当前队列的执行 id,通过这个 id 可以判断队列何时执行完毕。
|
||||
|
||||
```js
|
||||
myQueue.cancelTask(taskId);
|
||||
```
|
||||
|
||||
必要的时候可以取消某个函数的执行。
|
||||
|
||||
# 4. 总结
|
||||
|
||||
随着 Hooks 的发布,即将到来的 Concurrent 与 Suspense 你是否准备好了呢?
|
||||
|
||||
笔者希望大家一起思考,这三种 API 会给前端开发带来什么样的改变?欢迎留言!
|
||||
|
||||
> 讨论地址是:[精读《Scheduling in React》 · Issue #146 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/146)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
**special Sponsors**
|
||||
|
||||
- [DevOps 全流程平台](https://e.coding.net/?utm_source=weekly)
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,201 @@
|
||||
# 1. 引言
|
||||
|
||||
本周精读的文章是 [V8 引擎 Lazy Parsing](https://v8.dev/blog/preparser),看看 V8 引擎为了优化性能,做了怎样的尝试吧!
|
||||
|
||||
这篇文章介绍的优化技术叫 [preparser](https://cs.chromium.org/chromium/src/v8/src/parsing/preparser.h?l=921&rcl=e3b2feb3aade83c02e4bd2fa46965a69215cd821),是通过跳过不必要函数编译的方式优化性能。
|
||||
|
||||
# 2. 概述 & 精读
|
||||
|
||||
解析 Js 发生在网页运行的关键路径上,因此加速对 JS 的解析,就可以加速网页运行效率。
|
||||
|
||||
然而并不是所有 Js 都需要在初始化时就被执行,因此也不需要在初始化时就解析所有的 Js!因为编译 Js 会带来三个成本问题:
|
||||
|
||||
1. 编译不必要的代码会占用 CPU 资源。
|
||||
2. 在 GC 前会占用不必要的内存空间。
|
||||
3. 编译后的代码会缓存在磁盘,占用磁盘空间。
|
||||
|
||||
因此所有主流浏览器都实现了 Lazy Parsing(延迟解析),它会将不必要的函数进行预解析,也就是只解析出外部函数需要的内容,而全量解析在调用这个函数时才发生。
|
||||
|
||||
## 预解析的挑战
|
||||
|
||||
本来预解析也不难,因为只要判断一个函数是否会立即执行就可以了,只有立即执行的函数才需要被完全解析。
|
||||
|
||||
使得预解析变复杂的是变量分配问题。原文通过了堆栈调用的例子说明原因:
|
||||
|
||||
Js 代码的执行在堆栈上完成,比如下面这个函数:
|
||||
|
||||
```js
|
||||
function f(a, b) {
|
||||
const c = a + b;
|
||||
return c;
|
||||
}
|
||||
|
||||
function g() {
|
||||
return f(1, 2);
|
||||
// The return instruction pointer of `f` now points here
|
||||
// (because when `f` `return`s, it returns here).
|
||||
}
|
||||
```
|
||||
|
||||
这段函数的调用堆栈如下:
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB1gNCsRVYqK1RjSZLeXXbXppXa-173-333.svg">
|
||||
|
||||
首先是全局 This `globalThis`,然后执行到函数 `f`,再对 `a` `b` 进行赋值。在执行 `f` 函数时,通过 `<rip g>`(return instruction pointer) 保存 g 堆栈状态,再保存堆栈跳出后返回位置的指针 `<save fp>`(frame pointer),最后对变量 `c` 赋值。
|
||||
|
||||
这看上去没有问题,只要将值存在堆栈就搞定了。但是将变量定义到函数内部就不一样了:
|
||||
|
||||
```js
|
||||
function make_f(d) {
|
||||
// ← declaration of `d`
|
||||
return function inner(a, b) {
|
||||
const c = a + b + d; // ← reference to `d`
|
||||
return c;
|
||||
};
|
||||
}
|
||||
|
||||
const f = make_f(10);
|
||||
|
||||
function g() {
|
||||
return f(1, 2);
|
||||
}
|
||||
```
|
||||
|
||||
将变量 `d` 申明在函数 `make_f` 中,且在返回函数 `inner` 中用到了 `d`。那么函数的调用栈就变成了这样:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1HiuGR4YaK1RjSZFnXXa80pXa-428-292.svg">
|
||||
|
||||
需要创建一个 `context` 存储函数 `f` 中变量 `d` 的值。
|
||||
|
||||
也就是说,如果一个在函数内部定义的变量被子 Scope 使用时,Js 引擎需要识别这种情况,并将这个变量值存储在 `context` 中。
|
||||
|
||||
所以对于函数定义的每一个入参,我们需要知道其是否会被子函数引用。**也就是说,在 `preparser` 阶段,我们只要少能分析出哪些变量被内部函数引用了。**
|
||||
|
||||
## 难以分辨的引用
|
||||
|
||||
预处理器中跟踪变量的申明与引用很复杂,因为 Js 的语法导致了无法从部分表达式推断含义,比如下面的函数:
|
||||
|
||||
```js
|
||||
function f(d) {
|
||||
function g() {
|
||||
const a = ({ d }
|
||||
```
|
||||
|
||||
我们不清楚第三行的 `d` 到底是不是指代第一行的 `d`。它可能是:
|
||||
|
||||
```js
|
||||
function f(d) {
|
||||
function g() {
|
||||
const a = ({ d } = { d: 42 });
|
||||
return a;
|
||||
}
|
||||
return g;
|
||||
}
|
||||
```
|
||||
|
||||
也可能只是一个自定义函数参数,与上面的 `d` 无关:
|
||||
|
||||
```js
|
||||
function f(d) {
|
||||
function g() {
|
||||
const a = ({ d }) => d;
|
||||
return a;
|
||||
}
|
||||
|
||||
return [d, g];
|
||||
}
|
||||
```
|
||||
|
||||
## 惰性 parse
|
||||
|
||||
在执行函数时,只会将最外层执行的函数完全编译并生成 AST,而对内部模块只进行 `preparser`。
|
||||
|
||||
```js
|
||||
// This is the top-level scope.
|
||||
function outer() {
|
||||
// preparsed
|
||||
function inner() {
|
||||
// preparsed
|
||||
}
|
||||
}
|
||||
|
||||
outer(); // Fully parses and compiles `outer`, but not `inner`.
|
||||
```
|
||||
|
||||
为了允许惰性编译函数,上下文指针指向了 [ScopeInfo](https://cs.chromium.org/chromium/src/v8/src/objects/scope-info.h?rcl=ce2242080787636827dd629ed5ee4e11a4368b9e&l=36) 的对象(从代码中可以看到,ScopeInfo 包含上下文信息,比如当前上下文是否有函数名,是否在一个函数内等等),当编译内部函数时,可以利用 ScopeInfo 继续编译子函数。
|
||||
|
||||
但是为了判断惰性编译函数自身是否需要一个上下文,我们需要再次解析内部的函数:比如我们需要知道某个子函数是否对外层函数定义的变量有所引用。
|
||||
|
||||
这样就会产生递归遍历:
|
||||
|
||||
<img width=800 src="https://img.alicdn.com/tfs/TB1uCOPR7voK1RjSZFwXXciCFXa-960-540.svg">
|
||||
|
||||
由于代码总会包含一些嵌套,而编译工具更会产生 IIFE(立即调用函数) 这种多层嵌套的表达式,使得递归性能比较差。
|
||||
|
||||
而下面有一种办法可以将时间复杂度简化为线性:将变量分配的位置序列化为一个密集的数组,当惰性解析函数时,变量会按照原先的顺序重新创建,这样就不需要因为子函数可能引用外层定义变量的原因,对所有子函数进行递归惰性解析了。
|
||||
|
||||
按照这种方式优化后的时间复杂度是线性的:
|
||||
|
||||
<img width=800 src="https://img.alicdn.com/tfs/TB1VS5LR7voK1RjSZFNXXcxMVXa-960-540.svg">
|
||||
|
||||
## 针对模块化打包的优化
|
||||
|
||||
由于现代代码几乎都是模块化编写的,构建起在打包时会将模块化代码封装在 IIFE(立即调用的闭包)中,以保证模拟模块化环境运行。比如 `(function(){....})()`。
|
||||
|
||||
这些代码看似在函数中应该惰性编译,但其实这些模块化代码从一开始就要被编译,否则反而会影响性能,因此 V8 有两种机制识别这些可能被立即调用的函数:
|
||||
|
||||
1. 如果函数是带括号的,比如 `(function(){...})`,就假设它会被立即调用。
|
||||
2. 从 V8 v5.7 / Chrome 57 开始,还会识别 uglifyJS 的 `!function(){...}(), function(){...}(), function(){...}()` 这种模式。
|
||||
|
||||
然而在浏览器引擎解析环境比较复杂,很难对函数进行完整字符串匹配,因此只能对函数头进行简单判断。所以对于下面这种匿名函数的行为,浏览器是不识别的:
|
||||
|
||||
```js
|
||||
// pre-parser
|
||||
function run(func) {
|
||||
func()
|
||||
}
|
||||
|
||||
run(function(){}) // 在这执行它,进行 full parser
|
||||
```
|
||||
|
||||
上面的代码看上去没毛病,但由于浏览器只检测被括号括住的函数,因此这个函数不被认为是立即执行函数,因此在后续执行时会被重复 full-parse。
|
||||
|
||||
也有一些代码辅助转换工具帮助 V8 正确识别,比如 [optimize-js](https://github.com/nolanlawson/optimize-js),会将代码做如下转换。
|
||||
|
||||
转换前:
|
||||
|
||||
```js
|
||||
!function (){}()
|
||||
function runIt(fun){ fun() }
|
||||
runIt(function (){})
|
||||
```
|
||||
|
||||
转换后:
|
||||
|
||||
```js
|
||||
!(function (){})()
|
||||
function runIt(fun){ fun() }
|
||||
runIt((function (){}))
|
||||
```
|
||||
|
||||
然而在 V8 v7.5+ 已经很大程度解决了这个问题,因此现在其实不需要使用 [optimize-js](https://github.com/nolanlawson/optimize-js) 这种库了~
|
||||
|
||||
# 4. 总结
|
||||
|
||||
JS 解析引擎在性能优化做了不少工作,但同时也要应对代码编译器产生的特殊 IIFE 闭包,防止对这种立即执行闭包进行重复 parser。
|
||||
|
||||
最后,不要试图总是将函数用括号括起来,因为这样会导致惰性编译的特性无法启用。
|
||||
|
||||
> 讨论地址是:[精读《V8 引擎 Lazy Parsing》 · Issue #148 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/148)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
**special Sponsors**
|
||||
|
||||
- [DevOps 全流程平台](https://e.coding.net/?utm_source=weekly)
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
Some files were not shown because too many files have changed in this diff Show More
Reference in New Issue
Block a user