Compare commits
| Author | SHA1 | Date | |
|---|---|---|---|
 ascoders |
1d95103bfb | ||
|
ascoders
|
b9d9292040 | ||
|
黄子毅
|
7ce55795a2 | ||
|
Linear-Enter
|
2a420c455e | ||
|
ascoders
|
069cf8f947 | ||
|
ascoders
|
af86669e18 | ||
|
ascoders
|
50c4409e29 | ||
|
ascoders
|
5c44507443 | ||
|
ascoders
|
ffb736eb6d | ||
|
黄子毅
|
abc677a5f0 | ||
|
ascoders
|
3c78a1a659 | ||
|
ascoders
|
507df796b0 | ||
|
ascoders
|
0f58ce27dc | ||
|
ascoders
|
51c8f3bb69 | ||
|
vivaxy
|
c4da7262cb | ||
|
ascoders
|
a513286318 | ||
|
ascoders
|
509dfe2c97 | ||
|
ascoders
|
806ee0177a | ||
|
ascoders
|
fe4afdf89c | ||
|
ascoders
|
caec16066a | ||
|
ascoders
|
7f53bde9a3 |
@@ -813,25 +813,30 @@ function Parent() {
|
||||
换一个例子就可以看得更清楚:
|
||||
|
||||
```js
|
||||
function Parent() {
|
||||
function Parent(props) {
|
||||
const [count, setCount] = useState(0);
|
||||
const [step, setStep] = useState(0);
|
||||
const [other, setOther] = useState(0);
|
||||
const drag = useDraggable(count, step); // 封装了拖拽函数
|
||||
const drag = useDraggable(props.dom, count, step); // 封装了拖拽函数
|
||||
|
||||
useEffect(() => {
|
||||
// dom 变化时重新实例化
|
||||
drag()
|
||||
}, [drag])
|
||||
}
|
||||
```
|
||||
|
||||
假设我们使用 [Sortablejs](https://github.com/SortableJS/Sortable) 对某个区域进行拖拽监听,这个函数每次都重复执行的性能损耗非常大,**然而这个函数内部可能因为仅仅要上报一些日志,所以依赖了没有实际被使用的 `count` `step` 变量:**
|
||||
|
||||
```js
|
||||
function useDraggable(count, step) {
|
||||
function useDraggable(dom, count, step) {
|
||||
return useCallback(() => {
|
||||
// 上报日志
|
||||
report(count, step);
|
||||
|
||||
// 对区域进行初始化,非常耗时
|
||||
// ... 省略耗时代码
|
||||
}, [count, step]);
|
||||
}, [dom, count, step]);
|
||||
}
|
||||
```
|
||||
|
||||
|
||||
+1
-1
@@ -92,7 +92,7 @@
|
||||
|
||||
**中南半岛由 5 个国家组成,从西到东分别是:缅甸、泰国、柬埔寨、老挝、越南**,其中缅、老、 越与中国接壤,除了老挝外都有足够的海岸线。这些国家大部分是殖民时代的遗产,英法分别在缅甸、越南发力,将泰国定位缓冲国。法国人曾将柬埔寨、老挝、越南合并成 “印支联邦” 与英国对抗,虽然现在又分裂成三个国家,因此却为越南埋下了大国梦。
|
||||
|
||||
缅甸在位置上,可以在陆地及海洋延伸中国的地缘影响力,而且也曾成为支持中国抗战的重要援助物资运输线。在缅甸西边是 “金三角地区”:
|
||||
缅甸在位置上,可以在陆地及海洋延伸中国的地缘影响力,而且也曾成为支持中国抗战的重要援助物资运输线。在缅甸东边是 “金三角地区”:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1iwnRchD1gK0jSZFKXXcJrVXa-1396-1266.png">
|
||||
|
||||
|
||||
@@ -154,7 +154,7 @@ Table 主要配置分为行、列、标记与筛选。通过这四个配置区
|
||||
|
||||
我们会发现,原本存在于列的 Category 被自动挪到了行,原本存在于行的 Sales 被挪到了 “标记” 区域。在正式介绍 “标记” 区域前,先理解一下为何会发生这种转变:
|
||||
|
||||
**表格类组件是双维度组件,折线图是单维度组件。**也就是表格的行与列都是维度,而折线图横轴作为维度后,纵轴就要作为度量。上面的例子中,折线图维度有两个字段,虽然通过分面方式渲染出来了,但当切换为支持双维度的表格后, **可以将多余的一个维度挪到表格组件另一个维度区域中**。
|
||||
**表格类组件是双维度组件,折线图是单维度组件。** 也就是表格的行与列都是维度,而折线图横轴作为维度后,纵轴就要作为度量。上面的例子中,折线图维度有两个字段,虽然通过分面方式渲染出来了,但当切换为支持双维度的表格后, **可以将多余的一个维度挪到表格组件另一个维度区域中**。
|
||||
|
||||
而表格行与列都是维度的情况下,单元格的值就需要用 “标记” 中文本来表示,因此原折线图的度量字段自动转移到了 “标记” 区域。
|
||||
|
||||
@@ -313,7 +313,7 @@ Tableau 内置的图表分为 N 大类 - **表格、地图、柱折面饼、散
|
||||
|
||||
<img width=529 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566699040802-40a23a43-7a23-43d1-9d06-27a6413803e8.png#align=left&display=inline&height=314&name=image.png&originHeight=856&originWidth=1440&size=106220&status=done&width=529">
|
||||
|
||||
**上图也可以理解为展示出 Order Date 与 Order ID 的明细数据,按照 Order Date 分组且列合并。**下钻就是一步步接近明细数据的过程,但目的不是为了看明细表,而是看某些维度下按其他维度拆分的详细信息。
|
||||
**上图也可以理解为展示出 Order Date 与 Order ID 的明细数据,按照 Order Date 分组且列合并。** 下钻就是一步步接近明细数据的过程,但目的不是为了看明细表,而是看某些维度下按其他维度拆分的详细信息。
|
||||
|
||||
图表下钻和表格思路是一致的:
|
||||
|
||||
@@ -323,9 +323,9 @@ Tableau 内置的图表分为 N 大类 - **表格、地图、柱折面饼、散
|
||||
|
||||
<img width=667 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566700041429-03bcb68a-dd00-4cab-a256-f37234bb2300.png#align=left&display=inline&height=423&name=image.png&originHeight=1350&originWidth=2128&size=155697&status=done&width=667">
|
||||
|
||||
**可以认为,当行或列上最后一个字段为度量时,就会切换为图表展示,因为图表适合展示连续状态。**如果排除上图蓝色区域,剩下的区域就是个交叉表,交叉表只是行与列同时存在维度字段的场景,仅有行或列时就变成了普通表格;而图形的下钻和表格下钻机理相同,只是把 “单元格” 的文本换成了柱子或线。
|
||||
**可以认为,当行或列上最后一个字段为度量时,就会切换为图表展示,因为图表适合展示连续状态。** 如果排除上图蓝色区域,剩下的区域就是个交叉表,交叉表只是行与列同时存在维度字段的场景,仅有行或列时就变成了普通表格;而图形的下钻和表格下钻机理相同,只是把 “单元格” 的文本换成了柱子或线。
|
||||
|
||||
**所以对任何图表的下钻,都是对轴的下钻,**相同的是单元格属性永远不会改变,表格的单元格是文本,图形单元格是图形,一个简单折线图可以理解为对整体行与列单元格进行 “连续打通”:
|
||||
**所以对任何图表的下钻,都是对轴的下钻,** 相同的是单元格属性永远不会改变,表格的单元格是文本,图形单元格是图形,一个简单折线图可以理解为对整体行与列单元格进行 “连续打通”:
|
||||
|
||||
<img width=406 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566700448492-a7b96c99-b600-41b0-9159-e88412f4402b.png#align=left&display=inline&height=329&name=image.png&originHeight=1342&originWidth=1654&size=105794&status=done&width=406">
|
||||
|
||||
|
||||
@@ -0,0 +1,293 @@
|
||||
## 1 概述
|
||||
|
||||
本期精读的是有限状态机管理工具 [robot](https://github.com/matthewp/robot) 源码。
|
||||
|
||||
有限状态机是指有限个数的状态之间相互切换的数学模型,在业务与游戏开发中有限状态都很常见,包括发请求也是一种有限状态机的模型。
|
||||
|
||||
笔者将在简介中介绍这个库的使用方式,在精读中介绍实现原理,最后总结在业务中使用的价值。
|
||||
|
||||
## 2 简介
|
||||
|
||||
这个库的核心就是利用 `createMachine` 创建一个有限状态机:
|
||||
|
||||
```typescript
|
||||
import { createMachine, state, transition } from 'robot3';
|
||||
|
||||
const machine = createMachine({
|
||||
inactive: state(
|
||||
transition('toggle', 'active')
|
||||
),
|
||||
active: state(
|
||||
transition('toggle', 'inactive')
|
||||
)
|
||||
});
|
||||
|
||||
export default machine;
|
||||
```
|
||||
|
||||
如上图所示,我们创建了一个有限状态机 `machine`,包含了两种状态:`inactive` 与 `active`,并且可以通过 `toggle` 动作在两种状态间做切换。
|
||||
|
||||
与 React 结合则有 [react-robot](https://github.com/matthewp/react-robot):
|
||||
|
||||
```tsx
|
||||
import { useMachine } from 'react-robot';
|
||||
import React from 'react';
|
||||
import machine from './machine'
|
||||
|
||||
function App() {
|
||||
const [current, send] = useMachine(machine);
|
||||
|
||||
return (
|
||||
<button type="button" onClick={() => send('toggle')}>
|
||||
State: {current.name}
|
||||
</button>
|
||||
)
|
||||
}
|
||||
```
|
||||
|
||||
通过 `useMachine` 拿到的 `current.name` 表示当前状态值,`send` 用来发送改变状态的指令。
|
||||
|
||||
至于为什么要用有限状态机管理工具,官方文档举了个例子 - 点击编辑后进入编辑态,点击保存后返回原始状态的例子:
|
||||
|
||||

|
||||
|
||||
点击 Edit 按钮后,将进入下图的状态,点击 Save 后如果输入的内容校验通过保存后再回到初始状态:
|
||||
|
||||

|
||||
|
||||
如果不用有限状态机,我们首先会创建两个变量存储是否处于编辑态,以及当前输入文本是什么:
|
||||
|
||||
```js
|
||||
let editMode = false;
|
||||
let title = '';
|
||||
```
|
||||
|
||||
如果再考虑和后端的交互,就会增加三个状态 - 保存中、校验、保存是否成功:
|
||||
|
||||
```js
|
||||
let editMode = false;
|
||||
let title = '';
|
||||
let saving = false;
|
||||
let validating = false;
|
||||
let saveHadError = false;
|
||||
```
|
||||
|
||||
就算使用 React、Vue 等框架数据驱动 UI,我们还是免不了对复杂状态进行管理。如果使用有限状态机实现,将是这样的:
|
||||
|
||||
```js
|
||||
import { createMachine, guard, immediate, invoke, state, transition, reduce } from 'robot3';
|
||||
|
||||
const machine = createMachine({
|
||||
preview: state(
|
||||
transition('edit', 'editMode',
|
||||
// Save the current title as oldTitle so we can reset later.
|
||||
reduce(ctx => ({ ...ctx, oldTitle: ctx.title }))
|
||||
)
|
||||
),
|
||||
editMode: state(
|
||||
transition('input', 'editMode',
|
||||
reduce((ctx, ev) => ({ ...ctx, title: ev.target.value }))
|
||||
),
|
||||
transition('cancel', 'cancel'),
|
||||
transition('save', 'validate')
|
||||
),
|
||||
cancel: state(
|
||||
immediate('preview',
|
||||
// Reset the title back to oldTitle
|
||||
reduce(ctx => ({ ...ctx, title: ctx.oldTitle })
|
||||
)
|
||||
),
|
||||
validate: state(
|
||||
// Check if the title is valid. If so go
|
||||
// to the save state, otherwise go back to editMode
|
||||
immediate('save', guard(titleIsValid)),
|
||||
immediate('editMode')
|
||||
)
|
||||
save: invoke(saveTitle,
|
||||
transition('done', 'preview'),
|
||||
transition('error', 'error')
|
||||
),
|
||||
error: state(
|
||||
// Should we provide a retry or...?
|
||||
)
|
||||
});
|
||||
```
|
||||
|
||||
其中 `immediate` 表示直接跳到下一个状态,`reduce` 则可以对状态机内部数据进行拓展。比如 `preview` 返回了 `oldTitle`,那么 `cancle` 时就可以通过 `ctx.oldTitle` 拿到;`invoke` 表示调用第一个函数后,再执行 `state`。
|
||||
|
||||
通过上面的代码我们可以看到使用状态机的好处:
|
||||
|
||||
1. 状态清晰,先罗列出某个业务逻辑的全部状态,避免遗漏。
|
||||
2. 状态转换安全。比如 `preview` 只能切换到 `edit` 状态,这样就算在错误的状态发错指令也不会产生异常情况。
|
||||
|
||||
## 3 精读
|
||||
|
||||
[robot](https://github.com/matthewp/robot) 重要的函数有 `createMachine, state, transition, immediate`,下面一一拆解说明。
|
||||
|
||||
### createMachine
|
||||
|
||||
[createMachine](https://github.com/matthewp/robot/blob/master/machine.js#L122) 表示创建状态机:
|
||||
|
||||
```js
|
||||
export function createMachine(current, states, contextFn = empty) {
|
||||
if(typeof current !== 'string') {
|
||||
contextFn = states || empty;
|
||||
states = current;
|
||||
current = Object.keys(states)[0];
|
||||
}
|
||||
if(d._create) d._create(current, states);
|
||||
return create(machine, {
|
||||
context: valueEnumerable(contextFn),
|
||||
current: valueEnumerable(current),
|
||||
states: valueEnumerable(states)
|
||||
});
|
||||
}
|
||||
```
|
||||
|
||||
可以看到,如果传递了一个对象,通过 `Object.keys(states)[0]` 拿到第一个状态作为当前状态(标记在 `current`),最终将保存三个属性:
|
||||
|
||||
- `context` 当前状态机内部属性,初始化是空的。
|
||||
- `current` 当前状态。
|
||||
- `states` 所有状态,也就是 `createMachine` 传递的第一个参数。
|
||||
|
||||
再看 `create` 函数:
|
||||
|
||||
```js
|
||||
let create = (a, b) => Object.freeze(Object.create(a, b));
|
||||
```
|
||||
|
||||
也就是创建了一个不修改的对象作为状态机。
|
||||
|
||||
这个是 `machine` 对象:
|
||||
|
||||
```js
|
||||
let machine = {
|
||||
get state() {
|
||||
return {
|
||||
name: this.current,
|
||||
value: this.states[this.current]
|
||||
};
|
||||
}
|
||||
};
|
||||
```
|
||||
|
||||
也就是说,状态机内部的状态管理是通过对象完成的,并提供了 `state()` 函数拿到当前的状态名和状态值。
|
||||
|
||||
### state
|
||||
|
||||
[state](https://github.com/matthewp/robot/blob/master/machine.js#L70) 用来描述状态支持哪些转换:
|
||||
|
||||
```js
|
||||
export function state(...args) {
|
||||
let transitions = filter(transitionType, args);
|
||||
let immediates = filter(immediateType, args);
|
||||
let desc = {
|
||||
final: valueEnumerable(args.length === 0),
|
||||
transitions: valueEnumerable(transitionsToMap(transitions))
|
||||
};
|
||||
if(immediates.length) {
|
||||
desc.immediates = valueEnumerable(immediates);
|
||||
desc.enter = valueEnumerable(enterImmediate);
|
||||
}
|
||||
return create(stateType, desc);
|
||||
}
|
||||
```
|
||||
|
||||
`transitions` 与 `immediates` 表示从 `args` 里拿到 `transition` 或 `immediate` 的结果。
|
||||
|
||||
方法是通过如下方式定义 `transition` 与 `immediate`:
|
||||
|
||||
```js
|
||||
export let transition = makeTransition.bind(transitionType);
|
||||
export let immediate = makeTransition.bind(immediateType, null);
|
||||
|
||||
function filter(Type, arr) {
|
||||
return arr.filter(value => Type.isPrototypeOf(value));
|
||||
}
|
||||
```
|
||||
|
||||
**那么如果一个函数是通过 `immediate` 创建的,就可以通过 `immediateType.isPrototypeOf()` 的校验,此方法适用范围很广,在任何库里都可以用来校验拿到对应函数创建的对象。**
|
||||
|
||||
如果参数数量为 0,表示这个状态是最终态,无法进行转换。**最后通过 `create` 创建一个对象,这个对象就是状态的值**。
|
||||
|
||||
### transition
|
||||
|
||||
[transition](https://github.com/matthewp/robot/blob/master/machine.js#L53) 是写在 `state` 中描述当前状态可以如何变换的函数,其实际函数是 `makeTransistion`:
|
||||
|
||||
```js
|
||||
function makeTransition(from, to, ...args) {
|
||||
let guards = stack(filter(guardType, args).map(t => t.fn), truthy, callBoth);
|
||||
let reducers = stack(filter(reduceType, args).map(t => t.fn), identity, callForward);
|
||||
return create(this, {
|
||||
from: valueEnumerable(from),
|
||||
to: valueEnumerable(to),
|
||||
guards: valueEnumerable(guards),
|
||||
reducers: valueEnumerable(reducers)
|
||||
});
|
||||
}
|
||||
```
|
||||
|
||||
由于:
|
||||
|
||||
```js
|
||||
export let transition = makeTransition.bind(transitionType);
|
||||
export let immediate = makeTransition.bind(immediateType, null);
|
||||
```
|
||||
|
||||
可见 `from` 为 `null` 即表示立即转换到状态 `to`。`transition` 最终返回一个对象,其中 `guards` 是从 `transition` 或 `immediate` 参数中找到的,由 `guards` 函数创建的对象,当这个对象回调函数执行成功时此状态才生效。
|
||||
|
||||
`...args` 对应 `transition('toggle', 'active')` 或 `immediate('save', guard(titleIsValid))`,而 `stack(filter(guardType, args).map(t => t.fn), truthy, callBoth)` 这句话就是从 `...args` 中寻找是否有 `guards`,`reducers` 同理。
|
||||
|
||||
最后看看状态是如何改变的,设置状态改变的函数是 [transitionTo](https://github.com/matthewp/robot/blob/master/machine.js#L136):
|
||||
|
||||
```js
|
||||
function transitionTo(service, fromEvent, candidates) {
|
||||
let { machine, context } = service;
|
||||
for(let { to, guards, reducers } of candidates) {
|
||||
if(guards(context)) {
|
||||
service.context = reducers.call(service, context, fromEvent);
|
||||
|
||||
let original = machine.original || machine;
|
||||
let newMachine = create(original, {
|
||||
current: valueEnumerable(to),
|
||||
original: { value: original }
|
||||
});
|
||||
|
||||
let state = newMachine.state.value;
|
||||
return state.enter(newMachine, service, fromEvent);
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
可以看到,如果存在 `guards`,则需要在 `guards` 执行返回成功时才可以正确改变状态。同时 `reducers` 可以修改 `context` 也在 `service.context = reducers.call(service, context, fromEvent);` 这一行体现了出来。最后通过生成一个新的状态机,并将 `current` 标记为 `to`。
|
||||
|
||||
最后我们看 `state.enter` 这个函数,这个函数在 [state](https://github.com/matthewp/robot/blob/master/machine.js#L79) 函数中有定义,其本质是继承了 `stateType`:
|
||||
|
||||
```js
|
||||
let stateType = { enter: identity };
|
||||
```
|
||||
|
||||
而 `identity` 这个函数就是立即执行函数:
|
||||
|
||||
```js
|
||||
let identity = a => a;
|
||||
```
|
||||
|
||||
因此相当于返回了新的状态机。
|
||||
|
||||
## 4 总结
|
||||
|
||||
有限状态机相比普通业务描述,其实是增加了一些状态间转化的约束来达到优化状态管理的目的,并且状态描述也会更规范一些,在业务中具有一定的实用性。
|
||||
|
||||
当然并不是所有业务都适用有限状态机,因为新框架还是有一些学习成本要考虑。最后通过源码的学习,我们又了解到一些新的框架级小技巧,可以灵活应用到自己的框架中。
|
||||
|
||||
> 讨论地址是:[精读《robot 源码 - 有限状态机》 · Issue #209 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/209)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,486 @@
|
||||
## 1 引言
|
||||
|
||||
在写这次精读之前,我想谈谈前端精读可以为读者带来哪些价值,以及如何评判这些价值。
|
||||
|
||||
前端精读已经写到第 123 篇了,大家已经不必担心它突然停止更新,因为我已养成每周写一篇文章的习惯,而读者也养成了每周看一篇的习惯。所以我想说的其实是一种更有生命力的自媒体运作方式,定期更新。一个定期更新的专栏比一个不不定期更新的专栏更有活力,也更受读者喜爱,因为读者能看到文章之间的联系,跟随作者一起成长。个人学习也是如此,养成定期学习的习惯,比在培训班突击几个月更有用,学会在生活中规律的学习,甚至好过读几年名牌大学。
|
||||
|
||||
前端精读想带给读者的不仅是一篇篇具体的内容和知识,知识是无穷无尽的,几万篇文章也说不完,但前端精读一直沿用了“引言-概述-精读-总结”这套学习模式,无论是前端任何领域的问题,还是对人生和世界的思考都可以套用,希望能为读者提供一套学习思维框架,让你能学习到如何找到好的文章,以及如何解读它。
|
||||
|
||||
至今已经选择了许多源码解读的题材,与培训思维的源码解读不同,我希望你不要带着面试的目的学习源码,因为这样会让你只局限在 react、vue 这种热门的框架上。前端精读选取的框架类型之所以广泛,是希望你能静下心来,吸取不同框架风格与作者的优势,培养一种优雅编码的气质。
|
||||
|
||||
进入正题,这次选择的文章 [《用 Babel 创造自定义 JS 语法》](https://lihautan.com/creating-custom-javascript-syntax-with-babel/) 也是培养编码气质的一类文章,虽然对你实际工作用处不大,但这篇文章可以培养几个程序员梦寐以求的能力:深入理解 Babel、深入理解框架拓展机制。理解一个复杂系统或培养框架思维不是一朝一夕的,但持续阅读这种文章可以让你越来越接近掌握它。
|
||||
|
||||
之所以选择 Babel,是因为 Babel 处理的一直是语法树相关的底层逻辑,编译原理是程序世界的基座之一,拥有很大的学习价值。所以我们的目的并不是像文章标题说的 - 创造一个自定义 JS 语法,因为你创造的语法只会让 JS 复杂体系更加混乱,但可以让你理解 Babel 解析标准 JS 语法的原理,以及看待新语法提案时,拥有从实现层面思考的能力。
|
||||
|
||||
最后,不必多说,能重温 Babel 经典的插件机制,你可以发现 Babel 的插件拓展机制和 Antrl4 很像,在设计业务模块拓展方案时也可以作为参考。
|
||||
|
||||
## 2 概述
|
||||
|
||||
我们要利用 Babel 实现 `function @@` 的新语法,用 `@@` 装饰的函数会自动柯里化:
|
||||
|
||||
```js
|
||||
// '@@' makes the function `foo` curried
|
||||
function @@ foo(a, b, c) {
|
||||
return a + b + c;
|
||||
}
|
||||
console.log(foo(1, 2)(3)); // 6
|
||||
```
|
||||
|
||||
可以看到,`function @@ foo` 描述的函数 `foo` 支持 `foo(1, 2)(3)` 这种柯里化调用。
|
||||
|
||||
实现方式分为两步:
|
||||
|
||||
1. Fork babel 源码。
|
||||
2. 创建一个 babel 转换器插件。
|
||||
|
||||
不要畏惧这些步骤,“如果你读完了这篇文章,你将成为同事眼中的 Babel 大神” - 原文。
|
||||
|
||||
首先 Fork babel 源码到本地,执行下面的命令可以初始化并编译 babel:
|
||||
|
||||
```bash
|
||||
$ make bootstrap
|
||||
$ make build
|
||||
```
|
||||
|
||||
babel 使用 [Makefile](https://opensource.com/article/18/8/what-how-makefile) 执行编译命令,并且采用 monorepo 管理,我们这次要关心的是 `package/babel-parser` 这个模块。
|
||||
|
||||
### 词法
|
||||
|
||||
首先要了解词法知识,更详细的可以阅读原文或精读之前的一篇系列文章:[精读《词法分析》](https://github.com/dt-fe/weekly/blob/v2/064.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E8%AF%8D%E6%B3%95%E5%88%86%E6%9E%90%E3%80%8B.md)。
|
||||
|
||||
要解析语法,首先要进行词法分析。任何语法输入都是一个字符串,比如 `function @@ foo(a, b, c)`,词法分析就是要将这个长度为 24 的字符拆分为一个个有语义的单词片段:`function` `@@` `foo` `(` `a` ..
|
||||
|
||||
由于 `@@` 是我们创造的语法,所以我们第一个任务就是让 babel 词法分析可以识别它。
|
||||
|
||||
下面是 `package/babel-parser` 的文件结构:
|
||||
|
||||
```text
|
||||
- src/
|
||||
- tokenizer/
|
||||
- parser/
|
||||
- plugins/
|
||||
- jsx/
|
||||
- typescript/
|
||||
- flow/
|
||||
- ...
|
||||
- test/
|
||||
```
|
||||
|
||||
可以看到,分为词法分析 `tokenizer`,语法分析 `parser`,以及支持一些特殊语法的插件,以及测试用例 `test`。
|
||||
|
||||
推荐使用 **Test-driven development (TDD) - 测试驱动开发的方式**,就是先写测试用例,再根据测试用例开发。这种开发方式在后端或者 babel 这种底层框架很常见,因为 TDD 方式开发的逻辑能保证测试用例 100% 覆盖,同时先看测试用例也是个很好的切面编程思维。
|
||||
|
||||
```js
|
||||
// packages/babel-parser/test/curry-function.js
|
||||
|
||||
import { parse } from '../lib';
|
||||
|
||||
function getParser(code) {
|
||||
return () => parse(code, { sourceType: 'module' });
|
||||
}
|
||||
|
||||
describe('curry function syntax', function() {
|
||||
it('should parse', function() {
|
||||
expect(getParser(`function @@ foo() {}`)()).toMatchSnapshot();
|
||||
});
|
||||
});
|
||||
```
|
||||
|
||||
可以利用 jest 直接测试这段代码:
|
||||
|
||||
```bash
|
||||
BABEL_ENV=test node_modules/.bin/jest -u packages/babel-parser/test/c
|
||||
```
|
||||
|
||||
结果会出现如下报错:
|
||||
|
||||
```text
|
||||
SyntaxError: Unexpected token (1:9)
|
||||
|
||||
at Parser.raise (packages/babel-parser/src/parser/location.js:39:63)
|
||||
at Parser.raise [as unexpected] (packages/babel-parser/src/parser/util.js:133:16)
|
||||
at Parser.unexpected [as parseIdentifierName] (packages/babel-parser/src/parser/expression.js:2090:18)
|
||||
at Parser.parseIdentifierName [as parseIdentifier] (packages/babel-parser/src/parser/expression.js:2052:23)
|
||||
at Parser.parseIdentifier (packages/babel-pars
|
||||
```
|
||||
|
||||
第 9 个字符就是 `@`,说明程序现在还不支持函数前面的 `@` 解析。我们还可以在错误堆栈中找到报错位置,并把当前 Token 与下一个 Token 打印出来:
|
||||
|
||||
```js
|
||||
// packages/babel-parser/src/parser/expression.js
|
||||
|
||||
parseIdentifierName(pos: number, liberal?: boolean): string {
|
||||
if (this.match(tt.name)) {
|
||||
// ...
|
||||
} else {
|
||||
console.log(this.state.type); // current token
|
||||
console.log(this.lookahead().type); // next token
|
||||
throw this.unexpected();
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
`this.state.type` 代表当前 Token,`this.lookahead().type` 表示下一个 Token。`lookahead` 是词法分析的专有词,表示向后查看。打印之后,我们会发现输出了两个 `@` Token:
|
||||
|
||||
```js
|
||||
TokenType {
|
||||
label: '@',
|
||||
// ...
|
||||
}
|
||||
```
|
||||
|
||||
下一步,我们需要让 babel 词法分析识别 `@@` 这个 Token。首先需要注册这个 Token:
|
||||
|
||||
```js
|
||||
// packages/babel-parser/src/tokenizer/types.js
|
||||
|
||||
export const types: { [name: string]: TokenType } = {
|
||||
// ...
|
||||
at: new TokenType('@'),
|
||||
atat: new TokenType('@@'),
|
||||
};
|
||||
```
|
||||
|
||||
注册了之后,我们要在遍历 Token 时增加判断 “如果当前字符是 `@` 且下一个字符也是 `@`,则整体构成了 `@@` Token 并且光标向后移动两格”:
|
||||
|
||||
```js
|
||||
// packages/babel-parser/src/tokenizer/index.js
|
||||
|
||||
getTokenFromCode(code: number): void {
|
||||
switch (code) {
|
||||
// ...
|
||||
case charCodes.atSign:
|
||||
// if the next character is a `@`
|
||||
if (this.input.charCodeAt(this.state.pos + 1) === charCodes.atSign) {
|
||||
// create `tt.atat` instead
|
||||
this.finishOp(tt.atat, 2);
|
||||
} else {
|
||||
this.finishOp(tt.at, 1);
|
||||
}
|
||||
return;
|
||||
// ...
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
再次运行测试文件,输出变成了:
|
||||
|
||||
```js
|
||||
// current token
|
||||
TokenType {
|
||||
label: '@@',
|
||||
// ...
|
||||
}
|
||||
|
||||
// next token
|
||||
TokenType {
|
||||
label: 'name',
|
||||
// ...
|
||||
}
|
||||
```
|
||||
|
||||
到这一步,已经能正确解析 `@@` Token 了。
|
||||
|
||||
## 语法
|
||||
|
||||
词法已经可以将 `@@` 解析为 `atat` Token,下一步我们就要利用这个 Token,让生成的 AST 结构中包含柯里化函数的信息,并利用 babel 插件在解析时实现柯里化功能。
|
||||
|
||||
首先我们可以在 [Babel AST explorer](https://lihautan.com/babel-ast-explorer/#?eyJiYWJlbFNldHRpbmdzIjp7InZlcnNpb24iOiI3LjYuMCJ9LCJ0cmVlU2V0dGluZ3MiOnsiaGlkZUVtcHR5Ijp0cnVlLCJoaWRlTG9jYXRpb24iOnRydWUsImhpZGVUeXBlIjp0cnVlfSwiY29kZSI6ImZ1bmN0aW9uICogZm9vKCkge30ifQ==) 看到 AST 解析的结构,我们拿 generator 函数测试,因为这个函数结构与柯里化函数类似:
|
||||
|
||||
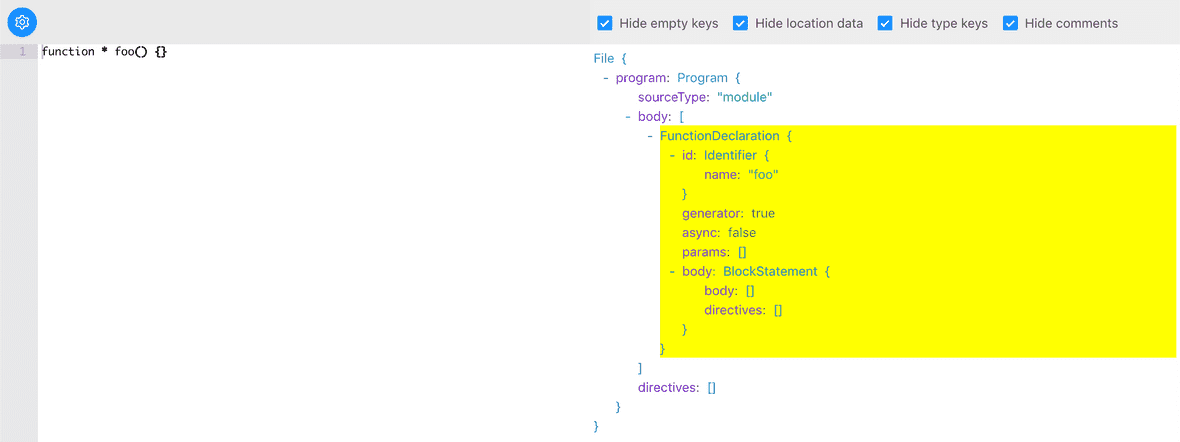
|
||||
|
||||
可以看到,babel 通过 `generator` `async` 属性来标识函数是否为 generator 或者 async 函数。同理,增加一个 `curry` 属性就可以实现第一步了:
|
||||
|
||||
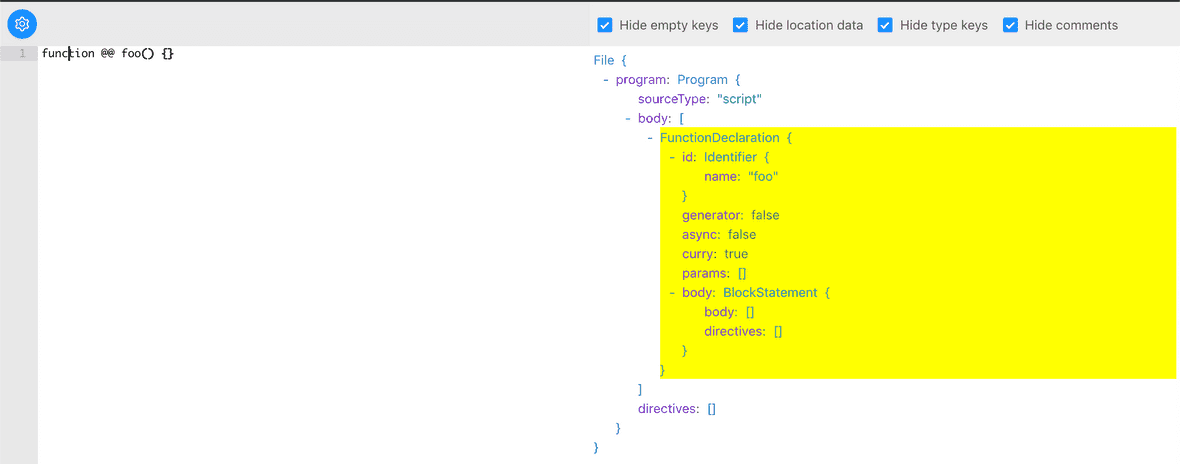
|
||||
|
||||
要实现如上效果,只需在词法分析 `parser/statement` 文件的 `parseFunction` 处新增 `atat` 解析即可:
|
||||
|
||||
```js
|
||||
// packages/babel-parser/src/parser/statement.js
|
||||
|
||||
export default class StatementParser extends ExpressionParser {
|
||||
// ...
|
||||
parseFunction<T: N.NormalFunction>(
|
||||
node: T,
|
||||
statement?: number = FUNC_NO_FLAGS,
|
||||
isAsync?: boolean = false
|
||||
): T {
|
||||
// ...
|
||||
node.generator = this.eat(tt.star);
|
||||
node.curry = this.eat(tt.atat);
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
`eat` 是吃掉的意思,实际上可以理解为吞掉这个 Token,这样做有两个效果:1. 为函数添加了 `curry` 属性 2. 吞掉了 `@@` 标识,保证所有 Token 都被识别是 AST 解析正确的必要条件。
|
||||
|
||||
关于递归下降语法分析的更多知识,可以参考 [精读《手写 SQL 编译器 - 语法分析》](https://github.com/dt-fe/weekly/blob/v2/066.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E8%AF%AD%E6%B3%95%E5%88%86%E6%9E%90%E3%80%8B.md),或者阅读原文。
|
||||
|
||||
我们再次执行测试函数,发现测试通过了,一切都在预料中。
|
||||
|
||||
## babel 插件
|
||||
|
||||
现在我们得到了标记了 `curry` 的 AST,那么最后需要一个 babel 解析插件,实现柯里化。
|
||||
|
||||
首先我们通过修改 babel 源码的方式实现的效果,是可以转化为自定义 babel parser 插件的:
|
||||
|
||||
```js
|
||||
// babel-plugin-transformation-curry-function.js
|
||||
|
||||
import customParser from './custom-parser';
|
||||
|
||||
export default function ourBabelPlugin() {
|
||||
return {
|
||||
parserOverride(code, opts) {
|
||||
return customParser.parse(code, opts);
|
||||
},
|
||||
};
|
||||
}
|
||||
```
|
||||
|
||||
这样就可以实现修改 babel 源码一样的效果,这也是做框架常用的插件机制。
|
||||
|
||||
其次我们要理解如何实现柯里化。柯里化可以通过柯里函数包装后实现:
|
||||
|
||||
```js
|
||||
function currying(fn) {
|
||||
const numParamsRequired = fn.length;
|
||||
function curryFactory(params) {
|
||||
return function (...args) {
|
||||
const newParams = params.concat(args);
|
||||
if (newParams.length >= numParamsRequired) {
|
||||
return fn(...newParams);
|
||||
}
|
||||
return curryFactory(newParams);
|
||||
}
|
||||
}
|
||||
return curryFactory([]);
|
||||
}
|
||||
|
||||
// from
|
||||
function @@ foo(a, b, c) {
|
||||
return a + b + c;
|
||||
}
|
||||
|
||||
// to
|
||||
const foo = currying(function foo(a, b, c) {
|
||||
return a + b + c;
|
||||
})
|
||||
```
|
||||
|
||||
柯里化函数通过构造参数数量相关的递归,当参数传入不足时返回一个新函数,并持久化之前传入的参数,最后当参数齐全后一次性调用函数。
|
||||
|
||||
我们需要做的是,将 `@@ foo` 解析为 `currying()` 函数包裹后的新函数。
|
||||
|
||||
下面就是我们熟悉的 babel 插件部分了:
|
||||
|
||||
```js
|
||||
// babel-plugin-transformation-curry-function.js
|
||||
|
||||
export default function ourBabelPlugin() {
|
||||
return {
|
||||
// ...
|
||||
visitor: {
|
||||
FunctionDeclaration(path) {
|
||||
if (path.get('curry').node) {
|
||||
// const foo = curry(function () { ... });
|
||||
path.node.curry = false;
|
||||
path.replaceWith(
|
||||
t.variableDeclaration('const', [
|
||||
t.variableDeclarator(
|
||||
t.identifier(path.get('id.name').node),
|
||||
t.callExpression(t.identifier('currying'), [
|
||||
t.toExpression(path.node),
|
||||
])
|
||||
),
|
||||
])
|
||||
);
|
||||
}
|
||||
},
|
||||
},
|
||||
};
|
||||
}
|
||||
```
|
||||
|
||||
`FunctionDeclaration` 就是 AST 的 visit 钩子,这个钩子在执行到函数时被触发,我们通过 `path.get('curry')` 拿到 **柯里化函数**,并利用 `replaceWith` 将这个函数构造为一个被 `currying` 函数包裹的新函数。
|
||||
|
||||
剩下最后一个问题:`currying` 函数源码放在哪里。
|
||||
|
||||
第一种方式,创建类似 `babel-plugin-transformation-curry-function` 这样的插件,在 babel 解析时将 `currying` 函数注册到全局,这是全局思维的方案。
|
||||
|
||||
第二种是模块化解决方案,创建一个自定义的 `@babel/helpers`,注册一个 `currying` 标识:
|
||||
|
||||
```js
|
||||
// packages/babel-helpers/src/helpers.js
|
||||
helpers.currying = helper("7.6.0")`
|
||||
export default function currying(fn) {
|
||||
const numParamsRequired = fn.length;
|
||||
function curryFactory(params) {
|
||||
return function (...args) {
|
||||
const newParams = params.concat(args);
|
||||
if (newParams.length >= numParamsRequired) {
|
||||
return fn(...newParams);
|
||||
}
|
||||
return curryFactory(newParams);
|
||||
}
|
||||
}
|
||||
return curryFactory([]);
|
||||
}
|
||||
`;
|
||||
```
|
||||
|
||||
在 visit 函数使用 `addHelper` 方式拿到 `currying`:
|
||||
|
||||
```js
|
||||
path.replaceWith(
|
||||
t.variableDeclaration('const', [
|
||||
t.variableDeclarator(
|
||||
t.identifier(path.get('id.name').node),
|
||||
t.callExpression(this.addHelper("currying"), [
|
||||
t.toExpression(path.node),
|
||||
])
|
||||
),
|
||||
])
|
||||
);
|
||||
```
|
||||
|
||||
这样在 babel 转换后,就会自动 import helper,并引用 helper 中导出的 `currying`。
|
||||
|
||||
最后原文末尾留下了一些延伸阅读内容,感兴趣的同学可以 [点击到原文](https://lihautan.com/creating-custom-javascript-syntax-with-babel/)。
|
||||
|
||||
## 3 精读
|
||||
|
||||
读完这篇文章,相信你不仅对 babel 插件有了更深刻的认识,而且还掌握了如何为 js 添加新语法这种黑魔法。
|
||||
|
||||
我来帮你从 babel 这篇文章总结一些编程模型和知识点,借助 babel 创造自定义语法的实例,加深对它们的理解。
|
||||
|
||||
### TDD
|
||||
|
||||
Test-driven development 即测试驱动的开发模式。
|
||||
|
||||
从文章的例子可以看出,创造一个新语法,可以先在测试用例先写上这个语法,通过执行测试命令通过报错堆栈一步步解决问题。这种方式开发可以让测试覆盖率更高,目的更专注,更容易保障代码质量。
|
||||
|
||||
### 联想编程
|
||||
|
||||
联想编程不属于任何编程模型,但从简介的思路来看,作者把 “为 babel 创建一个新 js 语法” 看作一种探案式探索过程,通过错误堆栈和代码阅读,一步一步通过合理联想实现最终目的。
|
||||
|
||||
在 AST 那一节,还借助了 [Babel AST explorer](https://lihautan.com/babel-ast-explorer/#?eyJiYWJlbFNldHRpbmdzIjp7InZlcnNpb24iOiI3LjYuMCJ9LCJ0cmVlU2V0dGluZ3MiOnsiaGlkZUVtcHR5Ijp0cnVlLCJoaWRlTG9jYXRpb24iOnRydWUsImhpZGVUeXBlIjp0cnVlfSwiY29kZSI6ImZ1bmN0aW9uICogZm9vKCkge30ifQ==) 工具查看 AST 结构,通过联想到 generator 函数找到类似的 AST 结构,并找到拓展 AST 的突破口。
|
||||
|
||||
随着解决问题的不同,联想方式也不同,如果能够举一反三,对不同场景都能合理的联想,才算是具备了技术专家的软素质。
|
||||
|
||||
### 词法、语法分析
|
||||
|
||||
词法、语法分析属于编译原理的知识,理解词法拆分、递归下降,可以帮助你技术走的更深。
|
||||
|
||||
不论是 Babel 插件的使用、还是 Babel 增加自定义 JS 语法,都要具备基本编译原理知识。编译原理知识还能帮助你开发在线编辑器,做智能语法提示等等。
|
||||
|
||||
### 插件机制
|
||||
|
||||
如下是 babel 自定义 parser 的插件拓展方式:
|
||||
|
||||
```js
|
||||
export default function ourBabelPlugin() {
|
||||
return {
|
||||
parserOverride(code, opts) {
|
||||
return customParser.parse(code, opts);
|
||||
},
|
||||
};
|
||||
}
|
||||
```
|
||||
|
||||
这只是插件拓展的一种,有申明式,也有命令式;有用 JS 书写的,也有用 JSON 书写的。babel 选择了通过对象方式拓展,是比较适合对 AST 结构统一处理的。
|
||||
|
||||
做框架首先要确定接口规范,比如 parser,先按照接口规范实现一套官方解析,对接时按照接口进行对接,就可以自然而然被用户自定义插件替代了。
|
||||
|
||||
可以参考的文章: [精读《插件化思维》](https://github.com/dt-fe/weekly/blob/v2/053.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%8F%92%E4%BB%B6%E5%8C%96%E6%80%9D%E7%BB%B4%E3%80%8B.md)
|
||||
|
||||
### 柯里化
|
||||
|
||||
柯里化是面试经常考察的一个知识点,我们能学到的有两点:理解递归、理解如何将函数变成柯里化。
|
||||
|
||||
这里再拓展一下,我们还可以想到 JS 尾递归优化。如何快速写一个支持尾递归的函数?
|
||||
|
||||
```js
|
||||
const fn = tailCallOptimize(() => {
|
||||
if ( /* xxx */ ) {
|
||||
fn()
|
||||
}
|
||||
})
|
||||
```
|
||||
|
||||
通过封装 `tailCallOptimize` 函数,可以很方便的构造一个支持尾递归的函数,这个函数可以这么写:
|
||||
|
||||
```js
|
||||
export function tailCallOptimize<T>(f: T): T {
|
||||
let value: any;
|
||||
let active = false;
|
||||
const accumulated: any[] = [];
|
||||
return function accumulator(this: any) {
|
||||
accumulated.push(arguments);
|
||||
if (!active) {
|
||||
active = true;
|
||||
while (accumulated.length) {
|
||||
value = (f as any).apply(this, accumulated.shift());
|
||||
}
|
||||
active = false;
|
||||
return value;
|
||||
}
|
||||
};
|
||||
}
|
||||
```
|
||||
|
||||
感兴趣的读者可以在评论里解释一下这个函数的原理。
|
||||
|
||||
### AST visit
|
||||
|
||||
遍历 AST 树常采用的方案是做一个遍历器 visitor,所以在遍历过程中进行拓展常采用 babel 这种方式:
|
||||
|
||||
```js
|
||||
return {
|
||||
// ...
|
||||
visitor: {
|
||||
FunctionDeclaration(path) {
|
||||
if (path.get('curry').node) {
|
||||
// const foo = curry(function () { ... });
|
||||
path.node.curry = false;
|
||||
path.replaceWith(
|
||||
t.variableDeclaration('const', [
|
||||
t.variableDeclarator(
|
||||
t.identifier(path.get('id.name').node),
|
||||
t.callExpression(t.identifier('currying'), [
|
||||
t.toExpression(path.node),
|
||||
])
|
||||
),
|
||||
])
|
||||
);
|
||||
}
|
||||
},
|
||||
},
|
||||
};
|
||||
```
|
||||
|
||||
`visitor` 下每一个 key 名都是遍历过程中的拓展点,比如上面的例子,我们可以对函数定义位置进行拓展和改写。
|
||||
|
||||
### 内置函数注册
|
||||
|
||||
babel 提供了两种内置函数注册方式,一种类似 polyfill,在全局注册 window 级的变量,另一种是模块化的方式。
|
||||
|
||||
除此之外,可以学习的是 babel 通过 `this.addHelper("currying")` 这种插件拓展方式,在编译后会自动从 helper 引入对应的模块,前提是 `@babel/helper` 需要注册 `currying` 这个 helper。
|
||||
|
||||
babel 将编译过程隐藏了起来,通过一些高度封装的函数调用,以较为语义化方式书写插件,这样写出来的代码也容易理解。
|
||||
|
||||
## 4 总结
|
||||
|
||||
《用 Babel 创造自定义 JS 语法》这篇文章虽然说的是 babel 相关知识,但可以从中提取到许多通用知识,这就是现在还去理解 babel 的原因。
|
||||
|
||||
从某个功能点为切面,走一遍框架的完整流程是一种高效的进阶学习方式,如果你也有看到类似这样的文章,欢迎推荐出来。
|
||||
|
||||
> 讨论地址是:[精读《用 Babel 创造自定义 JS 语法》 · Issue #210 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/210)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,372 @@
|
||||
## 1 引言
|
||||
|
||||
Flex 与 Grid 相比就像功能键盘和触摸屏。触摸屏的控制力相比功能键盘来说就像是降维打击,因为功能键盘只能上下左右控制(x、y 轴),而触摸屏打破了布局障碍,直接从(z 轴)触达,这样 **无论 UI 内部布局再复杂,都可以通过 touch 直接定位。**
|
||||
|
||||
Flex 是一维布局方式,我们需要不断嵌套 Div 才能形成复杂结构,而一旦布局产生了变化,原有嵌套结构如果不能 “兼容变化” 到新结构,代码就需要重构。而 Grid 就像触摸屏一样,可以二维布局,即便布局方式做了翻天覆地的调整,也仅需少量修改就能适配。
|
||||
|
||||
这就是这次精读 [用 css grid 重新思考布局](https://www.freecodecamp.org/news/css-grid-changes-how-we-can-think-about-structuring-our-content/) 的原因,理解这个革命性布局技术给布局,甚至代码逻辑组织带来的变化。
|
||||
|
||||
## 2 概述
|
||||
|
||||
作者首先抛出了 Flex 的问题,其实是 `block` `float` `flex` 这三种布局模式的通病:
|
||||
|
||||
- 布局结构由 Div 层级结构描述,导致 Div 层级复杂且遇到结构变更时难以维护。
|
||||
- 定制能力弱。Flex 布局有一些不受控制的智能设定,比如宽度 50% 的子元素会被同级元素挤到 50% 以下,这种智能化在某些场景是需要的,但由于没有提供像 Grid 的 `minmax` 之类的 API,所以定制型不足。
|
||||
|
||||
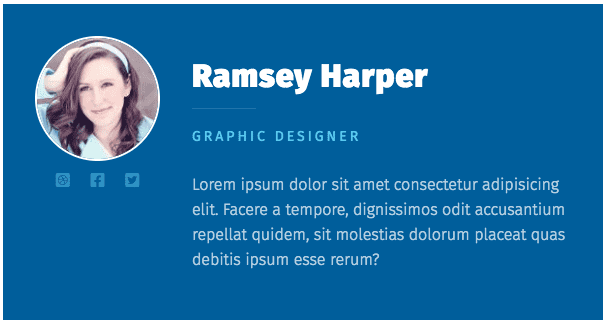
|
||||
|
||||
举个例子,上图的结构用 Flex 描述可能是这样的:
|
||||
|
||||
```html
|
||||
<div class="card">
|
||||
<div class="profile-sidebar">
|
||||
<img src="https://i.pravatar.cc/125?image=3" alt="" class="profile-img" />
|
||||
<ul class="social-list">
|
||||
<li>
|
||||
<a href="#" class="social-link"
|
||||
><i class="fab fa-dribbble-square"></i
|
||||
></a>
|
||||
</li>
|
||||
<li>
|
||||
<a href="#" class="social-link"
|
||||
><i class="fab fa-facebook-square"></i
|
||||
></a>
|
||||
</li>
|
||||
<li>
|
||||
<a href="#" class="social-link"
|
||||
><i class="fab fa-twitter-square"></i
|
||||
></a>
|
||||
</li>
|
||||
</ul>
|
||||
</div>
|
||||
<div class="profile-body">
|
||||
<h2 class="profile-name">Ramsey Harper</h2>
|
||||
<p class="profile-position">Graphic Designer</p>
|
||||
<p class="profile-info">
|
||||
Lorem ipsum dolor sit amet consectetur adipisicing elit. Facere a tempore,
|
||||
dignissimos odit accusantium repellat quidem, sit molestias dolorum
|
||||
placeat quas debitis ipsum esse rerum?
|
||||
</p>
|
||||
</div>
|
||||
</div>
|
||||
```
|
||||
|
||||
利用 HTML 嵌套结构,我们将图形纵向分成两大块,然后在每块内部继续嵌套划分布局,这是最经典的布局行为了。
|
||||
|
||||
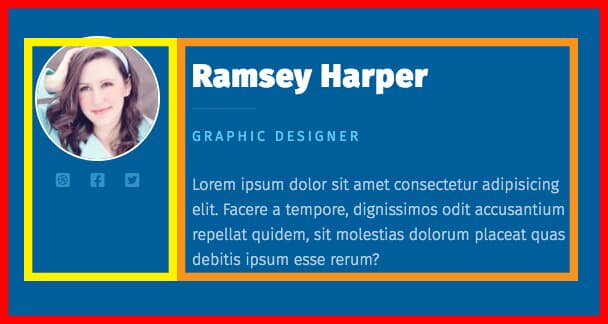
|
||||
|
||||
样式文件里,我们需要对每层布局进行描述,同时支持多分辨率弹性布局,包括顶层 `card` 容器在内的一些样式需要做一定调整:
|
||||
|
||||
```scss
|
||||
.card {
|
||||
width: 80%;
|
||||
margin: 0 auto;
|
||||
display: flex;
|
||||
flex-direction: column;
|
||||
max-width: 600px;
|
||||
background: #005e9b;
|
||||
flex-basis: 250px;
|
||||
color: white;
|
||||
padding: 2em;
|
||||
text-align: center;
|
||||
}
|
||||
|
||||
.profile-info {
|
||||
font-weight: 300;
|
||||
opacity: 0.7;
|
||||
}
|
||||
|
||||
.profile-sidebar {
|
||||
margin-right: 2em;
|
||||
text-align: center;
|
||||
}
|
||||
|
||||
.profile-name {
|
||||
letter-spacing: 1px;
|
||||
font-size: 2rem;
|
||||
margin: 0.75em 0 0;
|
||||
line-height: 1;
|
||||
}
|
||||
|
||||
.profile-name::after {
|
||||
content: "";
|
||||
display: block;
|
||||
width: 2em;
|
||||
height: 1px;
|
||||
background: #5bcbf0;
|
||||
margin: 0.5em auto 0.65em;
|
||||
opacity: 0.25;
|
||||
}
|
||||
|
||||
.profile-position {
|
||||
text-transform: uppercase;
|
||||
font-size: 0.875rem;
|
||||
letter-spacing: 3px;
|
||||
margin: 0 0 2em;
|
||||
line-height: 1;
|
||||
color: #5bcbf0;
|
||||
}
|
||||
|
||||
.profile-img {
|
||||
max-width: 100%;
|
||||
border-radius: 50%;
|
||||
border: 2px solid white;
|
||||
}
|
||||
|
||||
.social-list {
|
||||
list-style: none;
|
||||
justify-content: space-evenly;
|
||||
display: flex;
|
||||
min-width: 125px;
|
||||
max-width: 175px;
|
||||
margin: 0 auto;
|
||||
padding: 0;
|
||||
}
|
||||
|
||||
.social-link {
|
||||
color: #5bcbf0;
|
||||
opacity: 0.5;
|
||||
}
|
||||
|
||||
.social-link:hover,
|
||||
.social-link:focus {
|
||||
opacity: 1;
|
||||
}
|
||||
|
||||
.bio {
|
||||
padding: 2em;
|
||||
display: flex;
|
||||
flex-direction: column;
|
||||
justify-content: center;
|
||||
}
|
||||
|
||||
@media (min-width: 450px) {
|
||||
.bio {
|
||||
text-align: left;
|
||||
max-width: 350px;
|
||||
}
|
||||
}
|
||||
|
||||
.bio-title {
|
||||
color: #0090d1;
|
||||
font-size: 1.25rem;
|
||||
letter-spacing: 1px;
|
||||
text-transform: uppercase;
|
||||
line-height: 1;
|
||||
margin: 0;
|
||||
}
|
||||
|
||||
.bio-body {
|
||||
color: #555;
|
||||
}
|
||||
|
||||
.profile {
|
||||
display: flex;
|
||||
align-items: flex-start;
|
||||
}
|
||||
|
||||
@media (min-width: 450px) {
|
||||
.card {
|
||||
flex-direction: row;
|
||||
text-align: left;
|
||||
}
|
||||
|
||||
.profile-name::after {
|
||||
margin-left: 0;
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
让我们看看 Grid 是怎么做的吧!Grid 有许多 API,我们重点看 `grid-template-areas` 这个属性,利用它,我们可以不关心模块的 HTML 结构,直接平铺方式描述:
|
||||
|
||||
```html
|
||||
<div class="card">
|
||||
<img src="https://i.pravatar.cc/125?image=3" alt="" class="profile-img" />
|
||||
<ul class="social-list">
|
||||
<li>
|
||||
<a href="#" class="social-link"><i class="fab fa-dribbble-square"></i></a>
|
||||
</li>
|
||||
<li>
|
||||
<a href="#" class="social-link"><i class="fab fa-facebook-square"></i></a>
|
||||
</li>
|
||||
<li>
|
||||
<a href="#" class="social-link"><i class="fab fa-twitter-square"></i></a>
|
||||
</li>
|
||||
</ul>
|
||||
<h2 class="profile-name">Ramsey Harper</h2>
|
||||
<p class="profile-position">Graphic Designer</p>
|
||||
<p class="profile-info">
|
||||
Lorem ipsum dolor sit amet consectetur adipisicing elit. Facere a tempore,
|
||||
dignissimos odit accusantium repellat quidem, sit molestias dolorum placeat
|
||||
quas debitis ipsum esse rerum?
|
||||
</p>
|
||||
</div>
|
||||
```
|
||||
|
||||
可以看到,使用 Grid 可以将 UI 结构与 HTML 结构分离,HTML 结构仅描述包含关系,我们只需在样式文件中描述具体 UI 结构。
|
||||
|
||||
样式文件只截取 Grid 相关部分:
|
||||
|
||||
```scss
|
||||
.card {
|
||||
width: 80%;
|
||||
margin: 0 auto;
|
||||
display: flex;
|
||||
flex-direction: column;
|
||||
max-width: 600px;
|
||||
background: #005e9b;
|
||||
flex-basis: 250px;
|
||||
color: white;
|
||||
padding: 2em;
|
||||
text-align: left;
|
||||
|
||||
display: grid;
|
||||
grid-template-columns: 1fr 3fr;
|
||||
grid-column-gap: 2em;
|
||||
grid-template-areas:
|
||||
"image name"
|
||||
"image position"
|
||||
"social description";
|
||||
}
|
||||
|
||||
.profile-name {
|
||||
grid-area: name;
|
||||
}
|
||||
.profile-position {
|
||||
grid-area: position;
|
||||
}
|
||||
.profile-info {
|
||||
grid-area: description;
|
||||
}
|
||||
.profile-img {
|
||||
grid-area: image;
|
||||
}
|
||||
.social-list {
|
||||
grid-area: social;
|
||||
}
|
||||
```
|
||||
|
||||
可以看到,`grid-template-areas` 是进一步抽象的语法,将页面结构通过直观的文本描述,无论是理解还是修改都更为轻松。
|
||||
|
||||
这种描述方式适配不同分辨率下也具有优势,只要重组 `grid-template-areas` 即可:
|
||||
|
||||
```scss
|
||||
@media (min-width: 600px) {
|
||||
.card {
|
||||
text-align: left;
|
||||
grid-template-columns: 1fr 3fr;
|
||||
grid-template-areas:
|
||||
"image name"
|
||||
"image position"
|
||||
"social description";
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
归根结底,Grid 通过二维结构描述,将子元素布局控制收到了父级,使布局描述更加直观。
|
||||
|
||||
最后作者也提到,Flex 依然有使用场景,即简单的一维结构,或者 `space-between` 等 Flex 独有语法的情况。因此推荐整体、复杂的二维布局采用 Grid,一维的简单布局采用 Flex。
|
||||
|
||||
## 3 精读
|
||||
|
||||
Grid 的布局思路给了我很多启发,HTML 结构与 UI 结构的分离有助于减少 DIV 的层级结构,使代码看上去更清晰。
|
||||
|
||||
也许有人会疑惑,Grid 无非将 HTML 布局部分功能挪到了 CSS,整体复杂度应该不变。其实,从 `grid-template-areas` 这个 API 可以看到,Grid 不仅仅将布局功能抽到 CSS 中,更是将布局描述进行了一层抽象,使代码更易维护。
|
||||
|
||||
### 抽象,再抽象
|
||||
|
||||
为什么 Grid 可以对布局进行抽象?因为 Grid 将二维结构都掌握在手中,得到了更大的布局能力,才能进一步将结构化语法抽象为字符串的描述。
|
||||
|
||||
抽象的好处是不言而喻的,你觉得一堆嵌套的 DIV 与下面的代码,哪个更易读呢?
|
||||
|
||||
```scss
|
||||
.card {
|
||||
grid-template-areas:
|
||||
"image name"
|
||||
"image position"
|
||||
"social description";
|
||||
}
|
||||
```
|
||||
|
||||
这就是抽象的好处,一般来说,代码抽象程度越高就越易读,越易维护。
|
||||
|
||||
再看一个 Chrome Grid 插件,将 Grid 可视化显示出来,并可以以 UI 方式进行调整:
|
||||
|
||||
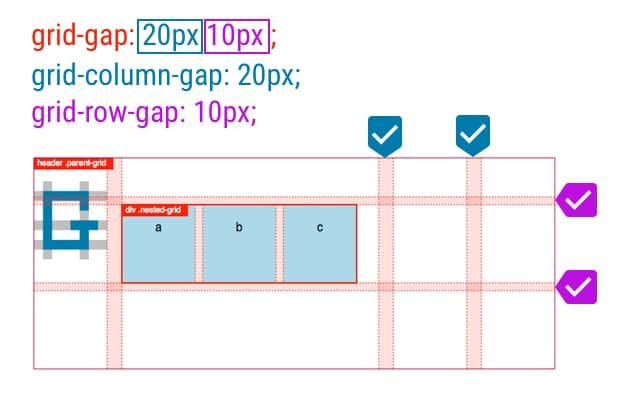
|
||||
|
||||
UI 是对文本的再抽象,同时可以规避一些不可能存在的语法,比如:
|
||||
|
||||
```scss
|
||||
.card {
|
||||
grid-template-areas:
|
||||
"image name"
|
||||
"image position"
|
||||
"social image";
|
||||
}
|
||||
```
|
||||
|
||||
布局只能以凸多边形方式拓展,不可能分离,也不可能突然插入一个其他模块而变成凹多边形。因此 UI 可以将这个错误规避,并简化为横竖多条线的方式对 UI 进行划分,显然这种描述方式效率更高。
|
||||
|
||||
不得不说,Grid 以及图形化插件的探索,是布局领域的一大进步,是不断抽象的尝试,要解决的问题只有一个:如何提供一种更直观的描述 UI 的方式。
|
||||
|
||||
### 布局对模块化的影响
|
||||
|
||||
Grid 将布局方式提高了一个维度,会直接影响到 JS 模块化方式。
|
||||
|
||||
尤其是以 JSX 组织代码的情况下,一个模块等于 UI + JS,通过嵌套方式的布局会让我们更倾向于站在 UI 视角划分模块。
|
||||
|
||||

|
||||
|
||||
比如对于上图模块,如果用 Flex 方式布局,我们可能会首先创建模块 X 作为左侧容器,子元素是 A 和 B,创建模块 Y 作为右侧容器,子元素是 C 以及新容器 Z,Z 容器的子元素是 D 和 E。
|
||||
|
||||
如果你的第一印象是这么组织代码,不得不承认模块化会受到布局方式的影响。虽然许多时候这样划分是正确的,但当这 5 个模块各自没有关联时,我们创建的容器 X、Y、Z 就失去了复用性,在新的组合场景我们又要重新组合一遍。
|
||||
|
||||
但是在 Grid 语法中,我们不需要 X、Y、Z,只需要用 [css grid generator](https://cssgrid-generator.netlify.com/) 按照上图的方式拖拖拽拽即可自动生成如下布局代码:
|
||||
|
||||
```scss
|
||||
.parent {
|
||||
display: grid;
|
||||
grid-template-columns: 3fr repeat(2, 1fr);
|
||||
grid-template-rows: repeat(5, 1fr);
|
||||
grid-column-gap: 0px;
|
||||
grid-row-gap: 0px;
|
||||
}
|
||||
|
||||
.div1 {
|
||||
grid-area: 1 / 1 / 3 / 2;
|
||||
}
|
||||
.div2 {
|
||||
grid-area: 3 / 1 / 6 / 2;
|
||||
}
|
||||
.div3 {
|
||||
grid-area: 1 / 2 / 2 / 4;
|
||||
}
|
||||
.div4 {
|
||||
grid-area: 2 / 2 / 6 / 3;
|
||||
}
|
||||
.div5 {
|
||||
grid-area: 2 / 3 / 6 / 4;
|
||||
}
|
||||
```
|
||||
|
||||
其实 `grid-template-columns` `grid-template-rows` 组合起来使用比 `grid-template-areas` 更强大,但是纯代码方式描述没有 `grid-template-areas` 直观,可是配合一些可视化系统就非常直观了:
|
||||
|
||||

|
||||
|
||||
将 A ~ E 这 5 个模块布局抽出来后,它们之间的关系就打平了,我们可以完全从逻辑视角审视如何做模块化了。
|
||||
|
||||
## 4 总结
|
||||
|
||||
CSS Grid 本质上是一种二维布局的语法,相比 [Block](https://www.w3schools.com/Css/css_inline-block.asp)、[Flex](https://www.w3schools.com/Css/css3_flexbox.asp) 等一维布局方案,多了一个维度可以同时从行与列角度定义布局,因此派生出 `grid-template-areas` 等语法,整体上更内聚更直观,抽象度也更高了。
|
||||
|
||||
理解了这些也就理解了布局未来的发展方向,**让布局与 Dom 分离** 一直是前端的一个梦想,开发 UI 部分时,只需关心页面由哪些模块组成,去实现这些模块就行了,而不需要关心模块之间应该如何组合。在描述组合时,可以通过可视化或比较抽象的字符串描述布局的结构,并对应到写好的模块上,这样的代码维护性远高于用 DIV 描述结构的方案。
|
||||
|
||||
> 讨论地址是:[精读《用 css grid 重新思考布局》 · Issue #211 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/211)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,136 @@
|
||||
## 1 引言
|
||||
|
||||
函数式语言在深度学习领域应用很广泛,因为函数式与深度学习模型的契合度很高,[The Beauty of Functional Languages in Deep Learning — Clojure and Haskell](https://www.welcometothejungle.co/fr/articles/btc-deep-learning-clojure-haskell) 就很好的诠释了这个道理。
|
||||
|
||||
通过这篇文章可以加深我们对深度学习与函数式编程的理解。
|
||||
|
||||
## 2 概述与精读
|
||||
|
||||
深度学习是机器学习中基于人工神经网络模型的一个分支,通过模拟多层神经元的自编码神经网络,将特征逐步抽象化,这需要多维度、大数据量的输入。[TensorFlow](https://www.tensorflow.org/) 和 [PyTorch](https://pytorch.org/) 是比较著名的 Python 深度学习框架,同样 [Keras](https://blog.rstudio.com/2017/09/05/keras-for-r/) 在 R 语言中也很著名。然而在生产环境中,基于 **性能和安全性** 的考虑,一般会使用函数式语言 [Clojure](https://www.clojure.org/) 或 [Haskell](https://www.haskell.org/)。
|
||||
|
||||
在生产环境中,可能要并发出里几百万个参数,因此面临的挑战是:如何高效、安全的执行这些运算。
|
||||
|
||||
**所以为什么函数式编程语言可以胜任深度学习的计算要求呢?** 深度学习的计算模型本质上是数学模型,而数学模型本质上和函数式编程思路是一致的:数据不可变且函数间可以任意组合。这意味着使用函数式编程语言可以更好的表达深度学习的计算过程,因此更容易理解与维护,同时函数式语言内置的 Immutable 数据结构也保障了并发的安全性。
|
||||
|
||||
另外函数式语言的函数之间都是相互隔离的,即便在多线程环境下也不会发生竞争和死锁的情况,函数式编程语言会自动处理这些情况。
|
||||
|
||||
比如说 [Clojure](https://www.clojure.org/),**它甚至可在两个同时修改同一引用的程序并发运行时,自动重试其中之一,而不需要手动加锁**:
|
||||
|
||||
```clojure
|
||||
(import ‘(java.util.concurrent Executors))
|
||||
(defn test-stm [nitems nthreads niters]
|
||||
(let [refs (map ref (repeat nitems 0))
|
||||
pool (Executors/newFixedThreadPool nthreads)
|
||||
tasks (map (fn [t]
|
||||
(fn []
|
||||
(dotimes [n niters]
|
||||
(dosync
|
||||
(doseq [r refs]
|
||||
(alter r + 1 t))))))
|
||||
(range nthreads))]
|
||||
(doseq [future (.invokeAll pool tasks)]
|
||||
(.get future))
|
||||
(.shutdown pool)
|
||||
(map deref refs)))
|
||||
(test-stm 10 10 10000) -> (550000 550000 550000 550000 550000 550000 550000 550000 550000 550000)
|
||||
```
|
||||
|
||||
上面的代码创建了引用(refs),同时创建了多个线程自增这个引用对象,按理说每个线程都修改这个引用会导致竞争状态出现,但从结果来看是正常的,说明 Clojure 引擎在执行时会自动解决这个问题。实际上当两个线程出现竞争而失败时,Clojure 会自动重试其中之一。
|
||||
|
||||
> [原文介绍](https://clojure.org/about/concurrent_programming)
|
||||
|
||||
**Clojure 的另一个优势是并行效率高:**
|
||||
|
||||
```clojure
|
||||
(defn calculate-pixels-2 []
|
||||
(let [n (* *width* *height*)
|
||||
work (partition (/ n 16) (range 0 n))
|
||||
result (pmap (fn [x]
|
||||
(doall (map
|
||||
(fn [p]
|
||||
(let [row (rem p *width*) col (int (/ p *height*))]
|
||||
(get-color (process-pixel (/ row (double *width*)) (/ col (double *height*))))))
|
||||
x)))
|
||||
work)]
|
||||
(doall (apply concat result))))
|
||||
```
|
||||
|
||||
使用 `partition` 结合 `pmap` 可以使并发效率达到最大化,也就是 CPU 几乎都消耗在实际计算上,而不是并行的任务管理与上下文切换。Clojure 凭借 `partition` 对计算进行分区,采取分而治之并对分区计算结果进行合并的思路优化了并发性能。
|
||||
|
||||
> [原文介绍](http://www.fatvat.co.uk/2009/05/jvisualvm-and-clojure.html)
|
||||
|
||||
Clojure 另一个特性是函数链式调用:
|
||||
|
||||
```clojure
|
||||
;; pipe arg to function
|
||||
(-> "x" f1) ; "x1"
|
||||
|
||||
;; pipe. function chaining
|
||||
(-> "x" f1 f2) ; "x12"
|
||||
```
|
||||
|
||||
其中 `(-> "x" f1 f2)` 等价于 `f2(f1("x"))`,这种描述不仅更简洁清晰,也更接近于实际数学模型。
|
||||
|
||||
> [原文介绍](http://xahlee.info/clojure/clojure_function_chaining.html)
|
||||
|
||||
最后,Clojure 还具备计算安全性,计算过程不会修改已有的数据,因此在神经网络的任何一层的原始值都会保留,每层计算都可以独立运行且函数永远幂等。
|
||||
|
||||
[Haskell](https://www.haskell.org/) 也有独特的优势,**它具有类型推断、惰性求值等特性**,被认为更适合用于机器学习。
|
||||
|
||||
类型推断即 Haskell 类型都是静态的,如果试图赋予错误的类型会报错。
|
||||
|
||||
Haskell 的另一个优势是可以非常清晰的描述数学模型。
|
||||
|
||||
想想一般数学模型是怎么描述函数的:
|
||||
|
||||
```text
|
||||
fn =>
|
||||
f1 = 1
|
||||
f2 = 9
|
||||
f3 = 16
|
||||
n > 2, fn = 3fn-3 + 2fn-2 + fn-1
|
||||
```
|
||||
|
||||
一般语言用 `if-else` 描述等价关系,但 Haskell 可以几乎原汁原味的还原函数定义过程:
|
||||
|
||||
```haskell
|
||||
solve :: Int -> Interger
|
||||
solve 1 = 1
|
||||
solve 2 = 9
|
||||
solve 3 = 16
|
||||
solve n = 3 * solve (n - 3) + 2 * solve (n - 2) + solve (n - 1)
|
||||
```
|
||||
|
||||
这使得阅读 Haskell 代码和阅读数学公式一样轻松。
|
||||
|
||||
> [原文](https://blog.jle.im/entry/purely-functional-typed-models-1.html)
|
||||
|
||||
Haskell 另一个优势是惰性求值,即计算会在真正用到时才进行,而不会在计算前提前消费掉,比如:
|
||||
|
||||
```haskell
|
||||
let x = [1..]
|
||||
let y = [2,4 ..]
|
||||
head (tail tail( (zip x y)))
|
||||
```
|
||||
|
||||
可以看到,`x` 与 `y` 分别是 `1,2,3,4,5,6...` 与 `2,4,6,8...` 的无限数组,而 `zip` 函数将其整合为一个新数组 `(1,2),(2,4),(3,6),(4,8)...` 这也是无限数组,如果将 `zip` 函数执行完那么程序就会永远执行下去。但 Haskell 却不会陷入死循环,而是直接输出第一位数字 `1`。这就是惰性计算的特性,无论数组有多长,只有真正用到某项时才对其进行计算,所以哪怕初始数据量或计算量很大,实际消耗的运算资源只取决于这次计算实际用到的部分。
|
||||
|
||||
由于深度学习数据量巨大,惰性求值可以忽略海量数据输入,大大提升计算性能。
|
||||
|
||||
## 3 总结
|
||||
|
||||
本文介绍了为什么深度学习更适合使用函数式语言,以及介绍了 Clojure 与 Haskell 语言的共性:安全性、高性能,以及各自独有的特性,证明了为何这两种语言更适合用在深度学习中。
|
||||
|
||||
在前端领域说到函数式或函数之美,大部分时候想到的是 Class Component 与 Function Component 的关系,这个理解是较为片面的。通过本文我们可以了解到,函数式的思想与数学表达式思想如出一辙,以写数学公式的思维方式写代码,就是一种较好的函数式编程思路。
|
||||
|
||||
函数式应该只有表达式,没有语句,这是因为函数式是为了处理运算而诞生的,因此很适合用在深度学习领域。
|
||||
|
||||
> 讨论地址是:[精读《深度学习 - 函数式之美》 · Issue #212 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/212)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,309 @@
|
||||
## 1 引言
|
||||
|
||||
[Nuxt](https://github.com/nuxt/nuxt.js) 是基于 Vue 的前端开发框架,这次我们通过 [Introduction toNuxtJS](https://www.youtube.com/watch?v=NS0io3Z75GI) 视频了解框架特色以及前端开发框架的基本要素。
|
||||
|
||||
> nuxt 与 [next](https://github.com/zeit/next.js) 结构很像,可以结合在一起看
|
||||
|
||||
视频介绍了 NuxtJs 的安装、目录结构、页面路由、导航模版、asyncData、meta、vueX。
|
||||
|
||||
这是一个入门级视频,所以上面所列举的特征都是一个前端开发框架的最核心的基本要素。一个前端开发框架,安装、目录结构、页面路由、导航模版一定是最要下功夫认真设计的。
|
||||
|
||||
asyncData 和 Vuex 都在解决数据问题,meta 则是通过约定语法控制网页 meta 属性,这部分值得与 React 体系做对比,在精读部分再展开。
|
||||
|
||||
Nuxtjs 前端开发框架不仅提供了脚手架的基本功能,还对项目结构、代码做了约定,以减少代码量。从这点可以看出,脚手架永远围绕两个核心目标:**让每一行源码都在描述业务逻辑;让每个项目结构都相同且易读**。
|
||||
|
||||
20 年前,几百行 HTML、Css、Js 代码就能完成一个完整的项目,只需要遵守 W3C 的基本规范就足够了,每一个项目代码都简单清晰,而且由于没有复杂的业务逻辑,导致代码结构也非常简单。但现在前端项目复杂度逐渐升高,一个大型项目源码数量可能达到几十万行、几百万行,这是 W3C 规范没有设想到的,因此出现了各种工程化与模块化方案解决这个复杂度问题,也引发了各个框架间约定的割裂,且设计合理程度各不相同。
|
||||
|
||||
Nuxtjs 等框架要做的就是定义支持现代大型项目的前端研发标准,这个规范具有网络效应,即用的人越多,价值越大。
|
||||
|
||||
接下来我们进入正题,看看 Nuxt 脚手架定义了怎样的开发规范。
|
||||
|
||||
## 2 概述
|
||||
|
||||
### 安装
|
||||
|
||||
使用 `npx create-nuxt-app app-name` 创建新项目。这个命令与 `create-react-app` 一样,区别主要是模版以及配置不同。
|
||||
|
||||
这个命令本质上是拉取一个模版到本地,并安装 `nuxt` 系列脚本作为项目依赖,并自动生成一系列 npmScripts:
|
||||
|
||||
```json
|
||||
{
|
||||
"scripts": {
|
||||
"dev": "nuxt",
|
||||
"build": "nuxt build",
|
||||
"start": "nuxt start",
|
||||
"generate": "nuxt generate",
|
||||
"lint": "eslint --ext .js,.vue --ignore-path .gitignore .",
|
||||
"test": "jest"
|
||||
},
|
||||
"dependencies": {
|
||||
"nuxt": "^2.0.0"
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
之后即可通过 `npm start` 等命令开发项目,对大部分项目来说,npmScripts 启动是最能达成共识的。
|
||||
|
||||
这种安装方式另一个好处是,依赖都被安装在了本地,即开发环境 100% 内置在项目中。Nuxt 没有采用全局 cli 命令方式执行,第一是 npmScripts 更符合大家通用习惯,不需要记住不同脚手架繁琐的名称与不同约定的启动命令,第二是全局脚手架一旦进行不兼容升级,老项目就面临维护难题。
|
||||
|
||||
### 目录结构
|
||||
|
||||
```text
|
||||
├── .nuxt
|
||||
├── layouts
|
||||
├── pages
|
||||
├── store
|
||||
├── assets
|
||||
├── static
|
||||
├── middleware
|
||||
├── plugins
|
||||
├── nuxt.config.js
|
||||
```
|
||||
|
||||
**pages**
|
||||
|
||||
页面文件存放的目录,路径 + 文件名即路由名,关于更多约定路由的信息,在下一节页面路由详细说明。
|
||||
|
||||
**layouts**
|
||||
|
||||
模版文件存放的目录,文件名即模版名,页面可以通过定义模版在选择使用的模版。
|
||||
|
||||
**store**
|
||||
|
||||
全局数据流目录,在 vueX 章节介绍。
|
||||
|
||||
**assets**、**static**
|
||||
|
||||
分别存放不需被编译的资源文件与非 `.vue` 的静态文件,比如 scss 文件。
|
||||
|
||||
由于 `.vue` 文件集成了 html、js、css,因此一般不会再额外定义样式文件在 static 文件夹中。
|
||||
|
||||
当然,这是 Vue 生态的特别之处,在 React 生态中会存在大量 `.scss` 文件混杂在各个目录中,比较影响阅读。
|
||||
|
||||
**middleware**、**plugins**
|
||||
|
||||
中间件与插件,这两个目录是可选的,作为一种定制化拓展能力。
|
||||
|
||||
**.nuxt**
|
||||
|
||||
为实现约定路由等便捷功能,启动项目时需要自动生成一些文件作为真正项目入口,这些文件就存储在 `.nuxt` 目录下,gitingore 且无需手动修改。
|
||||
|
||||
**nuxt.config.js**
|
||||
|
||||
nuxt 使用 js 文件作为配置文件,比 json 配置文件拓展性更好一些,这个文件也是整个项目唯一的配置文件。
|
||||
|
||||
基本上 **pages**、**layouts**、**store**、**assets**、以及唯一的配置文件基本成为现代前端开发框架的标配。
|
||||
|
||||
### 页面路由
|
||||
|
||||
nuxt 支持约定路由:
|
||||
|
||||
```text
|
||||
├── pages
|
||||
│ ├── home.vue
|
||||
│ └── index.vue
|
||||
```
|
||||
|
||||
上述目录结构描述了两个路由:`/` 与 `/home`。
|
||||
|
||||
也支持参数路由,只要以下划线作为前缀命名文件,就定义了一个动态参数路由:
|
||||
|
||||
```text
|
||||
├── pages
|
||||
│ ├── videos
|
||||
│ │ └── _id.vue
|
||||
```
|
||||
|
||||
`/videos/*` 都会指向这个文件,且可以通过 `$route.params.id` 拿到这个 url 参数。
|
||||
|
||||
另一个特性是嵌套路由:
|
||||
|
||||
```text
|
||||
├── pages
|
||||
│ ├── videos
|
||||
│ │ └── index.vue
|
||||
│ └── videos.vue
|
||||
```
|
||||
|
||||
`videos.vue` 与 `videos/index.vue` 都指向 `/videos` 这个路由,如果这两个文件同时存在,那么外层的 videos 就会作为外层拦截所有 `/videos` 文件夹下的路由,可以通过 `nuxt-child` 透出子元素:
|
||||
|
||||
```html
|
||||
# pages/videos.vue
|
||||
<template>
|
||||
<div>
|
||||
videos
|
||||
<nuxt-child />
|
||||
</div>
|
||||
</template>
|
||||
```
|
||||
|
||||
### 导航模版
|
||||
|
||||
页面公共逻辑,比如导航条可以放在模版里,模版的目录在 `layouts` 文件夹下。
|
||||
|
||||
默认 `layouts/default.vue` 对所有页面生效,但也可以创建例如 `layouts/videos.vue` 特殊导航文件,在 `pages/` 页面文件通过如下申明指定使用这个模版:
|
||||
|
||||
```html
|
||||
<script>
|
||||
export default {
|
||||
layout: "videos"
|
||||
};
|
||||
</script>
|
||||
```
|
||||
|
||||
### asyncData
|
||||
|
||||
`asyncData` 是 nuxt 支持的异步取数函数,可以替代 `data`。
|
||||
|
||||
`data` 函数:
|
||||
|
||||
```html
|
||||
<script>
|
||||
export default {
|
||||
data() {
|
||||
return {};
|
||||
}
|
||||
};
|
||||
</script>
|
||||
```
|
||||
|
||||
对于异步场景,可以用 `asyncData` 替代:
|
||||
|
||||
```html
|
||||
<script>
|
||||
export default {
|
||||
async asyncData() {
|
||||
return await fetch("/");
|
||||
}
|
||||
};
|
||||
</script>
|
||||
```
|
||||
|
||||
### meta
|
||||
|
||||
nuxt 允许在 `.vue` 页面文件自定义 head 标签信息:
|
||||
|
||||
```html
|
||||
<script>
|
||||
export default {
|
||||
headr() {
|
||||
return {
|
||||
title: "",
|
||||
meta: {
|
||||
charset: "utf-8"
|
||||
}
|
||||
};
|
||||
}
|
||||
};
|
||||
</script>
|
||||
```
|
||||
|
||||
这是开发框架提供的特性,不过在 React 体系下可以通过 `useTitle` 等自定义 Hooks 解决此问题,将框架功能降维到代码功能,会更容易理解些。
|
||||
|
||||
### vueX
|
||||
|
||||
nuxt 集成了 [vuex](https://github.com/vuejs/vuex),在 `store/` 文件夹下创建数据模型:
|
||||
|
||||
```js
|
||||
export const state = () => ({
|
||||
videos: [],
|
||||
currentVideo: {}
|
||||
})
|
||||
|
||||
export const mutations = {
|
||||
SET_VIDEOS (state, videos) {
|
||||
state.videos = videos
|
||||
}
|
||||
SET_CURRENT_VIDEO (state, video) {
|
||||
state.currentVideo = video
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
接下来就能在 `pages` 文件夹下的页面组件使用了:
|
||||
|
||||
```html
|
||||
<script>
|
||||
import { mapState } from "vuex";
|
||||
|
||||
export default {
|
||||
async fetch({ $axios, params, store }) {
|
||||
const reponse = await $axios.get(`/videos/${params.id}`);
|
||||
const video = response.data.data.arrtibutes;
|
||||
store.commit("SET_CURRENT_VIDEO", video);
|
||||
}
|
||||
};
|
||||
</script>
|
||||
```
|
||||
|
||||
将 `return` 替换为 `store.commit` 即可,更多语法可以参考 [vuex 文档](https://github.com/vuejs/vuex)。
|
||||
|
||||
## 3 精读
|
||||
|
||||
Nuxtjs 框架做了几件事情:
|
||||
|
||||
1. 统一执行命令。
|
||||
2. 统一开发框架。
|
||||
3. 统一目录与代码规范。
|
||||
4. 内置公共 utils 函数。
|
||||
|
||||
### 统一执行命令
|
||||
|
||||
命令行是所有开发者每天都要用上十几次甚至几十次的场景,试想一下团队中项目分别有如下这么多不同的启动命令会怎么样?
|
||||
|
||||
1. npm start.
|
||||
2. monkey dev.
|
||||
3. npm run ng.
|
||||
4. npm run bootstrap & banana start.
|
||||
5. ...
|
||||
|
||||
我永远不知道下一个项目该如何启动,这大大降低了开发效率。更严重的是,有的项目可以通过 `npm run docs` 查看文档,有的项目不能;有的项目 `npm run build` 可以触发编译,有的项目却无需编译,等等,所谓的环境不一致或者说迁移成本,学习成本,都是由最开始负责搭建项目脚手架的同学对架构设计不一致导致的,**然而没有必须用 `monkey dev` 才能运行起来的项目,但项目却可能因为被设计为 `monkey dev` 启动而显得与其他项目格格不入,甚至难以统一维护。**
|
||||
|
||||
Nuxtjs 等前端开发框架统一执行命令就是为了解决这个问题,统一开发者习惯需要很长的时间周期,但这个趋势不可挡。
|
||||
|
||||
### 统一开发框架
|
||||
|
||||
**虽然现在 React、Vue、Angular 框架各有利弊,但如果一个团队的项目同时使用了两个以上的框架,没有人会觉得这是一件好事。**
|
||||
|
||||
诚然每个框架都有自己的特点,在不同维度都一些优势,但三大框架能并存,说明各自都没有绝对的杀手锏来消灭对方。
|
||||
|
||||
对开源来说,多元化是活力的源动力,但对一家公司来说,多元化就是一场灾难,至今没有一个框架敢说自己的优势是 “与其他框架混合使用可以提升整体开发效率”。
|
||||
|
||||
前端开发框架要解决的最重要问题也是这一点,无论如何只能选择一种开发框架,Nuxtjs 选择了 Vue,Nextjs 选择了 React。
|
||||
|
||||
### 统一目录与代码规范
|
||||
|
||||
目录和代码规范不会从根本上影响项目的通用性,因为不同的目录结构可以通过映射来兼容,不同的代码规范不会影响代码执行。所以目录与代码规范真正影响的是一个程序员对项目的 “解码成本”。
|
||||
|
||||
所谓解码成本,就是程序员理解项目逻辑所需要的成本。如果你是一个销售主管,让团队周报统一用一种格式汇总绝对比 “用自己喜欢的方式汇总” 效率高,而对编程也一样,一个完全不同的目录结构和代码规范对程序员来说是巨大的阅读阻碍,甚至可能引发恶心反应。
|
||||
|
||||
所以不同的目录结构和代码规范是没有必要的壁垒,除非你的团队已经对某种规范产生达成了牢固的共识,否则最好和其他团队共享相同的目录结构与代码规范。改变代码规范是一件很难得事情,但只要不同规范的团队间产生了长期合作关系,规范统一就势必会被提上议程,那么为何不能在公司层面早一点达成共识,提前消除这种痛苦呢?
|
||||
|
||||
所以统一目录与代码规范是前端开发框架需要优先确定的,很多时候不要去质疑为什么目录叫 `layouts` 而不叫 `layout`,因为这个规范背后形成的协同网络规模越大,叫什么名字就越不重要。
|
||||
|
||||
### 内置公共 utils 函数
|
||||
|
||||
让业务开发更聚焦,还可以通过抽取通用的逻辑的方式解决,但需要解决两个问题:
|
||||
|
||||
1. 虽然将公共函数抽成 npm 包可以解决代码复用问题,但关键是怎么保证你的代码能被别人复用?
|
||||
2. 如何让业务通用的 utils 代码有效沉淀并从项目中移除?
|
||||
|
||||
脚手架内置公共 utils 函数就为了解决这个问题。上面几个小节解决了通用命令、框架、规范,但实际代码中,`router` `history` `fetch` `store` 等等概念也都是可以统一的,**没有一个项目必须用定制的 `fetch` 函数才能取数,但一开始就定制了 `fetch` 会导致耦合了不可预期的、没有必要的业务逻辑,成为理解与提效的阻碍。**
|
||||
|
||||
所以统一这些能统一的包,是进一步提效的关键。也许有人会觉得断了自己造轮子的路,但就像我们如今都不会重写浏览器内核逻辑一样,稳定的逻辑不仅带来了全行业的提效,还催生了前端岗位带来大量的就业,同样的,统一底层通用函数,其实是断了无意义产出这条路,每个人都有追求更高价值事情的权利,不要把自己困在反复造 `fetch` 函数这个低水平的活里。
|
||||
|
||||
## 4 总结
|
||||
|
||||
如果一个项目没有使用类似 Nuxtjs 开发框架,它面临的不仅仅是技术选型不统一的问题,久而久之这种项目势必成为 **代码孤岛**,当尘封在代码仓库几年后,一系列文档工具链接都失效后,就成为谁也不想碰,不敢碰的高危代码。
|
||||
|
||||
所以我们今天不仅要看到 Nuxtjs 提供的能力对项目开发有多么便捷,更要看到这类框架带来的协同效应有多么巨大,如果它不能成为整个前端的标准,至少要成为你们公司,或者你们团队的标准。
|
||||
|
||||
> 讨论地址是:[精读《Nuxtjs》 · Issue #213 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/213)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,702 @@
|
||||
## 1 引言
|
||||
|
||||
[React Conf 2019](https://www.youtube.com/watch?v=RCiccdQObpo) 在今年 10 月份举办,内容质量还是一如既往的高,如果想进一步学习前端或者 React,这个大会一定不能错过。
|
||||
|
||||
希望前端精读成为你学习成长路上的布道者,所以本期精读就介绍 React Conf 2019 - Day1 的相关内容。
|
||||
|
||||
总的来看,React Conf 今年的内容视野更广了,不仅仅有技术内容,还有宣扬公益、拓展到移动端、后端,最后还有对 web 发展的总结与展望。
|
||||
|
||||
前端世界正变得越来越复杂,可以看到大家对未来都充满了希望,永不停歇的探索精神是这场大会的主旋律。
|
||||
|
||||
## 2 概述 & 精读
|
||||
|
||||
本期大会思想、设计上的内容较多,具体实现层内容较少,因为行业领导者需要引领规范,而真正技术价值在于思维模型与算法,理解了解题思路,实现它其实并不难。
|
||||
|
||||
### 开发者体验与用户体验
|
||||
|
||||
- 开发者体验:DX(develop experience)
|
||||
- 用户体验:UX(user experience)
|
||||
|
||||
技术人解决的问题总是围绕 DX 与 UX,而一般来说,优化了 DX 往往会带来 UX 的提升,这是因为一个解决开发者体验的技术创新往往也会带来用户体验的升级,至少也能让开发者有更好的心情、更充足的时间做出好产品。
|
||||
|
||||
如何优化开发者体验呢?
|
||||
|
||||
**易上手**
|
||||
|
||||
React 确实致力于解决这个问题,因为 React 实际上是一个开发者桥梁,无论你开发 web、ios 还是单片机,都可以通过一套统一的语法去实现。React 是一个协议标准(读到 reactReconciler 章节会更有体感),React 像 HTML,但 React 不止能构建 HTML 应用,React 希望构建一切。
|
||||
|
||||
**高效开发**
|
||||
|
||||
React 解决调试、工具问题,让开发者更高效的完成工作,这也是开发者体验重要组成部分。
|
||||
|
||||
**弹性**
|
||||
|
||||
React 编写的程序拥有良好可维护性,包括数据驱动、模块化等等特征都是为了更好服务于不同规模的团队。
|
||||
|
||||
对于 UX 问题,React 也有 Concurrent mode、Suspense 等方案。
|
||||
|
||||
虽然 React 还不完美,但 React 致力于解决 DX 与 UX 的目标和效果都是我们有目共睹的,更好的 DX、UX 一定是前端技术未来发展的大趋势。
|
||||
|
||||
### 样式方案
|
||||
|
||||
Facebook 使用 css-in-js,而今年的 React conf 给出了一种技术方案,将 413 kb 的样式文件体积降低到 74kb!
|
||||
|
||||
一步步了解这个方案,从用法开始:
|
||||
|
||||
```tsx
|
||||
const styles = stylex.create({
|
||||
blue: { color: "blue" },
|
||||
red: { color: "red" }
|
||||
});
|
||||
|
||||
function MyComponent(props) {
|
||||
return <span className={styles("blue", "red")}>I'm red now!</span>;
|
||||
}
|
||||
```
|
||||
|
||||
如上是这个方案的写法,通过 `stylex.create` 创建样式,通过 `styles()` 使用样式。
|
||||
|
||||
**主题方案**
|
||||
|
||||
如果使用 CSS 变量定义主题,那么换肤就可以由最外层 `class` 轻松决定了:
|
||||
|
||||
```scss
|
||||
.old-school-theme {
|
||||
--link-text: blue;
|
||||
}
|
||||
|
||||
.text-link {
|
||||
color: var(--link-text);
|
||||
}
|
||||
```
|
||||
|
||||
字体颜色具体的值由外层 `class` 决定,因此外层的 `class` 就可以控制所有子元素的样式:
|
||||
|
||||
```html
|
||||
<div class="old-school-theme">
|
||||
<a class="text-link" href="...">
|
||||
I'm blue!
|
||||
</a>
|
||||
</div>
|
||||
```
|
||||
|
||||
将其封装成 React 组件,也不需要用 `context` 等 JS 能力,而是包裹一层 `class` 即可。
|
||||
|
||||
```tsx
|
||||
function ThemeProvider({ children, theme }) {
|
||||
return <div className={themes[theme]}>{children}</div>;
|
||||
}
|
||||
```
|
||||
|
||||
**图标方案**
|
||||
|
||||
下面是设计师给出的 svg 代码:
|
||||
|
||||
```tsx
|
||||
<svg viewBox="0 0 100 100">
|
||||
<path d="M9 25C8 25 8..." />
|
||||
</svg>
|
||||
```
|
||||
|
||||
将其包装为 React 组件:
|
||||
|
||||
```tsx
|
||||
function SettingsIcon(props) {
|
||||
return (
|
||||
<SVGIcon viewBox="0 0 100 100" {...props}>
|
||||
<path d="M9 25C8 25 8..." />
|
||||
</SVGIcon>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
结合上面提到的主题方案,就可以控制 svg 的主题颜色。
|
||||
|
||||
```tsx
|
||||
const styles = stylex.create({
|
||||
primary: { fill: "var(--primary-icon)" },
|
||||
gighlight: { fill: "var(--highlight-icon)" }
|
||||
});
|
||||
|
||||
function SVGIcon(color, ...props) {
|
||||
return (
|
||||
<svg>
|
||||
{...props}
|
||||
className={styles({
|
||||
primary: color === "primary",
|
||||
highlight: color === "highlight"
|
||||
})}
|
||||
{children}
|
||||
</svg>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
**减少样式大小的秘密**
|
||||
|
||||
```tsx
|
||||
const styles = stylex.create({
|
||||
blue: { color: "blue" },
|
||||
default: { color: "red", fontSize: 16 }
|
||||
});
|
||||
|
||||
function MyComponent(props) {
|
||||
return <span className={styles("default", props.isBlue && "blue")} />;
|
||||
}
|
||||
```
|
||||
|
||||
对于上述样式文件代码,最终会编译成 `c1`、`c2`、`c3` 三个 `class`:
|
||||
|
||||
```scss
|
||||
.c1 {
|
||||
color: blue;
|
||||
}
|
||||
.c2 {
|
||||
color: red;
|
||||
}
|
||||
.c3 {
|
||||
font-size: 16px;
|
||||
}
|
||||
```
|
||||
|
||||
出乎意料的是,并没有根据 `blue` 和 `default` 生成对应的 `class`,而是根据实际样式值生成 `class`,这样做有什么好处呢?
|
||||
|
||||
首先是加载顺序,`class` 生效的顺序与加载顺序有关,而按照样式值生成的 `class` 可以精确控制样式加载顺序,使其与书写顺序对应:
|
||||
|
||||
```tsx
|
||||
// 效果可能是 blue 而不是 red
|
||||
<div className="blue red" />
|
||||
|
||||
// 效果一定是 red,因为 css-in-js 在最终编排 class 时,虽然两种样式都存在,但书写顺序导致最后一个优先级最高,
|
||||
// 合并的时候就会舍弃失效的那个 class
|
||||
<div className={styles('blue', 'red')} />
|
||||
```
|
||||
|
||||
这么做永远不会出现头疼的样式覆盖问题。
|
||||
|
||||
更重要的是,随着样式文件的增多,`class` 总量会减少。这是因为新增的 `class` 涵盖的属性可能已经被其他 `class` 写到并生成了,此时会直接复用对应属性生成的 `class` 而不会生成新的:
|
||||
|
||||
```tsx
|
||||
<Component1 className=".class1"/>
|
||||
<Component2 className=".class2"/>
|
||||
```
|
||||
|
||||
```scss
|
||||
.class1 {
|
||||
background-color: mediumseagreen;
|
||||
cursor: default;
|
||||
margin-left: 0px;
|
||||
}
|
||||
.class2 {
|
||||
background-color: thistle;
|
||||
cursor: default;
|
||||
justify-self: flex-start;
|
||||
margin-left: 0px;
|
||||
}
|
||||
```
|
||||
|
||||
正如这个 Demo 所示,正常情况的 `class1` 与 `class2` 存在许多重复定义的属性,但换成 css-in-js 的方案,编译后的效果等价于将 `class` 复用并拆解了:
|
||||
|
||||
```tsx
|
||||
<Component1 classNames=".classA .classB .classD">
|
||||
|
||||
<Component2 classNames=".classA .classC .classD .classE">
|
||||
```
|
||||
|
||||
```scss
|
||||
.classA {
|
||||
cursor: default;
|
||||
}
|
||||
.classB {
|
||||
background-color: mediumseagreen;
|
||||
}
|
||||
.classC {
|
||||
background-color: thistle;
|
||||
}
|
||||
.classD {
|
||||
margin-left: 0px;
|
||||
}
|
||||
.classE {
|
||||
justify-self: flex-start;
|
||||
}
|
||||
```
|
||||
|
||||
这种方式不仅节省空间、还能自动计算样式优先级避免冲突,并将 413 kb 的样式文件体积降低到 74kb。
|
||||
|
||||
### 字体大小方案
|
||||
|
||||
`rem` 的好处是相对的字体大小,使用 `rem` 作为单位可以很方便实现网页字体大小的切换。
|
||||
|
||||
但问题是现在工业设计都习惯了以 px 作为单位,所以一种全新的编译方案产生了:在编译阶段将 `px` 自动转换成 `rem`。
|
||||
|
||||
这等于让以 `px` 为单位的字体大小可以跟随根节点字体大小随意缩放。
|
||||
|
||||
### 代码检测
|
||||
|
||||
静态检测类型错误、拼写错误、浏览器兼容问题。
|
||||
|
||||
在线检测 dom 节点元素问题,比如是否有可访问性,比如替代文案 aria-label。
|
||||
|
||||
### 提升加载速度
|
||||
|
||||
普通网页的加载流程是这样的:
|
||||
|
||||

|
||||
|
||||
先加载代码,然后会渲染页面,在渲染的同时发取数请求,等取数完成后才能渲染出真实数据。
|
||||
|
||||
那么如何改善这个情况呢?首先是预取数,提前解析出请求并在脚本加载的同时取数,可以节省大量时间:
|
||||
|
||||
|
||||
|
||||
那么下载的代码可以再拆分吗?注意到并不是所有代码都作用于 UI 渲染,我们可以将模块分为 `ImportForDisplay` 与 `importForAfterDisplay` :
|
||||
|
||||

|
||||
|
||||
这样就可以优先加载与 UI 相关的代码,其余逻辑代码在页面展示出之后再加载:
|
||||
|
||||

|
||||
|
||||
这样可以实现源码分段加载,并分段渲染:
|
||||
|
||||

|
||||
|
||||
对取数来说也是如此,并不是所有取数都是初始化渲染阶段必须用上的。可以通过 `relay` 的特性 `@defer` 标记出可以延迟加载的数据:
|
||||
|
||||
```relay
|
||||
fragment ProfileData on User {
|
||||
classNameprofile_picture { ... }
|
||||
|
||||
...AdditionalData @defer
|
||||
}
|
||||
```
|
||||
|
||||
这下取数也可以分段了,首屏的数据会优先加载:
|
||||
|
||||

|
||||
|
||||
利用 `relay` 还可以以数据驱动方式结合代码拆分:
|
||||
|
||||
```relay
|
||||
... on Post {
|
||||
... on PhotoPost {
|
||||
@module('PhotoComponent.js')
|
||||
photo_data
|
||||
}
|
||||
|
||||
... on VideoPost {
|
||||
@module('VideoComponent.js')
|
||||
video_data
|
||||
}
|
||||
|
||||
... on SongPost {
|
||||
@module('SongComponent.js')
|
||||
song_data
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
这样首屏数据中也只会按需加载用到的部分,请求时间可以再次缩短:
|
||||
|
||||

|
||||
|
||||
可以看到,与 relay 结合可以进一步优化加载性能。
|
||||
|
||||
### 加载体验
|
||||
|
||||
可以 `React.Suspense` 与 `React.lazy` 动态加载组件。通过 `fallback` 指定元素的占位图可以提升加载体验:
|
||||
|
||||
```tsx
|
||||
<React.Suspense fallback={<MyPlaceholder />}>
|
||||
<Post>
|
||||
<Header />
|
||||
<Body />
|
||||
<Reactions />
|
||||
<Comments />
|
||||
</Post>
|
||||
</React.Suspense>
|
||||
```
|
||||
|
||||
`Suspense` 可以被嵌套,资源会按嵌套顺序加载,保证一个自然的视觉连贯性。
|
||||
|
||||
### 智能文档
|
||||
|
||||
通过解析 Markdown 自动生成文档大家已经很熟悉了,也有很多现成的工具可以用,但这次分享的文档系统有意思之处在于,可以动态修改源码并实时生效。
|
||||
|
||||

|
||||
|
||||
不仅如此,还利用了 Typescript + MonacoEditor 在网页上做语法检测与 API 自动提示,这种文档体验上升了一个档次。
|
||||
|
||||
虽然没有透露技术实现细节,但从热更新的操作来看像是把编译工作放在了浏览器 web worker 中,如果是这种实现方式,原理与 [CodeSandbox 实现原理](https://segmentfault.com/a/1190000019679430) 类似。
|
||||
|
||||
### GraphQL and Stuff
|
||||
|
||||
这一段在安利利用接口自动生成 Typescript 代码提升前后端联调效率的工具,比如 go2dts。
|
||||
|
||||
我们团队也开源了基于 swagger 的 Typescript 接口自动生成工具 [pont](https://github.com/alibaba/pont),欢迎使用。
|
||||
|
||||
### React Reconciler
|
||||
|
||||
这是知识密度最大的一节,介绍了如何使用 React Reconclier。
|
||||
|
||||
React Reconclier 可以创建基于任何平台的 React 渲染器,也可以理解为通过 React Reconclier 可以创建自定义的 ReactDOM。
|
||||
|
||||
比如下面的例子,我们尝试用自定义函数 `ReactDOMMini` 渲染 React 组件:
|
||||
|
||||
```jsx
|
||||
import React from "react";
|
||||
import logo from "./logo.svg";
|
||||
import ReactDOMMini from "./react-dom-mini";
|
||||
import "./App.css";
|
||||
|
||||
function App() {
|
||||
const [showLogo, setShowLogo] = React.useState(true);
|
||||
|
||||
let [color, setColor] = React.useState("red");
|
||||
React.useEffect(() => {
|
||||
let colors = ["red", "green", "blue"];
|
||||
let i = 0;
|
||||
let interval = setInterval(() => {
|
||||
i++;
|
||||
setColor(colors[i % 3]);
|
||||
}, 1000);
|
||||
|
||||
return () => clearInterval(interval);
|
||||
});
|
||||
|
||||
return (
|
||||
<div
|
||||
className="App"
|
||||
onClick={() => {
|
||||
setShowLogo(show => !show);
|
||||
}}
|
||||
>
|
||||
<header className="App-header">
|
||||
{showLogo && <img src={logo} className="App-logo" alt="logo /" />}
|
||||
// 自创语法
|
||||
<p bgColor={color}>
|
||||
Edit <code>src/App.js</code> and save to reload.
|
||||
</p>
|
||||
<a
|
||||
className="App-link"
|
||||
href="https://reactjs.org"
|
||||
target="_blank"
|
||||
rel="noopener noreferrer"
|
||||
>
|
||||
Learn React{" "}
|
||||
</a>
|
||||
</header>
|
||||
</div>
|
||||
);
|
||||
}
|
||||
|
||||
ReactDOMMini.render(<App />, codument.getElementById("root"));
|
||||
```
|
||||
|
||||
`ReactDOMMini` 是利用 `ReactReconciler` 生成的自定义组件渲染函数,下面是完整的代码:
|
||||
|
||||
```typescript
|
||||
import ReactReconciler from "react-reconciler";
|
||||
|
||||
const reconciler = ReactReconciler({
|
||||
createInstance(
|
||||
type,
|
||||
props,
|
||||
rootContainerInstance,
|
||||
hostContext,
|
||||
internalInstanceHandle
|
||||
) {
|
||||
const el = document.createElement(type);
|
||||
|
||||
["alt", "className", "href", "rel", "src", "target"].forEach(key => {
|
||||
if (props[key]) {
|
||||
el[key] = props[key];
|
||||
}
|
||||
});
|
||||
|
||||
// React 事件代理
|
||||
if (props.onClick) {
|
||||
el.addEventListener("click", props.onClick);
|
||||
}
|
||||
|
||||
// 自创 api bgColor
|
||||
if (props.bgColor) {
|
||||
el.style.backgroundColor = props.bgColor;
|
||||
}
|
||||
|
||||
return el;
|
||||
},
|
||||
|
||||
createTextInstance(
|
||||
text,
|
||||
rootContainerInstance,
|
||||
hostContext,
|
||||
internalInstanceHandle
|
||||
) {
|
||||
return document.createTextNode(text);
|
||||
},
|
||||
|
||||
appendChildToContainer(container, child) {
|
||||
container.appendChild(child);
|
||||
},
|
||||
appendChild(parent, child) {
|
||||
parent.appendChild(child);
|
||||
},
|
||||
appendInitialChild(parent, child) {
|
||||
parent.appendChild(child);
|
||||
},
|
||||
|
||||
removeChildFromContainer(container, child) {
|
||||
container.removeChild(child);
|
||||
},
|
||||
removeChild(parent, child) {
|
||||
parent.removeChild(child);
|
||||
},
|
||||
insertInContainerBefore(container, child, before) {
|
||||
container.insertBefore(child, before);
|
||||
},
|
||||
insertBefore(parent, child, before) {
|
||||
parent.insertBefore(child, before);
|
||||
},
|
||||
|
||||
prepareUpdate(
|
||||
instance,
|
||||
type,
|
||||
oldProps,
|
||||
newProps,
|
||||
rootContainerInstance,
|
||||
currentHostContext
|
||||
) {
|
||||
let payload;
|
||||
if (oldProps.bgColor !== newProps.bgColor) {
|
||||
payload = { newBgCOlor: newProps.bgColor };
|
||||
}
|
||||
return payload;
|
||||
},
|
||||
commitUpdate(
|
||||
instance,
|
||||
updatePayload,
|
||||
type,
|
||||
oldProps,
|
||||
newProps,
|
||||
finishedWork
|
||||
) {
|
||||
if (updatePayload.newBgColor) {
|
||||
instance.style.backgroundColor = updatePayload.newBgColor;
|
||||
}
|
||||
}
|
||||
});
|
||||
|
||||
const ReactDOMMini = {
|
||||
render(wahtToRender, div) {
|
||||
const container = reconciler.createContainer(div, false, false);
|
||||
reconciler.updateContainer(whatToRender, container, null, null);
|
||||
}
|
||||
};
|
||||
|
||||
export default ReactDOMMini;
|
||||
```
|
||||
|
||||
笔者拆解一下说明:
|
||||
|
||||
React 之所以具备跨平台特性,是因为其渲染函数 `ReactReconciler` **只关心如何组织组件与组件间关系,而不关心具体实现**,所以会暴露出一系列回调函数。
|
||||
|
||||
**创建实例**
|
||||
|
||||
由于 React 组件本质是一个描述,即 `tag` + 属性,所以 `Reconciler` 不关心元素是如何创建的,需要通过 `createInstance` 拿到组件基本属性,在 Web 平台利用 DOM API 实现:
|
||||
|
||||
```typescript
|
||||
createInstance(
|
||||
type,
|
||||
props,
|
||||
rootContainerInstance,
|
||||
hostContext,
|
||||
internalInstanceHandle
|
||||
) {
|
||||
const el = document.createElement(type);
|
||||
|
||||
["alt", "className", "href", "rel", "src", "target"].forEach(key => {
|
||||
if (props[key]) {
|
||||
el[key] = props[key];
|
||||
}
|
||||
});
|
||||
|
||||
// React 事件代理
|
||||
if (props.onClick) {
|
||||
el.addEventListener("click", props.onClick);
|
||||
}
|
||||
|
||||
// 自创 api bgColor
|
||||
if (props.bgColor) {
|
||||
el.style.backgroundColor = props.bgColor;
|
||||
}
|
||||
|
||||
return el;
|
||||
}
|
||||
```
|
||||
|
||||
之所以说 React 对 DOM 事件都做了一层代理,是因为 JSX 的所有函数都没有真正透传给 DOM,而是通过类似 `el.addEventListener("click", props.onClick)` 的方式代理实现的。
|
||||
|
||||
而自定义这个函数,我们甚至能创建例如 `bgColor` 这种特殊语法,只要解析引擎实现了这个语法的 Handler。
|
||||
|
||||
除此之外,还有 **创建、删除实例** 的回调函数,我们都要利用 DOM 平台的 API 重新实现一遍,这样不仅可以实现对浏览器 API 的兼容,还可以对接到比如 react-native 等非 WEB 平台。
|
||||
|
||||
**更新组件**
|
||||
|
||||
实现了 `prepareUpdate` 与 `commitUpdate` 才能完成组件更新。
|
||||
|
||||
`prepareUpdate` 返回的 `payload` 被 `commitUpdate` 函数接收到,并根据接收到的信息决定如何更新实例节点。这个实例节点就是 `createInstance` 回调函数返回的对象,所以如果在 WEB 环境返回的 instance 就是 DOMInstance,后续所有操作都使用 DOMAPI。
|
||||
|
||||
总结一下:`react` 主要用平台无关的语法生成具有业务含义的 AST,而利用 `react-reconciler` 生成的渲染函数可以解析这个 AST,并提供了一系列回调函数实现完整的 UI 渲染功能,`react-dom` 现在也是基于 `react-reconciler` 写的。
|
||||
|
||||
### 图标体积优化
|
||||
|
||||
Facebook 团队通过优化,将图标大小从 4046.05KB 降低到了 132.95kb,体积减少了惊人的 96.7%,减少体积占总包体积的 19.6%!
|
||||
|
||||
实现方式很简单,下面是原始图标使用的代码:
|
||||
|
||||
```jsx
|
||||
<FontAwesomeIcon icon="coffee" />
|
||||
<Icon icon={["fab", "twitter"]} />
|
||||
<Button leftIcon="user" />
|
||||
<FeatureGroup.Item icon="info" />
|
||||
<FeatureGroup.Item icon={["fail", "info"]} />
|
||||
```
|
||||
|
||||
在编译期间通过 AST 分析,将所有字符串引用换成了图标实例的引用,利用 webpack 的 tree-shaking 功能实现按需加载,从而删除了没有使用到的图标。
|
||||
|
||||
```jsx
|
||||
import {faCoffee,faInfo,faUser} from "@fontawesome/free-solid-svg-icons"
|
||||
import {faTwitter} from '@fontawesome/free-brands-svg-icons'
|
||||
import {faInfo as faInfoFal} from '@fontawesome/pro-light-svg-icons'
|
||||
|
||||
<FontAwesomeIcon icon={faCoffee} />
|
||||
<Icon icon={faTwitter} />
|
||||
<Button leftIcon={faUser} />
|
||||
<FeatureGroup.Item icon={faInfo} />
|
||||
<FeatureGroup.Item icon={faInfoFal} />
|
||||
```
|
||||
|
||||
[替换工具](https://github.com/skovy/font-awesome-codemod) 的链接放出来了,感兴趣的同学可以点进去了解更多。
|
||||
|
||||
这也从某种意义上说明了 iconFont 注定被淘汰,因为字体文件目前无法按需加载,只有全部使用 SVG 图标的项目才能使用这种优化。
|
||||
|
||||
### Git & Github
|
||||
|
||||
这一节介绍了基本 Git 知识以及 Github 用法,笔者略过比较水的部分,直接列出两个可能你不知道的点:
|
||||
|
||||
**干预 Github 项目主要语言检测**
|
||||
|
||||
如果你提交的代码包含许多自动生成的文件,可能你实际使用的语言不会被 Github 解析为主要语言,这时候可以通过 `.gitattributes` 文件忽略指定文件夹的检测:
|
||||
|
||||
```text
|
||||
static/* linguist-vendored
|
||||
```
|
||||
|
||||
这样语言文件占比统计就会忽略 `static/` 文件夹。
|
||||
|
||||
**Git hooks 的技巧**
|
||||
|
||||
以下是几个比较具有启发的点,我们可以利用 Git hooks 做点什么:
|
||||
|
||||
- 阻止提交到 master。
|
||||
- 在 commit 之前执行 prettier/eslint/jest 检测。
|
||||
- 检测代码规范、合并冲突、检测是否有大文件。
|
||||
- commit 成功后给出提示或记录到日志。
|
||||
|
||||
但 Git hooks 仍然有局限性:
|
||||
|
||||
- 容易被绕过:--no-verifuy --no-merge --no-checkout ---force。
|
||||
- 本地 hooks 无法提交,导致项目开发规则可能不尽相同。
|
||||
- 无法替代 CI、服务端分支保护、Code Review。
|
||||
|
||||
可以畅想一下,在 WebIDE 环境可以通过自定义 git 命令禁止检测绕过,自然解决第二条环境不一致的问题。
|
||||
|
||||
### GraphQL + Typescript
|
||||
|
||||
GraphQL 是没有类型支持的,如果要手动创建一遍类型文件是非常痛苦的:
|
||||
|
||||
```typescript
|
||||
interface GetArticleData {
|
||||
getArticle: {
|
||||
id: number;
|
||||
title: string;
|
||||
};
|
||||
}
|
||||
|
||||
const query = graphql(gql`
|
||||
query getArticle {
|
||||
article {
|
||||
id
|
||||
title
|
||||
}
|
||||
}
|
||||
`);
|
||||
|
||||
apolloClient.query<GetArticleData>(query);
|
||||
```
|
||||
|
||||
同样的代码分散在两处维护一定会带来问题,我们可以利用比如 `typed-graphqlify` 这种库解决类型问题:
|
||||
|
||||
```typescript
|
||||
import { params, types, query } from "typed-graphqlify";
|
||||
|
||||
const getArticleQuery = {
|
||||
article: params({
|
||||
id: types.number,
|
||||
title: types.string
|
||||
})
|
||||
};
|
||||
|
||||
const gqlString = query("getUser", getUserQuery);
|
||||
```
|
||||
|
||||
只要一遍定义就可以自动生成 GQLString,并且拿到 Typescript 类型。
|
||||
|
||||
### React 文档国际化
|
||||
|
||||
即便是谷歌翻译也不是很靠谱,国际化文档还是要靠人肉,[Nat Alison](https://github.com/tesseralis) 利用 Github 充分发动各国人民的力量,共同打造了一个个 reactjs group 下的国际化仓库。
|
||||
|
||||
国际化仓库命名规则是 `reactjs/xx.reactjs.org`,比如简体中文的国际化仓库是:https://github.com/reactjs/zh-hans.reactjs.org
|
||||
|
||||
从仓库的 readme 可以看到维护规则是这样的:
|
||||
|
||||
- 请 fork 这个仓库。
|
||||
- 基于 fork 后的仓库中 master 分支拉取一个新的分支(名字自取)。
|
||||
- 翻译(校对)你所选择的文章,提交到新的分支。
|
||||
- 此时提交 Pull Request 到该仓库。
|
||||
- 会有专人 Review 该 Pull Request,当两人以上通过该 Pull Request 时,你的翻译将被合并到仓库中。
|
||||
- 删除你所创建的分支(如继续参与,参考同步流程)。
|
||||
|
||||
之后定期从 React 官方文档项目拉取最新代码即可保持文档的同步更新。
|
||||
|
||||
### 你需要 redux 吗?
|
||||
|
||||
关于数据流的话题目前没有什么新意,但这次 React Conf 关于数据流总结的算是比较真诚的,总结了以下几个点:
|
||||
|
||||
1. 全局数据流现在不是必须的,比如 Redux,但也不能说完全不能用,至少在全局状态较为复杂时有必要使用。
|
||||
2. 不要只使用一种数据流方案,根据状态的作用域确定方案比较好。
|
||||
3. 工程技术与科学不同,工程世界没有最好的方案,只有更好的方案。
|
||||
4. 就算有了完美方案也不要停止学习的步伐,总会有新知识产生。
|
||||
|
||||
### web 历史
|
||||
|
||||
很精彩的演讲,不过新鲜内容并不多,比较有感触一点是:以前的网页地址对应到的是服务器磁盘的某个具体文件,比如早期 php 应用,现在后端不再是文件化而是服务化了,这层抽象让服务端摆脱了对文件结构的依赖,可以构建更多复杂动态逻辑,也支持了前后端分离的技术方案。
|
||||
|
||||
## 3 总结
|
||||
|
||||
这届 React Conf 让我们看到前端更多的可能性,我们不仅要关注技术实现细节,更要关注行业标准以及团队愿景。
|
||||
|
||||
React 团队的愿景是让 React 包罗万象,提升全球开发者的开发体验、提升全球产品的用户体验,基于这个目标,React Conf 自然不能只包含 DOM Diff、Reconciler 等等技术细节,更需要展示 React 如何帮助全球开发者,如何让这些开发者帮助到用户,如何推动行业标准的演进,如何让 React 打破国界、语言的壁垒。
|
||||
|
||||
相比其他前端大会非常多的干货来说,React Conf 虽然显得主题比较杂,但这正是人文情怀的体现,我相信只有带着更高的使命愿景,真诚帮助他人的技术团队才可以走得更远。
|
||||
|
||||
> 讨论地址是:[精读《React Conf 2019 - Day1》 · Issue #214 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/214)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,464 @@
|
||||
## 1 引言
|
||||
|
||||
取数是前端业务的重要部分,也经历过几次演化:
|
||||
|
||||
- [fetch](https://developer.mozilla.org/en-US/docs/Web/API/Fetch_API) 的兼容性已经足够好,足以替换包括 `$.post` 在内的各种取数封装。
|
||||
- 原生用得久了,发现拓展性更好、支持 ssr 的同构取数方案也挺好,比如 [isomorphic-fetch](https://github.com/matthew-andrews/isomorphic-fetch)、[axios](https://github.com/axios/axios)。
|
||||
- 对于数据驱动场景还是不够,数据流逐渐将取数封装起来,同时针对数据驱动状态变化管理进行了 `data` `isLoading` `error` 封装。
|
||||
- Hooks 的出现让组件更 Reactive,我们发现取数还是优雅回到了组件里,[swr](https://github.com/zeit/swr) 就是一个教科书般的例子。
|
||||
|
||||
[swr](https://github.com/zeit/swr) 在 2019.10.29 号提交,仅仅 12 天就攒了 4000+ star,平均一天收获 300+ star!本周精读就来剖析这个库的功能与源码,了解这个 React Hooks 的取数库的 Why How 与 What。
|
||||
|
||||
## 2 概述
|
||||
|
||||
首先介绍 swr 的功能。
|
||||
|
||||
为了和官方文档有所区别,笔者以探索式思路介绍这个它,但例子都取自官方文档。
|
||||
|
||||
### 2.1 为什么用 Hooks 取数
|
||||
|
||||
首先回答一个根本问题:为什么用 Hooks 替代 fetch 或数据流取数?
|
||||
|
||||
因为 **Hooks 可以触达 UI 生命周期,取数本质上是 UI 展示或交互的一个环节。** 用 Hooks 取数的形式如下:
|
||||
|
||||
```typescript
|
||||
import useSWR from "swr";
|
||||
|
||||
function Profile() {
|
||||
const { data, error } = useSWR("/api/user", fetcher);
|
||||
|
||||
if (error) return <div>failed to load</div>;
|
||||
if (!data) return <div>loading...</div>;
|
||||
return <div>hello {data.name}!</div>;
|
||||
}
|
||||
```
|
||||
|
||||
首先看到的是,以同步写法描述了异步逻辑,这是因为渲染被执行了两次。
|
||||
|
||||
`useSWR` 接收三个参数,第一个参数是取数 `key`,这个 `key` 会作为第二个参数 `fetcher` 的第一个参数传入,普通场景下为 URL,第三个参数是配置项。
|
||||
|
||||
Hooks 的威力还不仅如此,上面短短几行代码还自带如下特性:
|
||||
|
||||
1. 可自动刷新。
|
||||
2. 组件被销毁再渲染时优先启用本地缓存。
|
||||
3. 在列表页中浏览器回退可以自动记忆滚动条位置。
|
||||
4. tabs 切换时,被 focus 的 tab 会重新取数。
|
||||
|
||||
当然,自动刷新或重新取数也不一定是我们想要的,[swr](https://github.com/zeit/swr) 允许自定义配置。
|
||||
|
||||
### 2.2 配置
|
||||
|
||||
上面提到,`useSWR` 还有第三个参数作为配置项。
|
||||
|
||||
**独立配置**
|
||||
|
||||
通过第三个参数为每个 `useSWR` 独立配置:
|
||||
|
||||
```tsx
|
||||
useSWR("/api/user", fetcher, { revalidateOnFocus: false });
|
||||
```
|
||||
|
||||
配置项可以参考 [文档](https://github.com/zeit/swr#options)。
|
||||
|
||||
> 可以配置的有:suspense 模式、focus 重新取数、重新取数间隔/是否开启、失败是否重新取数、timeout、取数成功/失败/重试时的回调函数等等。
|
||||
|
||||
> 第二个参数如果是 object 类型,则效果为配置项,第二个 fetcher 只是为了方便才提供的,在 object 配置项里也可以配置 fetcher。
|
||||
|
||||
**全局配置**
|
||||
|
||||
`SWRConfig` 可以批量修改配置:
|
||||
|
||||
```tsx
|
||||
import useSWR, { SWRConfig } from "swr";
|
||||
|
||||
function Dashboard() {
|
||||
const { data: events } = useSWR("/api/events");
|
||||
// ...
|
||||
}
|
||||
|
||||
function App() {
|
||||
return (
|
||||
<SWRConfig value={{ refreshInterval: 3000 }}>
|
||||
<Dashboard />
|
||||
</SWRConfig>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
独立配置优先级高于全局配置,在精读部分会介绍实现方式。
|
||||
|
||||
最重量级的配置项是 `fetcher`,它决定了取数方式。
|
||||
|
||||
### 2.3 自定义取数方式
|
||||
|
||||
自定义取数逻辑其实分几种抽象粒度,比如自定义取数 url,或自定义整个取数函数,而 [swr](https://github.com/zeit/swr) 采取了相对中间粒度的自定义 `fetcher`:
|
||||
|
||||
```tsx
|
||||
import fetch from "unfetch";
|
||||
|
||||
const fetcher = url => fetch(url).then(r => r.json());
|
||||
|
||||
function App() {
|
||||
const { data } = useSWR("/api/data", fetcher);
|
||||
// ...
|
||||
}
|
||||
```
|
||||
|
||||
所以 `fetcher` 本身就是一个拓展点,我们不仅能自定义取数函数,自定义业务处理逻辑,甚至可以自定义取数协议:
|
||||
|
||||
```tsx
|
||||
import { request } from "graphql-request";
|
||||
|
||||
const API = "https://api.graph.cool/simple/v1/movies";
|
||||
const fetcher = query => request(API, query);
|
||||
|
||||
function App() {
|
||||
const { data, error } = useSWR(
|
||||
`{
|
||||
Movie(title: "Inception") {
|
||||
releaseDate
|
||||
actors {
|
||||
name
|
||||
}
|
||||
}
|
||||
}`,
|
||||
fetcher
|
||||
);
|
||||
// ...
|
||||
}
|
||||
```
|
||||
|
||||
这里回应了第一个参数称为取数 Key 的原因,在 graphql 下它则是一段语法描述。
|
||||
|
||||
到这里,我们可以自定义取数函数,但却无法控制何时取数,因为 Hooks 写法使取数时机与渲染时机结合在一起。[swr](https://github.com/zeit/swr) 的条件取数机制可以解决这个问题。
|
||||
|
||||
### 2.4 条件取数
|
||||
|
||||
所谓条件取数,即 `useSWR` 第一个参数为 null 时则会终止取数,我们可以用三元运算符或函数作为第一个参数,使这个条件动态化:
|
||||
|
||||
```tsx
|
||||
// conditionally fetch
|
||||
const { data } = useSWR(shouldFetch ? "/api/data" : null, fetcher);
|
||||
|
||||
// ...or return a falsy value
|
||||
const { data } = useSWR(() => (shouldFetch ? "/api/data" : null), fetcher);
|
||||
```
|
||||
|
||||
上例中,当 `shouldFetch` 为 false 时则不会取数。
|
||||
|
||||
第一个取数参数推荐为回调函数,这样 [swr](https://github.com/zeit/swr) 会 catch 住内部异常,比如:
|
||||
|
||||
```tsx
|
||||
// ... or throw an error when user.id is not defined
|
||||
const { data, error } = useSWR(() => "/api/data?uid=" + user.id, fetcher);
|
||||
```
|
||||
|
||||
如果 `user` 对象不存在,`user.id` 的调用会失败,此时错误会被 catch 住并抛到 `error` 对象。
|
||||
|
||||
实际上,`user.id` 还是一种依赖取数场景,当 `user.id` 发生变化时需要重新取数。
|
||||
|
||||
### 2.5 依赖取数
|
||||
|
||||
如果一个取数依赖另一个取数的结果,那么当第一个数据结束时才会触发新的取数,这在 [swr](https://github.com/zeit/swr) 中不需要特别关心,只需按照依赖顺序书写 `useSWR` 即可:
|
||||
|
||||
```tsx
|
||||
function MyProjects() {
|
||||
const { data: user } = useSWR("/api/user");
|
||||
const { data: projects } = useSWR(() => "/api/projects?uid=" + user.id);
|
||||
|
||||
if (!projects) return "loading...";
|
||||
return "You have " + projects.length + " projects";
|
||||
}
|
||||
```
|
||||
|
||||
[swr](https://github.com/zeit/swr) 会尽可能并行没有依赖的请求,并按依赖顺序一次发送有依赖关系的取数。
|
||||
|
||||
可以想象,如果手动管理取数,当依赖关系复杂时,为了确保取数的最大可并行,往往需要精心调整取数递归嵌套结构,而在 [swr](https://github.com/zeit/swr) 的环境下只需顺序书写即可,这是很大的效率提升。优化方式在下面源码解读章节详细说明。
|
||||
|
||||
依赖取数是自动重新触发取数的一种场景,其实 [swr](https://github.com/zeit/swr) 还支持手动触发重新取数。
|
||||
|
||||
### 2.6 手动触发取数
|
||||
|
||||
`trigger` 可以通过 Key 手动触发取数:
|
||||
|
||||
```tsx
|
||||
import useSWR, { trigger } from "swr";
|
||||
|
||||
function App() {
|
||||
return (
|
||||
<div>
|
||||
<Profile />
|
||||
<button
|
||||
onClick={() => {
|
||||
// set the cookie as expired
|
||||
document.cookie =
|
||||
"token=; expires=Thu, 01 Jan 1970 00:00:00 UTC; path=/;";
|
||||
|
||||
// tell all SWRs with this key to revalidate
|
||||
trigger("/api/user");
|
||||
}}
|
||||
>
|
||||
Logout
|
||||
</button>
|
||||
</div>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
大部分场景不必如此,**因为请求的重新触发由数据和依赖决定,但遇到取数的必要性不由取数参数决定,而是时机时,就需要用手动取数能力了。**
|
||||
|
||||
### 2.7 乐观取数
|
||||
|
||||
特别在表单场景时,数据的改动是可预期的,此时数据驱动方案只能等待后端返回结果,其实可以优化为本地先修改数据,等后端结果返回后再刷新一次:
|
||||
|
||||
```tsx
|
||||
import useSWR, { mutate } from "swr";
|
||||
|
||||
function Profile() {
|
||||
const { data } = useSWR("/api/user", fetcher);
|
||||
|
||||
return (
|
||||
<div>
|
||||
<h1>My name is {data.name}.</h1>
|
||||
<button
|
||||
onClick={async () => {
|
||||
const newName = data.name.toUpperCase();
|
||||
// send a request to the API to update the data
|
||||
await requestUpdateUsername(newName);
|
||||
// update the local data immediately and revalidate (refetch)
|
||||
mutate("/api/user", { ...data, name: newName });
|
||||
}}
|
||||
>
|
||||
Uppercase my name!
|
||||
</button>
|
||||
</div>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
通过 `mutate` 可以在本地临时修改某个 Key 下返回结果,特别在网络环境差的情况下加快响应速度。乐观取数,表示对取数结果是乐观的、可预期的,所以才能在结果返回之前就预测并修改了结果。
|
||||
|
||||
### 2.8 Suspense 模式
|
||||
|
||||
在 React Suspense 模式下,所有子模块都可以被懒加载,包括代码和请求都可以被等待,只要开启 `suspense` 属性即可:
|
||||
|
||||
```tsx
|
||||
import { Suspense } from "react";
|
||||
import useSWR from "swr";
|
||||
|
||||
function Profile() {
|
||||
const { data } = useSWR("/api/user", fetcher, { suspense: true });
|
||||
return <div>hello, {data.name}</div>;
|
||||
}
|
||||
|
||||
function App() {
|
||||
return (
|
||||
<Suspense fallback={<div>loading...</div>}>
|
||||
<Profile />
|
||||
</Suspense>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
### 2.9 错误处理
|
||||
|
||||
`onErrorRetry` 可以统一处理错误,包括在错误发生后重新取数等:
|
||||
|
||||
```tsx
|
||||
useSWR(key, fetcher, {
|
||||
onErrorRetry: (error, key, option, revalidate, { retryCount }) => {
|
||||
if (retryCount >= 10) return;
|
||||
if (error.status === 404) return;
|
||||
|
||||
// retry after 5 seconds
|
||||
setTimeout(() => revalidate({ retryCount: retryCount + 1 }), 5000);
|
||||
}
|
||||
});
|
||||
```
|
||||
|
||||
## 3 精读
|
||||
|
||||
### 3.1 全局配置
|
||||
|
||||
在 Hooks 场景下,包装一层自定义 `Context` 即可实现全局配置。
|
||||
|
||||
首先 `SWRConfig` 本质是一个定制 `Context Provider`:
|
||||
|
||||
```tsx
|
||||
const SWRConfig = SWRConfigContext.Provider;
|
||||
```
|
||||
|
||||
在 `useSWR` 中将当前配置与全局配置 Merge 即可,通过 `useContext` 拿到全局配置:
|
||||
|
||||
```tsx
|
||||
config = Object.assign({}, defaultConfig, useContext(SWRConfigContext), config);
|
||||
```
|
||||
|
||||
### 3.2 useSWR 的一些细节
|
||||
|
||||
从源码可以看到更多细节用心,`useSWR` 真的比手动调用 `fetch` 好很多。
|
||||
|
||||
**兼容性**
|
||||
|
||||
`useSWR` 主体代码在 `useEffect` 中,但是为了将请求时机提前,放在了 UI 渲染前(`useLayoutEffect`),并兼容了服务端场景:
|
||||
|
||||
```tsx
|
||||
const useIsomorphicLayoutEffect = IS_SERVER ? useEffect : useLayoutEffect;
|
||||
```
|
||||
|
||||
**非阻塞**
|
||||
|
||||
请求时机在浏览器空闲时,因此请求函数被 `requestIdleCallback` 包裹:
|
||||
|
||||
```tsx
|
||||
window["requestIdleCallback"](softRevalidate);
|
||||
```
|
||||
|
||||
`softRevalidate` 是开启了去重的 `revalidate`:
|
||||
|
||||
```tsx
|
||||
const softRevalidate = () => revalidate({ dedupe: true });
|
||||
```
|
||||
|
||||
即默认 2s 内参数相同的重复取数会被取消。
|
||||
|
||||
**性能优化**
|
||||
|
||||
由于 [swr](https://github.com/zeit/swr) 的 `data`、`isValidating` 等数据状态是利用 `useState` 分开管理的:
|
||||
|
||||
```tsx
|
||||
let [data, setData] = useState(
|
||||
(shouldReadCache ? cacheGet(key) : undefined) || config.initialData
|
||||
);
|
||||
// ...
|
||||
let [isValidating, setIsValidating] = useState(false);
|
||||
```
|
||||
|
||||
而取数状态变化时往往 `data` 与 `isValidating` 要一起更新,为了仅触发一次更新,使用了 <del>`unstable_batchedUpdates` 将更新合并为一次:</del>
|
||||
|
||||
```tsx
|
||||
unstable_batchedUpdates(() => {
|
||||
setIsValidating(false);
|
||||
// ...
|
||||
setData(newData);
|
||||
});
|
||||
```
|
||||
|
||||
|
||||
其实还有别的解法,比如使用 `useReducer` 管理数据也能达到相同性能效果。
|
||||
目前源码已经从`unstable_batchedUpdates`切换为 `useReducer`管理
|
||||
```tsx
|
||||
dispatch(newState);
|
||||
```
|
||||
|
||||
|
||||
### 3.3 初始缓存
|
||||
|
||||
当页面切换时,可以暂时以上一次数据替换取数结果,即初始化数据从缓存中拿:
|
||||
|
||||
```tsx
|
||||
const shouldReadCache = config.suspense || !useHydration();
|
||||
|
||||
// stale: get from cache
|
||||
let [data, setData] = useState(
|
||||
(shouldReadCache ? cacheGet(key) : undefined) || config.initialData
|
||||
);
|
||||
```
|
||||
|
||||
上面一段代码在 `useSWR` 的初始化期间,`useHydration` 表示是否为初次加载:
|
||||
|
||||
```tsx
|
||||
let isHydration = true;
|
||||
|
||||
export default function useHydration(): boolean {
|
||||
useEffect(() => {
|
||||
setTimeout(() => {
|
||||
isHydration = false;
|
||||
}, 1);
|
||||
}, []);
|
||||
|
||||
return isHydration;
|
||||
}
|
||||
```
|
||||
|
||||
### 3.4 支持 suspense
|
||||
|
||||
Suspense 分为两块功能:异步加载代码与异步加载数据,现在提到的是异步加载数据相关的能力。
|
||||
|
||||
Suspense 要求代码 suspended,即抛出一个可以被捕获的 Promise 异常,在这个 Promise 结束后再渲染组件。
|
||||
|
||||
核心代码就这一段,抛出取数的 Promise:
|
||||
|
||||
```tsx
|
||||
throw CONCURRENT_PROMISES[key];
|
||||
```
|
||||
|
||||
等取数完毕后再返回 `useSWR` API 定义的结构:
|
||||
|
||||
```tsx
|
||||
return {
|
||||
error: latestError,
|
||||
data: latestData,
|
||||
revalidate,
|
||||
isValidating
|
||||
};
|
||||
```
|
||||
|
||||
如果没有上面 `throw` 的一步,在取数完毕前组件就会被渲染出来,所以 `throw` 了请求的 Promise 使得这个请求函数支持了 Suspense。
|
||||
|
||||
### 3.5 依赖的请求
|
||||
|
||||
翻了一下代码,没有找到对循环依赖特别处理的逻辑,**后来看了官方文档才恍然大悟,原来是通过 `try/catch` + `onErrorRetry` 机制实现依赖取数的。**
|
||||
|
||||
看下面这段代码:
|
||||
|
||||
```tsx
|
||||
const { data: user } = useSWR("/api/user");
|
||||
const { data: projects } = useSWR(() => "/api/projects?uid=" + user.id);
|
||||
```
|
||||
|
||||
怎么做到智能按依赖顺序请求呢?我们看 `useSWR` 取数函数的主体逻辑:
|
||||
|
||||
```tsx
|
||||
try {
|
||||
// 设置 isValidation 为 true
|
||||
// 取数、onSuccess 回调
|
||||
// 设置 isValidation 为 false
|
||||
// 设置缓存
|
||||
// unstable_batchedUpdates
|
||||
} catch (err) {
|
||||
// 撤销取数、缓存等对象
|
||||
// 调用 onErrorRetry
|
||||
}
|
||||
```
|
||||
|
||||
可见取数逻辑被 `try` 住了,那么 `user.id` 在 `useSWR("/api/user")` 没有 Ready 的情况一定会抛出异常,则自动进入 `onErrorRetry` 逻辑,看看下次取数时 `user.id` 有没有 Ready。
|
||||
|
||||
那么什么时候才轮到下次取数呢?这个时机是:
|
||||
|
||||
```tsx
|
||||
const count = Math.min(opts.retryCount || 0, 8);
|
||||
const timeout =
|
||||
~~((Math.random() + 0.5) * (1 << count)) * config.errorRetryInterval;
|
||||
```
|
||||
|
||||
重试时间基本按 2 的指数速度增长。
|
||||
|
||||
所以 [swr](https://github.com/zeit/swr) 会优先按照并行方式取数,存在依赖的取数会重试,直到上游 Ready。这种简单的模式稍稍损失了一些性能(没有在上游 Ready 后及时重试下游),但不失为一种巧妙的解法,而且最大化并行也使得大部分场景性能反而比手写的好。
|
||||
|
||||
## 4 总结
|
||||
|
||||
笔者给仔细阅读本文的同学留下两道思考题:
|
||||
|
||||
- 关于 Hooks 取数还是在数据流中取数,你怎么看呢?
|
||||
- swr 解决依赖取数的方法还有更好的改进办法吗?
|
||||
|
||||
> 讨论地址是:[精读《Hooks 取数 - swr 源码》 · Issue #216 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/216)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,630 @@
|
||||
## 1 引言
|
||||
|
||||
这是继 [精读《React Conf 2019 - Day1》](https://github.com/dt-fe/weekly/blob/v2/127.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20Conf%202019%20-%20Day1%E3%80%8B.md) 之后的第二篇,补充了 React Conf 2019 第二天的内容。
|
||||
|
||||
## 2 概述 & 精读
|
||||
|
||||
第二天的内容更为精彩,笔者会重点介绍比较干货的部分。
|
||||
|
||||
### Fast refresh
|
||||
|
||||
[Fast refresh](https://facebook.github.io/react-native/docs/fast-refresh) 是更好的 react-hot-loader 替代方案,目前仅支持 react-native 平台,很快就会支持 react-dom 平台。
|
||||
|
||||
相比不支持 Function component、无法错误恢复、更新经常失灵的 hot reloading 来说,fast refresh 还拥有以下几个优点:
|
||||
|
||||
- 状态保持。
|
||||
- 支持 Function Component Hooks。
|
||||
- 更快的更新速度。
|
||||
|
||||
Fast refresh 更新速度更快,是基于 Function Component 生成了 “签名”,从而最大成都避免销毁重渲染,尽可能保持对组件的 rerender 刷新。下面介绍签名机制的工作原理。
|
||||
|
||||
Fast refresh 对每个 Function component 都生成了一份专属签名,用以描述这个组件核心状态,当这个核心状态改变时,就只能销毁重渲染了,但对于不触及核心的修改就能进行代价非常小的 rerender。
|
||||
|
||||
这个签名包含了 hooks 和参数名:
|
||||
|
||||
```js
|
||||
// signature: "useState{isLoggedIn}"
|
||||
|
||||
function ExampleComponent() {
|
||||
const [isLoggedIn, setIsLoggedIn] = useState(true);
|
||||
}
|
||||
```
|
||||
|
||||
比如当参数名变更时,这个组件的逻辑已发生改动,此时只能销毁并重渲染了。因此实际上通过对签名的对比来判断是否要销毁并重刷新组件:
|
||||
|
||||
```js
|
||||
// signature: "useState{isLoggedOut}"
|
||||
|
||||
function ExampleComponent() {
|
||||
const [isLoggedOut, setIsLoggedOut] = useState(true);
|
||||
}
|
||||
```
|
||||
|
||||
同理,当 hooks 从 `useState` 改成了 `useReducer`,签名也会发生变化从而导致彻底的重渲染。
|
||||
|
||||
但除此之外,**比如对样式的修改、Dom 结构的修改都不会触发签名的变化**,从而保证了 “对不触及逻辑的改动进行高效的轻量 renreder”。
|
||||
|
||||
然而 Fast refresh 也有如下局限性:
|
||||
|
||||
- 还不能友好支持 Class component。
|
||||
- 混合导出 React 和非 React 组件时无法精确的 hot reload。
|
||||
- 更高的内存要求。
|
||||
|
||||
可以看到,Fast Refresh 随着功能推广与内置,现在已经覆盖了 Facebook 95% 以上 hot reload 场景了:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1bjm1mYr1gK0jSZR0XXbP8XXa-1598-1018.png">
|
||||
|
||||
这部分内容不仅揭开了 hot reload 技术内幕,还对其功能进行了进一步优化,2019 年的 React 开发体系已经进入精细化阶段。
|
||||
|
||||
### 重写 React devtools
|
||||
|
||||
React devtools 的更新终于被正式介绍了,本来笔者以为新的 devtools 只是支持了 hooks,但听完分享后发现还有更多有用的改进,包括:
|
||||
|
||||
- 更高的性能。
|
||||
- 更多特性支持。
|
||||
- 更好用户体验。
|
||||
|
||||
**找到节点渲染链路**
|
||||
|
||||
并不是每个 React 节点都参与渲染,新版 React devtools 可以展示出 rendered by:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1OSWomV67gK0jSZPfXXahhFXa-2354-668.png">
|
||||
|
||||
**调试 Suspense**
|
||||
|
||||
在 Day1 中讲到的 Suspense 特性可以在 React devtools 调试了:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1W790m4D1gK0jSZFsXXbldVXa-1816-660.png">
|
||||
|
||||
通过点击时钟 icon,可以模拟 Suspense 处于 pendding 或 ready 状态。
|
||||
|
||||
**增强调试能力**
|
||||
|
||||
可以通过点击直接跳转到组件源码:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1IBK1m4n1gK0jSZKPXXXvUXXa-1806-772.png">
|
||||
|
||||
最新版已增强至点击按钮后直接通过 Source 打开源码位置,**这样可以快速通过 UI 寻找到代码**。同时还可以看到,通过点击 debugger 按钮将当前组件信息打到控制台调试。
|
||||
|
||||
除此之外还可以动态修改组件的 props 与 hook state,大大增强了调试能力。
|
||||
|
||||
**profiler**
|
||||
|
||||
分析工具也得到了增强,现在可以看到每个组件被渲染了几次以及重新渲染的原因:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1cla1m7P2gK0jSZPxXXacQpXa-1824-690.png">
|
||||
|
||||
比如上图组件被渲染了 4 次,主要有两个原因:Hooks 改变与 Props 改变。
|
||||
|
||||
除此之外,还优化了更多细节体验,比如高亮搜索、HOC 的展示优化、嵌套层级过多时不会占用过多的横向宽度等等。
|
||||
|
||||
### react codemod
|
||||
|
||||
codemod 是一个代码重构的方式,通过 AST 方式精准触达代码,我们可以认为 codemod 是一个更聪明的“查找/替换”。
|
||||
|
||||
codemod 主要有以下三种使用方式:
|
||||
|
||||
- 重命名。
|
||||
- 代码排序。
|
||||
- 一定程度的代码替换。
|
||||
|
||||
接下来就讲到 [react codemod](https://github.com/reactjs/react-codemod) 了,它是 react 场景的 codemod 解决方案,facebook 是这么使用 react codemod 的:
|
||||
|
||||
- 迁移 facebook 代码。
|
||||
- 涉及几万个组件。
|
||||
- 修复了 3500 个文件的 React.PropTypes。
|
||||
- 修复了 8500 个文件的生命周期 unsafe。
|
||||
- 修复了 20000 个文件的 createClass 转 JSX。
|
||||
|
||||
使用方式:
|
||||
|
||||
```bash
|
||||
npx react-codemod React-PropTypes-to-prop-types
|
||||
```
|
||||
|
||||
可以看到,通过 cli 对文件进行一次性重构处理。除此之外,再列举几种使用场景:
|
||||
|
||||
- create-element-to-jsx 将 `React.createElement` 转换为 JSX。
|
||||
- error-boundaries 将 `unstable_handleError` 改为 `componentDidCatch`。
|
||||
- findDOMNode 将 `React.createClass` 中 `this.getDOMNode()` 改为 `React.findDOMNode`。
|
||||
- sort-comp 将 Class Component 生命周期按照规范排序,[eslint-plugin-react](https://github.com/yannickcr/eslint-plugin-react/blob/master/docs/rules/sort-comp.md) 插件也有相同能力。
|
||||
|
||||
理论上来讲,所有 codemode 做的事情都可以替换为 eslint 的 autofix 来完成,比如 sort-comp 就同时被 codemode 和 eslint 支持。
|
||||
|
||||
### Suspense
|
||||
|
||||
要理解 Suspense,就要理解 Suspense 与普通 loading 有什么区别。
|
||||
|
||||
从代码角度来说,Suspense 可以类比为 `try/catch` 的体验。为了简化代码复杂度,我们可以用 `try/catch` 包裹代码,从而简化 try 区块代码复杂度,并将兜底代码放在 catch 区块:
|
||||
|
||||
```js
|
||||
try {
|
||||
// 只要考虑正确情况
|
||||
} catch {
|
||||
// 错误时 fallback
|
||||
}
|
||||
```
|
||||
|
||||
Suspense 也一样,它在渲染 React 组件时如果遇到了 Promise 抛出的 Error,就会进入 `fallback`,所以 `fallback` 含义是 Loading 中状态:
|
||||
|
||||
```jsx
|
||||
<Suspense fallback={<Spinner />}>
|
||||
<ProfilePage />
|
||||
</Suspense>
|
||||
```
|
||||
|
||||
与此同时,实际业务组件中的取数也不需要担心取数是否正在进行中,只要直接处理拿到数据的情况就好了:
|
||||
|
||||
```jsx
|
||||
function ProfileDetails() {
|
||||
// 直接使用 user,不用担心失败。
|
||||
const user = resource.user.read();
|
||||
return <h1>{user.name}</h1>;
|
||||
}
|
||||
```
|
||||
|
||||
进一步的,如果要处理组件渲染的异常,再使用 `ErrorBoundary` 包裹即可,此时的 `fallback` 含义是组件加载异常的错误状态:
|
||||
|
||||
```jsx
|
||||
function Home(props) {
|
||||
return (
|
||||
<ErrorBoundary fallback={<ErrorMessage />}>
|
||||
<Suspense fallback={<Placeholder />}>
|
||||
<Composer />
|
||||
</Suspense>
|
||||
</ErrorBoundary>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
Suspense 模式的取数好处是 “fetch on render”,即渲染与取数同时进行,而普通模式的取数是 “fetch after render”,即渲染完成后再通过 `useEffect` 取数,此时取数时机已晚。
|
||||
|
||||
**队列加载**
|
||||
|
||||
假设 `Composer` 与 `NewsFeed` 组件内部都通过 `useQuery` 取数,那么并行取数时加载机制如下:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1AonZm7L0gK0jSZFtXXXQCXXa-1770-778.png">
|
||||
|
||||
这可能有两个问题:组件内部加载顺序不统一与组件间加载顺序不统一。
|
||||
|
||||
如果组件内部有图片,可能图片与组件渲染实际不一致,此时可以利用 Suspense 统一 hold 所有子组件的特性,将图片加载改为 Suspense 模式:
|
||||
|
||||
```jsx
|
||||
<div>
|
||||
<YourImage src={uri} alt={...} />
|
||||
<MoreComposer />
|
||||
</div>
|
||||
```
|
||||
|
||||
同一个 Suspense 可以等待所有子元素都 Ready 后才会一把渲染出 UI,因此可以看到网页被一次性刷新而不是分部刷新。
|
||||
|
||||
第二个问题是组件间加载顺序不统一,可能导致先渲染了文章内容,再渲染出文章头部,此时如果区块高度不固定,文章头部可能会撑开,导致文章内容下移,用户的阅读体验会遭到打断。可以通过 `suspense ordering` 解决这个问题:
|
||||
|
||||
```jsx
|
||||
function Home(props) {
|
||||
return (
|
||||
<SuspenseList revealOrder="forwards">
|
||||
<Suspense fallback={<ComposerFallback />}>
|
||||
<Composer />
|
||||
</Suspense>
|
||||
<Suspense fallback={<FeedFallback />}>
|
||||
<NewsFeed />
|
||||
</Suspense>
|
||||
</SuspenseList>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
比如 `forwards` 表示从上到下,那么一定会先渲染头部再渲染文章内容,这样文章内容就不会都抖动了。
|
||||
|
||||
### Render as you fetch
|
||||
|
||||
相比 “fetch on render”,更高级别的优化是 “Render as you fetch”,即取数在渲染时机之前。
|
||||
|
||||
比如页面路由的跳转、Hover 到一个区块,此时如果取数由这个动作触发,就可以再次将取数时机提前,Facebook 为此创造了一个新的 Hook:`usePreloadedQuery`。
|
||||
|
||||
用法是,在某个事件中取数,比如点击页面跳转按钮时,通过 `preloadQuery` 预取数,得到的结果并不是取数结果,而是一个标识,在渲染组件中,把这个标识传给 `usePreloadedQuery` 可以拿到真实取数结果:
|
||||
|
||||
```js
|
||||
// 组件 A 的 onClick
|
||||
const reference = preloadQuery(query, variables);
|
||||
// 组件 B 的 render
|
||||
const data = usePreloadedQuery(query, reference);
|
||||
```
|
||||
|
||||
可以看到,取数真正触发的时机在渲染函数执行之前,所以在 `usePreloadedQuery` 调用时取数肯定已经在路上,甚至已经完成。相比之下,普通的 `useQuery` 函数存在下面几个问题:
|
||||
|
||||
- 由于取数过程存在状态变化,可能导致组件在 “取数无意义” 状态下重新渲染多次。
|
||||
- 可能取数还未完成就触发重渲染。
|
||||
- 没有取消的机制,没有清除结果的机制。
|
||||
- 没有办法唯一标识组件。
|
||||
|
||||
preloadQuery 的好处就是将取数时机与 UI 分离,这样可以更细粒度的控制逻辑:
|
||||
|
||||
- 调用 preloadQuery 时:
|
||||
- 在组件销毁时取消取数。
|
||||
- 有新取数触发时取消取数。
|
||||
- 销毁一些轮询机制。
|
||||
- 渲染组件调用 usePreloadedQuery 时:
|
||||
- 不会再触发取数,不会触发意外的 re-render。
|
||||
- 不需要清空,因为取数不在这里发起。
|
||||
- 不需要清理轮询。
|
||||
|
||||
可见 preloadQuery 相比 useQuery 的确有了一些体验提升,然而这个优化比较追求极致,对大部分国内项目来说可能还走不到 facebook 这么极致的性能优化,所以投入产出比显得不是那么高,而且这个开发方式对开发者不是太友好,因为它让请求的时机割裂到两个模块中。
|
||||
|
||||
但毕竟用户体验是大于开发者体验的,React 尽量通过提高开发者体验来间接提高用户体验,使双方都满意,但像 preloadQuery 就无法两者兼顾了,为了用户体验可以适当的降低一些开发者体验。
|
||||
|
||||
### 如何维护代码
|
||||
|
||||
这个分享讲述了如何提升代码维护效率,毕竟一个月后可能连自己写的代码都看不懂了。[hydrosquall](http://github.com/hydrosquall) 通过类比地图的方式解释了程序员是如何维护代码的。
|
||||
|
||||
首先看我们是如何认路的。认路分为三个层次:
|
||||
|
||||
- 随意走走。
|
||||
- 通过一些地标判断方向。
|
||||
- 有方向的寻路。
|
||||
- 通过跟随同伴或者了解更多本地信息找到目的地。
|
||||
- 地图。
|
||||
- 通过 GPS 定位。
|
||||
- 通过模拟地图方式指出路线。
|
||||
|
||||
可以看到这三种方式是逐层递进的,那么类比到代码就有意思了:
|
||||
|
||||
- 随意走走(滚动查看源代码 + ctrl/f 查找代码 + grep 搜索)。
|
||||
- 入口(找到入口节点,查看数据结构)。
|
||||
- 标记(查看代码注释、查看 README)。
|
||||
- 发信号弹(断点、console.log 等调试行为)
|
||||
- 找到方向。
|
||||
- git blame 查看 owner,或直接根据文档找到 codeowners。
|
||||
- 地图。
|
||||
- 幸运的话你可以找到一份架构流程图。
|
||||
|
||||
可以看到,地图有几种抽象层次,比如忽略了细节的纽约地铁线路图:
|
||||
|
||||
<img width=400 src="https://img.alicdn.com/tfs/TB14k7pmYr1gK0jSZR0XXbP8XXa-1014-702.png">
|
||||
|
||||
或者是包含丰富地面信息的地铁线路图:
|
||||
|
||||
<img width=400 src="https://img.alicdn.com/tfs/TB1Sbwpm.T1gK0jSZFrXXcNCXXa-692-750.png">
|
||||
|
||||
抽象到什么层次取决于用户使用的场景,那么代码抽象也是如此。[hydrosquall](http://github.com/hydrosquall) 做了一个工具自动分析出代码调用关系:[js-callgraph](https://github.com/persper/js-callgraph)
|
||||
|
||||

|
||||
|
||||
这就像路牌一样,可以更高效的看出代码结构,也包括了数据流结构,由于篇幅限制,感兴趣的同学可以看 [原视频](https://youtu.be/JDDxR1a15Yo?t=6579) 了解更多。
|
||||
|
||||
### 写作与写代码
|
||||
|
||||
本章讲了写作(小说)与写代码的关联,总结出如下几个重点:
|
||||
|
||||
- 写小说和写代码都是创造行为。
|
||||
- 写代码需要抽象思维,写小说也要有抽象思维构造人物和情节。
|
||||
- Show, don't tell,写作天然就是申明式的,和数据驱动很相似。
|
||||
|
||||
更多可以去看 [原视频](https://youtu.be/JDDxR1a15Yo?t=9135)。
|
||||
|
||||
### 移动端动画最佳实践
|
||||
|
||||
首先要使用一个真实的手机设备调试,否则可能出现 PC Chrome 一切正常,而手机上实际效果性能很差的情况!
|
||||
|
||||
**手势下拉退出**
|
||||
|
||||
利用 [react-spring](https://github.com/react-spring/react-spring) 和 [react-use-gesture](react-use-gesture) 做一个下滑消失的 Demo:
|
||||
|
||||
```jsx
|
||||
import { animated, useSpring } from "react-spring";
|
||||
import { useDrag } from "react-use-gesture";
|
||||
|
||||
const [{ y }, set] = useSpring(() => {
|
||||
y: 0;
|
||||
});
|
||||
```
|
||||
|
||||
首先定义一个 `y` 纵向位置,通过 `useDrag` 将拖拽操作与 UI 绑定,通过回调将其与 `y` 数据绑定:
|
||||
|
||||
```js
|
||||
const bind = useDrag(({ last, movement: [, movementY], memo = y.value }) => {
|
||||
if (last) {
|
||||
// 拖拽结束时,如果偏移量超过 50 则效果和结束一样,直接将 y 设置为 100
|
||||
const notificationClosed = movementY > 50;
|
||||
|
||||
return set({
|
||||
y: notificationClosed ? 100 : 0,
|
||||
onReset: notificationClosed && removeNotification
|
||||
});
|
||||
}
|
||||
|
||||
// y 的位置区间在 0~100
|
||||
set([{ y: clamp(0, 100, memo + movementY) }]);
|
||||
|
||||
return memo;
|
||||
});
|
||||
```
|
||||
|
||||
将 `useDrag` 与 `y` 绑定后,就可以用在 UI 组件上了:
|
||||
|
||||
```jsx
|
||||
<StyledNotification
|
||||
as={animated.div}
|
||||
onTouchStart={bind().onTouchStart}
|
||||
style={{
|
||||
opacity: y.interpolate([0, 100], [1, 0]),
|
||||
transform: y.interpolate(y => `translateY(${y}px)`)
|
||||
}}
|
||||
/>
|
||||
```
|
||||
|
||||
将 `opacity` 与 `transform` 与位置 `y` 绑定就可以做出下拉消失的效果。
|
||||
|
||||
**滑动的洞见**
|
||||
|
||||
接着讲到了滑动的三个洞见:
|
||||
|
||||
1. 要立刻响应,任何延迟都会造成用户额外精神负担。
|
||||
2. 滚动速度衰减可以提升用户体验:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1HocDm1H2gK0jSZJnXXaT1FXa-1348-878.gif">
|
||||
|
||||
接着我们需要预测用户的意图,比如在一个类似微信消息列表页左右滑动时:
|
||||
|
||||
- 是否想取消手势交互?
|
||||
- 是否想展示出更多交互按钮?
|
||||
- 是否想删除所有内容?
|
||||
|
||||
这需要更多设计思考。
|
||||
|
||||
1. 橡皮筋滚动,即列表页可以一直向下拉,上面部分像橡皮筋一样可以被拉出空白页的效果。
|
||||
|
||||
在设计手势动画时要考虑三个要点:
|
||||
|
||||
- 使用移动增量作为手势动画的基准点。
|
||||
- 动画和手势应该随时可以被中断,通过 springs 即可实现。
|
||||
- 完成手势后的动画速度应该与手势速度相当,这样视觉体验更自然。
|
||||
|
||||
最后提到了动画兼容性与性能,比如尽量只使用 `transform` 与 `opacity` 可以保证移动端的流畅度,不同移动设备的默认手势效果不同,最好通过 `touch-action` 禁用默认行为以达到更好的兼容性与效果。
|
||||
|
||||
### 唱片与 React
|
||||
|
||||
J.Dash 拥有十年软件开发经验,同时也卖过很多唱片,他介绍了唱片行业与软件开发的共同点。
|
||||
|
||||
唱片行业需要音乐编排能力,这与编码能力类似,都存在良好的设计模式,并且需要团队合作,开发过程中会遇到一些痛苦的经历,但最终完成音乐和项目时都会获得满足的喜悦。
|
||||
|
||||
### 函数式编程
|
||||
|
||||
> Declaratives UIs are the future, and the future is Comonadic. - Phil Freeman
|
||||
|
||||
申明式 UI 是未来,未来则是 Comonadic。
|
||||
|
||||
所谓申明式 UI 可以用下面的公式表达:
|
||||
|
||||
```js
|
||||
type render = (state: State) => View;
|
||||
```
|
||||
|
||||
然后用一段公式介绍了 Comonadic:
|
||||
|
||||
```js
|
||||
class Functor w => Comonad w where
|
||||
extract :: w a -> a
|
||||
duplicate :: w a -> w (w a)
|
||||
extend :: (w a -> a) -> w a -> w b
|
||||
```
|
||||
|
||||
用 JS 版本做一个解释:
|
||||
|
||||
```js
|
||||
const Store = ({ state, render }) => ({
|
||||
extend: f => Store({ state, render: state => f(Store({ state, render })) }),
|
||||
extract: () => render(state)
|
||||
});
|
||||
```
|
||||
|
||||
`extract` 调用后会进行申明式渲染 UI,即 `render(state)`。
|
||||
|
||||
`extend` 表示拓展,接收一个拓展函数作为参数,返回一个新的 Store 对象。这个拓展函数可以拿到 `state`、`render` 并返回新的 `state` 作为 `extract` 时 `render` 的输入。使用例子是这样的:
|
||||
|
||||
```jsx
|
||||
const App = Store({
|
||||
state: { msg: "World" },
|
||||
render: ({ msg }) => <p>Hello {msg}</p>
|
||||
});
|
||||
|
||||
App.extend(({ state }) =>
|
||||
state.msg === "World" ? { msg: "ReactConf" } : state
|
||||
).extract(); // <p> Hello ReactConf </p>
|
||||
```
|
||||
|
||||
然而尴尬的是,笔者看了很久也没看懂 `Store` 函数,最后运行了一下发现这个 Demo 抛出了异常 😂。
|
||||
|
||||
下面是笔者稍微修改后的例子,至少能跑起来:
|
||||
|
||||
```js
|
||||
const Store = ({ state, render }) => ({
|
||||
extend: f => Store({ state, render: state => render(f({ state, render })) }),
|
||||
extract: () => render(state)
|
||||
});
|
||||
|
||||
const app = Store({
|
||||
state: { msg: "Hello World" },
|
||||
render: ({ msg }) => console.log("render " + msg)
|
||||
});
|
||||
|
||||
app
|
||||
.extend(({ state }) => {
|
||||
return { msg: state.msg + " extend1" };
|
||||
})
|
||||
.extend(({ state }) => {
|
||||
return { msg: state.msg + " extend2" };
|
||||
})
|
||||
.extract(); // render Hello World extend2 extend1
|
||||
```
|
||||
|
||||
然而作者的意思仍是未解之谜,希望对函数式了解的同学可以在评论区指点一下。
|
||||
|
||||
### wick editor
|
||||
|
||||
[wick editor](https://www.wickeditor.com/) 是一个开源的动画、游戏制作软件。
|
||||
|
||||
wick editor 是一个动画制作工具,但拓展了一些 js 编程能力,因此可以很好的将动画与游戏结合在一起:
|
||||
|
||||
<img width=300 src="https://img.alicdn.com/tfs/TB1hLJpnbr1gK0jSZR0XXbP8XXa-1766-1002.png">
|
||||
|
||||
演讲介绍了 wick editor 的演化过程:
|
||||
|
||||
从很简陋的 MVP 版本开始(1 周)
|
||||
|
||||
<img width=300 src="https://img.alicdn.com/tfs/TB11sdsneL2gK0jSZFmXXc7iXXa-1192-764.png">
|
||||
|
||||
到 Pre-Alpha(4 月)
|
||||
|
||||
<img width=300 src="https://img.alicdn.com/tfs/TB1TMJnnXY7gK0jSZKzXXaikpXa-1306-858.png">
|
||||
|
||||
Alpha(5 月)
|
||||
|
||||
<img width=300 src="https://img.alicdn.com/tfs/TB1608pnoD1gK0jSZFGXXbd3FXa-1794-1186.png">
|
||||
|
||||
Beta(1.5 年)
|
||||
|
||||
<img width=300 src="https://img.alicdn.com/tfs/TB1CKJpnoD1gK0jSZFGXXbd3FXa-1274-854.png">
|
||||
|
||||
重点是 1.0 版本采用 React 重写了!继 Beta 之后又经历了 1 年:
|
||||
|
||||
<img width=300 src="https://img.alicdn.com/tfs/TB1ZZhrneH2gK0jSZFEXXcqMpXa-906-596.png">
|
||||
|
||||
这个团队最棒的地方是,将游戏与教育结合,针对不同场景做了很多用户调研并根据反馈持续改进。
|
||||
|
||||
### React Select
|
||||
|
||||
[react-select](https://github.com/JedWatson/react-select) 的作者 [Jed Watson](https://github.com/JedWatson) 被请来啦。作为一个看上去很简单组件(select)的开发者,却拥有如此大的关注量(1.8w star),那作者有着怎样的心路历程呢?
|
||||
|
||||
react-select 看似简单的名字背后其实有挺多的功能,比如作者列举了一些功能层面的内容:
|
||||
|
||||
- autocomplete - 输入时搜索。
|
||||
- 单、多选。
|
||||
- focus 管理。
|
||||
- 下拉框层级与位置,比如可以放在根 DOM 节点,也可以作为当前节点的子元素。
|
||||
- 异步下拉框内容。
|
||||
- 键盘、触控。
|
||||
- Createble,即在搜索时如果没有内容可以动态创建。
|
||||
- 等等。
|
||||
|
||||
<img width=300 src="https://img.alicdn.com/tfs/TB1RYS1mubviK0jSZFNXXaApXXa-1166-226.png">
|
||||
|
||||
在设计层面:
|
||||
|
||||
- 申明式。
|
||||
- 可以被定制。
|
||||
- 性能要求。
|
||||
- 等等。
|
||||
|
||||
随着 Star 逐渐上涨,越来越多的需求被提出,核心库代码量越来越大,甚至许多需求之间都是相互冲突的,而且作者每天都会被上百个 Issue 与 PR 吵醒。做一个业务 Select 可能只要 5 分钟,但做一个开源 Select 却要 5 年,原因是一个简单的 Select 如何满足所有不同业务场景?这绝对是个巨大的挑战。
|
||||
|
||||
比如用户即需要受控也要非受控的组件,如何满足好这个需求同时又让代码更可维护呢?
|
||||
|
||||
假设我们拥有一个受控的组件 `SelectComponent`,那么它的主要 props 是 `value` 与 `onChange`,如果要拓展成一个既支持 `defaultValue`(非受控)又支持 `value`(受控)的组件,我们可以创建一个 `manageState` 组件对 `SelectComponent` 进行封装:
|
||||
|
||||
```jsx
|
||||
const manageState = SelectComponent => ({
|
||||
value: valueProps,
|
||||
onChange: onChangeProp,
|
||||
defaultValue,
|
||||
...props
|
||||
}) => {
|
||||
const [valueState, setValue] = useState(defaultValue);
|
||||
|
||||
const value = valueProps !== undefined ? valueProps : valueState;
|
||||
|
||||
const onChange = (newValue, actionMeta) => {
|
||||
if (typeof onChangeProp === "function") {
|
||||
onChangeProp(newValue, actionMeta);
|
||||
}
|
||||
setValue(newValue);
|
||||
};
|
||||
|
||||
return <SelectComponent {...props} value={value} onChange={onChange}>
|
||||
};
|
||||
```
|
||||
|
||||
这样就可以组合为一个受控/非受控的综合 Select 组件:
|
||||
|
||||
```js
|
||||
import BaseSelect from "./Select";
|
||||
import manageState from "./manageState";
|
||||
|
||||
export default manageState(Select);
|
||||
```
|
||||
|
||||
同理对异步的封装也可以放在 `makeAsync` 函数中:
|
||||
|
||||
```jsx
|
||||
const makeAsync = SelectComponent => ({
|
||||
getOptions,
|
||||
defaultOptions,
|
||||
...props
|
||||
}) => {
|
||||
const [options, setOptions] = useState(defaultOptions);
|
||||
const [isLoading, setIsLoading] = useState(false);
|
||||
|
||||
const onInputChange = async newValue => {
|
||||
setIsLoading(true);
|
||||
const newOptions = await getOptions(newValue);
|
||||
setIsLoading(false);
|
||||
setOptions(newOptions);
|
||||
};
|
||||
|
||||
return (
|
||||
<SelectComponent
|
||||
{...props}
|
||||
options={options}
|
||||
isLoading={isLoading}
|
||||
onInputChange={onInputChange}
|
||||
/>
|
||||
);
|
||||
};
|
||||
```
|
||||
|
||||
可以看到,`SelectComponent` 是一个完全受控的数据驱动的 UI,无论是 `manageState` 还是 `makeAsync` 都是对数据处理的拓展,所以这三者之间才可以融洽的组合:
|
||||
|
||||
```js
|
||||
import BaseSelect from "./Select";
|
||||
import manageState from "./manageState";
|
||||
import makeAsync from "./async";
|
||||
|
||||
export default manageState(Select);
|
||||
|
||||
export const AsyncSelect = manageState(makeAsync(Select));
|
||||
```
|
||||
|
||||
后面还有一些风格化、开源协作的思考,这里就不展开了,对这部分感兴趣的同学可以查看原视频了解更多。
|
||||
|
||||
### React + 政府财政透明项目
|
||||
|
||||
usaspending.gov 这个网站使用 React 建设,可以查看美国政府支持财政的明细,通过流畅的体验让更多用户可以了解国家财政支出,进一步推动财政支出的透明化。由于并不涉及前端技术的介绍,主要是产品介绍,因此精读就不详细展开了。
|
||||
|
||||
顺便说一句,智能分析数据就用 [QuickBI](https://www.alibabacloud.com/zh/product/quickbi),QuickBI 是我们团队研发的一款智能 BI 服务平台,如果你将美国政府的财政支持作为数据集输入,你会分析得更透彻。
|
||||
|
||||
### React + 星舰模拟器
|
||||
|
||||
最后介绍的是使用 React 制作的星舰模拟器,看上去像一个游戏:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1HrxAneL2gK0jSZPhXXahvXXa-1946-1104.png">
|
||||
|
||||
有星系图、船体、驾驶员信息、武器装备、燃料、通信等等内容。甚至可以模拟太空驾驶,进行任务,可以实时多人协同。对太空迷们的吸引力很大,感兴趣的同学建议直接观看 [视频](https://youtu.be/JDDxR1a15Yo?t=28638)。
|
||||
|
||||
## 3 总结
|
||||
|
||||
第二天的内容非常全面,涉及了 React API、开发者周边、codemod 工具、代码维护、写作/音乐与代码、动画、函数式编程、看似简单的 React 组件、使用 React 制作的各种脑洞大开的项目,等等。
|
||||
|
||||
React Conf 要展示的是一个完整的 React 世界,第一天提到了 React 是一个桥梁,正因为这个桥梁,连接了各行各业不同的人群以及不同的项目,大家都有一个共同的语言:React。
|
||||
|
||||
"We not only react code, but react the world"。
|
||||
|
||||
> 讨论地址是:[精读《React Conf 2019 - Day2》 · Issue #217 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/217)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,579 @@
|
||||
## 1 引言
|
||||
|
||||
[unstated](https://github.com/jamiebuilds/unstated) 是基于 Class Component 的数据流管理库,[unstated-next](https://github.com/jamiebuilds/unstated-next) 是针对 Function Component 的升级版,且特别优化了对 Hooks 的支持。
|
||||
|
||||
与类 redux 库相比,这个库设计的别出心裁,而且这两个库源码行数都特别少,与 180 行的 unstated 相比,unstated-next 只有不到 40 行,但想象空间却更大,且用法符合直觉,所以本周精读就会从用法与源码两个角度分析这两个库。
|
||||
|
||||
## 2 概述
|
||||
|
||||
**首先问,什么是数据流?React 本身就提供了数据流,那就是 `setState` 与 `useState`,数据流框架存在的意义是解决跨组件数据共享与业务模型封装。**
|
||||
|
||||
还有一种说法是,React 早期声称自己是 UI 框架,不关心数据,因此需要生态提供数据流插件弥补这个能力。但其实 React 提供的 `createContext` 与 `useContext` 已经能解决这个问题,只是使用起来稍显麻烦,而 unstated 系列就是为了解决这个问题。
|
||||
|
||||
### unstated
|
||||
|
||||
unstated 解决的是 Class Component 场景下组件数据共享的问题。
|
||||
|
||||
相比直接抛出用法,笔者还原一下作者的思考过程:利用原生 `createContext` 实现数据流需要两个 UI 组件,且实现方式冗长:
|
||||
|
||||
```jsx
|
||||
const Amount = React.createContext(1);
|
||||
|
||||
class Counter extends React.Component {
|
||||
state = { count: 0 };
|
||||
increment = amount => {
|
||||
this.setState({ count: this.state.count + amount });
|
||||
};
|
||||
decrement = amount => {
|
||||
this.setState({ count: this.state.count - amount });
|
||||
};
|
||||
render() {
|
||||
return (
|
||||
<Amount.Consumer>
|
||||
{amount => (
|
||||
<div>
|
||||
<span>{this.state.count}</span>
|
||||
<button onClick={() => this.decrement(amount)}>-</button>
|
||||
<button onClick={() => this.increment(amount)}>+</button>
|
||||
</div>
|
||||
)}
|
||||
</Amount.Consumer>
|
||||
);
|
||||
}
|
||||
}
|
||||
|
||||
class AmountAdjuster extends React.Component {
|
||||
state = { amount: 0 };
|
||||
handleChange = event => {
|
||||
this.setState({
|
||||
amount: parseInt(event.currentTarget.value, 10)
|
||||
});
|
||||
};
|
||||
render() {
|
||||
return (
|
||||
<Amount.Provider value={this.state.amount}>
|
||||
<div>
|
||||
{this.props.children}
|
||||
<input
|
||||
type="number"
|
||||
value={this.state.amount}
|
||||
onChange={this.handleChange}
|
||||
/>
|
||||
</div>
|
||||
</Amount.Provider>
|
||||
);
|
||||
}
|
||||
}
|
||||
|
||||
render(
|
||||
<AmountAdjuster>
|
||||
<Counter />
|
||||
</AmountAdjuster>
|
||||
);
|
||||
```
|
||||
|
||||
而我们要做的,**是将 `setState` 从具体的某个 UI 组件上剥离,形成一个数据对象实体,可以被注入到任何组件。**
|
||||
|
||||
这就是 `unstated` 的使用方式:
|
||||
|
||||
```jsx
|
||||
import React from "react";
|
||||
import { render } from "react-dom";
|
||||
import { Provider, Subscribe, Container } from "unstated";
|
||||
|
||||
class CounterContainer extends Container {
|
||||
state = {
|
||||
count: 0
|
||||
};
|
||||
|
||||
increment() {
|
||||
this.setState({ count: this.state.count + 1 });
|
||||
}
|
||||
|
||||
decrement() {
|
||||
this.setState({ count: this.state.count - 1 });
|
||||
}
|
||||
}
|
||||
|
||||
function Counter() {
|
||||
return (
|
||||
<Subscribe to={[CounterContainer]}>
|
||||
{counter => (
|
||||
<div>
|
||||
<button onClick={() => counter.decrement()}>-</button>
|
||||
<span>{counter.state.count}</span>
|
||||
<button onClick={() => counter.increment()}>+</button>
|
||||
</div>
|
||||
)}
|
||||
</Subscribe>
|
||||
);
|
||||
}
|
||||
|
||||
render(
|
||||
<Provider>
|
||||
<Counter />
|
||||
</Provider>,
|
||||
document.getElementById("root")
|
||||
);
|
||||
```
|
||||
|
||||
首先要为 `Provider` 正名:`Provider` 是解决单例 Store 的最佳方案,当项目与组件都是用了数据流,需要分离作用域时,`Provider` 便派上了用场。如果项目仅需单 Store 数据流,那么与根节点放一个 `Provider` 等价。
|
||||
|
||||
其次 `CounterContainer` 成为一个真正数据处理类,只负责存储与操作数据,通过 `<Subscribe to={[CounterContainer]}>` RenderProps 方法将 `counter` 注入到 Render 函数中。
|
||||
|
||||
**unstated 方案本质上利用了 `setState`,但将 `setState` 与 UI 剥离,并可以很方便的注入到任何组件中。**
|
||||
|
||||
类似的是,其升级版 `unstated-next` 本质上利用了 `useState`,利用了自定义 Hooks 可以与 UI 分离的特性,加上 `useContext` 的便捷性,利用不到 40 行代码实现了比 `unstated` 更强大的功能。
|
||||
|
||||
### unstated-next
|
||||
|
||||
`unstated-next` 用 40 行代码号称 React 数据管理库的终结版,让我们看看它是怎么做到的!
|
||||
|
||||
还是从思考过程说起,笔者发现其 README 也提供了对应思考过程,就以其 README 里的代码作为案例。
|
||||
|
||||
首先,使用 Function Component 的你会这样使用数据流:
|
||||
|
||||
```jsx
|
||||
function CounterDisplay() {
|
||||
let [count, setCount] = useState(0);
|
||||
let decrement = () => setCount(count - 1);
|
||||
let increment = () => setCount(count + 1);
|
||||
return (
|
||||
<div>
|
||||
<button onClick={decrement}>-</button>
|
||||
<p>You clicked {count} times</p>
|
||||
<button onClick={increment}>+</button>
|
||||
</div>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
如果想将数据与 UI 分离,利用 Custom Hooks 就可以完成,这不需要借助任何框架:
|
||||
|
||||
```jsx
|
||||
function useCounter() {
|
||||
let [count, setCount] = useState(0);
|
||||
let decrement = () => setCount(count - 1);
|
||||
let increment = () => setCount(count + 1);
|
||||
return { count, decrement, increment };
|
||||
}
|
||||
|
||||
function CounterDisplay() {
|
||||
let counter = useCounter();
|
||||
return (
|
||||
<div>
|
||||
<button onClick={counter.decrement}>-</button>
|
||||
<p>You clicked {counter.count} times</p>
|
||||
<button onClick={counter.increment}>+</button>
|
||||
</div>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
如果想将这个数据分享给其他组件,利用 `useContext` 就可以完成,这不需要借助任何框架:
|
||||
|
||||
```jsx
|
||||
function useCounter() {
|
||||
let [count, setCount] = useState(0);
|
||||
let decrement = () => setCount(count - 1);
|
||||
let increment = () => setCount(count + 1);
|
||||
return { count, decrement, increment };
|
||||
}
|
||||
|
||||
let Counter = createContext(null);
|
||||
|
||||
function CounterDisplay() {
|
||||
let counter = useContext(Counter);
|
||||
return (
|
||||
<div>
|
||||
<button onClick={counter.decrement}>-</button>
|
||||
<p>You clicked {counter.count} times</p>
|
||||
<button onClick={counter.increment}>+</button>
|
||||
</div>
|
||||
);
|
||||
}
|
||||
|
||||
function App() {
|
||||
let counter = useCounter();
|
||||
return (
|
||||
<Counter.Provider value={counter}>
|
||||
<CounterDisplay />
|
||||
<CounterDisplay />
|
||||
</Counter.Provider>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
但这样还是显示使用了 `useContext` 的 API,并且对 `Provider` 的封装没有形成固定模式,这就是 `usestated-next` 要解决的问题。
|
||||
|
||||
所以这就是 `unstated-next` 的使用方式:
|
||||
|
||||
```jsx
|
||||
import { createContainer } from "unstated-next";
|
||||
|
||||
function useCounter() {
|
||||
let [count, setCount] = useState(0);
|
||||
let decrement = () => setCount(count - 1);
|
||||
let increment = () => setCount(count + 1);
|
||||
return { count, decrement, increment };
|
||||
}
|
||||
|
||||
let Counter = createContainer(useCounter);
|
||||
|
||||
function CounterDisplay() {
|
||||
let counter = Counter.useContainer();
|
||||
return (
|
||||
<div>
|
||||
<button onClick={counter.decrement}>-</button>
|
||||
<p>You clicked {counter.count} times</p>
|
||||
<button onClick={counter.increment}>+</button>
|
||||
</div>
|
||||
);
|
||||
}
|
||||
|
||||
function App() {
|
||||
return (
|
||||
<Counter.Provider>
|
||||
<CounterDisplay />
|
||||
<CounterDisplay />
|
||||
</Counter.Provider>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
可以看到,`createContainer` 可以将任何 Hooks 包装成一个数据对象,这个对象有 `Provider` 与 `useContainer` 两个 API,其中 `Provider` 用于对某个作用域注入数据,而 `useContainer` 可以取到这个数据对象在当前作用域的实例。
|
||||
|
||||
对 Hooks 的参数也进行了规范化,我们可以通过 `initialState` 设定初始化数据,且不同作用域可以嵌套并赋予不同的初始化值:
|
||||
|
||||
```jsx
|
||||
function useCounter(initialState = 0) {
|
||||
let [count, setCount] = useState(initialState);
|
||||
let decrement = () => setCount(count - 1);
|
||||
let increment = () => setCount(count + 1);
|
||||
return { count, decrement, increment };
|
||||
}
|
||||
|
||||
const Counter = createContainer(useCounter);
|
||||
|
||||
function CounterDisplay() {
|
||||
let counter = Counter.useContainer();
|
||||
return (
|
||||
<div>
|
||||
<button onClick={counter.decrement}>-</button>
|
||||
<span>{counter.count}</span>
|
||||
<button onClick={counter.increment}>+</button>
|
||||
</div>
|
||||
);
|
||||
}
|
||||
|
||||
function App() {
|
||||
return (
|
||||
<Counter.Provider>
|
||||
<CounterDisplay />
|
||||
<Counter.Provider initialState={2}>
|
||||
<div>
|
||||
<div>
|
||||
<CounterDisplay />
|
||||
</div>
|
||||
</div>
|
||||
</Counter.Provider>
|
||||
</Counter.Provider>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
**可以看到,React Hooks 已经非常适合做状态管理,而生态应该做的事情是尽可能利用其能力进行模式化封装。**
|
||||
|
||||
> 有人可能会问,取数和副作用怎么办?`redux-saga` 和其他中间件都没有,这个数据流是不是阉割版?
|
||||
|
||||
首先我们看 Redux 为什么需要处理副作用的中间件。这是因为 `reducer` 是一个同步纯函数,其返回值就是操作结果中间不能有异步,且不能有副作用,所以我们需要一种异步调用 `dispatch` 的方法,或者一个副作用函数来存放这些 “脏” 逻辑。
|
||||
|
||||
而在 Hooks 中,我们可以随时调用 `useState` 提供的 `setter` 函数修改值,这早已天然解决了 `reducer` 无法异步的问题,同时也实现了 `redux-chunk` 的功能。
|
||||
|
||||
而异步功能也被 `useEffect` 这个 React 官方 Hook 替代。**我们看到这个方案可以利用 React 官方提供的能力完全覆盖 Redux 中间件的能力,对 Redux 库实现了降维打击,所以下一代数据流方案随着 Hooks 的实现是真的存在的**。
|
||||
|
||||
最后,相比 Redux 自身以及其生态库的理解成本(笔者不才,初学 Redux 以及其周边 middleware 时理解了好久),Hooks 的理解学习成本明显更小。
|
||||
|
||||
**很多时候,人们排斥一个新技术,并不是因为新技术不好,而是这可能让自己多年精通的老手艺带来的 “竞争优势” 完全消失。可能一个织布老专家手工织布效率是入门学员的 5 倍,但换上织布机器后,这个差异很快会被抹平,老织布专家面临被淘汰的危机,所以维护这份老手艺就是维护他自己的利益。希望每个团队中的老织布工人都能主动引入织布机。**
|
||||
|
||||
> 再看取数中间件,我们一般需要解决 **取数业务逻辑封装** 与 **取数状态封装**,通过 redux 中间件可以封装在内,通过一个 `dispatch` 解决。
|
||||
|
||||
其实 Hooks 思维下,利用 [swr](<[swr](https://github.com/dt-fe/weekly/blob/v2/128.%E7%B2%BE%E8%AF%BB%E3%80%8AHooks%20%E5%8F%96%E6%95%B0%20-%20swr%20%E6%BA%90%E7%A0%81%E3%80%8B.md)>) `useSWR` 一样能解决:
|
||||
|
||||
```jsx
|
||||
function Profile() {
|
||||
const { data, error } = useSWR("/api/user");
|
||||
}
|
||||
```
|
||||
|
||||
取数的业务逻辑封装在 `fetcher` 中,这个在 `SWRConfigContext.Provider` 时就已注入,还可以控制作用域!完全利用 React 提供的 Context 能力,可以感受到实现底层原理的一致性和简洁性,越简单越优美的数学公式越可能是真理。
|
||||
|
||||
而取数状态已经封装在 `useSWR` 中,配合 Suspense 能力,连 Loading 状态都不用关心了。
|
||||
|
||||
## 3 精读
|
||||
|
||||
### unstated
|
||||
|
||||
我们再梳理一下 `unstated` 这个库做了哪些事情。
|
||||
|
||||
1. 利用 `Provider` 申明作用范围。
|
||||
2. 提供 `Container` 作为可以被继承的类,继承它的 Class 作为 Store。
|
||||
3. 提供 `Subscribe` 作为 RenderProps 用法注入 Store,注入的 Store 实例由参数 `to` 接收到的 Class 实例决定。
|
||||
|
||||
对于第一点,`Provider` 在 Class Component 环境下要初始化 `StateContext`,这样才能在 `Subscribe` 中使用:
|
||||
|
||||
```jsx
|
||||
const StateContext = createReactContext(null);
|
||||
|
||||
export function Provider(props) {
|
||||
return (
|
||||
<StateContext.Consumer>
|
||||
{parentMap => {
|
||||
let childMap = new Map(parentMap);
|
||||
|
||||
if (props.inject) {
|
||||
props.inject.forEach(instance => {
|
||||
childMap.set(instance.constructor, instance);
|
||||
});
|
||||
}
|
||||
|
||||
return (
|
||||
<StateContext.Provider value={childMap}>
|
||||
{props.children}
|
||||
</StateContext.Provider>
|
||||
);
|
||||
}}
|
||||
</StateContext.Consumer>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
对于第二点,对于 `Container`,需要提供给 Store `setState` API,按照 React 的 `setState` 结构实现了一遍。
|
||||
|
||||
值得注意的是,还存储了一个 `_listeners` 对象,并且可通过 `subscribe` 与 `unsubscribe` 增删。
|
||||
|
||||
`_listeners` 存储的其实是当前绑定的组件 `onUpdate` 生命周期,然后在 `setState` 时主动触发对应组件的渲染。`onUpdate` 生命周期由 `Subscribe` 函数提供,最终调用的是 `this.setState`,这个在 `Subscribe` 部分再说明。
|
||||
|
||||
以下是 `Container` 的代码实现:
|
||||
|
||||
```jsx
|
||||
export class Container<State: {}> {
|
||||
state: State;
|
||||
_listeners: Array<Listener> = [];
|
||||
|
||||
constructor() {
|
||||
CONTAINER_DEBUG_CALLBACKS.forEach(cb => cb(this));
|
||||
}
|
||||
|
||||
setState(
|
||||
updater: $Shape<State> | ((prevState: $Shape<State>) => $Shape<State>),
|
||||
callback?: () => void
|
||||
): Promise<void> {
|
||||
return Promise.resolve().then(() => {
|
||||
let nextState;
|
||||
|
||||
if (typeof updater === "function") {
|
||||
nextState = updater(this.state);
|
||||
} else {
|
||||
nextState = updater;
|
||||
}
|
||||
|
||||
if (nextState == null) {
|
||||
if (callback) callback();
|
||||
return;
|
||||
}
|
||||
|
||||
this.state = Object.assign({}, this.state, nextState);
|
||||
|
||||
let promises = this._listeners.map(listener => listener());
|
||||
|
||||
return Promise.all(promises).then(() => {
|
||||
if (callback) {
|
||||
return callback();
|
||||
}
|
||||
});
|
||||
});
|
||||
}
|
||||
|
||||
subscribe(fn: Listener) {
|
||||
this._listeners.push(fn);
|
||||
}
|
||||
|
||||
unsubscribe(fn: Listener) {
|
||||
this._listeners = this._listeners.filter(f => f !== fn);
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
对于第三点,`Subscribe` 的 `render` 函数将 `this.props.children` 作为一个函数执行,并把对应的 Store 实例作为参数传递,这通过 `_createInstances` 函数实现。
|
||||
|
||||
`_createInstances` 利用 `instanceof` 通过 Class 类找到对应的实例,并通过 `subscribe` 将自己组件的 `onUpdate` 函数传递给对应 Store 的 `_listeners`,在解除绑定时调用 `unsubscribe` 解绑,防止不必要的 renrender。
|
||||
|
||||
以下是 `Subscribe` 源码:
|
||||
|
||||
```jsx
|
||||
export class Subscribe<Containers: ContainersType> extends React.Component<
|
||||
SubscribeProps<Containers>,
|
||||
SubscribeState
|
||||
> {
|
||||
state = {};
|
||||
instances: Array<ContainerType> = [];
|
||||
unmounted = false;
|
||||
|
||||
componentWillUnmount() {
|
||||
this.unmounted = true;
|
||||
this._unsubscribe();
|
||||
}
|
||||
|
||||
_unsubscribe() {
|
||||
this.instances.forEach(container => {
|
||||
container.unsubscribe(this.onUpdate);
|
||||
});
|
||||
}
|
||||
|
||||
onUpdate: Listener = () => {
|
||||
return new Promise(resolve => {
|
||||
if (!this.unmounted) {
|
||||
this.setState(DUMMY_STATE, resolve);
|
||||
} else {
|
||||
resolve();
|
||||
}
|
||||
});
|
||||
};
|
||||
|
||||
_createInstances(
|
||||
map: ContainerMapType | null,
|
||||
containers: ContainersType
|
||||
): Array<ContainerType> {
|
||||
this._unsubscribe();
|
||||
|
||||
if (map === null) {
|
||||
throw new Error(
|
||||
"You must wrap your <Subscribe> components with a <Provider>"
|
||||
);
|
||||
}
|
||||
|
||||
let safeMap = map;
|
||||
let instances = containers.map(ContainerItem => {
|
||||
let instance;
|
||||
|
||||
if (
|
||||
typeof ContainerItem === "object" &&
|
||||
ContainerItem instanceof Container
|
||||
) {
|
||||
instance = ContainerItem;
|
||||
} else {
|
||||
instance = safeMap.get(ContainerItem);
|
||||
|
||||
if (!instance) {
|
||||
instance = new ContainerItem();
|
||||
safeMap.set(ContainerItem, instance);
|
||||
}
|
||||
}
|
||||
|
||||
instance.unsubscribe(this.onUpdate);
|
||||
instance.subscribe(this.onUpdate);
|
||||
|
||||
return instance;
|
||||
});
|
||||
|
||||
this.instances = instances;
|
||||
return instances;
|
||||
}
|
||||
|
||||
render() {
|
||||
return (
|
||||
<StateContext.Consumer>
|
||||
{map =>
|
||||
this.props.children.apply(
|
||||
null,
|
||||
this._createInstances(map, this.props.to)
|
||||
)
|
||||
}
|
||||
</StateContext.Consumer>
|
||||
);
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
总结下来,`unstated` 将 State 外置是通过自定义 Listener 实现的,在 Store `setState` 时触发收集好的 `Subscribe` 组件的 rerender。
|
||||
|
||||
### unstated-next
|
||||
|
||||
`unstated-next` 这个库只做了一件事情:
|
||||
|
||||
1. 提供 `createContainer` 将自定义 Hooks 封装为一个数据对象,提供 `Provider` 注入与 `useContainer` 获取 Store 这两个方法。
|
||||
|
||||
正如之前解析所说,`unstated-next` 可谓将 Hooks 用到了极致,认为 Hooks 已经完全具备数据流管理的全部能力,我们只要包装一层规范即可:
|
||||
|
||||
```jsx
|
||||
export function createContainer(useHook) {
|
||||
let Context = React.createContext(null);
|
||||
|
||||
function Provider(props) {
|
||||
let value = useHook(props.initialState);
|
||||
return <Context.Provider value={value}>{props.children}</Context.Provider>;
|
||||
}
|
||||
|
||||
function useContainer() {
|
||||
let value = React.useContext(Context);
|
||||
if (value === null) {
|
||||
throw new Error("Component must be wrapped with <Container.Provider>");
|
||||
}
|
||||
return value;
|
||||
}
|
||||
|
||||
return { Provider, useContainer };
|
||||
}
|
||||
```
|
||||
|
||||
可见,`Provider` 就是对 `value` 进行了约束,**固化了 Hooks 返回的 value 直接作为 `value` 传递给 `Context.Provider` 这个规范。**
|
||||
|
||||
而 `useContainer` 就是对 `React.useContext(Context)` 的封装。
|
||||
|
||||
真的没有其他逻辑了。
|
||||
|
||||
唯一需要思考的是,在自定义 Hooks 中,我们用 `useState` 管理数据还是 `useReducer` 管理数据的问题,这个是个仁者见仁的问题。不过我们可以对自定义 Hooks 进行嵌套封装,支持一些更复杂的数据场景,比如:
|
||||
|
||||
```jsx
|
||||
function useCounter(initialState = 0) {
|
||||
const [count, setCount] = useState(initialState);
|
||||
const decrement = () => setCount(count - 1);
|
||||
const increment = () => setCount(count + 1);
|
||||
return { count, decrement, increment };
|
||||
}
|
||||
|
||||
function useUser(initialState = {}) {
|
||||
const [name, setName] = useState(initialState.name);
|
||||
const [age, setAge] = useState(initialState.age);
|
||||
const registerUser = userInfo => {
|
||||
setName(userInfo.name);
|
||||
setAge(userInfo.age);
|
||||
};
|
||||
return { user: { name, age }, registerUser };
|
||||
}
|
||||
|
||||
function useApp(initialState) {
|
||||
const { count, decrement, increment } = useCounter(initialState.count);
|
||||
const { user, registerUser } = useUser(initialState.user);
|
||||
return { count, decrement, increment, user, registerUser };
|
||||
}
|
||||
|
||||
const App = createContainer(useApp);
|
||||
```
|
||||
|
||||
## 4 总结
|
||||
|
||||
借用 `unstated-next` 的标语:“never think about React state management libraries ever again” - 用了 `unstated-next` 再也不要考虑其他 React 状态管理库了。
|
||||
|
||||
而有意思的是,`unstated-next` 本身也只是对 Hooks 的一种模式化封装,Hooks 已经能很好解决状态管理的问题,我们真的不需要 “再造” React 数据流工具了。
|
||||
|
||||
> 讨论地址是:[精读《unstated 与 unstated-next 源码》 · Issue #218 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/218)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,218 @@
|
||||
## 1 引言
|
||||
|
||||
《从 0 到 1》是一本创业经典,创业非常有魅力,需要多种维度的商业知识,包括基础经济学、公司经济学、商业学、公司金融学、甚至历史学等等。
|
||||
|
||||
为什么要懂历史学?因为《从 0 到 1》这本书的作者是 彼得·蒂尔,他是 Paypal 的创始人和投资家,想读懂他的书就必须读懂他自己的创业经历,而 Paypal 的成长经历需要以考究历史的思维学习,了解什么是 Paypal 黑帮,他与其他公司的关系,为什么 Paypal 是继英特尔时隔 20 年之后的互联网黄埔军校。
|
||||
|
||||
为什么要懂商业学?本书第一句话就是 “在商业上机会只有一次”,这是商业基本准则之一。商业不是物理学,没有必然因果关系,没有商业必胜法。同时,商业也是训练多维度思考的战场,对一个商业结果的解读多种多样,我们需要避免对结果的简单归因、过度解读、甚至是本末倒置。《从 0 到 1》这本书抓住了创业成功的精髓。
|
||||
|
||||
《从 0 到 1》这本书,就是在商业这种复杂环境下,尝试总结一套通用的成功经验。然而前面我也说了,商业没有必胜法,那什么才是驱动成功与发展的根本引擎?**就是创新**。
|
||||
|
||||
## 2 概述 & 精读
|
||||
|
||||
### 未来的挑战
|
||||
|
||||
什么人能胜任未来的挑战?彼得蒂尔认为,有创新能力的人可以,所以他面试时喜欢问:**“有什么你与其他人有不同看法,但你觉得却很重要的事”**。能真正回答好这个问题的人才算具备了基本创新能力。
|
||||
|
||||
人类技术演进分为 **水平进步与垂直进步**,水平进步是从 1 到 N 的规模化应用,而垂直进步是从 0 到 1 的创造,虽然水平进步可以给发展中国家带来巨大发展速度,但真正推动历史变革的还在于垂直进步。
|
||||
|
||||
对于创业团队,独立思考与速度很重要,因此团队规模要尽量小。彼得蒂尔对 Paypal 的管理理念重点有二:**招人越像越好、极端聚焦**,Paypal 在早期时隔工程师都是 UIUC 毕业的,5 个非技术人员都是彼得蒂尔在斯坦福校友网络认识的,背景非常趋同,因此沟通成本非常低,决策效率很高。彼得蒂尔要求员工的年终总结必须明确写出 “对公司最有价值的一个贡献”,只能写一个。
|
||||
|
||||
根据 Paypal 发展经历来看,难怪《从 0 到 1》这本书会强调小团队高灵活的重要程度,因为 Paypal 就是这么起家的。
|
||||
|
||||
### 像 1999 年那样狂欢
|
||||
|
||||
1993 年网景公司的成立拉开互联网时代的序幕,Paypal 就是这个时代成立的。
|
||||
|
||||
互联网狂欢兴起:
|
||||
|
||||
<img width=400 src="https://user-images.githubusercontent.com/7970947/69900559-e75c1e80-13af-11ea-8f60-c3c80ef2ab98.png">
|
||||
|
||||
互联网泡沫破裂:
|
||||
|
||||
<img width=350 src="https://user-images.githubusercontent.com/7970947/69900566-03f85680-13b0-11ea-86f5-8faf80ae546d.png">
|
||||
|
||||
自 1999 年之后,市场学会了保守,主要有四条:
|
||||
|
||||
1. 循序渐进的发展。
|
||||
2. 保持精简和灵活。
|
||||
3. 不要贸然开辟新市场。
|
||||
4. 专注产品而不是营销。
|
||||
|
||||
显然,1999 年互联网泡沫破裂后的美国企业家害怕了,逐渐走向了保守。**然而彼得蒂尔认为,1999 年互联网泡沫破裂的虽然惨烈,但正因如此才带来了美国未来几十年的增长。**保守无法带来成功,相反,这四条的反面反而更正确:
|
||||
|
||||
1. 大胆尝试胜过平庸保守。
|
||||
2. 坏计划也好过没有计划。
|
||||
3. 竞争性市场对收益有负面影响。
|
||||
4. 营销和产品同样重要。
|
||||
|
||||
**狂妄自大的尝试必定导致大部分人悲惨的失败,但我们别无选择,创业必须创新,必须实现从 0 到 1。**所以彼得蒂尔反直觉的观点就是,我们不能因为吸取 1999 年的教训就变得保守,反而美国需要 1999 年那股狂热驱动新的创新。
|
||||
|
||||
### 所有成功的企业都是不同的
|
||||
|
||||
彼得蒂尔完美解释了垄断的价值。
|
||||
|
||||
市场分为充分竞争与完全垄断,看上去充分竞争的市场更有活力,更健康,但实则不然。**充分竞争将利润完全吞噬,只有完全垄断才能获得持久价值,最终对市场有利。**
|
||||
|
||||
对创业者来说也一样,如果你相信充分竞争,你只会创建一家同质化的公司,扎到红海里拼命挣扎,这不会给你带来持久的利益,也不会给市场带来真正的发展。
|
||||
|
||||
垄断者为了逃避垄断保护法,会竭尽全力证明自己没有取得垄断地位(甚至随时会被市场吃掉),同理,**竞争者为了自我麻痹或争取到投资,也会竭尽全力证明自己还有机会,市场并未形成垄断。** 然而无论怎么说,真正为市场创造独一无二价值的还是垄断者,虽然他们看起来很可恶。
|
||||
|
||||
不仅在商业如此,互联网公司内部技术竞争也一样:**低水平的重复竞争挑战者会竭尽全力证明自己所在的领域不存在垄断,然后投入人力做一个注定会失败的项目,不仅无法为公司产生新的价值,还带来了资源内耗。相反,那个垄断者才是为公司源源不断带来价值的引擎,虽然竞争者们都厌恶它。这也是为什么阿里鼓励高水平竞争,禁止低水平重复轮子。**
|
||||
|
||||
### 竞争意识
|
||||
|
||||
大家觉得竞争理所应当,但其实竞争更多带来的是伤害。
|
||||
|
||||
在奇葩说里听到薛兆丰这么一句话:“求职者你们的竞争对手不是企业,而是其他求职者”。说的很有道理,真正的伤害是在竞争中产生的,而存在供需关系的公司与求职者之间哪存在什么竞争?直白一点说,如果整个市场只有一个应聘者,哪怕小学没毕业,阿里腾讯也会抢着要。
|
||||
|
||||
**竞争使我们过度看中过去的机会,而忽略创造新的可能性。** 就像 Paypal 与 X 合并一样,彼得蒂尔发现这两家公司的竞争关系是恶性的,只有合并后形成垄断才能创造新的价值。而 X 公司的创始人就是埃隆·马斯克,虽然最后因为极力推广 X 品牌被合并后的 Paypal 请出局后,依然在 Paypal 被 20 多亿美元收购后,获得了一亿多美元回报,才创建了特斯拉和太空探索公司,真正为社会创造新的价值。
|
||||
|
||||
### 后发优势
|
||||
|
||||
既然垄断如此重要,那么如何打造垄断?
|
||||
|
||||
**首先一个企业的价值是它未来创造利润的总和**。也许你会奇怪,为什么企业现在的资产不算做企业价值呢?企业价值一般指的是企业市值,企业市值描述的企业价值其实是它的 **当前投资价值**,一个不能在未来创造利润的企业,就算现在坐拥几千亿美元的资产,对你来说也是没有投资价值的。
|
||||
|
||||
建立企业垄断,可以建立企业的护城河,比如专利技术或者网络效应;或者先进入小市场,逐步扩大范围,就像亚马逊从图书在线交易切入,随后扩张到全品类。与你的对手产生放大收益,你不能仅仅取代你的对手,最好能为它赋能。这些都是企业的后发优势。
|
||||
|
||||
### 成功不是中彩票
|
||||
|
||||
虽然大部分成功创业者都会将一半功劳归功于运气,但你最好不要真的相信,否则为什么有那么多连续失败的创业者呢?如果创业需要运气,那为什么彼得蒂尔要写《从 0 到 1》这本书,为什么我还要精读它呢?
|
||||
|
||||
**成功者的运气是靠努力换来的**。
|
||||
|
||||
国家就是一个巨大的创业,彼得蒂尔对当下各国对未来看法划出了四象限图:
|
||||
|
||||
<img width=400 src="https://user-images.githubusercontent.com/7970947/69900946-35275580-13b5-11ea-880b-63403fa154f5.png">
|
||||
|
||||
- 明确乐观的未来:1950~1970 的美国,当时美国创新能力和工程应用都在上升期,未来是明确且乐观的。
|
||||
- 不明确乐观的未来:1982 至今的美国,由于技术发展遇到了瓶颈,比如生物制药和医疗都有巨大不确定性,人们只知道未来是美好的,但不知道何时可以到来。
|
||||
- 明确悲观的未来:**现在的中国,由于缺乏核心创新能力,现在中国迅猛发展其实在吃发达国家创新的红利,只是将这些技术规模化应用,所以发展方向是明确的,但一旦红利吃完,不确定自己是否能找到新的突破点,因此对未来是悲观的。**
|
||||
- 不明确悲观的未来:现在的欧洲,技术红利和规模化都吃完了,不知道未来该怎么走,也不知道走向哪里。
|
||||
|
||||
不论国家还是公司,在这个时代想要拥有最好的未来,就是不明确乐观的未来,虽然这个乐观是不明确的,也就是需要运气,但只要在正确的方向努力,总是可能会成功。如果你真的相信比尔盖兹成功来源于运气,那请理解这是一个明确的运气,而不是不明确的运气,并不是所有方向的创业都可能走向成功。
|
||||
|
||||
### 向钱看
|
||||
|
||||
当爱因斯坦宣称复利是“世界第八大奇迹”,因为钱可以生钱,本质原因是指数级增长。指数级增长之所以如此可怕,还因为并没有证据表明爱英斯坦说过这句话,但因为他的影响力有指数级影响力,所有有影响力的话可能都会 “归功给他”。
|
||||
|
||||
风险投资领域也是如此,一家风投最成功的项目带来的收益可能超过其他所有项目的总和,所以风投才会不断给有发展潜力的企业加注,这都是因为指数级效应。
|
||||
|
||||
所以如果你创业的公司不能成为幂次法则指数增长的类型,最好尽快换一个项目,因为做一个平庸的项目是没有意义的,世界的天枰都会为头部项目加码。
|
||||
|
||||
### 秘密
|
||||
|
||||
企业只有创新才能获得成功,那一定是发现了新的 “商业秘密”。
|
||||
|
||||
但现在社会发展遇到了瓶颈,大家都不愿意探索新的秘密,主要有四个原因:
|
||||
|
||||
1. 认为已经没有新的秘密。就像探索世界一样,当地球完全被开发,已经没有探索的必要。
|
||||
2. 规避风险。害怕没有找到秘密而耽误自己的人生。
|
||||
3. 自满。安于现状,认为不需要探寻新的秘密。
|
||||
4. 扁平化。由于互联网对社会的连接,我们更容易觉得竞争是全球化的,如果有新的秘密,一定会更优秀的人发现,而显然我不是最优秀的人,所以我没有必要去发觉秘密,那些最优秀的人会帮我做到。
|
||||
|
||||
想要扭转这个悲观思想,**你需要意识到现代分工是极度专业化的,不同领域间往往很难竞争**,一个物理学家可能难于解决情感问题,要相信还有许多未被关注的细分领域可能存在蓝海。
|
||||
|
||||
### 基础决定命运
|
||||
|
||||
就像宪法决定了国家基础一样,企业最初决定的重要思想对未来发展起到决定因素,比如行业方向与招聘要求。
|
||||
|
||||
因此初创公司一定要确保创始人团队之间是否有默契,所有权、经营权和控制权是否分配合理,不要有兼职员工,最好以股权激励员工。
|
||||
|
||||
在技术领域做架构设计也是如此,架构基础决定了未来发展命运,我们必须尽可能保证早期架构设计的合理性,并坚持这些原则,就像坚持宪法一样。
|
||||
|
||||
### 黑手党式的机制
|
||||
|
||||
为什么 Paypal 早期员工被称为 Paypal 黑帮?其实彼得蒂尔创建的 Paypal 由于触及到金融领域,相关利益方非常复杂,对于没有政府背景的他来说几乎是不可能做成的。
|
||||
|
||||
Paypal 招来的早期员工必须极度认同其企业文化,认同 “创造虚拟货币代替美元” 这个疯狂的想法。
|
||||
|
||||
**Paypal 黑帮对公司的使命有着近乎于 “邪教” 般的信仰,唯一区别是,他们做的事情本身并不坏。**
|
||||
|
||||
### 顾客不会自动上门
|
||||
|
||||
销售和技术同样重要。
|
||||
|
||||
在工程技术界,技术打造的产品功能界限清晰,不是生效就是失效,而销售界,需要通过精心设计活动来打动用户的芳心,但却不能改变产品的实质性内容。技术内容是务实的,销售内容是务虚的,但我们不能说务实一定比务虚重要。
|
||||
|
||||
销售的技巧也随着业务场景的不同而不同。
|
||||
|
||||
- 复杂营销。当面对大企业客户时,甚至要克服政治惰性说服政府太空飞船采用你们公司的技术,而一旦完成协议的签署,哪怕只有几单,也足够维持公司后续发展了。
|
||||
- 人员营销。和复杂营销相反,需要从具体场景逐渐深入,比如 Box 公司的云存储服务,首先卖给了斯坦福睡眠诊所,之后逐步扩展到整个斯坦福大学,但如果 Box 一开始就和斯坦福的校长洽谈整个学校的云服务方案,可能一开始就会失败。
|
||||
- 病毒式营销。Paypal 的增长过程就是病毒式营销的范例,通过邀请机制传播给好友,并给最多 20 美元的奖励,也就是获客成本 20 元支撑了 Paypal 病毒式营销的成立。
|
||||
|
||||
然而 Paypal 也不是漫无目的的砸钱,首先它砸钱有自己的原因,因为 Paypal 是一个拥有网络效应的项目,因此拥有越多的用户就能带来越多的未来价值,这是 Paypal 可以选择烧钱营销的最大原因。
|
||||
|
||||
其次 Paypal 也选择了两个聪明的营销方式,第一是通过邮箱营销,由于当时世界上拥有邮箱的用户很少,都是一些对新技术持有开放态度的用户,因此邮件营销的人群就比较正确。后来 Paypal 发现,eBay 有部分商家甚至主动在商户页面贴出注册 Paypal 的链接,不仅是为了赚取佣金,更因为 Paypal 网络支付的最大场景就是电商交易平台,因此后续 Paypal 重点转向 eBay 推广。
|
||||
|
||||
### 人类和机器
|
||||
|
||||
**机器未来并不是为了取代人类,而是辅助人类更高效工作。** 在 [精读《刷新》](https://github.com/dt-fe/weekly/blob/v2/116.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%88%B7%E6%96%B0%E3%80%8B.md#%E5%85%B6%E5%AE%83) 中,微软 CEO 萨提亚·纳德拉也提到了人与机器的关系 - “机器替代人类工作的过程,也是人类逐渐拾回作为人的尊严的过程。人本就应该将时间用于思考与创造,而不是重复性劳动。”
|
||||
|
||||
有意思的是,彼得蒂尔在创立 Paypal 过程中由于遇到不法分子盗刷信用卡的问题,因此专门研究网络安全并研发出验证码、数据分析等一直沿用至今的重要网络安全技术,甚至在 Paypal 被 eBay 收购后,彼得蒂尔还专门成立了 Clarium Capital 公司为政府提供安全服务,其核心技术就是在 Paypal 期间为了对抗支付安全问题时打下基础的。
|
||||
|
||||
所以彼得蒂尔在思考机器和人类关系时,会重点关注机器帮助人类提升价值的领域。其中有一句话触达了问题本质:**“机器不会有利己的诉求,因此价值最终会转移至人类”。** 只要机器永远不要求自我价值的实现,人类和机器就能和平共处下去。
|
||||
|
||||
### 绿色能源与特斯拉
|
||||
|
||||
由于彼得蒂尔与埃隆·马斯克曾经互为敌友关系,因此就关注到了特斯拉与绿色能源的问题。
|
||||
|
||||
彼得蒂尔认为,绿色能源技术要思考好如下 7 个问题:
|
||||
|
||||
1. 工程问题,如果一个新技术不能带来本质的突破,那么其未来增长价值就不明显,公司的未来也不够清晰,狂热的投资注定引发泡沫。新能源技术目前带来的提升不是数倍的,因此前景不明确,无法说服大家一定去用这个产品。
|
||||
2. 时机问题,目前新能源领域技术并没有质的突破,现在进入注定面临技术储备不足的问题。
|
||||
3. 垄断问题,新能源技术是否能够垄断?新能源公司可能在故意隐瞒自己在市场中的渺小程度,其实相对于全球能源市场,新能源只是很小的子版块,整个行业总市值可能都不大。
|
||||
4. 人员问题。新能源是个技术问题,但现在融资需要 CEO 们西装革履的到处募集资金,这是严重的人员问题。
|
||||
5. 销售问题。人们对新能源领域、新能源汽车的接受程度有多大?是否足够便捷?
|
||||
6. 持久问题。随着中国在新能源市场的加入,导致美国新能源企业增长疲软,所以指责中国的声音很多。这是个危险的信号,如果成为垄断者需要以指责的方式进行,注定会失败。另外化石燃料随着液压破碎法的成熟,导致 2008 年天然气价格下降了 70% 多,新能源已不再是解决能源问题的唯一破局方式。
|
||||
7. 秘密问题。节省能源是一个政治正确的问题,大家都在呼吁要环保,那么这就证明环保项目一定有市场?不一定。
|
||||
|
||||
特斯拉的成功是因为解决了这 7 个问题,并且从实际的小领域切入,并且和政府以及其他企业达成了技术合作。这说明,在能源 2.0 市场中,企业面临的主要挑战是如何找到一个正确的小型市场。
|
||||
|
||||
### 创始人的悖论
|
||||
|
||||
这个章节,彼得蒂尔分析了各种名人或创业者的特质,内容非常丰富,由于篇幅限制就不展开了,而且由于笔者在这方面缺乏相应的阅历,很难原汁原味的还原出他对每个名人的评价,因此细节还是推荐阅读原文。
|
||||
|
||||
以下只能做简单的总结,只能理解到其中部分思想:
|
||||
|
||||
1. 伟人都拥有矛盾的两面性,企业需要极端的创始人,平庸的人往往很难成为好的创始人。
|
||||
2. 伟人的两面性与其成功路径存在相互塑造的过程,很难说是因为存在矛盾才导致了其成功,还是在成功的过程中塑造了其矛盾的性格。
|
||||
3. 伟人往往都会亲手终结自己的良好形象,除非英年早逝。
|
||||
|
||||
当然,这并不是说为了成功,我们必须成为这样的人,这个章节只是对创始人悖论这个现象的一种解读,可能这是一种自然现象,我们不需要模仿,只需要理解。
|
||||
|
||||
### 对未来的预期
|
||||
|
||||
哲学家尼克·博斯特罗姆描述了四种预测未来的理论:
|
||||
|
||||
1. 兴衰交替。由于历史总是呈现繁荣与衰败的交替,因此未来也很可能逃不出这个循环。
|
||||
2. 未来稳定发展。按照当今世界发展节奏,最后所有国家都进入发达国家行列,人民生活水平整体提高。
|
||||
3. 毁灭性衰落。由于地缘政治原因,未来不可避免会发生毁灭性冲突,人类文明可能呈断崖式下跌。
|
||||
4. 奇点。非常难以预测的加速发展,以至于发展到现在人类难以理解的高度。因为这个概念本身突出的就是 “发展到难以理解的高度”,因此试图去理解它的思考都反而会偏题,因此把它当作一种无法预测的未来吧。
|
||||
|
||||
笔者发现,现代大师人物写的书,最后都有对未来的预测,而且大家对未来的预测不同与书籍观点间的差异,往往都是很趋同的,这到底是英雄所见略同还是人类顶级大脑能到达的高度已经达到天花板?这是一个开放问题。
|
||||
|
||||
最后,保持独立思考是我们能重构世界的最佳方式。
|
||||
|
||||
## 4 总结
|
||||
|
||||
那到底什么是创新?巴菲特说过,商业最重要的是护城河,护城河不是什么产品质量、高素质员工、巨大的市场份额。真正的护城河是:**企业无形资产比如品牌、高客户转换成本、成本优势、网络效应**。Paypal 创新的找到了符合网络效应的业务场景:“网络货币”。
|
||||
|
||||
为什么 “网络货币” 拥有网络效应呢?所谓网络效应是指,每新增一个用户,就会对产品价值带来指数级提升。支付网络每增加一个人,不但你可以参与交易,还让交易网络变得更大,让更多交易成为可能,甚至成为全球通用货币,获得比国家货币更强的流通性,而这个质变只需要更多的用户加入即可,这就是它的网络效应。
|
||||
|
||||
《从 0 到 1》是一本创新思维的启蒙书,但想要深入理解这本书提供的概念,基本的经济学、商业知识是必不可少的,至少要理解到创新指的是为企业构筑护城河,而网络效应是 Paypal 的一个重要护城河。
|
||||
|
||||
类似拥有网络效应的还有 Uber 和 Airbnb,但他们创新思维不同,导致网络效应的大小也不同。Airbnb 的网络效应是全球的,因为场景天然是 “旅游时自有房屋出租”,每成交一对商家与客户,都可能是跨地区的,而且客户也有自己的房子,可能下次自己就会成为商家。而 Uber 业务场景天然是同城的叫车服务,因此无法形成全球的网络效应壁垒,这也是为什么 Uber 无法竞争过中国的滴滴,但 Airbnb 的全球市场地位无人能撼动。
|
||||
|
||||
商业领域远远不止于此,研究商业就像研究历史,每个公司都能给我们带来巨大启发。而商业最迷人的地方就在它的非必然性,就算你反复研究历史,熟读《从 0 到 1》这本书,他也无法给你带来必胜的商业操作路径。但这本书真正能带来的是正确而成功的信念,只要确定你的方向是正确的 “创新”,至少你可以正视失败,坦然开启下一段创业旅程,而说不定哪一次就成功了呢。
|
||||
|
||||
> 讨论地址是:[精读《从 0 到 1》 · Issue #219 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/219)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
Reference in New Issue
Block a user