Compare commits
| Author | SHA1 | Date | |
|---|---|---|---|
 ascoders |
d4eb4ee606 | ||
|
ascoders
|
04c67e183d | ||
|
ascoders
|
86ccf45f85 | ||
|
ascoders
|
3f9febce36 | ||
|
黄子毅
|
140da78305 | ||
|
AmagiDDmxh
|
12c85b9418 | ||
|
黄子毅
|
4cee1951da | ||
|
915016229
|
548fde2f85 | ||
|
ascoders
|
1ed6ac5c48 | ||
|
ascoders
|
4b1fa0c7c6 |
@@ -6,7 +6,7 @@
|
||||
|
||||
前端界的好文精读,每周更新!
|
||||
|
||||
最新精读:<a href="./前沿技术/216.%E7%B2%BE%E8%AF%BB%E3%80%8A15%20%E5%A4%A7%20LOD%20%E8%A1%A8%E8%BE%BE%E5%BC%8F%20-%20%E4%B8%8A%E3%80%8B.md">216.精读《15 大 LOD 表达式 - 上》</a>
|
||||
最新精读:<a href="./前沿技术/220.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%B7%B1%E5%85%A5%E4%BA%86%E8%A7%A3%E7%8E%B0%E4%BB%A3%E6%B5%8F%E8%A7%88%E5%99%A8%E4%BA%8C%E3%80%8B.md">220.精读《深入了解现代浏览器二》</a>
|
||||
|
||||
素材来源:[周刊参考池](https://github.com/ascoders/weekly/issues/2)
|
||||
|
||||
@@ -174,6 +174,10 @@
|
||||
- <a href="./前沿技术/214.%E7%B2%BE%E8%AF%BB%E3%80%8Aweb%20streams%E3%80%8B.md">214.精读《web streams》</a>
|
||||
- <a href="./前沿技术/215.%E7%B2%BE%E8%AF%BB%E3%80%8A%E4%BB%80%E4%B9%88%E6%98%AF%20LOD%20%E8%A1%A8%E8%BE%BE%E5%BC%8F%E3%80%8B.md">215.精读《什么是 LOD 表达式》</a>
|
||||
- <a href="./前沿技术/216.%E7%B2%BE%E8%AF%BB%E3%80%8A15%20%E5%A4%A7%20LOD%20%E8%A1%A8%E8%BE%BE%E5%BC%8F%20-%20%E4%B8%8A%E3%80%8B.md">216.精读《15 大 LOD 表达式 - 上》</a>
|
||||
- <a href="./前沿技术/217.%E7%B2%BE%E8%AF%BB%E3%80%8A15%20%E5%A4%A7%20LOD%20%E8%A1%A8%E8%BE%BE%E5%BC%8F%20-%20%E4%B8%8B%E3%80%8B.md">217.精读《15 大 LOD 表达式 - 下》</a>
|
||||
- <a href="./前沿技术/218.%E7%B2%BE%E8%AF%BB%E3%80%8ARust%20%E6%98%AF%20JS%20%E5%9F%BA%E5%BB%BA%E7%9A%84%E6%9C%AA%E6%9D%A5%E3%80%8B.md">218.精读《Rust 是 JS 基建的未来》</a>
|
||||
- <a href="./前沿技术/219.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%B7%B1%E5%85%A5%E4%BA%86%E8%A7%A3%E7%8E%B0%E4%BB%A3%E6%B5%8F%E8%A7%88%E5%99%A8%E4%B8%80%E3%80%8B.md">219.精读《深入了解现代浏览器一》</a>
|
||||
- <a href="./前沿技术/220.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%B7%B1%E5%85%A5%E4%BA%86%E8%A7%A3%E7%8E%B0%E4%BB%A3%E6%B5%8F%E8%A7%88%E5%99%A8%E4%BA%8C%E3%80%8B.md">220.精读《深入了解现代浏览器二》</a>
|
||||
|
||||
### 设计模式
|
||||
|
||||
|
||||
@@ -0,0 +1,183 @@
|
||||
接着上一篇 [精读《15 大 LOD 表达式 - 上》](https://github.com/ascoders/weekly/blob/master/%E5%89%8D%E6%B2%BF%E6%8A%80%E6%9C%AF/216.%E7%B2%BE%E8%AF%BB%E3%80%8A15%20%E5%A4%A7%20LOD%20%E8%A1%A8%E8%BE%BE%E5%BC%8F%20-%20%E4%B8%8A%E3%80%8B.md) ,这次继续总结 [Top 15 LOD Expressions](https://www.tableau.com/about/blog/LOD-expressions) 这篇文章的 9~15 场景。
|
||||
|
||||
## 9. 某时间段内最后一天的值
|
||||
|
||||
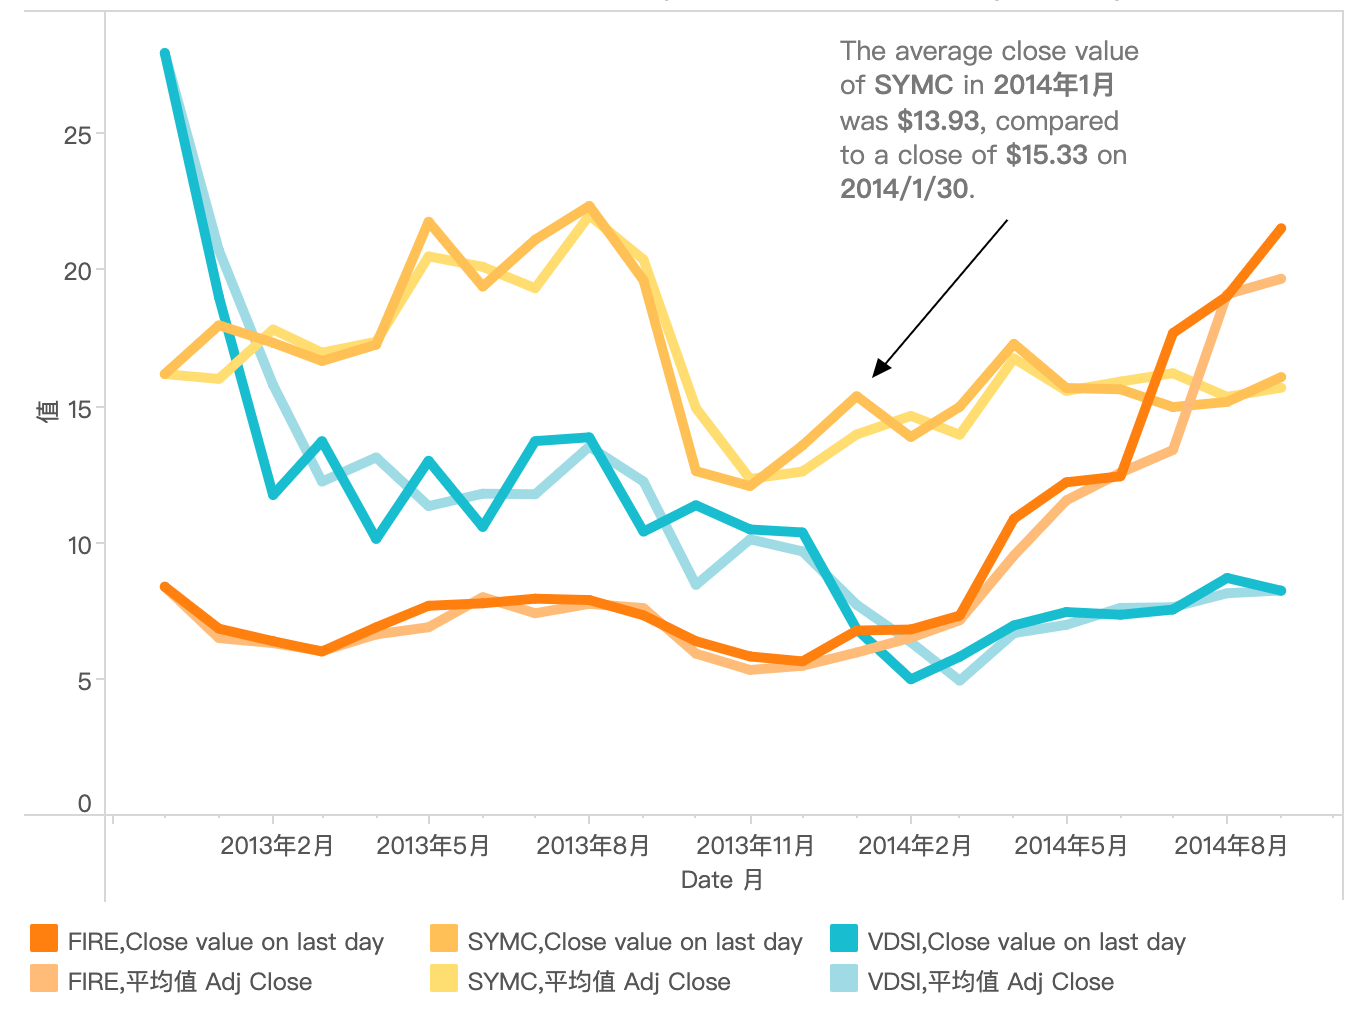
如何实现股票平均每日收盘价与当月最后一天收盘价的对比趋势图?
|
||||
|
||||
|
||||
|
||||
如图所示,要对比的并非是某个时间段,而是当月最后一天的收盘价,因此必须要借助 LOD 表达式。
|
||||
|
||||
设想原表如下:
|
||||
|
||||
| Date | Ticker | Adj Close |
|
||||
| ---- | ---- | ---- |
|
||||
| 29/08/2013 | SYMC | $1 |
|
||||
| 28/08/2013 | SYMC | $2 |
|
||||
| 27/08/2013 | SYMC | $3 |
|
||||
|
||||
我们按照月进行聚合作为横轴,求 `avg([Adj Close])` 作为纵轴即可。但计算对比我们需要一个 Max Date 字段如下:
|
||||
|
||||
| Date | Ticker | Adj Close | Max, Date |
|
||||
| ---- | ---- | ---- | ---- |
|
||||
| 29/08/2013 | SYMC | $1 | 29/08/2013 |
|
||||
| 28/08/2013 | SYMC | $2 | 29/08/2013 |
|
||||
| 27/08/2013 | SYMC | $3 | 29/08/2013 |
|
||||
|
||||
如果我们使用 `max(Date)` 表达式,在聚合后结果是可以看到 Max Date 的:
|
||||
|
||||
| Month of Date | Ticker | Avg, Adj Close | Max, Date
|
||||
| ---- | ---- | ---- | ---- |
|
||||
| 08/2013 | SYMC | $2 | 29/08/2013 |
|
||||
|
||||
原因是,`max(Date)` 是一个聚合表达式,只能在 group by 聚合 sql 下生效。但如果我们要计算最后一天的收盘价,就要执行 `sum([Close value on last day]`,表达式如下:
|
||||
|
||||
`[Close value on last day] = if [Max Date] = [Date] then [Adj Close] else 0 end`。
|
||||
|
||||
但问题是,这个表达式计算的明细级别是以天为粒度的,我们 `max(Date)` 在天粒度下是算不出来的:
|
||||
|
||||
| Date | Ticker | Adj Close | Max, Date |
|
||||
| ---- | ---- | ---- | ---- |
|
||||
| 29/08/2013 | SYMC | $1 | |
|
||||
| 28/08/2013 | SYMC | $2 | |
|
||||
| 27/08/2013 | SYMC | $3 | |
|
||||
|
||||
原因就是上面说过的,聚合表达式不能在非聚合的明细级别中出现。因此我们利用 `{ include : max([Date]) }` 表达式就能轻松实现下面的效果了:
|
||||
|
||||
| Date | Ticker | Adj Close | { include : max([Date]) } |
|
||||
| ---- | ---- | ---- | ---- |
|
||||
| 29/08/2013 | SYMC | $1 | 29/08/2013 |
|
||||
| 28/08/2013 | SYMC | $2 | 29/08/2013 |
|
||||
| 27/08/2013 | SYMC | $3 | 29/08/2013 |
|
||||
|
||||
`{ include : max([Date]) }` 表达式没有给定 include 参数,意味着永远以当前视图的明细级别计算,因此这个字段下推到明细表做计算时,也可以出现在明细表的每一行。接着按照上面的思路组装表达式即可。
|
||||
|
||||
拓展一下,如果横轴我们按年进行聚合,那么对比值就是每年最后一天的收盘价。原因是 `{ include : max([Date]) }` 会以当前年这个粒度计算 `max([Date])`,自然是当年的最后一天,然后下推到明细表,整整一年 365 行数据中,`[Close value on last day]` 大概是这样:
|
||||
|
||||
| Date | Ticker | Adj Close | [Close value on last day] |
|
||||
| ---- | ---- | ---- | ---- |
|
||||
| 31/12/2013 | SYMC | $1 | $1 |
|
||||
| 30/12/2013 | SYMC | $2 | $1 |
|
||||
| ... | ... | ... | ... |
|
||||
| 03/01/2013 | SYMC | $7 | $1 |
|
||||
| 02/01/2013 | SYMC | $8 | $1 |
|
||||
| 01/01/2013 | SYMC | $9 | $1 |
|
||||
|
||||
接着对比值按照 `sum([Close value on last day])` 聚合即可。
|
||||
|
||||
## 10. 复购阵列
|
||||
|
||||
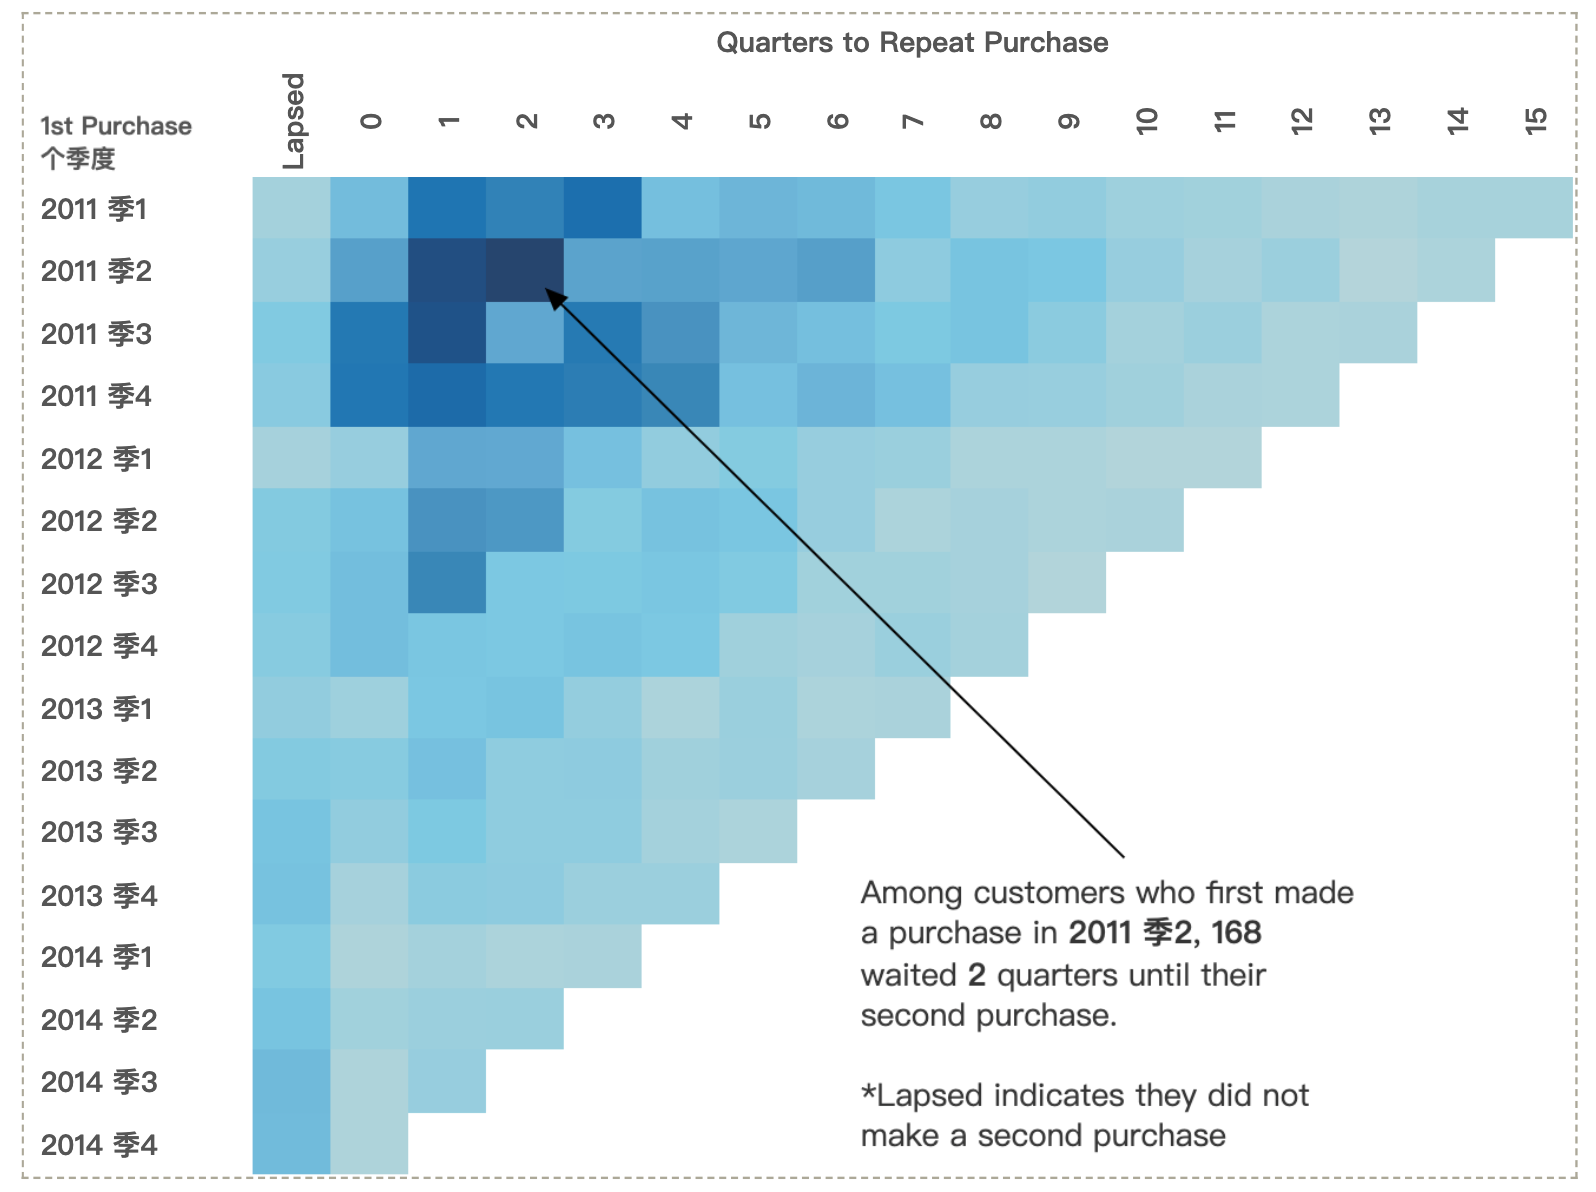
如下图所示,希望查看客户第一次购买到第二次购买间隔季度的复购阵列:
|
||||
|
||||
|
||||
|
||||
关键在于如何求第一次与第二次购买的季度时间差。首先可以通过 `[1st purchase] = { fixed [customer id] : min([order date]) }` 计算每位客户首次购买时间。
|
||||
|
||||
如何计算第二次购买时间?这里有个小技巧。首先利用 `[repeat purchase] = iif([order date] > [1st purchase], [order date], null)` 得到一个新列,首次购买的那一行值为 null,我们可以利用 `min` 函数计算时忽略 null 的特性,得到第二次购买时间:`[2nd purchase] = { fixed [customer id] : min([repeat purchase]) }`。
|
||||
|
||||
最后利用 `datediff` 函数得到间隔的季度数:`[quarters repeat to purchase] = datediff('quarter', [1st prechase], [2nd purchase])`。
|
||||
|
||||
## 11. 范围平均值差异百分比
|
||||
|
||||
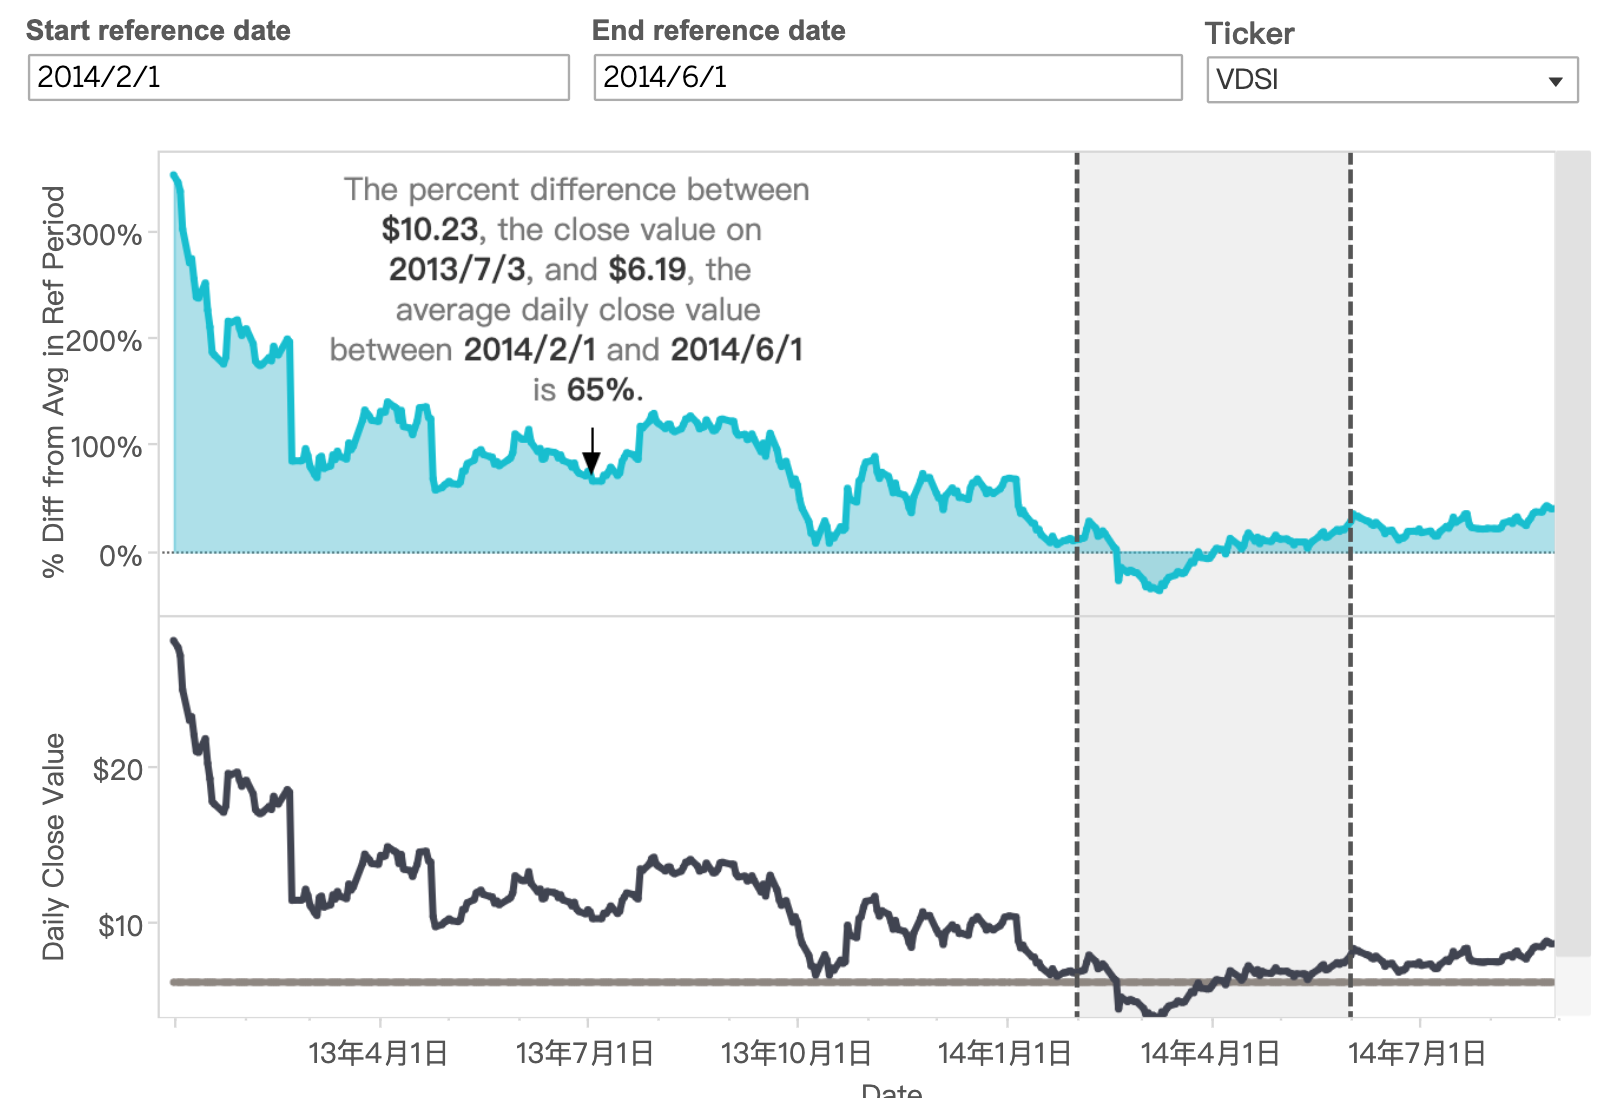
如下图所示,我们希望将趋势图的每个点,与选定区域(图中两个虚线范围内)的均值做一个差异百分比,并生成一个新的折线图放在上方。
|
||||
|
||||
|
||||
|
||||
重点是上面折线图 y 轴字段,差异百分比如何表示。首先我们要生成一个只包含指定区间的收盘值:
|
||||
|
||||
`[Close value in reference period] = IF [Date] >= [Start reference date] AND [Date] <= [End reference date] THEN [Adj close] END`,这段表达式只在日期在制定区间内时,才返回 `[Adj close]`,也就是只包含这个区间内的值。
|
||||
|
||||
第二步,计算制定区间的平均值,这个用 FIX 表达式即可:`[Average daily close value between ref date] = { fixed [Ticker] : AVG([Close value in reference period]) }`。
|
||||
|
||||
第三步,计算百分比差异:`[percent different from ref period] = ([Adj close] - [Average daily close value between ref date]) / [Average daily close value between ref date]`。
|
||||
|
||||
最后就是用 `[percent different from ref period]` 这个字段绘制上面的图形了。
|
||||
|
||||
## 12. 相对周期过滤
|
||||
|
||||
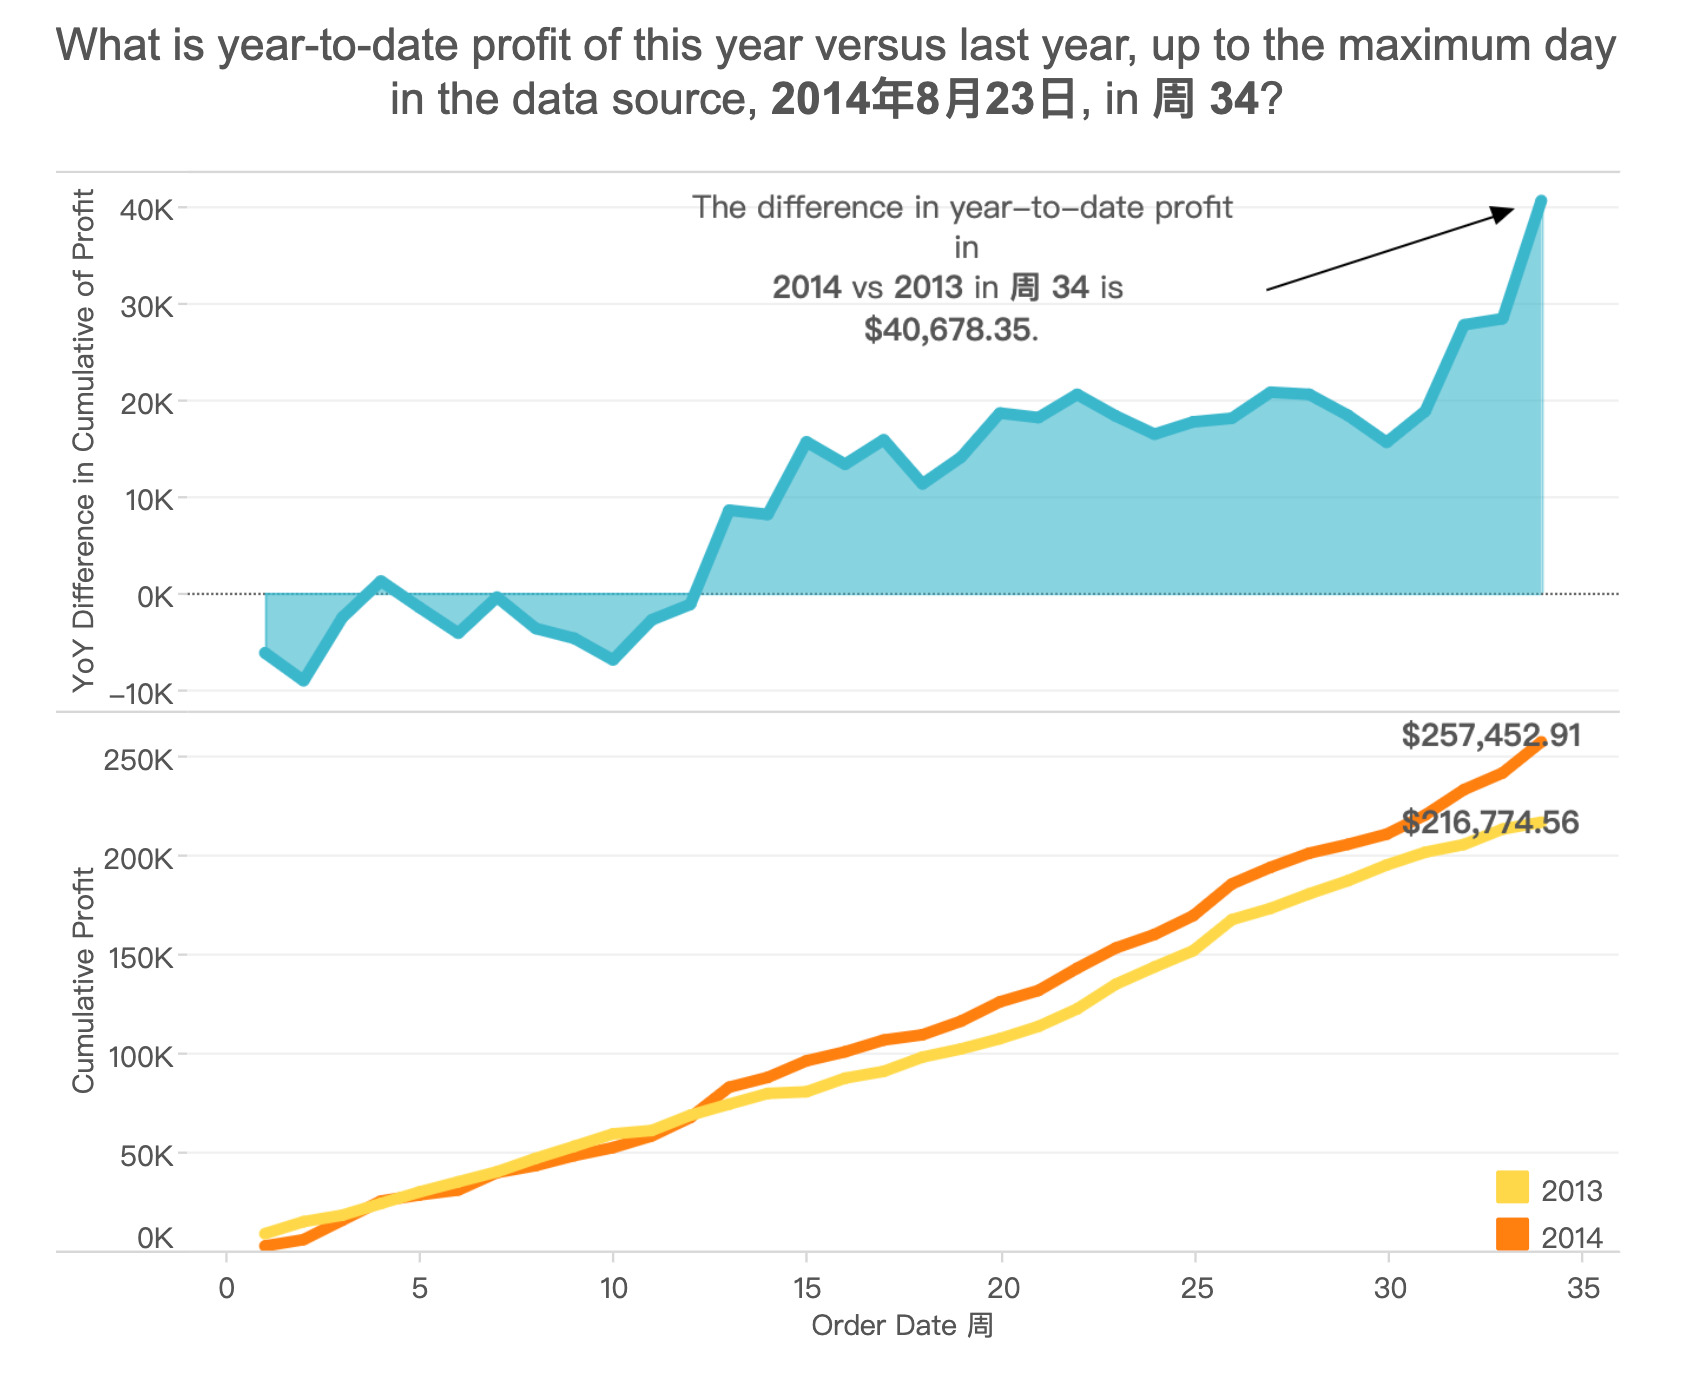
如果我们想对比两个周期数据差异,可能会遇到数据不全导致的错误。比如今年 3 月份数据只产出到 6 号,但却和去年 3 月整月的数据进行对比,显然是不合理的。我们可以利用 LOD 表达式解决这个问题:
|
||||
|
||||
|
||||
|
||||
相对周期过滤的重点是,不能直接用日期进行对比,因为今年数据总是比去年大。比如因为今年最新数据到 11.11 号,那么去年 11.11 号之后的数据都要被过滤掉。
|
||||
|
||||
首先找到最新数据是哪一天,利用不包含条件的 FIX 表达式即可:`[max date] = { max([date]) }`。
|
||||
|
||||
然后利用 datepart 函数计算当前日期是今年的第几天:
|
||||
|
||||
`[day of year of max date] = datepart('dayofyear', [max date])`,`[day of year of order date] = datepart('dayofyear', [order date])`。
|
||||
|
||||
所以 `[day of year of max date]` 就是一个卡点,任何超过今年这么多天的数据都要过滤掉。因此我们创建一个过滤条件:`[period filter] = [day of year of order date] <= [day of year of max date]`。
|
||||
|
||||
把 `[period filter]` 字段作为筛选条件即可。
|
||||
|
||||
## 13. 用户登陆频率
|
||||
|
||||
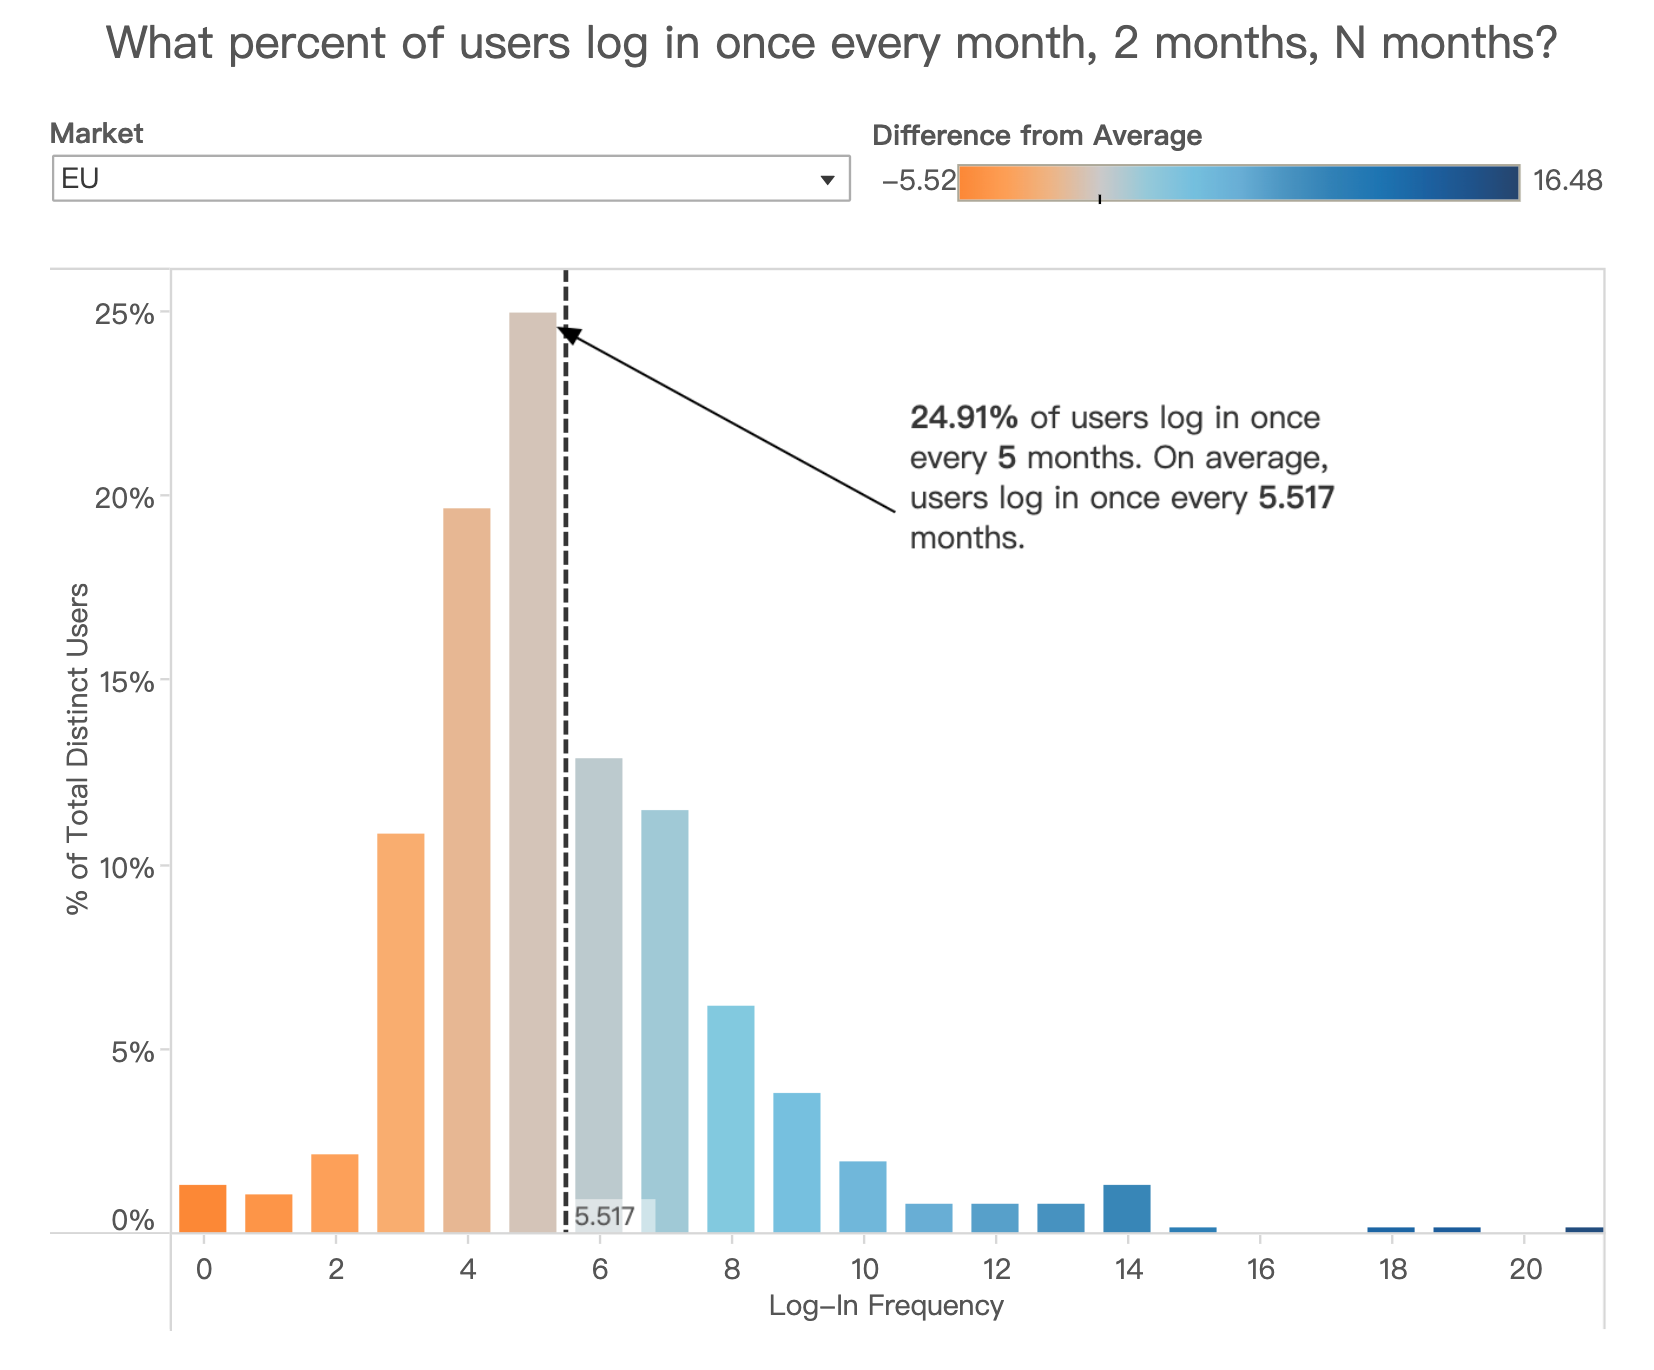
如何绘制一个用户每个月登陆频率?
|
||||
|
||||
|
||||
|
||||
要计算这个指标,得用用户总活跃时间除以总登陆次数。
|
||||
|
||||
首先计算总活跃时间:利用 FIX 表达式计算用户最早、最晚的登陆时间:
|
||||
|
||||
- `[first login] = { fixed [user id] : min([log in date]) }`
|
||||
- `[last login] = { fixed [user id] : max([log in date]) }`
|
||||
|
||||
计算其中月份 diff,就是用户活跃月数:
|
||||
|
||||
`[total months user is active] = datediff("month", [first login], [last login])`
|
||||
|
||||
总登录次数比较简单,也是固定用户 ID 后,对登陆日期计数即可:
|
||||
|
||||
`[numbers of logins per user] = { fixed [user id] : count([login date]) }`
|
||||
|
||||
最后,我们用两者相除,得到用户登陆频率:
|
||||
|
||||
`[login frequency] = [total months user is active] / [numbers of logins per user]`
|
||||
|
||||
制作图表就很简单了,把 `[login frequency]` 移到横轴,count distinct 用户 ID 作为纵轴即可。
|
||||
|
||||
## 14. 比例笔刷
|
||||
|
||||
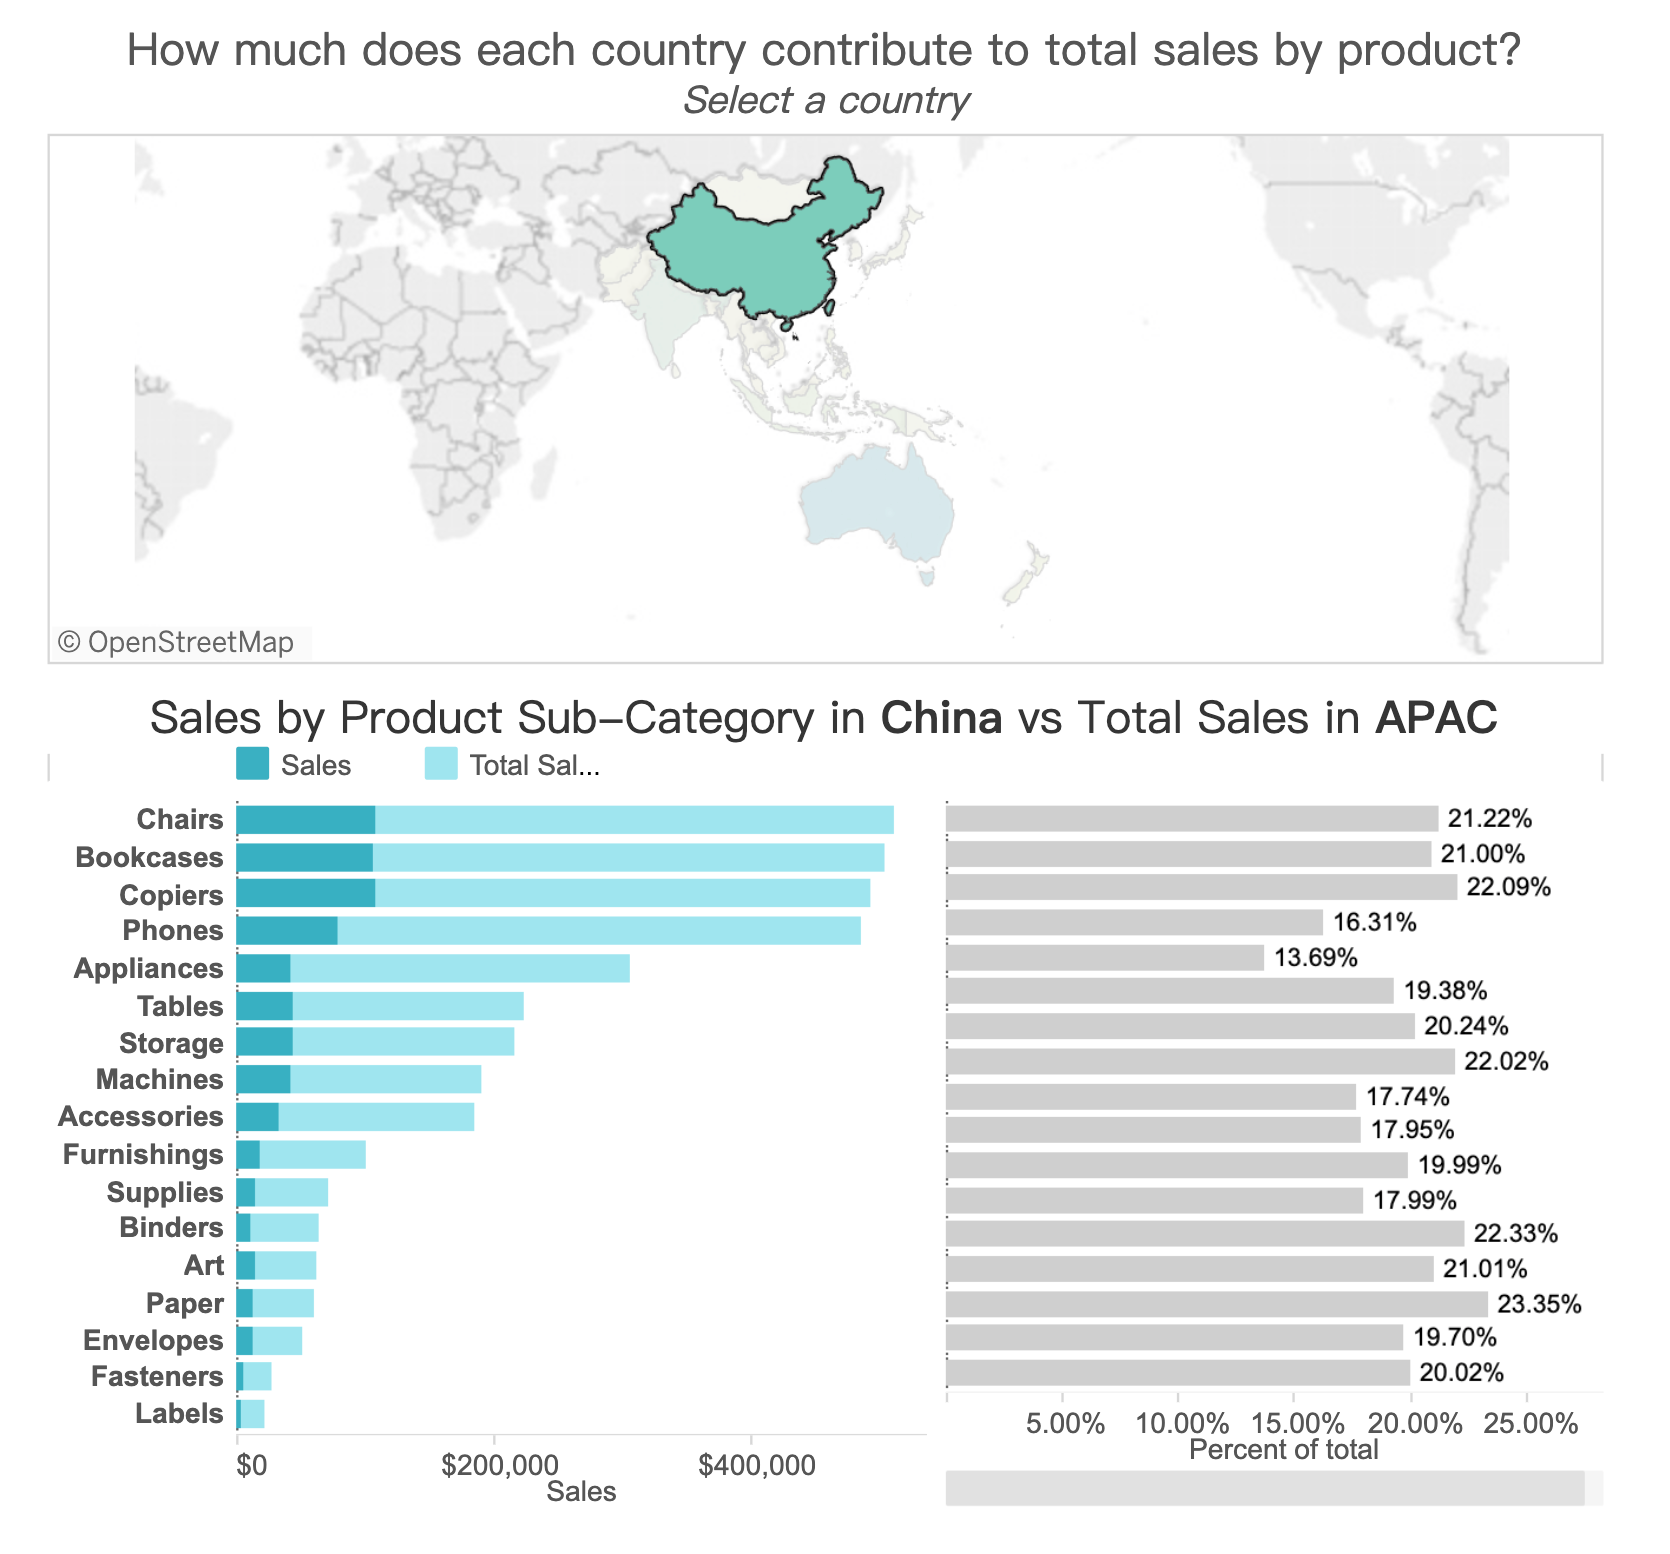
这个是 LOD 最常见的场景,比如求各品类销量占此品类总销量的贡献占比?
|
||||
|
||||
|
||||
|
||||
`sum(sales) / sum({ fixed [category] : sum(sales) })` 即可。
|
||||
|
||||
当前详细级别是 category + country,我们固定品类,就可以得到各品类在所有国家的累积销量。
|
||||
|
||||
## 15. 按客户群划分的年度购买频率
|
||||
|
||||
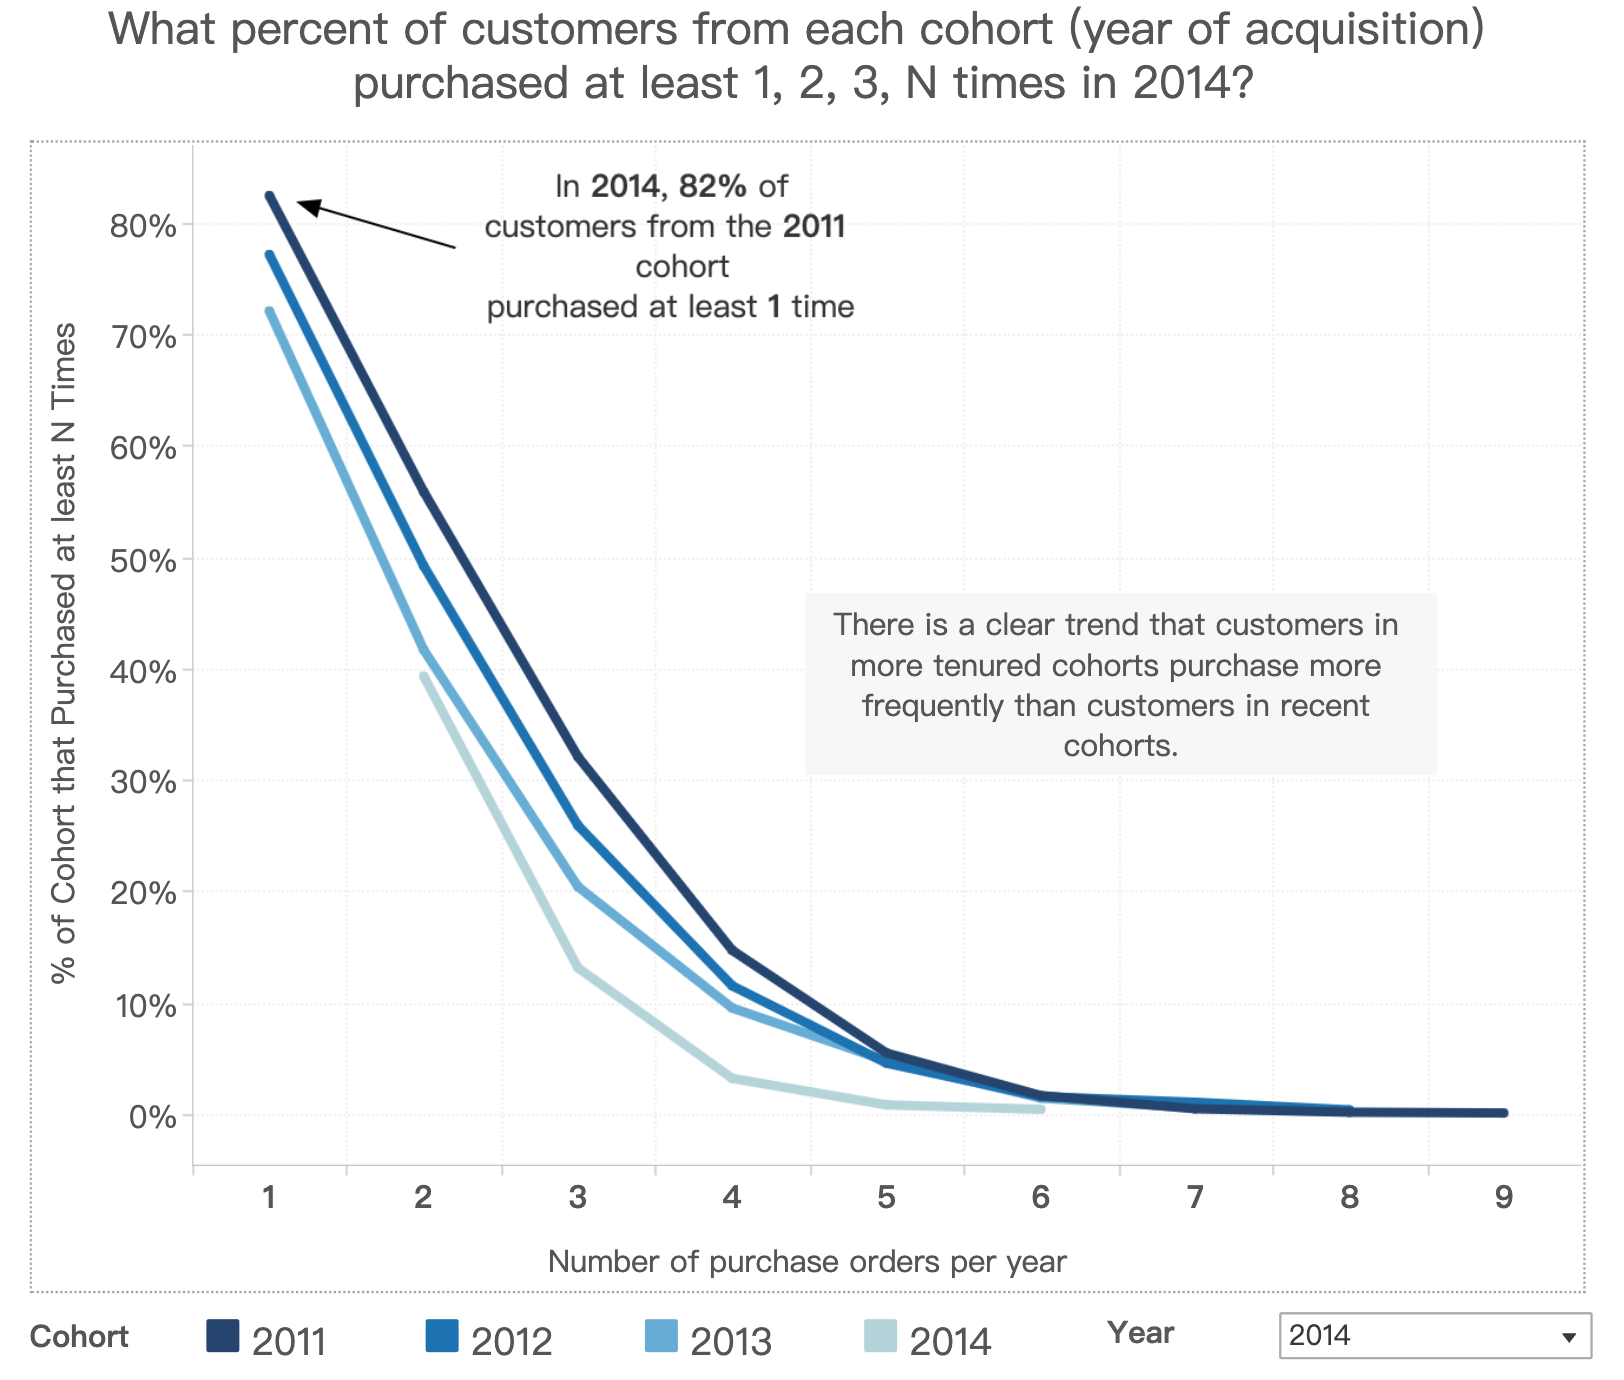
如何证明老客户忠诚度更高?
|
||||
|
||||
我们可以如下图,按照客户群(2011 年、2012 年客户)作为图例,观察他们每年购买频次分布。
|
||||
|
||||
|
||||
|
||||
如上图所示,我们发现顾客注册时间越早,各购买频次的比例都更高,所以证明了老顾客忠诚度更高这一结论。注意这里看的是至少购买 N 次,所以每条线相比才具有说服力。如果是购买 N 次,则可能老顾客购买 1 次较少,购买 10 次较多,难以直接对比。
|
||||
|
||||
首先我们生成图例字段,即按最早照购买年份划分顾客群:`[Cohort] = { fixed [customer id] : min(Year([order date])) }`
|
||||
|
||||
然后就和我们第一个例子类似,计算每个订单数量下,有多少顾客。唯一的区别是,我们不仅按照顾客 ID group,还要进一步对最早购买日期做拆分,即:`{ fixed [customer id], [Cohort] : count([order id]) }`。
|
||||
|
||||
上面的字段作为 X 轴,Y 轴和第一个例子类似:`count(customer id)`,但我们想查看的是至少购买 N 次,也就是这个购买次数是累计值,即至少购买 9 次 = 购买 9 次 + 购买 10 次 + ... 购买 MAX 次。所以是一种 DESC 的 `windowsum`,整体表达式应该类似 `[Running Total] = WINDOW_SUM(count(customer id)), 0, LAST())`。
|
||||
|
||||
最后,因为实际 Y 轴计算的是占比,所以用刚才计算的至少购买 N 次指标除以各 Cohort 下总购买次数,即 `[Running Total] / sum({ fixed [Cohort] : count([customer id]) })`。
|
||||
|
||||
## 总结
|
||||
|
||||
上面的几个例子,都是基于 fixed、include、exclude 这几个基本 LOD 用法的叠加。但从实际例子来看,我们会发现真正的难点不在与 LOD 表达式的语法,而在于我们如何精确理解需求,拆解成合理的计算步骤,并在需要运行 LOD 的计算步骤正确的使用。
|
||||
|
||||
LOD 表达式看上去很神奇,似乎可以和数据 “神奇” 的贴合在一起,我们要理解到 LOD 背后就是表之间的 join,而不同明细级别就表示不同的 group by 规则这一背后原理,就能比较好的理解为什么 LOD 表达式能这么运作了。
|
||||
|
||||
> 讨论地址是:[精读《15 大 LOD 表达式 - 下》· Issue #370 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/370)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,301 @@
|
||||
[Rust Is The Future of JavaScript Infrastructure](https://leerob.io/blog/rust) 这篇文章讲述了 Rust 正在 JS 基建圈流行的事实:[Webpack](https://github.com/webpack/webpack)、[Babel](https://github.com/babel/babel)、[Terser](https://github.com/terser/terser)、[Prettier](https://github.com/prettier/prettier)、[ESLint](https://github.com/eslint/eslint) 这些前些年才流行起来的工具都已有了 Rust 替代方案,且性能有着 10~100 倍的提升。
|
||||
|
||||
前端基建的迭代浪潮从未停歇,当上面这些工具给 Gulp、js-beautify、tslint 等工具盖上棺材盖时,基于 Rust 的新一代构建工具已经悄悄将棺材盖悬挂在 webpack、babel、prettier、terser、eslint 它们头上,不知道哪天就会盖上。
|
||||
|
||||
原文已经有了不错的 [中文翻译](https://mp.weixin.qq.com/s?__biz=MzkxNDIzNTg4MA==&mid=2247485792&idx=1&sn=682a4dee7ce4d3b47a81baf9ebd7a98a&chksm=c170c1e7f60748f17585d6bfca0cff6edbf71bab95f0a4a1ea0bcf2d43c16d1722666d9fadc1&token=1766743281&lang=zh_CN#rd),值得一提的是,原文一些英文名词对应着特定中文解释,记录如下:
|
||||
|
||||
- low-level programming:~~低级编程~~ 底层编程。
|
||||
- ergonomics:~~人体工程学~~ 人机工程学。
|
||||
- opinionated:~~自以为是,固执的~~ 开箱即用的。
|
||||
- critical adoption:~~批判性采用~~ 技术选型临界点。
|
||||
|
||||
## 精读
|
||||
|
||||
本文不会介绍 Rust 如何使用,而会重点介绍原文提到的 Rust 工具链的一些基本用法,如果你感兴趣,可以立刻替换现有的工具库!
|
||||
|
||||
### swc
|
||||
|
||||
[swc](https://swc.rs/) 是基于 Rust 开发的一系列编译、打包、压缩等工具,并且被广泛应用于更多更上层的 JS 基建,大大推动了 Rust 在 JS 基建的影响力,所以要第一个介绍。
|
||||
|
||||
swc 提供了一系列原子能力,涵盖构建与运行时:
|
||||
|
||||
#### @swc/cli
|
||||
|
||||
`@swc/cli` 可以同时构建 js 与 ts 文件:
|
||||
|
||||
```typescript
|
||||
const a = 1
|
||||
```
|
||||
|
||||
```bash
|
||||
npm i -D @swc/cli
|
||||
npx swc ./main.ts
|
||||
|
||||
# output:
|
||||
# Successfully compiled 1 file with swc.
|
||||
# var a = 1;
|
||||
```
|
||||
|
||||
具体功能与 babel 类似,都可以让浏览器支持先进语法或者 ts,只是 `@swc/cli` 比 babel 快了至少 20 倍。可以通过 `.swcrc` 文件做 [自定义配置](https://swc.rs/docs/configuration/swcrc)。
|
||||
|
||||
#### @swc/core
|
||||
|
||||
你可以利用 `@swc/core` 制作更上层的构建工具,所以它是 `@swc/cli` 的开发者调用版本。基本 API 来自官网开发者文档:
|
||||
|
||||
```typescript
|
||||
const swc = require("@swc/core");
|
||||
|
||||
swc
|
||||
.transform("source code", {
|
||||
// Some options cannot be specified in .swcrc
|
||||
filename: "input.js",
|
||||
sourceMaps: true,
|
||||
// Input files are treated as module by default.
|
||||
isModule: false,
|
||||
|
||||
// All options below can be configured via .swcrc
|
||||
jsc: {
|
||||
parser: {
|
||||
syntax: "ecmascript",
|
||||
},
|
||||
transform: {},
|
||||
},
|
||||
})
|
||||
.then((output) => {
|
||||
output.code; // transformed code
|
||||
output.map; // source map (in string)
|
||||
});
|
||||
```
|
||||
|
||||
其实就是把 cli 调用改成了 node 调用。
|
||||
|
||||
#### @swc/wasm-web
|
||||
|
||||
`@swc/wasm-web` 可以在浏览器运行时调用 wasm 版的 swc,以得到更好的性能。下面是官方的例子:
|
||||
|
||||
```typescript
|
||||
import { useEffect, useState } from "react";
|
||||
import initSwc, { transformSync } from "@swc/wasm-web";
|
||||
|
||||
export default function App() {
|
||||
const [initialized, setInitialized] = useState(false);
|
||||
|
||||
useEffect(() => {
|
||||
async function importAndRunSwcOnMount() {
|
||||
await initSwc();
|
||||
setInitialized(true);
|
||||
}
|
||||
importAndRunSwcOnMount();
|
||||
}, []);
|
||||
|
||||
function compile() {
|
||||
if (!initialized) {
|
||||
return;
|
||||
}
|
||||
const result = transformSync(`console.log('hello')`, {});
|
||||
console.log(result);
|
||||
}
|
||||
|
||||
return (
|
||||
<div className="App">
|
||||
<button onClick={compile}>Compile</button>
|
||||
</div>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
这个例子可以在浏览器运行时做类似 babel 的事情,无论是低代码平台还是在线 coding 平台都可以用它做运行时编译。
|
||||
|
||||
#### @swc/jest
|
||||
|
||||
`@swc/jest` 提供了 Rust 版本的 jest 实现,让 jest 跑得更快。使用方式也很简单,首先安装:
|
||||
|
||||
```bash
|
||||
npm i @swc/jest
|
||||
```
|
||||
|
||||
然后在 `jest.config.js` 配置文件中,将 ts 文件 compile 指向 `@swc/jest` 即可:
|
||||
|
||||
```javascript
|
||||
module.exports = {
|
||||
transform: {
|
||||
"^.+\\.(t|j)sx?$": ["@swc/jest"],
|
||||
},
|
||||
};
|
||||
```
|
||||
|
||||
#### swc-loader
|
||||
|
||||
`swc-loader` 是针对 webpack 的 loader 插件,代替 `babel-loader`:
|
||||
|
||||
```javascript
|
||||
module: {
|
||||
rules: [
|
||||
{
|
||||
test: /\.m?js$/,
|
||||
exclude: /(node_modules)/,
|
||||
use: {
|
||||
// `.swcrc` can be used to configure swc
|
||||
loader: "swc-loader"
|
||||
}
|
||||
}
|
||||
];
|
||||
}
|
||||
```
|
||||
|
||||
#### swcpack
|
||||
|
||||
增强了多文件 bundle 成一个文件的功能,基本可以认为是 swc 版本的 webpack,当然性能也会比 `swc-loader` 方案有进一步提升。
|
||||
|
||||
截至目前,该功能还在测试阶段,只要安装了 `@swc/cli` 就可使用,通过创建 `spack.config.js` 后执行 `npx spack` 即可运行,和 webpack 的使用方式一样。
|
||||
|
||||
### Deno
|
||||
|
||||
[Deno](https://deno.land/) 的 linter、code formatter、文档生成器采用 swc 构建,因此也算属于 Rust 阵营。
|
||||
|
||||
Deno 是一种新的 js/ts 运行时,所以我们总喜欢与 node 进行类比。[quickjs](https://bellard.org/quickjs/) 也一样,这三个都是一种对 js 语言的运行器,作为开发者,需求永远是更好的性能、兼容性与生态,三者几乎缺一不可,所以当下虽然不能完全代替 Nodejs,但作为高性能替代方案是很香的,可以基于他们做一些跨端跨平台的解析器,比如 [kraken](https://github.com/openkraken/kraken) 就是基于 quickjs + flutter 实现的一种高性能 web 渲染引擎,是 web 浏览器的替代方案,作为一种跨端方案。
|
||||
|
||||
### esbuild
|
||||
|
||||
[esbuild](https://esbuild.github.io/) 是较早被广泛使用的新一代 JS 基建,是 JS 打包与压缩工具。虽然采用 Go 编写,但性能与 Rust 不相上下,可以与 Rust 风潮放在一起看。
|
||||
|
||||
esbuild 目前有两个功能:编译和压缩,理论上分别可代替 babel 与 terser。
|
||||
|
||||
编译功能的基本用法:
|
||||
|
||||
```js
|
||||
require('esbuild').transformSync('let x: number = 1', {
|
||||
loader: 'ts',
|
||||
})
|
||||
|
||||
// 'let x = 1;\n'
|
||||
```
|
||||
|
||||
压缩功能的基本用法:
|
||||
|
||||
```js
|
||||
require('esbuild').transformSync('fn = obj => { return obj.x }', {
|
||||
minify: true,
|
||||
})
|
||||
|
||||
// 'fn=n=>n.x;\n'
|
||||
```
|
||||
|
||||
压缩功能比较稳定,适合用在生产环境,而编译功能要考虑兼容 webpack 的地方太多,在成熟稳定后才考虑能在生产环境使用,目前其实已经有不少新项目已经在生产环境使用 esbuild 的编译功能了。
|
||||
|
||||
编译功能与 `@swc` 类似,但因为 Rust 支持编译到 wasm,所以 `@swc` 提供了 web 运行时编译能力,而 esbuild 目前还没有看到这种特性。
|
||||
|
||||
### Rome
|
||||
|
||||
[Rome](https://rome.tools/blog/2020/08/08/introducing-rome) 是 Babel 作者做的基于 Nodejs 的前端基建全家桶,包含但不限于 Babel, ESLint, webpack, Prettier, Jest。目前 [计划使用 Rust 重构](https://rome.tools/blog/2021/09/21/rome-will-be-rewritten-in-rust),虽然还没有实现,但我们姑且可以把 Rome 当作 Rust 的一员。
|
||||
|
||||
`rome` 是个全家桶 API,所以你只需要 `yarn add rome` 就完成了所有环境准备工作。
|
||||
|
||||
- `rome bundle` 打包项目。
|
||||
- `rome compile` 编译单个文件。
|
||||
- `rome develop` 调试项目。
|
||||
- `rome parse` 解析文件抽象语法树。
|
||||
- `rome analyzeDependencies` 分析依赖。
|
||||
|
||||
Rome 还将文件格式化与 Lint 合并为了 `rome check` 命令,并提供了[友好 UI 终端提示](https://rome.tools/#command-usage)。
|
||||
|
||||
其实我并不太看好 Rome,因为它负担太重了,测试、编译、Lint、格式化、压缩、打包的琐碎事情太多,把每一块交给社区可能会做得更好,这不现在还在重构中,牵一发而动全身。
|
||||
|
||||
### NAPI-RS
|
||||
|
||||
[NAPI-RS](https://napi.rs/) 提供了高性能的 Rust 到 Node 的衔接层,可以将 Rust 代码编译后成为 Node 可调用文件。下面是官网的例子:
|
||||
|
||||
```rust
|
||||
#[js_function(1)]
|
||||
fn fibonacci(ctx: CallContext) -> Result<JsNumber> {
|
||||
let n = ctx.get::<JsNumber>(0)?.try_into()?;
|
||||
ctx.env.create_int64(fibonacci_native(n))
|
||||
}
|
||||
```
|
||||
|
||||
上面写了一个斐波那契数列函数,直接调用了 `fibonacci_native` 函数实现。为了让这个方法被 Node 调用,首先安装 CLI:`npm i @napi-rs/cli`。
|
||||
|
||||
由于环境比较麻烦,因此需要利用这个脚手架初始化一个工作台,我们在里面写 Rust,然后再利用固定的脚本发布 npm 包。执行 `napi new` 创建一个项目,我们发现入口文件肯定是个 js,毕竟要被 node 引用,大概长这样(我创建了一个 `myLib` 包):
|
||||
|
||||
```js
|
||||
const { loadBinding } = require('@node-rs/helper')
|
||||
|
||||
/**
|
||||
* __dirname means load native addon from current dir
|
||||
* 'myLib' is the name of native addon
|
||||
* the second arguments was decided by `napi.name` field in `package.json`
|
||||
* the third arguments was decided by `name` field in `package.json`
|
||||
* `loadBinding` helper will load `myLib.[PLATFORM].node` from `__dirname` first
|
||||
* If failed to load addon, it will fallback to load from `myLib-[PLATFORM]`
|
||||
*/
|
||||
module.exports = loadBinding(__dirname, 'myLib', 'myLib')
|
||||
```
|
||||
|
||||
所以 loadBinding 才是入口,同时项目文件夹下存在三个系统环境包,分别供不同系统环境调用:
|
||||
|
||||
- `@cool/core-darwin-x64` macOS x64 平台。
|
||||
- `@cool/core-win32-x64` Windows x64 平台。
|
||||
- `@cool/core-linux-arm64-gnu` Linux aarch64 平台。
|
||||
|
||||
`@node-rs/helper` 这个包的作用是引导 node 执行预编译的二进制文件,`loadBinding` 函数会尝试加载当前平台识别的二进制包。
|
||||
|
||||
将 `src/lib.rs` 的代码改成上面斐波那契数列的代码后,执行 `npm run build` 编译。注意在编译前需要安装 rust 开发环境,只要一行脚本即可安装,具体看 [rustup.rs](https://rustup.rs/)。然后把当前项目整体当作 node 包发布即可。
|
||||
|
||||
发布后,就可以在 node 代码中引用啦:
|
||||
|
||||
```javascript
|
||||
import { fibonacci } from 'myLib'
|
||||
|
||||
function hello() {
|
||||
let result = fibonacci(10000)
|
||||
console.log(result)
|
||||
return result
|
||||
}
|
||||
```
|
||||
|
||||
NAPI-RS 作为 Rust 与 Node 的桥梁,很好的解决了 Rust 渐进式替换现有 JS 工具链的问题。
|
||||
|
||||
### Rust + WebAssembly
|
||||
|
||||
[Rust + WebAssembly](https://www.rust-lang.org/what/wasm) 说明 Rust 具备编译到 wasm 的能力,虽然编译后代码性能会变得稍慢,但还是比 js 快很多,同时由于 wasm 的可移植性,让 Rust 也变得可移植了。
|
||||
|
||||
其实 Rust 支持编译到 WebAssembly 也不奇怪,因为本来 WebAssembly 的定位之一就是作为其他语言的目标编译产物,然后它本身支持跨平台,这样它就很好的完成了传播的使命。
|
||||
|
||||
WebAssembly 是一个基于栈的虚拟机 ([stack machine](https://webassembly.github.io/spec/core/exec/index.html)),所以跨平台能力一流。
|
||||
|
||||
想要将 Rust 编译为 wasm,除了安装 Rust 开发环境外,还要安装 [wasm-pack](https://rustwasm.github.io/wasm-pack/installer/)。
|
||||
|
||||
安装后编译只需执行 `wasm-pack build` 即可。更多用法可以查看 [API 文档](https://rustwasm.github.io/wasm-pack/book/commands/build.html)。
|
||||
|
||||
### dprint
|
||||
|
||||
[dprint](https://github.com/dprint/dprint) 是用 rust 编写的 js/ts 格式化工具,并提供了 [dprint-node](https://github.com/devongovett/dprint-node) 版本,可以直接作为 node 包,通过 npm 安装使用,从 [源码](https://github.com/devongovett/dprint-node/blob/main/src/lib.rs) 可以看到,使用 [NAPI-RS](https://napi.rs/) 实现。
|
||||
|
||||
`dprint-node` 可以直接在 Node 中使用:
|
||||
|
||||
```js
|
||||
const dprint = require('dprint-node');
|
||||
dprint.format(filePath, code, options);
|
||||
```
|
||||
|
||||
[参数文档](https://dprint.dev/plugins/typescript/config/)。
|
||||
|
||||
### Parcel
|
||||
|
||||
[Parcel](https://parceljs.org/) 严格来说算是上一代 JS 基建,它出现在 Webpack 之后,Rust 风潮之前。不过由于它已经[采用 SWC 重写](https://github.com/parcel-bundler/parcel/pull/6230),所以姑且算是跟上了时髦。
|
||||
|
||||
## 总结
|
||||
|
||||
前端全家桶已经有了一整套 Rust 实现,只是对于存量项目的编译准确性需要大量验证,我们还需要时间等待这些库的成熟度。
|
||||
|
||||
但毫无疑问的是,Rust 语言对 JS 基建支持已经较为完备了,剩下的只是工具层逻辑覆盖率的问题,都可以随时间而解决。而用 Rust 语言重写后的逻辑带来的巨幅性能提升将为社区注入巨大活力,就像原文说的,前端社区可以为了巨大性能提升而引入 Rust 语言,即便这可能导致为社区贡献门槛的提高。
|
||||
|
||||
> 讨论地址是:[精读《Rust 是 JS 基建的未来》· Issue #371 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/371)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,108 @@
|
||||
[Inside look at modern web browser](https://developers.google.com/web/updates/2018/09/inside-browser-part1) 是介绍浏览器实现原理的系列文章,共 4 篇,本次精读介绍第一篇。
|
||||
|
||||
虽然本文写于 2018 年,但如今依然值得学习,因为浏览器实现非常复杂,从细节开始学习很容易迷失方向,缺乏整体感,而这篇文章从宏观层面开始介绍,几乎没有涉及代码实现,全都是思路性的描述,非常适合培养对浏览器整体框架性思维。
|
||||
|
||||
原文有非常多形象的插图与动图,便于加深对知识的理解,所以也推荐直接阅读原文。
|
||||
|
||||
## 概述
|
||||
|
||||
文章先从 CPU、GPU、操作系统开始介绍,因为这些是浏览器运行的基座。
|
||||
|
||||
### CPU、GPU、操作系统、应用的关系
|
||||
|
||||
CPU 即中央处理器,可以处理几乎所有计算。以前的 CPU 是单核的,现在大部分笔记电脑都是多核的,专业服务器甚至有高达 100 多核的。CPU 计算能力很强,但只能一件件事处理,
|
||||
|
||||
GPU 一开始是为图像处理设计的,即主要处理像素点,所以拥有大量并行的处理简单事物的能力,非常适合用来做矩阵运算,而矩阵运算又是计算机图形学的基础,所以大量用在可视化领域。
|
||||
|
||||
CPU、GPU 都是计算机硬件,这些硬件各自都提供了一些接口供汇编语言调用;而操作系统则基于它们之上用 C 语言(如 linux)将硬件管理了起来,包括进程调度、内存分配、用户内核态切换等等;运行在操作系统之上的则是应用程序了,所以应用程序不直接和硬件打交道,而是通过操作系统间接操作硬件。
|
||||
|
||||
> 为什么应用程序不能直接操作硬件呢?这样做有巨大的安全隐患,因为硬件是没有任何抽象与安全措施的,这意味着理论上一个网页可以通过 js 程序,在你打开网页时直接访问你的任意内存地址,读取你的聊天记录,甚至读取历史输入的银行卡密码进行转账操作。
|
||||
|
||||
显然,浏览器作为一个应用程序,运行在操作系统之上。
|
||||
|
||||
### 进程与线程
|
||||
|
||||
为了让程序运行的更安全,操作系统创造了进程与线程的概念(linux 对进程与线程的实现是同一套),进程可以分配独立的内存空间,进程内可以创建多个线程进行工作,这些线程共享内存空间。
|
||||
|
||||
因为线程间共享内存空间,因此不需通信就能交流,但内存地址相互隔离的进程间也有通信需求,需通过 IPC(Inter Process Communication)进行通信。
|
||||
|
||||
进程之间相互独立,即一个进程挂了不会影响到其它进程,而在一个进程中可以创建一个新进程,并与之通信,所以浏览器就采用了这种策略,将 UI、网络、渲染、插件、存储等模块进程独立,并且任意挂掉后都可以被重新唤起。
|
||||
|
||||
### 浏览器架构
|
||||
|
||||
浏览器可以拆分为许多独立的模块,比如:
|
||||
|
||||
- 浏览器模块(Browser):负责整个浏览器内行为协调,调用各个模块。
|
||||
- 网络模块(Network):负责网络 I/O。
|
||||
- 存储模块(Storage):负责本地 I/O。
|
||||
- 用户界面模块(UI):负责浏览器提供给用户的界面模块。
|
||||
- GPU 模块:负责绘图。
|
||||
- 渲染模块(Renderer):负责渲染网页。
|
||||
- 设备模块(Device):负责与各种本地设备交互。
|
||||
- 插件模块(Plugin):负责处理各类浏览器插件。
|
||||
|
||||
基于这些模块,浏览器有两种可用的架构设计,一种是少进程,一种是多进程。
|
||||
|
||||
少进程是指将这些模块放在一个或有限的几个进程里,也就是每个模块一个线程,这样做的好处是最大程度共享了内存空间,对设备要求较低,但问题是只要一个线程挂了都会导致整个浏览器挂掉,因此稳定性较差。
|
||||
|
||||
多进程是指为每个模块(尽量)开辟一个进程,模块间通过 IPC 通信,因此任何模块挂掉都不会影响其它模块,但坏处是内存占用较大,比如浏览器 js 解析与执行引擎 V8 就要在这套架构下拷贝多份实例运行在每个进程中。
|
||||
|
||||
### Chrome 多进程架构的优势
|
||||
|
||||
Chrome 尽量为每个 tab 单独创建一个进程,所以我们才能在某个 tab 未响应时,从容的关闭它,而其它 tab 不会受到影响。不仅是 tab 间,一个 tab 内的 iframe 间也会创建独立的进程,这样做是为了保护网站的安全性。
|
||||
|
||||
### 服务化 - 单/多进程弹性架构
|
||||
|
||||
Chrome 并不满足于采用一种架构,而是在不同环境下切换不同的架构。Chrome 将各功能模块化后,就可以自由决定当前将哪些模块放在一个进程中,将哪些模块启动独立进程,即可以在运行时决定采用哪套进程架构。
|
||||
|
||||
这样做的好处是,可以在资源受限的机器上开启单进程模式,以尽量节约内存开销,实际上在手机应用上就是这么做的;而在资源丰富、内核数量充足的机器上采用独立进程模式,虽然消耗了更多资源,但获得了更好的稳定性。
|
||||
|
||||
### Iframe 独占进程
|
||||
|
||||
[site-isolation](https://developers.google.com/web/updates/2018/07/site-isolation) 将同一个 tab 内不同 iframe 包裹在不同的进程内运行,以确保 iframe 间资源的独占性,以及安全性。该功能直到 2018.7 才更新,是因为背后有许多复杂的工作要处理,比如开发者工具的调试、网页的全局搜索功能,都不能因为进程的隔离而受到影响,Chrome 必须让每个进程单独响应这些操作,并最终聚合在一起,让用户感受不到进程间的阻隔。
|
||||
|
||||
## 精读
|
||||
|
||||
本文从浏览器如何基于操作系统提供的进程、线程概念构建自己的应用程序开始,从硬件、操作系统、软件的分层开始,介绍到浏览器是如何划分模块的,并且分配进程或线程给这些模块运行,这背后的思考非常有价值。
|
||||
|
||||
从宏观角度看,要设计一个安全稳定、高性能、具有拓展性的浏览器,首先要把各功能模块划分清楚,并定义好各模块的通信关系,在各业务场景下制定一套模块协作的流程。
|
||||
|
||||
### 浏览器的主从架构
|
||||
|
||||
类似应用程序的主从模式,浏览器的 Browser 模块可以看作主模块,它本身用于协调其它模块的运行,并维持其它各模块的正常工作,在其它模块失去响应时等待或重新唤起,或者在模块销毁时进行内存回收。
|
||||
|
||||
各从模块也分工明确,比如在浏览器敲击 URL 地址时,会先通过 UI 模块响应用户的输入,并判断输入是否为 URL 地址,因为输入的可能是其它非法参数,或一些查询或设置命令。若输入的确实是 URL 地址,则校验通过后,会通知 Network 网络模块发送请求,UI 模块就不再关心请求是如何处理了。Network 模块也是相对独立的,仅处理请求的发送与接收,如果接收到的是 HTML 网页,则交给 Renderer 模块进行渲染。
|
||||
|
||||
有了这些相对独立且分工明确的模块划分后,将这些模块作为线程或进程管理就都不会影响它们的业务逻辑了,唯一影响的就是内存是否共享,以及某个模块 crash 后是否会影响到其它模块了,所以基于这个架构,判断设备类型,以采用单进程或多进程模式就变得简单了很多,且这个进程弹性架构本身也不需要入侵各模块业务逻辑,本身就是一套独立的机制。
|
||||
|
||||
浏览器作为非常复杂的应用程序,想要持续维护,就必须对每个功能点都进行合理的设计,让模块间高内聚、低耦合,这样才不至于让任何修改牵一发而动全身。
|
||||
|
||||
### tab、iframe 进程隔离
|
||||
|
||||
微前端的沙箱隔离方案也比较火,这里可以和浏览器 tab/iframe 隔离做个对比。
|
||||
|
||||
基于 js 运行时的沙箱方案大多都因为吐槽 iframe 慢而诞生的,一般会基于 `with` 改变沙箱代码的上下文,修改访问的全局对象引用,但基于 js 原型链特征,为了阻断向原型链追溯到主应用代码,一般会采用 `proxy` 对 `with` mock 的变量进行访问阻断。
|
||||
|
||||
还有一些方案利用创建空 iframe 获取到 document 变量传递给沙箱,一定程度做到了访问隔离,且对 document 添加的监听会随 iframe 销毁而销毁,便于控制。
|
||||
|
||||
还有一些更加彻底的尝试,将 js 代码扔到 web worker 运行,并通过 mock 模拟了 worker 运行时缺失的 dom API。
|
||||
|
||||
对比这些方案可以发现,只有最后 worker 的方案是最彻底的,因为浏览器创建的 worker 进程是完全资源隔离的,想要和浏览器主线程通信只能利用 `postMessage`,虽然有一些基于 ArrayBuffer 的内存共享方案,但因为支持的数据类型具有针对性,也不会存在安全问题。
|
||||
|
||||
回到浏览器开发者的视角,为什么 iframe 隔离要花费九牛二虎之力拆分多进程,最后再费很大功夫拼接回来,还原出一个相对无缝的体验?浏览器厂商其实完全可以利用上面提到的 js 运行时能力,对 API 语法进行改造,创建一个逻辑上的沙盒环境。
|
||||
|
||||
我认为本质原因是浏览器要实现的沙盒必须是进程层面的,也就是对内存访问权限的绝对隔离,因为逻辑层面的隔离可能随着各浏览器厂商实现差异,或 API 本身存在的逻辑漏洞而导致越权情况的出现,所以如果需要构造一个完全安全的沙盒,最好利用浏览器提供的 API 创建新的进程处理沙盒代码。
|
||||
|
||||
## 总结
|
||||
|
||||
本文介绍了浏览器是如何基于操作系统做宏观架构设计的,主要就说了一件事,即对进程,线程模型的弹性使用。同时在 tab、iframe 的设计中也要考虑到安全性要求,在必要的时候采用进程,在浏览器自身模块间因为没有安全性问题,所以可对进程模型进行灵活切换。
|
||||
|
||||
> 讨论地址是:[精读《深入了解现代浏览器一》· Issue #374 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/374)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,77 @@
|
||||
[Inside look at modern web browser](https://developers.google.com/web/updates/2018/09/inside-browser-part2) 是介绍浏览器实现原理的系列文章,共 4 篇,本次精读介绍第二篇。
|
||||
|
||||
## 概述
|
||||
|
||||
本篇重点介绍了 **浏览器路由跳转后发生了什么**,下一篇会介绍浏览器的渲染进程是如何渲染网页的,环环相扣。
|
||||
|
||||
在上一篇介绍了,browser process 包含 UI thread、network thread 和 storage thread,当我们在浏览器菜单栏输入网址并敲击回车时,这套动作均由 browser process 的 UI thread 响应。
|
||||
|
||||
接下来,按照几种不同的路由跳转场景,分别介绍了内部流程。
|
||||
|
||||
### 普通的跳转
|
||||
|
||||
第一步,UI thread 响应输入,并判断是否为一个合法的网址,当然输入的也可能是个搜索协议,这就会导致分发到另外的服务处理。
|
||||
|
||||
第二步,如果第一步输入的是合法网址,则 UI thread 会通知 network thread 获取网页内容,network thread 会寻找合适的协议处理网络请求,一般会通过 [DNS 协议](https://en.wikipedia.org/wiki/Domain_Name_System) 寻址,通过 [TLS 协议](https://en.wikipedia.org/wiki/Transport_Layer_Security) 建立安全链接。如果服务器返回了比如 301 重定向信息,network thread 会通知 UI thread 这个信息,再启动一遍第二步。
|
||||
|
||||
第三步,读取响应内容,在这一步 network thread 会首先读取首部一些字节,即我们常说的响应头,其中包含 [Content-Type](https://developer.mozilla.org/en-US/docs/Web/HTTP/Basics_of_HTTP/MIME_types) 告知返回内容是什么。如果返回内容是 HTML,则 network thread 会将数据传送给 renderer process。这一步还会校验安全性,比如 [CORB](https://www.chromium.org/Home/chromium-security/corb-for-developers) 或 [cross-site](https://en.wikipedia.org/wiki/Cross-site_scripting) 问题。
|
||||
|
||||
第四步,寻找 renderer process。一旦所有检查都完成,network thread 会通知 UI thread 已经准备好跳转了(注意此时并没有加载完所有数据,第三步只是检查了首字节),UI thread 会通知实力化 renderer process 进行渲染。为了提升性能,UI thread 在通知 network thread 的同时就会实力化一个 renderer process 等着,一旦 network thread 完毕后就可以立即进入渲染阶段,如果检查失败则丢弃提前实例化的 renderer process。
|
||||
|
||||
第五步,确认导航。第四步后,browser process 通过 IPC 向 renderer process 传送 stream([精读《web streams》](https://github.com/ascoders/weekly/blob/master/%E5%89%8D%E6%B2%BF%E6%8A%80%E6%9C%AF/214.%E7%B2%BE%E8%AF%BB%E3%80%8Aweb%20streams%E3%80%8B.md))数据。此时导航会被确认,浏览器的各个状态(比如导航状态、前进后退历史)将会被修改,同时为了方便 tab 关闭后快速恢复,会话记录会被存储在硬盘。
|
||||
|
||||
额外步骤,加载完成。当 renderer process 加载完成后(具体做了什么下一篇会说明),会通知 browser process `onLoad` 事件,此时浏览器完成最终加载完毕状态,loading 圆圈也会消失,各类 onLoad 的回调触发。注意此时 js 可能会继续加载远程资源,但这都是加载状态完成后的事了。
|
||||
|
||||
### 跳转到别的网站
|
||||
|
||||
当你准备跳转到别的网站时,在执行普通跳转流程前,还会响应 [beforeunload](https://developer.mozilla.org/en-US/docs/Web/API/Window/beforeunload_event) 事件,这个事件注册在 renderer process,所以 browser process 需要检查 renderer process 是否注册了这个响应。注册 `beforeunload` 无论如何都会拖慢关闭 tab 的速度,所以如无必要请勿注册。
|
||||
|
||||
如果跳转是 js 发出的,那么执行跳转就由 renderer process 触发,browser process 来执行,后续流程就是普通的跳转流程。要注意的是,当执行跳转时,会触发原网站 `unload` 等事件([网页生命周期](https://developers.google.com/web/updates/2018/07/page-lifecycle-api#overview_of_page_lifecycle_states_and_events)),所以这个由旧的 renderer process 响应,而新网站会创建一个新的 renderer process 处理,当旧网页全部关闭时,才会销毁旧的 renderer process。
|
||||
|
||||
也就是说,即便只有一个 tab,在跳转时,也可能会在短时间内存在多个 renderer process。
|
||||
|
||||
### Service Worker
|
||||
|
||||
[Service Worker](https://developers.google.com/web/fundamentals/primers/service-workers) 可以在页面加载前执行一些逻辑,甚至改变网页内容,但浏览器仍然把 Service Worker 实现在了 renderer process 中。
|
||||
|
||||
当 Service Worker 被注册后,会被丢到一个作用域中,当 UI thread 执行时会检查这个作用域是否注册了 Service Worker,如果有,则 network thread 会创建一个 renderer process 执行 Service Worker(因为是 js 代码)。然后网络响应会被 Service Worker 接管。
|
||||
|
||||
但这样会慢一步,所以 UI thread 往往会在注册 Service Worker 的同时告诉 network thread 发送请求,这就是 [Navigation Preload](https://developers.google.com/web/updates/2017/02/navigation-preload) 机制。
|
||||
|
||||
本文介绍了网页跳转时发生的步骤,涉及 browser process、UI thread、network thread、renderer process 的协同。
|
||||
|
||||
## 精读
|
||||
|
||||
也许你会有疑问,为什么是 renderer process 而不是 renderer thread?因为相比 process(进程)相比 thread(线程),之间数据是被操作系统隔离的,为了网页间无法相互读取数据(mysite.com 读取你 baidu.com 正在输入的账号密码),浏览器必须为每个 tab 创建一个独立的进程,甚至每个 iframe 都必须是独立进程。
|
||||
|
||||
读完第二篇,应该能更深切的感受到模块间合理分工的重要性。
|
||||
|
||||
UI thread 处理浏览器 UI 的展现与用户交互,比如当前加载的状态变化,历史前进后退,浏览器地址栏的输入、校验与监听按下 Enter 等事件,但不会涉及诸如发送请求、解析网页内容、渲染等内容。
|
||||
|
||||
network thread 也仅处理网络相关的事情,它主要关心通信协议、安全协议,目标就是快速准确的找到网站服务器,并读取其内容。network thread 会读取内容头做一些前置判断,读取内容和 renderer process 做的事情是有一定重合的,但 network thread 读取内容头仅为了判断内容类型,以便交给渲染引擎还是下载管理器(比如一个 zip 文件),所以为了不让渲染引擎知道下载管理器的存在,读取内容头必须由 network thread 来做。
|
||||
|
||||
与 renderer process 的通信也是由 browser process 来做的,也就是 UI thread、network thread 一旦要创建或与 renderer process 通信,都会交由它们所在的 browser process 处理。
|
||||
|
||||
renderer process 仅处理渲染逻辑,它不关心是从哪来的,比如是网络请求过来的,还是 Service Worker 拦截后修改的,也不关心当前浏览器状态是什么,它只管按照约定的接口规范,在指定的节点抛出回调,而修改应用状态由其它关心的模块负责,比如 `onLoad` 回调触发后,browser process 处理浏览器的状态就是一个例子。
|
||||
|
||||
再比如 renderer process 里点击了一个新的跳转链接,这个事情发生在 renderer process,但会交给 browser process 处理,因为每个模块解耦的非常彻底,所以任何复杂工作都能找到一个能响应它的模块,而这个模块也只要处理这个复杂工作的一部分,其余部分交给其它模块就好了,这就是大型应用维护的秘诀。
|
||||
|
||||
所以在浏览器运行周期里,有着非常清晰的逻辑链路,这些模块必须事先规划设计好,很难想象这些模块分工是在开发中逐渐形成的。
|
||||
|
||||
最后提到加速优化,Chrome 惯用技巧就是,用资源换时间。即宁可浪费潜在资源,也要让事物尽可能的并发,这些从提前创建 renderer process、提前发起 network process 都能看出来。
|
||||
|
||||
## 总结
|
||||
|
||||
深入了解现代浏览器二介绍了网页跳转时发生的,browser process 与 renderer process 是如何协同的。
|
||||
|
||||
也许这篇文章可以帮助你回答 “聊聊在浏览器地址栏输入 www.baidu.com 并回车后发生了什么事儿吧!”
|
||||
|
||||
> 讨论地址是:[精读《深入了解现代浏览器二》· Issue #375 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/375)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -42,13 +42,25 @@ State(状态模式)属于行为型模式。
|
||||
下面例子使用 typescript 编写。
|
||||
|
||||
```typescript
|
||||
abstract class Context {
|
||||
abstract setState(state: State): void;
|
||||
}
|
||||
|
||||
// 定义状态接口
|
||||
interface State {
|
||||
// 模拟台灯点亮
|
||||
show: () => string
|
||||
}
|
||||
|
||||
class Light1 implements State {
|
||||
interface Light {
|
||||
click: () => void
|
||||
}
|
||||
|
||||
type LightState = State & Light
|
||||
|
||||
class TurnOff implements State, Light {
|
||||
context: Context;
|
||||
|
||||
constructor(context: Context) {
|
||||
this.context = context
|
||||
}
|
||||
@@ -59,11 +71,13 @@ class Light1 implements State {
|
||||
|
||||
// 按下按钮
|
||||
public click() {
|
||||
this.context.setState(new Light2(this.context))
|
||||
this.context.setState(new WeakLight(this.context))
|
||||
}
|
||||
}
|
||||
|
||||
class Light2 implements State {
|
||||
class WeakLight implements State, Light {
|
||||
context: Context;
|
||||
|
||||
constructor(context: Context) {
|
||||
this.context = context
|
||||
}
|
||||
@@ -74,11 +88,13 @@ class Light2 implements State {
|
||||
|
||||
// 按下按钮
|
||||
public click() {
|
||||
this.context.setState(new Light3(this.context))
|
||||
this.context.setState(new StandardLight(this.context))
|
||||
}
|
||||
}
|
||||
|
||||
class Light3 implements State {
|
||||
class StandardLight implements State, Light {
|
||||
context: Context;
|
||||
|
||||
constructor(context: Context) {
|
||||
this.context = context
|
||||
}
|
||||
@@ -89,11 +105,13 @@ class Light3 implements State {
|
||||
|
||||
// 按下按钮
|
||||
public click() {
|
||||
this.context.setState(new Light4(this.context))
|
||||
this.context.setState(new StrongLight(this.context))
|
||||
}
|
||||
}
|
||||
|
||||
class Light4 implements State {
|
||||
class StrongLight implements State, Light {
|
||||
context: Context;
|
||||
|
||||
constructor(context: Context) {
|
||||
this.context = context
|
||||
}
|
||||
@@ -104,30 +122,37 @@ class Light4 implements State {
|
||||
|
||||
// 按下按钮
|
||||
public click() {
|
||||
this.context.setState(new Light1(this.context))
|
||||
this.context.setState(new TurnOff(this.context))
|
||||
}
|
||||
}
|
||||
|
||||
// 台灯
|
||||
public class Lamp {
|
||||
class Lamp extends Context {
|
||||
// 当前状态
|
||||
private currentState = new Light1(this)
|
||||
|
||||
protected setState(state: State) {
|
||||
this.currentState = state
|
||||
#currentState: LightState = new TurnOff(this)
|
||||
setState(state: LightState) {
|
||||
this.#currentState = state
|
||||
}
|
||||
getState() {
|
||||
return this.#currentState
|
||||
}
|
||||
|
||||
// 按下按钮
|
||||
public click() {
|
||||
click() {
|
||||
this.getState().click()
|
||||
}
|
||||
}
|
||||
|
||||
const lamp = new Lamp() // 关闭
|
||||
console.log(lamp.getState().show()) // 关灯
|
||||
lamp.click() // 弱光
|
||||
console.log(lamp.getState().show()) // 弱光
|
||||
lamp.click() // 亮
|
||||
console.log(lamp.getState().show()) // 亮
|
||||
lamp.click() // 强光
|
||||
console.log(lamp.getState().show()) // 强光
|
||||
lamp.click() // 关闭
|
||||
console.log(lamp.getState().show()) // 关闭
|
||||
```
|
||||
|
||||
其实有很多种方式来实现,不必拘泥于形式,大体上只要保证由多个类实现不同状态,每个类实现到下一个状态切换就好了。
|
||||
|
||||
Reference in New Issue
Block a user