Compare commits
| Author | SHA1 | Date | |
|---|---|---|---|
 ascoders |
89c50fc032 | ||
|
ascoders
|
c81446eff5 | ||
|
黄子毅
|
d5f96ff5a3 | ||
|
黄子毅
|
db3449ace1 | ||
|
Kai Qi
|
1dddebbb1f | ||
|
蔡小伦
|
77e2da3f2d | ||
|
ascoders
|
019076e87f | ||
|
ascoders
|
18e058af5b | ||
|
ascoders
|
fe7b930b95 | ||
|
黄子毅
|
1a9be6aaf8 | ||
|
向晚
|
3110990b90 | ||
|
黄子毅
|
e5e2d49ae1 | ||
|
ascoders
|
94381de60b | ||
|
fltenwall
|
70f20e6861 | ||
|
ascoders
|
fab11f31d2 | ||
|
ascoders
|
8af572d9f9 | ||
|
ascoders
|
0c542af0ab | ||
|
ascoders
|
4b3aae675d | ||
|
ascoders
|
532d3bd6f0 | ||
|
黄子毅
|
cb20d65c2c | ||
|
谭九鼎
|
07b6017451 | ||
|
黄子毅
|
2c5f8ca4f3 | ||
|
ascoders
|
cd543b1fd4 | ||
|
feikerwu
|
88560b6626 |
@@ -6,7 +6,7 @@
|
||||
|
||||
前端界的好文精读,每周更新!
|
||||
|
||||
最新精读:<a href="./前沿技术/207.%E7%B2%BE%E8%AF%BB%E3%80%8ATypescript%20infer%20%E5%85%B3%E9%94%AE%E5%AD%97%E3%80%8B.md">207.精读《Typescript infer 关键字》</a>
|
||||
最新精读:<a href="./前沿技术/213.%E7%B2%BE%E8%AF%BB%E3%80%8APrisma%20%E7%9A%84%E4%BD%BF%E7%94%A8%E3%80%8B.md">213.精读《Prisma 的使用》</a>
|
||||
|
||||
素材来源:[周刊参考池](https://github.com/ascoders/weekly/issues/2)
|
||||
|
||||
@@ -165,6 +165,12 @@
|
||||
- <a href="./前沿技术/205.%E7%B2%BE%E8%AF%BB%E3%80%8AJS%20with%20%E8%AF%AD%E6%B3%95%E3%80%8B.md">205.精读《JS with 语法》</a>
|
||||
- <a href="./前沿技术/206.%E7%B2%BE%E8%AF%BB%E3%80%8A%E4%B8%80%E7%A7%8D%20Hooks%20%E6%95%B0%E6%8D%AE%E6%B5%81%E7%AE%A1%E7%90%86%E6%96%B9%E6%A1%88%E3%80%8B.md">206.精读《一种 Hooks 数据流管理方案》</a>
|
||||
- <a href="./前沿技术/207.%E7%B2%BE%E8%AF%BB%E3%80%8ATypescript%20infer%20%E5%85%B3%E9%94%AE%E5%AD%97%E3%80%8B.md">207.精读《Typescript infer 关键字》</a>
|
||||
- <a href="./前沿技术/208.%E7%B2%BE%E8%AF%BB%E3%80%8ATypescript%204.4%E3%80%8B.md">208.精读《Typescript 4.4》</a>
|
||||
- <a href="./前沿技术/209.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%8D%95%E8%8E%B7%E6%89%80%E6%9C%89%E5%BC%82%E6%AD%A5%20error%E3%80%8B.md">209.精读《捕获所有异步 error》</a>
|
||||
- <a href="./前沿技术/210.%E7%B2%BE%E8%AF%BB%E3%80%8Aclass%20static%20block%E3%80%8B.md">210.精读《class static block》</a>
|
||||
- <a href="./前沿技术/211.%E7%B2%BE%E8%AF%BB%E3%80%8AMicrosoft%20Power%20Fx%E3%80%8B.md">211.精读《Microsoft Power Fx》</a>
|
||||
- <a href="./前沿技术/212.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%8F%AF%E7%BB%B4%E6%8A%A4%E6%80%A7%E6%80%9D%E8%80%83%E3%80%8B.md">212.精读《可维护性思考》</a>
|
||||
- <a href="./前沿技术/213.%E7%B2%BE%E8%AF%BB%E3%80%8APrisma%20%E7%9A%84%E4%BD%BF%E7%94%A8%E3%80%8B.md">213.精读《Prisma 的使用》</a>
|
||||
|
||||
### 设计模式
|
||||
|
||||
|
||||
@@ -11,7 +11,7 @@
|
||||
|
||||
# 2 内容概要
|
||||
|
||||
来自 Wikipedia 的定义:模态框是一个定位于应用视窗定层的元素。它创造了一种模式让自身保持在一个最外层的子视察下显示,并让主视窗失效。用户必须在回到主视窗前在它上面做交互动作。
|
||||
来自 Wikipedia 的定义:模态框是一个定位于应用视窗顶层的元素。它创造了一种模式让自身保持在一个最外层的子视察下显示,并让主视窗失效。用户必须在回到主视窗前在它上面做交互动作。
|
||||
|
||||
**模态框用处**
|
||||
|
||||
@@ -103,7 +103,7 @@ const TdElement = data.map(item => {
|
||||
});
|
||||
```
|
||||
|
||||
上面代码初始化执行了 N 个模态框初始化代码,显然不合适。对于 table 操作列中触发的模态框,所有行都对应一个模态框,通过父级中一个状态变量来控制展示的内容:
|
||||
上面代码初始化执行了 N 个模态框初始化代码,显然不合适。对于 table 操作列中触发的模态框,所有行都复用同一个模态框,通过父级中一个状态变量来控制展示的内容:
|
||||
|
||||
```js
|
||||
class Table extends Component {
|
||||
|
||||
@@ -6,7 +6,7 @@ Typescript 官网也拿 `ReturnType` 这一经典例子说明它的作用:
|
||||
type ReturnType<T> = T extends (...args: any[]) => infer R ? R : any;
|
||||
```
|
||||
|
||||
理解为:如果 `T` 继承了 `extends (...args: any[]) => any` 类型,则返回类型 `R`,否则返回 `any`。其中 `R` 是什么呢?`R` 被定义在 `extends (...args: any[]) => infer R` 中,即 R 是从传入参数类型中推导出来的。
|
||||
理解为:如果 `T` 继承了 `(...args: any[]) => any` 类型,则返回类型 `R`,否则返回 `any`。其中 `R` 是什么呢?`R` 被定义在 `extends (...args: any[]) => infer R` 中,即 R 是从传入参数类型中推导出来的。
|
||||
|
||||
## 精读
|
||||
|
||||
@@ -36,10 +36,10 @@ function xxx<T>(value: T): { result: T }
|
||||
|
||||
但我们发现 `T` 这个泛型太整体化了,我们还不具备从中 Pick 子类型的能力。也就是对于 `xxx<{label: string}>` 这个场景,`T = {label: string}`,但我们无法将 `R` 定义为 `{label: R}` 这个位置,因为泛型是一个不可拆分的整体。
|
||||
|
||||
而且实际上为了类型安全,我们也不能允许用户描述任意的类型位置,**万一传入的类型结构不是 `{label: xxx}` 而是一个回调 `() => void`,那子类型推导岂不是建立在了错误的环境中。** 所以考虑到想要拿到 `{label: infer R}`,首先参数必须具备 `{label: xxx}` 的结构,所以正好可以将 `infer` 与条件判断 `T extends ? A : B` 结合起来用,即:
|
||||
而且实际上为了类型安全,我们也不能允许用户描述任意的类型位置,**万一传入的类型结构不是 `{label: xxx}` 而是一个回调 `() => void`,那子类型推导岂不是建立在了错误的环境中。** 所以考虑到想要拿到 `{label: infer R}`,首先参数必须具备 `{label: xxx}` 的结构,所以正好可以将 `infer` 与条件判断 `T extends xxx ? A : B` 结合起来用,即:
|
||||
|
||||
```typescript
|
||||
type GetLabelTypeFromObject<T> = T extends ? { label: infer R } ? R : never
|
||||
type GetLabelTypeFromObject<T> = T extends { label: infer R } ? R : never
|
||||
|
||||
type Result = GetLabelTypeFromObject<{ label: string }>;
|
||||
// type Result = string
|
||||
@@ -50,7 +50,7 @@ type Result = GetLabelTypeFromObject<{ label: string }>;
|
||||
回过头来看第一个需求,拿到第一个参数类型就可以用 `infer` 实现了:
|
||||
|
||||
```typescript
|
||||
type GetFirstParamType<T> = T extends ? (...args: infer R) => any ? R[0] : never
|
||||
type GetFirstParamType<T> = T extends (...args: infer R) => any ? R[0] : never
|
||||
```
|
||||
|
||||
可以理解为,如果此时 `T` 满足 `(...args: any) => any` 这个结构,同时我们用 `infer R` 表示 `R` 这个临时变量指代第一个 `any` 运行时类型,那么整个函数返回的类型就是 `R`。如果 `T` 都不满足 `(...args: any) => any` 这个结构,比如 `GetFirstParamType<number>`,那这种推导根本无从谈起,直接返回 `never` 类型兜底,当然也可以自定义比如 `any` 之类的任何类型。
|
||||
|
||||
@@ -0,0 +1,275 @@
|
||||
Typescript 4.4 正式发布了!距离 Typescript 4.5 发布还有三个月的时间,抓紧上车学习吧!
|
||||
|
||||
本周精读的文章:[announcing-typescript-4-4](https://devblogs.microsoft.com/typescript/announcing-typescript-4-4/)
|
||||
|
||||
## 概述
|
||||
|
||||
### 更智能的自动类型收窄
|
||||
|
||||
类型收窄功能非常方便,它可以让 Typescript 尽可能的像 Js 一样自动智能判定类型,从而避免类型定义的工作,让你的 Typescript 写得更像 Js。
|
||||
|
||||
其实这个功能早就有了,在我们 [精读《Typescript2.0 - 2.9》](https://github.com/ascoders/weekly/blob/master/%E5%89%8D%E6%B2%BF%E6%8A%80%E6%9C%AF/58.%E7%B2%BE%E8%AF%BB%E3%80%8ATypescript2.0%20-%202.9%E3%80%8B.md#%E8%87%AA%E5%8A%A8%E7%B1%BB%E5%9E%8B%E6%8E%A8%E5%AF%BC) 就已经介绍过,当时用的名词是自动类型推导,这次用了更精确的自动类型收窄一词,因为只有类型收窄是安全的,比如:
|
||||
|
||||
```typescript
|
||||
function foo(arg: unknown) {
|
||||
if (typeof arg === "string") {
|
||||
// We know 'arg' is a string now.
|
||||
console.log(arg.toUpperCase());
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
而在 Typescript 4.4 之前的版本,如果我们将这个判定赋值给一个变量,再用到 `if` 分支里,就无法正常收窄类型了:
|
||||
|
||||
```typescript
|
||||
function foo(arg: unknown) {
|
||||
const argIsString = typeof arg === "string";
|
||||
if (argIsString) {
|
||||
console.log(arg.toUpperCase());
|
||||
// ~~~~~~~~~~~
|
||||
// Error! Property 'toUpperCase' does not exist on type 'unknown'.
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
这个问题在 Typescript 4.4 得到了解决,实际上是把这种类型收窄判断逻辑加深了,即无论这个判断写在哪都可以生效。所以下面这种解构的用法判断也可以推断出类型收窄:
|
||||
|
||||
```typescript
|
||||
type Shape =
|
||||
| { kind: "circle", radius: number }
|
||||
| { kind: "square", sideLength: number };
|
||||
|
||||
function area(shape: Shape): number {
|
||||
// Extract out the 'kind' field first.
|
||||
const { kind } = shape;
|
||||
|
||||
if (kind === "circle") {
|
||||
// We know we have a circle here!
|
||||
return Math.PI * shape.radius ** 2;
|
||||
}
|
||||
else {
|
||||
// We know we're left with a square here!
|
||||
return shape.sideLength ** 2;
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
不仅是单一的判断,Typescript 4.4 还支持复合类型推导:
|
||||
|
||||
```typescript
|
||||
function doSomeChecks(
|
||||
inputA: string | undefined,
|
||||
inputB: string | undefined,
|
||||
shouldDoExtraWork: boolean,
|
||||
) {
|
||||
const mustDoWork = inputA && inputB && shouldDoExtraWork;
|
||||
if (mustDoWork) {
|
||||
// We can access 'string' properties on both 'inputA' and 'inputB'!
|
||||
const upperA = inputA.toUpperCase();
|
||||
const upperB = inputB.toUpperCase();
|
||||
// ...
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
`mustDoWork` 为 `true` 的分支就意味着 `inputA`、`inputB` 均收窄为 `string` 类型。
|
||||
|
||||
这种深层的判定还体现在,一个具备类型判断的变量进行再计算,生成的变量还具有类型判断功能:
|
||||
|
||||
```typescript
|
||||
function f(x: string | number | boolean) {
|
||||
const isString = typeof x === "string";
|
||||
const isNumber = typeof x === "number";
|
||||
const isStringOrNumber = isString || isNumber;
|
||||
if (isStringOrNumber) {
|
||||
x; // Type of 'x' is 'string | number'.
|
||||
}
|
||||
else {
|
||||
x; // Type of 'x' is 'boolean'.
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
可以看到,我们几乎可以像写 Js 一样写 Typescript,4.4 支持了大部分符合直觉的推导非常方便。但要注意的是,Typescript
|
||||
毕竟不是运行时,无法做到更彻底的自动推断,但足以支持绝大部分场景。
|
||||
|
||||
### 下标支持 Symbol 与模版字符串类型判定
|
||||
|
||||
原本我们定义一个用下标访问的对象是这样的:
|
||||
|
||||
```typescript
|
||||
interface Values {
|
||||
[key: string]: number
|
||||
}
|
||||
```
|
||||
|
||||
现在也支持 Symbol 拉:
|
||||
|
||||
```typescript
|
||||
interface Colors {
|
||||
[sym: symbol]: number;
|
||||
}
|
||||
|
||||
const red = Symbol("red");
|
||||
const green = Symbol("green");
|
||||
const blue = Symbol("blue");
|
||||
|
||||
let colors: Colors = {};
|
||||
|
||||
colors[red] = 255; // Assignment of a number is allowed
|
||||
let redVal = colors[red]; // 'redVal' has the type 'number'
|
||||
|
||||
colors[blue] = "da ba dee"; // Error: Type 'string' is not assignable to type 'number'.
|
||||
```
|
||||
|
||||
而且对于特定的字符串模版也支持类型匹配,比如希望以 `data-` 开头的下标是一种独立类型,可以这么定义:
|
||||
|
||||
```typescript
|
||||
interface Options {
|
||||
width?: number;
|
||||
height?: number;
|
||||
}
|
||||
|
||||
let a: Options = {
|
||||
width: 100,
|
||||
height: 100,
|
||||
"data-blah": true, // Error! 'data-blah' wasn't declared in 'Options'.
|
||||
};
|
||||
|
||||
interface OptionsWithDataProps extends Options {
|
||||
// Permit any property starting with 'data-'.
|
||||
[optName: `data-${string}`]: unknown;
|
||||
}
|
||||
|
||||
let b: OptionsWithDataProps = {
|
||||
width: 100,
|
||||
height: 100,
|
||||
"data-blah": true, // Works!
|
||||
|
||||
"unknown-property": true, // Error! 'unknown-property' wasn't declared in 'OptionsWithDataProps'.
|
||||
};
|
||||
```
|
||||
|
||||
这个对于 HTML 的 `data-` 属性非常有帮助。
|
||||
|
||||
同时还支持联合类型定义,下面两种类型定义方式是等价的:
|
||||
|
||||
```typescript
|
||||
interface Data {
|
||||
[optName: string | symbol]: any;
|
||||
}
|
||||
|
||||
// Equivalent to
|
||||
|
||||
interface Data {
|
||||
[optName: string]: any;
|
||||
[optName: symbol]: any;
|
||||
}
|
||||
```
|
||||
|
||||
### 更严格的错误捕获类型
|
||||
|
||||
在 `unknown` 类型出来之前,Typescript 以 `any` 作为抛出错误的默认类型,毕竟谁也不知道抛出错误的类型是什么:
|
||||
|
||||
```typescript
|
||||
try {
|
||||
// Who knows what this might throw...
|
||||
executeSomeThirdPartyCode();
|
||||
}
|
||||
catch (err) { // err: any
|
||||
console.error(err.message); // Allowed, because 'any'
|
||||
err.thisWillProbablyFail(); // Allowed, because 'any' :(
|
||||
}
|
||||
```
|
||||
|
||||
Who knows what this might throw... 这句话很有意思,一个函数任何地方都可能出现运行时错误,这根本不是静态分析可以解决的,所以不可能自动推断错误类型,所以只能用 `any`。
|
||||
|
||||
在 Typescript 4.4 的 `--useUnknownInCatchVariables` 或 `--strict` 模式下都将以 `unknown` 作为捕获到错误的默认类型。
|
||||
|
||||
相比不存在的类型 `never`,`unknown` 仅仅是不知道是什么类型而已,所以不能像 `any` 一样当作任何类型使用,但我们可以将其随意推断为任意类型:
|
||||
|
||||
```typescript
|
||||
try {
|
||||
executeSomeThirdPartyCode();
|
||||
}
|
||||
catch (err) { // err: unknown
|
||||
// Error! Property 'message' does not exist on type 'unknown'.
|
||||
console.error(err.message);
|
||||
|
||||
// Works! We can narrow 'err' from 'unknown' to 'Error'.
|
||||
if (err instanceof Error) {
|
||||
console.error(err.message);
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
如果觉得这样做麻烦,也可以重新申明类型为 `any`:
|
||||
|
||||
```typescript
|
||||
try {
|
||||
executeSomeThirdPartyCode();
|
||||
}
|
||||
catch (err: any) {
|
||||
console.error(err.message); // Works again!
|
||||
}
|
||||
```
|
||||
|
||||
但这样做其实并不合适,因为即便是考虑了运行时因素,理论上还是可能发生意外错误,所以对错误过于自信的类型推断是不太合适的,最好保持其 `unknown` 类型,对所有可能的边界情况做处理。
|
||||
|
||||
### 明确的可选属性
|
||||
|
||||
对象的可选属性在类型描述时有个含糊不清的地方,比如:
|
||||
|
||||
```typescript
|
||||
interface Person {
|
||||
name: string,
|
||||
age?: number;
|
||||
}
|
||||
```
|
||||
|
||||
其实 Typescript 对其的类型定义的是:
|
||||
|
||||
```typescript
|
||||
interface Person {
|
||||
name: string,
|
||||
age?: number | undefined;
|
||||
}
|
||||
```
|
||||
|
||||
为什么要这么定义呢?因为很多情况下,没有这个 key,与这个 key 的值为 `undefined` 的表现是等价的。但比如 `Object.keys` 场景下这两种表现却又不等价,所以理论上对于 `age?: number` 的确切表述是:要么没有 `age`,要么有 `age` 且类型为 `number`,也就是说下面的写法应该是错误的:
|
||||
|
||||
```typescript
|
||||
// With 'exactOptionalPropertyTypes' on:
|
||||
const p: Person = {
|
||||
name: "Daniel",
|
||||
age: undefined, // Error! undefined isn't a number
|
||||
};
|
||||
```
|
||||
|
||||
在 Typescript 4.4 中同时开启 `--exactOptionalPropertyTypes` 与 `--strictNullChecks` 即可生效。
|
||||
|
||||
仔细想想这是合理的,既然定义的类型不是 `undefined`,就算对象是可选类型,也不能认为赋值 `undefined` 是合理的,因为 `age?: number` 的心理预期是,要么没有这个 key,要么有但是类型为 `number`,所以当 `Object.keys` 发现 `age` 这个 key 时,值就应该是 `number`。
|
||||
|
||||
### 支持 Static Block
|
||||
|
||||
Typescript 4.4 支持了 [class static blocks](https://github.com/tc39/proposal-class-static-block#ecmascript-class-static-initialization-blocks),并且在代码块作用域内可以访问私有变量。
|
||||
|
||||
|
||||
还有一些性能提升与体验优化杂项就不一一列举了,感兴趣可以直接看原文档:[perf-improvements](https://devblogs.microsoft.com/typescript/announcing-typescript-4-4/#perf-improvements)。
|
||||
|
||||
|
||||
## 总结
|
||||
|
||||
从 Typescript 4.4 特性可以看出,Typescript 正在往 “更具备原生 JS 亲和性” 方向作出努力,这无疑会使 Typescript 变得越来越好用。
|
||||
|
||||
对更多新特性感兴趣,可以 [查看 Typescript 4.5 版本发布计划](https://github.com/microsoft/TypeScript/issues/45418)。
|
||||
|
||||
> 讨论地址是:[精读《Typescript 4.4》· Issue #348 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/348)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,255 @@
|
||||
成熟的产品都有较高的稳定性要求,仅前端就要做大量监控、错误上报,后端更是如此,一个未考虑的异常可能导致数据错误、服务雪崩、内存溢出等等问题,轻则每天焦头烂额的处理异常,重则引发线上故障。
|
||||
|
||||
假设代码逻辑没有错误,那么剩下的就是异常错误了。
|
||||
|
||||
由于任何服务、代码都可能存在外部调用,只要外部调用存在不确定性,代码就可能出现异常,所以捕获异常是一个非常重要的基本功。
|
||||
|
||||
所以本周就精读 [How to avoid uncaught async errors in Javascript](https://advancedweb.hu/how-to-avoid-uncaught-async-errors-in-javascript/) 这篇文章,看看 JS 如何捕获异步异常错误。
|
||||
|
||||
## 概述
|
||||
|
||||
之所以要关注异步异常,是因为捕获同步异常非常简单:
|
||||
|
||||
```typescript
|
||||
try {
|
||||
;(() => {
|
||||
throw new Error('err')
|
||||
})()
|
||||
} catch (e) {
|
||||
console.log(e) // caught
|
||||
}
|
||||
```
|
||||
|
||||
但异步错误却无法被直接捕获,这不太直观:
|
||||
|
||||
```typescript
|
||||
try {
|
||||
;(async () => {
|
||||
throw new Error('err') // uncaught
|
||||
})()
|
||||
} catch (e) {
|
||||
console.log(e)
|
||||
}
|
||||
```
|
||||
|
||||
原因是异步代码并不在 `try catch` 上下文中执行,唯一的同步逻辑只有创建一个异步函数,所以异步函数内的错误无法被捕获。
|
||||
|
||||
要捕获 `async` 函数内的异常,可以调用 `.catch`,因为 `async` 函数返回一个 Promise:
|
||||
|
||||
```typescript
|
||||
;(async () => {
|
||||
throw new Error('err')
|
||||
})().catch((e) => {
|
||||
console.log(e) // caught
|
||||
})
|
||||
```
|
||||
|
||||
当然也可以在函数体内直接用 `try catch`:
|
||||
|
||||
```typescript
|
||||
;(async () => {
|
||||
try {
|
||||
throw new Error('err')
|
||||
} catch (e) {
|
||||
console.log(e) // caught
|
||||
}
|
||||
})()
|
||||
```
|
||||
|
||||
类似的,如果在循环体里捕获异常,则要使用 `Promise.all`:
|
||||
|
||||
```typescript
|
||||
try {
|
||||
await Promise.all(
|
||||
[1, 2, 3].map(async () => {
|
||||
throw new Error('err')
|
||||
})
|
||||
)
|
||||
} catch (e) {
|
||||
console.log(e) // caught
|
||||
}
|
||||
```
|
||||
|
||||
也就是说 `await` 修饰的 Promise 内抛出的异常,可以被 `try catch` 捕获。
|
||||
|
||||
但不是说写了 `await` 就一定能捕获到异常,一种情况是 Promise 内再包含一个异步:
|
||||
|
||||
```typescript
|
||||
new Promise(() => {
|
||||
setTimeout(() => {
|
||||
throw new Error('err') // uncaught
|
||||
}, 0)
|
||||
}).catch((e) => {
|
||||
console.log(e)
|
||||
})
|
||||
```
|
||||
|
||||
这个情况要用 `reject` 方式抛出异常才能被捕获:
|
||||
|
||||
```typescript
|
||||
new Promise((res, rej) => {
|
||||
setTimeout(() => {
|
||||
rej('err') // caught
|
||||
}, 0)
|
||||
}).catch((e) => {
|
||||
console.log(e)
|
||||
})
|
||||
```
|
||||
|
||||
另一种情况是,这个 `await` 没有被执行到:
|
||||
|
||||
```typescript
|
||||
const wait = (ms) => new Promise((res) => setTimeout(res, ms))
|
||||
|
||||
;(async () => {
|
||||
try {
|
||||
const p1 = wait(3000).then(() => {
|
||||
throw new Error('err')
|
||||
}) // uncaught
|
||||
await wait(2000).then(() => {
|
||||
throw new Error('err2')
|
||||
}) // caught
|
||||
await p1
|
||||
} catch (e) {
|
||||
console.log(e)
|
||||
}
|
||||
})()
|
||||
```
|
||||
|
||||
`p1` 等待 3s 后抛出异常,但因为 2s 后抛出了 `err2` 异常,中断了代码执行,所以 `await p1` 不会被执行到,导致这个异常不会被 catch 住。
|
||||
|
||||
而且有意思的是,如果换一个场景,提前执行了 `p1`,等 1s 后再 `await p1`,那异常就从无法捕获变成可以捕获了,这样浏览器会怎么处理?
|
||||
|
||||
```typescript
|
||||
const wait = (ms) => new Promise((res) => setTimeout(res, ms))
|
||||
|
||||
;(async () => {
|
||||
try {
|
||||
const p1 = wait(1000).then(() => {
|
||||
throw new Error('err')
|
||||
})
|
||||
await wait(2000)
|
||||
await p1
|
||||
} catch (e) {
|
||||
console.log(e)
|
||||
}
|
||||
})()
|
||||
```
|
||||
|
||||
结论是浏览器 1s 后会抛出一个未捕获异常,但再过 1s 这个未捕获异常就消失了,变成了捕获的异常。
|
||||
|
||||
这个行为很奇怪,当程序复杂时很难排查,因为并行的 Promise 建议用 Promise.all 处理:
|
||||
|
||||
```typescript
|
||||
await Promise.all([
|
||||
wait(1000).then(() => {
|
||||
throw new Error('err')
|
||||
}), // p1
|
||||
wait(2000),
|
||||
])
|
||||
```
|
||||
|
||||
另外 Promise 的错误会随着 Promise 链传递,因此建议把 Promise 内多次异步行为改写为多条链的模式,在最后 `catch` 住错误。
|
||||
|
||||
还是之前的例子,Promise 无法捕获内部的异步错误:
|
||||
|
||||
```typescript
|
||||
new Promise((res, rej) => {
|
||||
setTimeout(() => {
|
||||
throw Error('err')
|
||||
}, 1000) // 1
|
||||
}).catch((error) => {
|
||||
console.log(error)
|
||||
})
|
||||
```
|
||||
|
||||
但如果写成 Promise Chain,就可以捕获了:
|
||||
|
||||
```typescript
|
||||
new Promise((res, rej) => {
|
||||
setTimeout(res, 1000) // 1
|
||||
})
|
||||
.then((res, rej) => {
|
||||
throw Error('err')
|
||||
})
|
||||
.catch((error) => {
|
||||
console.log(error)
|
||||
})
|
||||
```
|
||||
|
||||
原因是,用 Promise Chain 代替了内部多次异步嵌套,这样多个异步行为会被拆解为对应 Promise Chain 的同步行为,Promise 就可以捕获啦。
|
||||
|
||||
最后,DOM 事件监听内抛出的错误都无法被捕获:
|
||||
|
||||
```typescript
|
||||
document.querySelector('button').addEventListener('click', async () => {
|
||||
throw new Error('err') // uncaught
|
||||
})
|
||||
```
|
||||
|
||||
同步也一样:
|
||||
|
||||
```typescript
|
||||
document.querySelector('button').addEventListener('click', () => {
|
||||
throw new Error('err') // uncaught
|
||||
})
|
||||
```
|
||||
|
||||
只能通过函数体内 `try catch` 来捕获。
|
||||
|
||||
## 精读
|
||||
|
||||
我们开篇提到了要监控所有异常,仅通过 `try catch`、`then` 捕获同步、异步错误还是不够的,因为这些是局部错误捕获手段,当我们无法保证所有代码都处理了异常时,需要进行全局异常监控,一般有两种方法:
|
||||
|
||||
- `window.addEventListener('error')`
|
||||
- `window.addEventListener('unhandledrejection')`
|
||||
|
||||
`error` 可以监听所有同步、异步的运行时错误,但无法监听语法、接口、资源加载错误。而 `unhandledrejection` 可以监听到 Promise 中抛出的,未被 `.catch` 捕获的错误。
|
||||
|
||||
在具体的前端框架中,也可以通过框架提供的错误监听方案解决部分问题,比如 React 的 [Error Boundaries](https://reactjs.org/docs/error-boundaries.html)、Vue 的 [error handler](https://v3.vuejs.org/api/application-config.html#errorhandler),一个是 UI 组件级别的,一个是全局的。
|
||||
|
||||
回过头来看,本身 js 提供的 `try catch` 错误捕获是非常有效的,之所以会遇到无法捕获错误的经常,大多是因为异步导致的。
|
||||
|
||||
然而大部分异步错误,都可以通过 `await` 的方式解决,我们唯一要注意的是,`await` 仅支持一层,或者说一条链的错误监听,比如这个例子是可以监听到错误的:
|
||||
|
||||
```typescript
|
||||
try {
|
||||
await func1()
|
||||
} catch (err) {
|
||||
// caught
|
||||
}
|
||||
|
||||
async function func1() {
|
||||
await func2()
|
||||
}
|
||||
|
||||
async function func2() {
|
||||
throw Error('error')
|
||||
}
|
||||
```
|
||||
|
||||
也就是说,只要这一条链内都被 `await` 住了,那么最外层的 `try catch` 就能捕获异步错误。但如果有一层异步又脱离了 `await`,那么就无法捕获了:
|
||||
|
||||
```typescript
|
||||
async function func2() {
|
||||
setTimeout(() => {
|
||||
throw Error('error') // uncaught
|
||||
})
|
||||
}
|
||||
```
|
||||
|
||||
针对这个问题,原文也提供了例如 `Promise.all`、链式 Promise、`.catch` 等方法解决,因此只要编写代码时注意对异步的处理,就可以用 `try catch` 捕获这些异步错误。
|
||||
|
||||
## 总结
|
||||
|
||||
关于异步错误的处理,如果还有其它未考虑到的情况,欢迎留言补充。
|
||||
|
||||
> 讨论地址是:[精读《捕获所有异步 error》· Issue #350 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/350)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,142 @@
|
||||
[class-static-block](https://github.com/tc39/proposal-class-static-block) 提案于 [2021.9.1](https://github.com/tc39/proposal-class-static-block/commit/c0cabee0aa2d036a8d902fea7bc1d179e3de2477) 进入 stage4,是一个基于 Class 增强的提案。
|
||||
|
||||
本周我们结合 [ES2022 feature: class static initialization blocks](https://2ality.com/2021/09/class-static-block.html) 这篇文章一起讨论一下这个特性。
|
||||
|
||||
## 概述
|
||||
|
||||
为什么我们需要 class static block 这个语法呢?其中一个原因是对 Class 静态变量的灵活赋值需求。以下面为例,我们想在 Class 内部对静态变量做批量初始化,就不得不写一个无用的 `_` 变量用来做初始化的逻辑:
|
||||
|
||||
```typescript
|
||||
class Translator {
|
||||
static translations = {
|
||||
yes: 'ja',
|
||||
no: 'nein',
|
||||
maybe: 'vielleicht',
|
||||
};
|
||||
static englishWords = [];
|
||||
static germanWords = [];
|
||||
static _ = initializeTranslator( // (A)
|
||||
this.translations, this.englishWords, this.germanWords);
|
||||
}
|
||||
function initializeTranslator(translations, englishWords, germanWords) {
|
||||
for (const [english, german] of Object.entries(translations)) {
|
||||
englishWords.push(english);
|
||||
germanWords.push(german);
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
而且我们为什么把 `initializeTranslator` 写在外面呢?就因为在 Class 内部不能写代码块,但这造成一个严重的问题,是外部函数无法访问 Class 内部属性,所以需要做一堆枯燥的传值。
|
||||
|
||||
从这个例子看出,我们为了自定义一段静态变量初始化逻辑,需要做出两个妥协:
|
||||
|
||||
1. 在外部定义一个函数,并接受大量 Class 成员变量传参。
|
||||
2. 在 Class 内部定义一个无意义的变量 `_` 用来启动这个函数逻辑。
|
||||
|
||||
这实在太没有代码追求了,我们在 Class 内部做掉这些逻辑不就简洁了吗?这就是 class static block 特性:
|
||||
|
||||
```typescript
|
||||
class Translator {
|
||||
static translations = {
|
||||
yes: 'ja',
|
||||
no: 'nein',
|
||||
maybe: 'vielleicht',
|
||||
};
|
||||
static englishWords = [];
|
||||
static germanWords = [];
|
||||
static { // (A)
|
||||
for (const [english, german] of Object.entries(this.translations)) {
|
||||
this.englishWords.push(english);
|
||||
this.germanWords.push(german);
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
可以看到,`static` 关键字后面不跟变量,而是直接跟一个代码块,就是 class static block 语法的特征,在这个代码块内部,可以通过 `this` 访问 Class 所有成员变量,包括 `#` 私有变量。
|
||||
|
||||
原文对这个特性使用介绍就结束了,最后还提到一个细节,就是执行顺序。即所有 `static` 变量或区块都按顺序执行,父类优先执行:
|
||||
|
||||
```typescript
|
||||
class SuperClass {
|
||||
static superField1 = console.log('superField1');
|
||||
static {
|
||||
assert.equal(this, SuperClass);
|
||||
console.log('static block 1 SuperClass');
|
||||
}
|
||||
static superField2 = console.log('superField2');
|
||||
static {
|
||||
console.log('static block 2 SuperClass');
|
||||
}
|
||||
}
|
||||
|
||||
class SubClass extends SuperClass {
|
||||
static subField1 = console.log('subField1');
|
||||
static {
|
||||
assert.equal(this, SubClass);
|
||||
console.log('static block 1 SubClass');
|
||||
}
|
||||
static subField2 = console.log('subField2');
|
||||
static {
|
||||
console.log('static block 2 SubClass');
|
||||
}
|
||||
}
|
||||
|
||||
// Output:
|
||||
// 'superField1'
|
||||
// 'static block 1 SuperClass'
|
||||
// 'superField2'
|
||||
// 'static block 2 SuperClass'
|
||||
// 'subField1'
|
||||
// 'static block 1 SubClass'
|
||||
// 'subField2'
|
||||
// 'static block 2 SubClass'
|
||||
```
|
||||
|
||||
所以 Class 内允许有多个 class static block,父类和子类也可以有,不同执行顺序结果肯定不同,这个选择权交给了使用者,因为执行顺序和书写顺序一致。
|
||||
|
||||
## 精读
|
||||
|
||||
结合提案来看,class static block 还有一个动机,就是给了一个访问私有变量的机制:
|
||||
|
||||
```typescript
|
||||
let getX;
|
||||
|
||||
export class C {
|
||||
#x
|
||||
constructor(x) {
|
||||
this.#x = { data: x };
|
||||
}
|
||||
|
||||
static {
|
||||
// getX has privileged access to #x
|
||||
getX = (obj) => obj.#x;
|
||||
}
|
||||
}
|
||||
|
||||
export function readXData(obj) {
|
||||
return getX(obj).data;
|
||||
}
|
||||
```
|
||||
|
||||
理论上外部无论如何都无法访问 Class 私有变量,但上面例子的 `readXData` 就可以,而且不会运行时报错,原因就是其整个流程都是合法的,最重要的原因是,class static block 可以同时访问私有变量与全局变量,所以可以利用其做一个 “里应外合”。
|
||||
|
||||
不过我并不觉得这是一个好点子,反而像一个 "BUG",因为任何对规定的突破都会为可维护性埋下隐患,除非这个特性用在稳定的工具、框架层,用来做一些便利性工作,最终提升了应用编码的体验,这种用法是可以接受的。
|
||||
|
||||
最后要意识到,class static block 本质上并没有增加新功能,我们完全可以用普通静态变量代替,只是写起来很不自然,所以这个特性可以理解为对缺陷的补充,或者是语法完善。
|
||||
|
||||
## 总结
|
||||
|
||||
总的来说,class static block 在 Class 内创建了一个块状作用域,这个作用域内拥有访问 Class 内部私有变量的特权,且这个块状作用域仅在引擎调用时初始化执行一次,是一个比较方便的语法。
|
||||
|
||||
原文下方有一些反对声音,说这是对 JS 的复杂化,也有诸如 JS 越来越像 Java 的声音,不过我更赞同作者的观点,也就是 Js 中 Class 并不是全部,现在越来越多代码使用函数式语法,即便使用了 Class 的场景也会存在大量函数申明,所以 class static block 这个提案对开发者的感知实际上并不大。
|
||||
|
||||
> 讨论地址是:[精读《class static block》· Issue #351 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/351)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,122 @@
|
||||
Power Fx 是一门语言,虽然它被推荐的场景是低代码,但我们必须以一门语言角度看待它,才能更好的理解。
|
||||
|
||||
Power Fx 的创建是为了更好的辅助非专业开发人员,因此这门语言被设计的足够简单,希望这门语言可以同时服务于专业与非专业开发者,这是个非常崇高的理想。
|
||||
|
||||
本周我们就随着 [Microsoft Power Fx 概述](https://docs.microsoft.com/zh-cn/power-platform/power-fx/overview) 这篇文章,详细了解一下这门语言是怎么做的。
|
||||
|
||||
## 概述
|
||||
|
||||
```javascript
|
||||
Notify("this is a problem", Error)
|
||||
```
|
||||
|
||||
这就是 Power Fx 语言的一个例子,乍一看没什么特别的。
|
||||
|
||||
Power Fx 描述的是画布应用公式语言,也就是说,这个编程语言是专门为画布引用设计的。
|
||||
|
||||
那什么是画布应用呢?低代码、网站搭建、BI、Web Excel 这些统统都是画布应用,所以 Power Fx 其实是一门适应画布场景的语言,直接面向用户。
|
||||
|
||||
那这种画布语言应该具备什么特性呢?Power Fx 团队已经有了一些思考:
|
||||
|
||||
- 简单:该语言设计本着简介简单的原则,这样才方便非开发人员上手。
|
||||
- Excel 一致性:可以帮助 Excel 开发者做知识迁移,一部分是和微软 Excel 太成功了有关,另一方面 Excel 表达式在画布语言领域探索确实深入,有可取性。对不能满足的尝试借鉴 SQL 这种声明性语言。
|
||||
- 声明性:这个最重要,即描述做什么,而不是如何或何时做。这个有点像 Jquery 转到 React 模式时,过程式代码与数据驱动代码的区别。
|
||||
- 函数式:函数式在灵活性和易用性上有天然优势,且无副作用的特性也利于理解逻辑与编译优化。
|
||||
- 组合:即利用函数式这个特性,推荐利用已有函数组合成新功能,而不是将比如 Sort、Filter 等功能在每个组件上重复实现或者重复配置一遍。
|
||||
- 强类型:类型对可维护性至关重要,再强大的低代码语言,如果没有类型支持,都不能称为易上手。
|
||||
- 类型推理:可以自动推断类型。这个和强类型一样,有点 TS 的感觉,主要方便书写简洁代码。
|
||||
- 不推荐面向对象:既然推荐了函数式,当然不推荐面向对象了。
|
||||
- 可推展:开发者要拥有拓展函数与组件的能力,还要支持通过 Javascript 来拓展。
|
||||
- 对开发人员友好:这门语言还要在与前面原则不冲突的情况下,尽量对开发人员友好。
|
||||
- 语言的迭代:即当语法变更时,要帮助用户平滑迁移,毕竟这门语言直接面向普通用户而非专业开发者。Power Fx 提供了这个能力,对每个文档进行版本标记,并在升级后,通过 “兼容转换器” 自动将老语法升级为新语法。
|
||||
- 无 undefined 值:为了简化语言带来的理解成本,移除了 undefined 值这个特定。
|
||||
|
||||
所以,基于这些考虑的 Power Fx 设计出来是这样的:
|
||||
|
||||
1. 实时性
|
||||
|
||||
即无论任何 UI 或语法错误,都不会阻塞其它正常节点的工作,同时代码效果与错误信息实时反馈。这保证了在画布应用编写逻辑的良好体验,因为本身画布应用就是实时的,低代码能力本身也要与画布实时性浑然一体。
|
||||
|
||||
<img width=500 src="https://z3.ax1x.com/2021/09/25/4sqx1g.gif">
|
||||
|
||||
2. 低代码特征
|
||||
|
||||
即任何 UI 组件都不需要描述类似 `onChange` 之类的回调,它们只要申明使用的变量,当这些变量变化时,程序会自动、异步、按需的更新使用到的组件。
|
||||
|
||||
3. 与无代码结合
|
||||
|
||||
所谓无代码,就是通过 UI 表单可视化的对画布应用进行配置。
|
||||
|
||||
与无代码的结合方式是,任意属性都可以用低代码,即表达式编写,但也提供了 UI 表单供编辑,其中 UI 表单编辑后,可以用低代码二次加工,而用低代码编辑的属性,表单就无法编辑了,此时点击表单编辑会跳转到低代码编辑框。
|
||||
|
||||
## 精读
|
||||
|
||||
创建一门不用学习就能上手的编程语言,需要足够简单,即从用户角度来理解事物:比如用户不知道回调函数等概念,那就屏蔽所谓的回调函数概念,让一切都是表达式。
|
||||
|
||||
这些表达式看起来很简单,也符合直觉,并且会自动驱动 UI 重绘,即声明式编程。
|
||||
|
||||
下面我们来讨论几个有意思的点:
|
||||
|
||||
### 为什么不用 Js
|
||||
|
||||
大部分画布应用都是指 Web 应用了,即便是 Excel,现在也早已转型到 Web Excel,就微软来说,早早转型到 Office Online 就能看出来。
|
||||
|
||||
然而 Js 是浏览器内置支持的脚本语言,且上手成本也比较低,其实很多低代码平台内置的编程语言就是 Js,其好处是实现成本低(沙箱甚至 `new function`),而 Power Fx 在浏览器平台最终也要转换为 Js 执行,费这么大劲创造一门新语言,无非是觉得 Js 不够 “零门槛”。
|
||||
|
||||
首先第一点是不符合 Excel 表达式规范,我们不要忘了 Power Fx 也是有小心机的,它想利用 Excel 生态扩大用户群,所以第一目的是兼容 Excel 语法。比如 Excel 使用 & 链接字符串,而 Js 使用 + 连接,虽然我觉得显然 + 号更自然,但微软觉得还是要符合 Excel 用户习惯。说实话在这一点上,撇开 Excel 的语法,我很难看出为什么 & 连接字符串就 “更易上手”,而 + 连接字符串 “更适合程序员使用”。
|
||||
|
||||
但有些是认可的,比如移除了 undefined 值,确实让语言更好理解。
|
||||
|
||||
也许未来 Power Fx 会更进一步,引入类 SQL 描述性的语法,像写自然语言一样编程,在这种程度上,配合强类型提示,在特定场景会比 Js 更好用。
|
||||
|
||||
### 提供内置函数
|
||||
|
||||
Js 提供了大量内置函数,这似乎不是 Power Fx 的专利,但 Power Fx 提供了许多 UI 级别的函数,这可比 Js 点到为止的 `alert` 强多了。
|
||||
|
||||
Power Fx 提供了 Confirm、Notify 用于弹出提示窗供用户输入,并且就算要形成逻辑,也只需要几乎一行代码:
|
||||
|
||||
```text
|
||||
If( Confirm( "Are you sure?", {Title: "Delete Confirmation"} ), Remove( ThisItem ) )
|
||||
```
|
||||
|
||||
可以看到,这里充斥着异步操作:
|
||||
|
||||
- 等待用户输入。
|
||||
- 删除元素。
|
||||
|
||||
但这些内置函数间的组合将异步效果转换为同步写法,这大大降低开发成本。
|
||||
|
||||
另一类内置函数则封装了业务属性,比如 `User` 可以获取当前用户信息。本来获取用户信息就需要代码开发,但低代码平台本身就实现了全套账号体系,因此低代码平台可以直接提供如 `User().Email` 函数访问当前用户的邮箱地址。
|
||||
|
||||
还有诸如 `Reset` 函数,可以重制控件为默认值,比如 `Reset( TextInput1 )`,这其实是把平台提供的所有上层能力抽象成低代码函数供用户调用,这样用户只要付出一点点学习成本,就可以获得比简单 UI 强大的多的应用编辑能力,这非常值得我们学习。
|
||||
|
||||
更多公式函数可以参考 [文档](https://docs.microsoft.com/zh-cn/powerapps/maker/canvas-apps/formula-reference)。
|
||||
|
||||
### 提供对表的操作
|
||||
|
||||
[对表的操作](https://docs.microsoft.com/zh-cn/power-platform/power-fx/tables) 让应用数据管理可以和 Excel 同一概念来看待了,这个统一方式就是,把数据抽象成表。Power Fx 提供了系列函数用于表处理:
|
||||
|
||||
```text
|
||||
AddColumns(
|
||||
Filter( Products, 'Quantity Requested' > 'Quantity Available' ),
|
||||
"Quantity To Order", 'Quantity Requested' - 'Quantity Available'
|
||||
)
|
||||
```
|
||||
|
||||
这些函数可以跨语言操作 Excel、Sql Server 等数据源的数据,学习成本与 SQL 类似,其实到这一步,对低代码用户的要求也不低,至少和熟练使用计算公式的 Excel 使用者相当。
|
||||
|
||||
## 总结
|
||||
|
||||
UI 编辑能力局限但易上手,代码能力最强但难上手,Power Fx 给我们提供了一种折中方案,即提供一种 “高度封装的简化代码” 供用户使用。
|
||||
|
||||
纵观其它低代码平台,也有一类采用了另一种折中方案,即超强的复杂编辑 UI,登峰造极的产物便是逻辑编排,这个方向在特定领域也是不错的选择,参考: [精读《低代码逻辑编排》](https://github.com/ascoders/weekly/blob/master/%E5%89%8D%E6%B2%BF%E6%8A%80%E6%9C%AF/197.%E7%B2%BE%E8%AF%BB%E3%80%8A%E4%BD%8E%E4%BB%A3%E7%A0%81%E9%80%BB%E8%BE%91%E7%BC%96%E6%8E%92%E3%80%8B.md)。
|
||||
|
||||
> 讨论地址是:[精读《Microsoft Power Fx》· Issue #355 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/355)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,101 @@
|
||||
> PS: 所有没给原文链接的精读都是原创,本篇也是原创。
|
||||
|
||||
前端精读之前写了 23 篇设计模式总结文,再加上 6 种设计原则,开闭、单一职责、依赖倒置、接口分离、迪米特法则、里氏替换原则,基本上对代码的可维护性有了全面深刻的理解。
|
||||
|
||||
但你我在工作中都会不断遇到烂代码,快要无法维护的大型项目,想一想,仅凭设计模式就能解决这些问题吗?为什么不断膨胀的大型项目总是变得越来越难以维护,而复杂度更高的真实世界,但没有人觉得快要崩塌了呢?
|
||||
|
||||
设计模式考虑的是代码之间的关系,设计原则考虑的是模块以及项目间的关系,那是否存在更上层的思考,解决大型项目越来越难维护的问题?
|
||||
|
||||
## 精读
|
||||
|
||||
先考虑一下,为什么真实世界没有可维护性问题?
|
||||
|
||||
### 真实世界为什么没有可维护问题
|
||||
|
||||
这个问题看起来有点傻,因为从来没有人会发出这样的抱怨 “我们的产品、科技、概念太多了,多到我觉得无法在这个世界活下去了”。但是在代码世界,程序员经常会抱怨,项目的概念太多、设计过于复杂,以至于他无法继续再维护下去了,是时候寻找下一份工作了。
|
||||
|
||||
一种显而易见的解释是,生活中,我们都是小角色,活在自己的天空下并不需要触及那么多概念,而程序员在项目中基本扮演了上帝的角色,必须为每一个细节操心。
|
||||
|
||||
但这并不完全解释得通。我们以为自己接触的东西不多,但实际上日常生活的知识太多了,就拿家电来说,每个人都会同时接触几十种家电,大到空调冰箱洗衣机,小到手机牙刷充电器,即便这些产品被大量标准化,但每个产品用起来都有大量细节的区别,但没有一个人觉得学习使用一个新剃须刀是一种负担,也并不觉得一款设计得不好的牙刷,会对整个牙刷行业造成怎样负面的冲击。
|
||||
|
||||
这背后的原因是:拷贝。正因为我们用的每一件东西都是拷贝,所以即使用坏了也不会对其它相同物品产生任何影响。但代码世界则不同,因为代码调用关系的存在,复用的越优雅,破坏力也就越大。一栋大楼断了几块钢筋尚可支撑,但换在代码世界,只要断了一块钢筋,就意味着这栋大楼所有钢筋都断了。这就是程序员最痛恨的问题之一,就是为什么改了一处看似人畜无害的代码,却导致一场故障。
|
||||
|
||||
从这个角度来说,代码世界是无法吸取真实世界经验的。而且代码世界的这种副作用,在商业上是有巨大正向价值的,即软件的边际成本几乎为零,这是实体产品做不到的,因此软件需要付出可维护性代价,似乎是这种极低边际成本的代价。
|
||||
|
||||
虽然通过借鉴真实世界的经验,使自己维护成本变成零是不可能的,但真实世界对软件世界确实有可借鉴之处,下面我们就来探讨几个有意思的点。
|
||||
|
||||
### 真实世界不断屏蔽复杂度
|
||||
|
||||
不知道你会不会有过这样的思考:面试官总是问原理,就是担心我只会用框架,而缺乏基础。但基础是什么呢?懂得 js,java 算是基础吗?也可以说不算,因为这些语言背后的编译原理好像才是基础,编译原理背后还有操作系统,操作系统运行在硬件上,而硬件的原理呢?从 CPU 设计到背后的硅是如何制作的,等等,这样下去,似乎永远也无法掌握原理。
|
||||
|
||||
但当我们从软件推导到硬件时,可以很自然的发现,没有人觉得掌握硅胶的制作过程是一件必须的事,我们可以一直使用硅胶制作的产品,但却可以不用了解硅胶制作的原理。
|
||||
|
||||
真实世界总是不断屏蔽复杂度,作为消费者时,我们面对的商品总是经过精心包装,简单易用的,只有我们工作时,才需要对某个专业领域的原理有所了解。
|
||||
|
||||
这个道理可以迁移到代码世界,即对于一个庞大而复杂的项目,不能指望每位开发者都了解全部原理后才能工作,我们需要在大多数时候把开发者当作消费者来看待,提供精美而稳定的接口。要做到这一点,需要一个类似下图的架构设计:
|
||||
|
||||
<img width=400 src="https://z3.ax1x.com/2021/10/08/5PTFBR.png">
|
||||
|
||||
从图中可以看出,即便是业务层代码,我也不需要关心过于底层的实现,底层的代码就像脚下被压实了的土地,只需要在上面走就行了。
|
||||
|
||||
然而最让人崩溃的是下面的设计:
|
||||
|
||||
<img width=400 src="https://z3.ax1x.com/2021/10/08/5P7Fxg.png">
|
||||
|
||||
为了解决一个问题,需要面对无穷无尽的上下文,这就是维护成本高的最主要原因。
|
||||
|
||||
### 为什么觉得维护成本高
|
||||
|
||||
作为开发者,已经习惯了评价代码维护成本高还是低,今天我们换个视角,想一想为什么你会觉得维护成本高?
|
||||
|
||||
对维护成本的感受不完全是客观的,我画了一个四象限图:
|
||||
|
||||
<img width=300 src="https://z3.ax1x.com/2021/10/09/5iGjZ6.png">
|
||||
|
||||
左边是和人相关部分,包括你对代码的理解能力,以及对项目的熟悉度。
|
||||
|
||||
理解能力越强,越不容易觉得维护成本高;对项目越熟悉,哪怕是屎山代码,也会觉得重构后可维护性并不会提高,因为自己对项目会变得不熟悉。
|
||||
|
||||
右边是和项目相关部分,包括业务本身的复杂度,以及这背后的技术抽象实现的质量。
|
||||
|
||||
业务本身越复杂,维护成本就会越高,因为信息量不可避免的增大了,我们永远不能只盯着 Hello World 的 Demo 研究框架;代码质量体现了技术对业务的抽象,抽象的好,复杂度曲线就会比较贴合业务真实复杂度,抽象的不好,Hello World Demo 也能够新人进来喝一壶。
|
||||
|
||||
在这四个关键词中,业务复杂度是几乎无法改变的,对项目熟悉也需要一个过程,所以重点应该放在理解能力与代码质量两部分。
|
||||
|
||||
无论是个人理解能力,还是代码质量,目标都是帮助我们快速理解项目,也就是说,只要能快速理解技术项目在做什么,我如何快速融入,就会觉得可维护性高,反之则觉得不好维护。
|
||||
|
||||
所以一个简单的项目,或者一个分层合理,文档清晰的大型项目都会让人觉得可维护性好。在这一点上,需要向真实世界学习的经验就是,即便在软件世界,也并不是了解所有原理,所有犄角旮旯的逻辑才表明技高一筹,带着这种思想工作只会让大家陷入无尽的内卷和理解焦虑。我们要给大家思想减负,不需要理解的模块、代码设计,就不要轻易展示出来,将每个模块开发所需了解的最小知识设定好,最大程度减少开发者的理解负担。
|
||||
|
||||
当然要补充一句,这并不意味着局限开发者的成长和学习空间,其它知识随时敞开大门,只是理解它们并不是日常开发所必要的,这些知识形成文档可以用完即弃,不用成为长期记忆。说到这,就引出了真实世界第二个有趣的地方,就是说明书。
|
||||
|
||||
### 真实世界的说明书
|
||||
|
||||
我回头想想也挺不可思议的,无论快递买来任何需要组装的东西,按照说明书的指引最终都可以组装好,而且装好之后就可以把说明书扔了,完全没有认知负担。
|
||||
|
||||
与其说快递包裹的说明书太完善了,不如说说明不完善,不好用的商品根本卖不出去。我们早已习惯极度易用的商品,及其详尽的说明书了,这是商业社会持续发展,长期博弈后的结果,而且会稳定持续下去。试想一下,如果我们参与维护的项目也有精巧的设计,完善的文档,那维护就不是什么问题,按照文档说的一步步来就行了。
|
||||
|
||||
那为什么大部分情况,我们接手的项目就像一个没有说明书的乐高呢?这应该是商品与代码的本质区别了,即商品质量好不好,是由买家用钞票投票的,做得好用,说明书完善的商品才能存活下来,但这背后的技术实现是看不到的,也没有人可以投票,即便技术人员吐槽代码无法维护,但如果项目取得了商业上的成功,也只会越做越大,技术债越滚越多。
|
||||
|
||||
技术项目的买家是程序员,但程序员没有拒签的办法,导致无论项目质量如何都要接受,没有市场机制的作用,就导致了烂代码随处可见。
|
||||
|
||||
要解决这个问题,首先要意识到这个问题,即技术项目质量本质上是无人长期、持续关心的,你可能会说,技术 Leader 会关心呀?但这和业务驱动相比实在是太弱了。产品有用户侧钞票的投票,无论管理者换多少人,还是会从源头持续提供动力,但项目质量总是要反复强调,间歇性整治,并且不同的 Leader 关心程度也不同,因为这背后没有源动力,除非项目质量影响到用户那头的现金供给了,但这种情况发生时,说明项目早已烂透了。
|
||||
|
||||
正是因为技术质量缺乏源动力,或者说源动力传导链路太长,我们才要人为的不断加强重视,重视文档、重视使用体验、重视是否符合设计模式。只有长期主义者才能坚持做代码质量治理,因为坚信总有一天,代码质量会影响到业务发展。
|
||||
|
||||
## 总结
|
||||
|
||||
这次从真实世界借鉴了一些经验到软件世界,我们从借鉴真实世界的屏蔽复杂度,谈到了为什么真实世界的说明书这么好用,但技术项目文档却总是缺胳膊少腿的问题。
|
||||
|
||||
我们总结出的经验是,设计原则与设计模式固然可以提升可维护性,但归根结底还是动力的问题,提升代码质量本身就是一件缺乏动力去做的事,或者长期被认为是重要不紧急的事,往往很难找出理由现在就去做,但没有人觉得不应该做。
|
||||
|
||||
所以想要提升可维护性,找到为什么现在,立刻,马上就要做技术优化的原因,并立即开始优化才是最重要的。
|
||||
|
||||
> 讨论地址是:[精读《可维护性思考》· Issue #359 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/359)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,569 @@
|
||||
ORM(Object relational mappers) 的含义是,将数据模型与 Object 建立强力的映射关系,这样我们对数据的增删改查可以转换为操作 Object(对象)。
|
||||
|
||||
Prisma 是一个现代 Nodejs ORM 库,根据 [Prisma 官方文档](https://www.prisma.io/docs/concepts/overview/what-is-prisma) 可以了解这个库是如何设计与使用的。
|
||||
|
||||
## 概述
|
||||
|
||||
Prisma 提供了大量工具,包括 Prisma Schema、Prisma Client、Prisma Migrate、Prisma CLI、Prisma Studio 等,其中最核心的两个是 Prisma Schema 与 Prisma Client,分别是描述应用数据模型与 Node 操作 API。
|
||||
|
||||
与一般 ORM 完全由 Class 描述数据模型不同,Primsa 采用了一个全新语法 Primsa Schema 描述数据模型,再执行 `prisma generate` 产生一个配置文件存储在 `node_modules/.prisma/client` 中,Node 代码里就可以使用 Prisma Client 对数据增删改查了。
|
||||
|
||||
### Prisma Schema
|
||||
|
||||
Primsa Schema 是在最大程度贴近数据库结构描述的基础上,对关联关系进行了进一步抽象,并且背后维护了与数据模型的对应关系,下图很好的说明了这一点:
|
||||
|
||||
<img width=400 src="https://z3.ax1x.com/2021/10/17/5YwZoF.png">
|
||||
|
||||
可以看到,几乎与数据库的定义一模一样,唯一多出来的 `posts` 与 `author` 其实是弥补了数据库表关联外键中不直观的部分,将这些外键转化为实体对象,让操作时感受不到外键或者多表的存在,在具体操作时再转化为 join 操作。下面是对应的 Prisma Schema:
|
||||
|
||||
```prisma
|
||||
datasource db {
|
||||
provider = "postgresql"
|
||||
url = env("DATABASE_URL")
|
||||
}
|
||||
|
||||
generator client {
|
||||
provider = "prisma-client-js"
|
||||
}
|
||||
|
||||
model Post {
|
||||
id Int @id @default(autoincrement())
|
||||
title String
|
||||
content String? @map("post_content")
|
||||
published Boolean @default(false)
|
||||
author User? @relation(fields: [authorId], references: [id])
|
||||
authorId Int?
|
||||
}
|
||||
|
||||
model User {
|
||||
id Int @id @default(autoincrement())
|
||||
email String @unique
|
||||
name String?
|
||||
posts Post[]
|
||||
}
|
||||
```
|
||||
|
||||
`datasource db` 申明了链接数据库信息;`generator client` 申明了使用 Prisma Client 进行客户端操作,也就是说 Prisma Client 其实是可以替换实现的;`model` 是最核心的模型定义。
|
||||
|
||||
在模型定义中,可以通过 `@map` 修改字段名映射、`@@map` 修改表名映射,默认情况下,字段名与 key 名相同:
|
||||
|
||||
```prisma
|
||||
model Comment {
|
||||
title @map("comment_title")
|
||||
|
||||
@@map("comments")
|
||||
}
|
||||
```
|
||||
|
||||
字段由下面四种描述组成:
|
||||
|
||||
- 字段名。
|
||||
- 字段类型。
|
||||
- 可选的类型修饰。
|
||||
- 可选的属性描述。
|
||||
|
||||
```prisma
|
||||
model Tag {
|
||||
name String? @id
|
||||
}
|
||||
```
|
||||
|
||||
在这个描述里,包含字段名 `name`、字段类型 `String`、类型修饰 `?`、属性描述 `@id`。
|
||||
|
||||
#### 字段类型
|
||||
|
||||
字段类型可以是 model,比如关联类型字段场景:
|
||||
|
||||
```prisma
|
||||
model Post {
|
||||
id Int @id @default(autoincrement())
|
||||
// Other fields
|
||||
comments Comment[] // A post can have many comments
|
||||
}
|
||||
|
||||
model Comment {
|
||||
id Int
|
||||
// Other fields
|
||||
Post Post? @relation(fields: [postId], references: [id]) // A comment can have one post
|
||||
postId Int?
|
||||
}
|
||||
```
|
||||
|
||||
关联场景有 1v1, nv1, 1vn, nvn 四种情况,字段类型可以为定义的 model 名称,并使用属性描述 `@relation` 定义关联关系,比如上面的例子,描述了 `Commenct` 与 `Post` 存在 nv1 关系,并且 `Comment.postId` 与 `Post.id` 关联。
|
||||
|
||||
字段类型还可以是底层数据类型,通过 `@db.` 描述,比如:
|
||||
|
||||
```prisma
|
||||
model Post {
|
||||
id @db.TinyInt(1)
|
||||
}
|
||||
```
|
||||
|
||||
对于 Prisma 不支持的类型,还可以使用 `Unsupported` 修饰:
|
||||
|
||||
```prisma
|
||||
model Post {
|
||||
someField Unsupported("polygon")?
|
||||
}
|
||||
```
|
||||
|
||||
这种类型的字段无法通过 ORM API 查询,但可以通过 `queryRaw` 方式查询。`queryRaw` 是一种 ORM 对原始 SQL 模式的支持,在 Prisma Client 会提到。
|
||||
|
||||
#### 类型修饰
|
||||
|
||||
类型修饰有 `?` `[]` 两种语法,比如:
|
||||
|
||||
```prisma
|
||||
model User {
|
||||
name String?
|
||||
posts Post[]
|
||||
}
|
||||
```
|
||||
|
||||
分别表示可选与数组。
|
||||
|
||||
#### 属性描述
|
||||
|
||||
属性描述有如下几种语法:
|
||||
|
||||
```prisma
|
||||
model User {
|
||||
id Int @id @default(autoincrement())
|
||||
isAdmin Boolean @default(false)
|
||||
email String @unique
|
||||
|
||||
@@unique([firstName, lastName])
|
||||
}
|
||||
```
|
||||
|
||||
`@id` 对应数据库的 PRIMARY KEY。
|
||||
|
||||
`@default` 设置字段默认值,可以联合函数使用,比如 `@default(autoincrement())`,可用函数包括 `autoincrement()`、`dbgenerated()`、`cuid()`、`uuid()`、`now()`,还可以通过 `dbgenerated` 直接调用数据库底层的函数,比如 `dbgenerated("gen_random_uuid()")`。
|
||||
|
||||
`@unique` 设置字段值唯一。
|
||||
|
||||
`@relation` 设置关联,上面已经提到过了。
|
||||
|
||||
`@map` 设置映射,上面也提到过了。
|
||||
|
||||
`@updatedAt` 修饰字段用来存储上次更新时间,一般是数据库自带的能力。
|
||||
|
||||
`@ignore` 对 Prisma 标记无效的字段。
|
||||
|
||||
所有属性描述都可以组合使用,并且还存在需对 model 级别的描述,一般用两个 `@` 描述,包括 `@@id`、`@@unique`、`@@index`、`@@map`、`@@ignore`。
|
||||
|
||||
#### ManyToMany
|
||||
|
||||
Prisma 在多对多关联关系的描述上也下了功夫,支持隐式关联描述:
|
||||
|
||||
```prisma
|
||||
model Post {
|
||||
id Int @id @default(autoincrement())
|
||||
categories Category[]
|
||||
}
|
||||
|
||||
model Category {
|
||||
id Int @id @default(autoincrement())
|
||||
posts Post[]
|
||||
}
|
||||
```
|
||||
|
||||
看上去很自然,但其实背后隐藏了不少实现。数据库多对多关系一般通过第三张表实现,第三张表会存储两张表之间外键对应关系,所以如果要显式定义其实是这样的:
|
||||
|
||||
```prisma
|
||||
model Post {
|
||||
id Int @id @default(autoincrement())
|
||||
categories CategoriesOnPosts[]
|
||||
}
|
||||
|
||||
model Category {
|
||||
id Int @id @default(autoincrement())
|
||||
posts CategoriesOnPosts[]
|
||||
}
|
||||
|
||||
model CategoriesOnPosts {
|
||||
post Post @relation(fields: [postId], references: [id])
|
||||
postId Int // relation scalar field (used in the `@relation` attribute above)
|
||||
category Category @relation(fields: [categoryId], references: [id])
|
||||
categoryId Int // relation scalar field (used in the `@relation` attribute above)
|
||||
assignedAt DateTime @default(now())
|
||||
assignedBy String
|
||||
|
||||
@@id([postId, categoryId])
|
||||
}
|
||||
```
|
||||
|
||||
背后生成如下 SQL:
|
||||
|
||||
```sql
|
||||
CREATE TABLE "Category" (
|
||||
id SERIAL PRIMARY KEY
|
||||
);
|
||||
CREATE TABLE "Post" (
|
||||
id SERIAL PRIMARY KEY
|
||||
);
|
||||
-- Relation table + indexes -------------------------------------------------------
|
||||
CREATE TABLE "CategoryToPost" (
|
||||
"categoryId" integer NOT NULL,
|
||||
"postId" integer NOT NULL,
|
||||
"assignedBy" text NOT NULL
|
||||
"assignedAt" timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP,
|
||||
FOREIGN KEY ("categoryId") REFERENCES "Category"(id),
|
||||
FOREIGN KEY ("postId") REFERENCES "Post"(id)
|
||||
);
|
||||
CREATE UNIQUE INDEX "CategoryToPost_category_post_unique" ON "CategoryToPost"("categoryId" int4_ops,"postId" int4_ops);
|
||||
```
|
||||
|
||||
### Prisma Client
|
||||
|
||||
描述好 Prisma Model 后,执行 `prisma generate`,再利用 `npm install @prisma/client` 安装好 Node 包后,就可以在代码里操作 ORM 了:
|
||||
|
||||
```typescript
|
||||
import { PrismaClient } from '@prisma/client'
|
||||
|
||||
const prisma = new PrismaClient()
|
||||
```
|
||||
|
||||
#### CRUD
|
||||
|
||||
使用 `create` 创建一条记录:
|
||||
|
||||
```typescript
|
||||
const user = await prisma.user.create({
|
||||
data: {
|
||||
email: 'elsa@prisma.io',
|
||||
name: 'Elsa Prisma',
|
||||
},
|
||||
})
|
||||
```
|
||||
|
||||
使用 `createMany` 创建多条记录:
|
||||
|
||||
```typescript
|
||||
const createMany = await prisma.user.createMany({
|
||||
data: [
|
||||
{ name: 'Bob', email: 'bob@prisma.io' },
|
||||
{ name: 'Bobo', email: 'bob@prisma.io' }, // Duplicate unique key!
|
||||
{ name: 'Yewande', email: 'yewande@prisma.io' },
|
||||
{ name: 'Angelique', email: 'angelique@prisma.io' },
|
||||
],
|
||||
skipDuplicates: true, // Skip 'Bobo'
|
||||
})
|
||||
```
|
||||
|
||||
使用 `findUnique` 查找单条记录:
|
||||
|
||||
```typescript
|
||||
const user = await prisma.user.findUnique({
|
||||
where: {
|
||||
email: 'elsa@prisma.io',
|
||||
},
|
||||
})
|
||||
```
|
||||
|
||||
对于联合索引的情况:
|
||||
|
||||
```prisma
|
||||
model TimePeriod {
|
||||
year Int
|
||||
quarter Int
|
||||
total Decimal
|
||||
|
||||
@@id([year, quarter])
|
||||
}
|
||||
```
|
||||
|
||||
需要再嵌套一层由 `_` 拼接的 key:
|
||||
|
||||
```typescript
|
||||
const timePeriod = await prisma.timePeriod.findUnique({
|
||||
where: {
|
||||
year_quarter: {
|
||||
quarter: 4,
|
||||
year: 2020,
|
||||
},
|
||||
},
|
||||
})
|
||||
```
|
||||
|
||||
使用 `findMany` 查询多条记录:
|
||||
|
||||
```typescript
|
||||
const users = await prisma.user.findMany()
|
||||
```
|
||||
|
||||
可以使用 SQL 中各种条件语句,语法如下:
|
||||
|
||||
```typescript
|
||||
const users = await prisma.user.findMany({
|
||||
where: {
|
||||
role: 'ADMIN',
|
||||
},
|
||||
include: {
|
||||
posts: true,
|
||||
},
|
||||
})
|
||||
```
|
||||
|
||||
使用 `update` 更新记录:
|
||||
|
||||
```typescript
|
||||
const updateUser = await prisma.user.update({
|
||||
where: {
|
||||
email: 'viola@prisma.io',
|
||||
},
|
||||
data: {
|
||||
name: 'Viola the Magnificent',
|
||||
},
|
||||
})
|
||||
```
|
||||
|
||||
使用 `updateMany` 更新多条记录:
|
||||
|
||||
```typescript
|
||||
const updateUsers = await prisma.user.updateMany({
|
||||
where: {
|
||||
email: {
|
||||
contains: 'prisma.io',
|
||||
},
|
||||
},
|
||||
data: {
|
||||
role: 'ADMIN',
|
||||
},
|
||||
})
|
||||
```
|
||||
|
||||
使用 `delete` 删除记录:
|
||||
|
||||
```typescript
|
||||
const deleteUser = await prisma.user.delete({
|
||||
where: {
|
||||
email: 'bert@prisma.io',
|
||||
},
|
||||
})
|
||||
```
|
||||
|
||||
使用 `deleteMany` 删除多条记录:
|
||||
|
||||
```typescript
|
||||
const deleteUsers = await prisma.user.deleteMany({
|
||||
where: {
|
||||
email: {
|
||||
contains: 'prisma.io',
|
||||
},
|
||||
},
|
||||
})
|
||||
```
|
||||
|
||||
使用 `include` 表示关联查询是否生效,比如:
|
||||
|
||||
```typescript
|
||||
const getUser = await prisma.user.findUnique({
|
||||
where: {
|
||||
id: 19,
|
||||
},
|
||||
include: {
|
||||
posts: true,
|
||||
},
|
||||
})
|
||||
```
|
||||
|
||||
这样就会在查询 `user` 表时,顺带查询所有关联的 `post` 表。关联查询也支持嵌套:
|
||||
|
||||
```typescript
|
||||
const user = await prisma.user.findMany({
|
||||
include: {
|
||||
posts: {
|
||||
include: {
|
||||
categories: true,
|
||||
},
|
||||
},
|
||||
},
|
||||
})
|
||||
```
|
||||
|
||||
筛选条件支持 `equals`、`not`、`in`、`notIn`、`lt`、`lte`、`gt`、`gte`、`contains`、`search`、`mode`、`startsWith`、`endsWith`、`AND`、`OR`、`NOT`,一般用法如下:
|
||||
|
||||
```typescript
|
||||
const result = await prisma.user.findMany({
|
||||
where: {
|
||||
name: {
|
||||
equals: 'Eleanor',
|
||||
},
|
||||
},
|
||||
})
|
||||
```
|
||||
|
||||
这个语句代替 sql 的 `where name="Eleanor"`,即通过对象嵌套的方式表达语义。
|
||||
|
||||
Prisma 也可以直接写原生 SQL:
|
||||
|
||||
```typescript
|
||||
const email = 'emelie@prisma.io'
|
||||
const result = await prisma.$queryRaw(
|
||||
Prisma.sql`SELECT * FROM User WHERE email = ${email}`
|
||||
)
|
||||
```
|
||||
|
||||
### 中间件
|
||||
|
||||
Prisma 支持中间件的方式在执行过程中进行拓展,看下面的例子:
|
||||
|
||||
```typescript
|
||||
const prisma = new PrismaClient()
|
||||
|
||||
// Middleware 1
|
||||
prisma.$use(async (params, next) => {
|
||||
console.log(params.args.data.title)
|
||||
console.log('1')
|
||||
const result = await next(params)
|
||||
console.log('6')
|
||||
return result
|
||||
})
|
||||
|
||||
// Middleware 2
|
||||
prisma.$use(async (params, next) => {
|
||||
console.log('2')
|
||||
const result = await next(params)
|
||||
console.log('5')
|
||||
return result
|
||||
})
|
||||
|
||||
// Middleware 3
|
||||
prisma.$use(async (params, next) => {
|
||||
console.log('3')
|
||||
const result = await next(params)
|
||||
console.log('4')
|
||||
return result
|
||||
})
|
||||
|
||||
const create = await prisma.post.create({
|
||||
data: {
|
||||
title: 'Welcome to Prisma Day 2020',
|
||||
},
|
||||
})
|
||||
|
||||
const create2 = await prisma.post.create({
|
||||
data: {
|
||||
title: 'How to Prisma!',
|
||||
},
|
||||
})
|
||||
```
|
||||
|
||||
输出如下:
|
||||
|
||||
```text
|
||||
Welcome to Prisma Day 2020
|
||||
1
|
||||
2
|
||||
3
|
||||
4
|
||||
5
|
||||
6
|
||||
How to Prisma!
|
||||
1
|
||||
2
|
||||
3
|
||||
4
|
||||
5
|
||||
6
|
||||
```
|
||||
|
||||
可以看到,中间件执行顺序是洋葱模型,并且每个操作都会触发。我们可以利用中间件拓展业务逻辑或者进行操作时间的打点记录。
|
||||
|
||||
## 精读
|
||||
|
||||
### ORM 的两种设计模式
|
||||
|
||||
ORM 有 Active Record 与 Data Mapper 两种设计模式,其中 Active Record 使对象背后完全对应 sql 查询,现在已经不怎么流行了,而 Data Mapper 模式中的对象并不知道数据库的存在,即中间多了一层映射,甚至背后不需要对应数据库,所以可以做一些很轻量的调试功能。
|
||||
|
||||
Prisma 采用了 Data Mapper 模式。
|
||||
|
||||
### ORM 容易引发性能问题
|
||||
|
||||
当数据量大,或者性能、资源敏感的情况下,我们需要对 SQL 进行优化,甚至我们需要对特定的 Mysql 的特定版本的某些内核错误,对 SQL 进行某些看似无意义的申明调优(比如在 where 之前再进行相同条件的 IN 范围限定),有的时候能取得惊人的性能提升。
|
||||
|
||||
而 ORM 是建立在一个较为理想化理论基础上的,即数据模型可以很好的转化为对象操作,然而对象操作由于屏蔽了细节,我们无法对 SQL 进行针对性调优。
|
||||
|
||||
另外,得益于对象操作的便利性,我们很容易通过 obj.obj. 的方式访问某些属性,但这背后生成的却是一系列未经优化(或者部分自动优化)的复杂 join sql,我们在写这些 sql 时会提前考虑性能因素,但通过对象调用时却因为成本低,或觉得 ORM 有 magic 优化等想法,写出很多实际上不合理的 sql。
|
||||
|
||||
### Prisma Schema 的好处
|
||||
|
||||
其实从语法上,Prisma Schema 与 Typeorm 基于 Class + 装饰器的拓展几乎可以等价转换,但 Prisma Schema 在实际使用中有一个很不错的优势,即减少样板代码以及稳定数据库模型。
|
||||
|
||||
减少样板代码比较好理解,因为 Prisma Schema 并不会出现在代码中,而稳定模型是指,只要不执行 `prisma generate`,数据模型就不会变化,而且 Prisma Schema 也独立于 Node 存在,甚至可以不放在项目源码中,相比之下,修改起来会更加慎重,而完全用 Node 定义的模型因为本身是代码的一部分,可能会突然被修改,而且也没有执行数据库结构同步的操作。
|
||||
|
||||
如果项目采用 Prisma,则模型变更后,可以执行 `prisma db pull` 更新数据库结构,再执行 `prisma generate` 更新客户端 API,这个流程比较清晰。
|
||||
|
||||
## 总结
|
||||
|
||||
Prisma Schema 是 Prisma 的一大特色,因为这部分描述独立于代码,带来了如下几个好处:
|
||||
|
||||
1. 定义比 Node Class 更简洁。
|
||||
2. 不生成冗余的代码结构。
|
||||
3. Prisma Client 更加轻量,且查询返回的都是 Pure Object。
|
||||
|
||||
至于 Prisma Client 的 API 设计其实并没有特别突出之处,无论与 [sequelize](https://sequelize.org/master/) 还是 [typeorm](https://typeorm.io/#/) 的 API 设计相比,都没有太大的优化,只是风格不同。
|
||||
|
||||
不过对于记录的创建,我更喜欢 Prisma 的 API:
|
||||
|
||||
```typescript
|
||||
// typeorm - save API
|
||||
const userRepository = getManager().getRepository(User)
|
||||
const newUser = new User()
|
||||
newUser.name = 'Alice'
|
||||
userRepository.save(newUser)
|
||||
|
||||
// typeorm - insert API
|
||||
const userRepository = getManager().getRepository(User)
|
||||
userRepository.insert({
|
||||
name: 'Alice',
|
||||
})
|
||||
|
||||
// sequelize
|
||||
const user = User.build({
|
||||
name: 'Alice',
|
||||
})
|
||||
await user.save()
|
||||
|
||||
// Mongoose
|
||||
const user = await User.create({
|
||||
name: 'Alice',
|
||||
email: 'alice@prisma.io',
|
||||
})
|
||||
|
||||
// prisma
|
||||
const newUser = await prisma.user.create({
|
||||
data: {
|
||||
name: 'Alice',
|
||||
},
|
||||
})
|
||||
```
|
||||
|
||||
首先存在 `prisma` 这个顶层变量,使用起来会非常方便,另外从 API 拓展上来说,虽然 Mongoose 设计得更简洁,但添加一些条件时拓展性会不足,导致结构不太稳定,不利于统一记忆。
|
||||
|
||||
Prisma Client 的 API 统一采用下面这种结构:
|
||||
|
||||
```typescript
|
||||
await prisma.modelName.operateName({
|
||||
// 数据,比如 create、update 时会用到
|
||||
data: /** ... */,
|
||||
// 条件,大部分情况都可以用到
|
||||
where: /** ... */,
|
||||
// 其它特殊参数,或者 operater 特有的参数
|
||||
})
|
||||
```
|
||||
|
||||
所以总的来说,Prisma 虽然没有对 ORM 做出革命性改变,但在微创新与 API 优化上都做得足够棒,github 更新也比较活跃,如果你决定使用 ORM 开发项目,还是比较推荐 Prisma 的。
|
||||
|
||||
在实际使用中,为了规避 ORM 产生笨拙 sql 导致的性能问题,可以利用 Prisma Middleware 监控查询性能,并对性能较差的地方采用 `prisma.$queryRaw` 原生 sql 查询。
|
||||
|
||||
> 讨论地址是:[精读《Prisma 的使用》· Issue #362 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/362)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -78,7 +78,7 @@ ES 模块需要借助模块加载器来实现这三步。加载器在不同的
|
||||
|
||||
这就意味着我们必须一层一层的遍历文件树,转化文件并找出依赖,最后查找并且加载这些依赖。如果主线程正在等待去下载这些文件,那么很多的任务会堆积在队列中。这是因为浏览器环境下下载用了很长时间。
|
||||
|
||||
阻塞主线程会导致应用所需的模块变得很慢。将构建过程分片进行实现了在全部下载前进行获取和构建。这种查分构建的方式是 ES 模块和 CJS 模块最本质的不同。
|
||||
阻塞主线程会导致应用所需的模块变得很慢。将构建过程分片进行实现了在全部下载前进行获取和构建。这种差分构建的方式是 ES 模块和 CJS 模块最本质的不同。
|
||||
|
||||
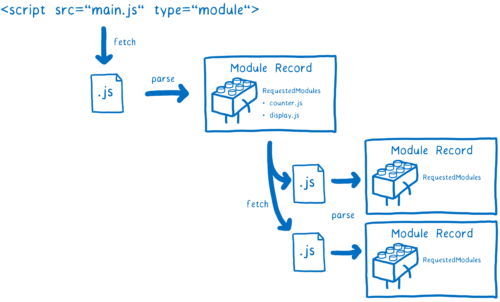
|
||||
|
||||
|
||||
@@ -41,7 +41,7 @@
|
||||
|
||||
**也就是学习技术细节是没有技术门槛,随着年龄的增加,如果只累积了大家都能学会的内容,那么当旧知识被淘汰后,学习新知识的速度又不如年轻人快,会逐渐失去经验优势。**
|
||||
|
||||
那么如何利用无门槛的特征,将其变为门槛呢?那就是任何年龄段学习技术细节都很容易,在你需要深入细节的时候再深入进去,不需要深入的时候把时间花在了解宏观架构上。
|
||||
那么如何利用无门槛的特征,将其变为门槛呢?任何年龄段学习技术细节都很容易,应该在你需要深入细节的时候再深入进去,不需要深入的时候把时间花在了解宏观架构上。
|
||||
|
||||
就是培养高效的学习能力,能准确判断某个技术细节是否有必要掌握,如需要该如何快速掌握核心内容,并在掌握之后不留恋,可以快速抽身出来继续全局性思考。这种思维是有门槛的,技术专家都可以做到这一点。
|
||||
|
||||
@@ -53,7 +53,7 @@
|
||||
|
||||
这要看怎么理解业务与技术的关系,比如建设 “数据联邦”,光是了解各个不同的存储系统技术细节可能就要花很久,而实际上是没必要将所有技术细节都弄懂的,只要定好一个通用交互规范,各存储系统各自封装一套符合这个规范的交互接口即可。
|
||||
|
||||
做成事往往需要宏观的技术思维,需要将许多技术点链接在一起。举个例子,做成事就类似于军官指挥作战,做成的目的是通过制定打法赢得战争,而不是自己冲锋陷阵并测量敌人壕沟的宽度。关心技术细节只最终落实到每个人具体实施项中的一部分,技术细节的目标累加起来才是做成事。
|
||||
做成事往往需要宏观的技术思维,需要将许多技术点链接在一起。举个例子,做成事就类似于军官指挥作战,做成的目的是通过制定打法赢得战争,而不是自己冲锋陷阵并测量敌人壕沟的宽度。关心技术细节只是最终落实到每个人具体实施项中的一部分,技术细节的目标累加起来才能做成事。
|
||||
|
||||
## 2.2 搞清楚业务对技术的真实诉求
|
||||
|
||||
@@ -63,7 +63,7 @@
|
||||
|
||||
拥有技术思维的人,容易沉迷于解决不切实际的问题,或者是别人解决过的问题。这种思维对技术学习是非常有帮助的,但如果长期不能转变这种思维,对公司来说是无法创造什么价值的。
|
||||
|
||||
拥有业务思维的人,首先要懂业务,只有懂业务,跟着对的业务,才能对未来又信心,知道自己的付出可以换来回报。
|
||||
拥有业务思维的人,首先要懂业务,只有懂业务,跟着对的业务,才能对未来有信心,知道自己的付出可以换来回报。
|
||||
|
||||
懂业务后,才知道如何通过技术帮助业务获得成功。
|
||||
|
||||
@@ -83,7 +83,7 @@
|
||||
|
||||
现在技术点越来越多,如果什么技术细节都要详细了解,最终一定不能有很好的全局视野。比较好的状态是找几个重点深入了解,其他的技术点在掌握了全局技术视野后再考虑深入。
|
||||
|
||||
在互联网初期,很多技术框架还不完善时,技术借力的意义不大,毕竟也没有多少东西可用。
|
||||
在互联网初期,很多技术框架还不完善,技术借力的意义不大,毕竟也没有多少东西可用。
|
||||
|
||||
但是现在无论前端还是后端的技术、轮子已经眼花缭乱了,能掌握这些已有技术的人,价值已经逐渐大于会完整了解某些技术细节的人。一个优秀的专家应该能快速定位要解决的业务问题是否有成熟的技术方案,如何以最小的投入产出比实现,同时保持良好的维护性应变业务维护。
|
||||
|
||||
|
||||
Reference in New Issue
Block a user