Compare commits
| Author | SHA1 | Date | |
|---|---|---|---|
 ascoders |
509dfe2c97 | ||
|
ascoders
|
806ee0177a | ||
|
ascoders
|
fe4afdf89c | ||
|
ascoders
|
caec16066a | ||
|
ascoders
|
7f53bde9a3 | ||
|
ascoders
|
63e2ca4d0d | ||
|
黄子毅
|
9dbd1fb7b9 | ||
|
黄子毅
|
7d8816c2c2 | ||
|
黄子毅
|
44ae420f52 | ||
|
mr_left
|
683b22d1ae | ||
|
mr_left
|
4e58379585 | ||
|
mr_left
|
1342144fef | ||
|
ascoders
|
a41f452df0 |
@@ -214,7 +214,7 @@ class Component extends React.PureComponent<Props, State> {
|
||||
this.rootDom = ReactDOM.findDOMNode(this.rootDomRef) as HTMLDivElement;
|
||||
|
||||
this.chart = new G2.Chart({
|
||||
container: document.getElementById("chart"),
|
||||
container: this.rootDom,
|
||||
forceFit: true,
|
||||
height: 300
|
||||
});
|
||||
|
||||
@@ -259,7 +259,7 @@ const { loading, error, result } = useAsync(fetchUser, [id]);
|
||||
实现:在 Promise 的初期设置 loading,结束后设置 result,如果出错则设置 error,这里可以将请求对象包装成 `useAsyncState` 来处理,这里就不放出来了。
|
||||
|
||||
```tsx
|
||||
export function useAsync(asyncFunction) {
|
||||
export function useAsync(asyncFunction: any, params: any[]) {
|
||||
const asyncState = useAsyncState(options);
|
||||
|
||||
useEffect(() => {
|
||||
@@ -326,8 +326,8 @@ const fetchUser = id =>
|
||||
});
|
||||
|
||||
function useFetchUser(id) {
|
||||
const asyncFetchUser = useAsync(fetchUser, id);
|
||||
return asyncUser;
|
||||
const asyncFetchUser = useAsync(fetchUser, [id]);
|
||||
return asyncFetchUser;
|
||||
}
|
||||
```
|
||||
|
||||
|
||||
@@ -813,25 +813,30 @@ function Parent() {
|
||||
换一个例子就可以看得更清楚:
|
||||
|
||||
```js
|
||||
function Parent() {
|
||||
function Parent(props) {
|
||||
const [count, setCount] = useState(0);
|
||||
const [step, setStep] = useState(0);
|
||||
const [other, setOther] = useState(0);
|
||||
const drag = useDraggable(count, step); // 封装了拖拽函数
|
||||
const drag = useDraggable(props.dom, count, step); // 封装了拖拽函数
|
||||
|
||||
useEffect(() => {
|
||||
// dom 变化时重新实例化
|
||||
drag()
|
||||
}, [drag])
|
||||
}
|
||||
```
|
||||
|
||||
假设我们使用 [Sortablejs](https://github.com/SortableJS/Sortable) 对某个区域进行拖拽监听,这个函数每次都重复执行的性能损耗非常大,**然而这个函数内部可能因为仅仅要上报一些日志,所以依赖了没有实际被使用的 `count` `step` 变量:**
|
||||
|
||||
```js
|
||||
function useDraggable(count, step) {
|
||||
function useDraggable(dom, count, step) {
|
||||
return useCallback(() => {
|
||||
// 上报日志
|
||||
report(count, step);
|
||||
|
||||
// 对区域进行初始化,非常耗时
|
||||
// ... 省略耗时代码
|
||||
}, [count, step]);
|
||||
}, [dom, count, step]);
|
||||
}
|
||||
```
|
||||
|
||||
@@ -1130,7 +1135,7 @@ const Step = () => {
|
||||
一个普通的 Redux 组件:
|
||||
|
||||
```js
|
||||
const mapStateToProps = state => (count: state.count);
|
||||
const mapStateToProps = state => ({count: state.count});
|
||||
|
||||
const mapDispatchToProps = dispatch => dispatch;
|
||||
|
||||
|
||||
@@ -0,0 +1,290 @@
|
||||
## 简介
|
||||
|
||||
React 16.8 于 2019.2 正式发布,这是一个能提升代码质量和开发效率的特性,笔者就抛砖引玉先列出一些实践点,希望得到大家进一步讨论。
|
||||
|
||||
然而需要理解的是,没有一个完美的最佳实践规范,对一个高效团队来说,稳定的规范比合理的规范更重要,因此这套方案只是最佳实践之一。
|
||||
|
||||
## 精读
|
||||
|
||||
### 环境要求
|
||||
|
||||
- 拥有较为稳定且理解函数式编程的前端团队。
|
||||
- 开启 ESLint 插件:[eslint-plugin-react-hooks](https://www.npmjs.com/package/eslint-plugin-react-hooks)。
|
||||
|
||||
### 组件定义
|
||||
|
||||
Function Component 采用 `const` + 箭头函数方式定义:
|
||||
|
||||
```tsx
|
||||
const App: React.FC<{ title: string }> = ({ title }) => {
|
||||
return React.useMemo(() => <div>{title}</div>, [title]);
|
||||
};
|
||||
|
||||
App.defaultProps = {
|
||||
title: 'Function Component'
|
||||
}
|
||||
```
|
||||
|
||||
上面的例子包含了:
|
||||
|
||||
1. 用 `React.FC` 申明 Function Component 组件类型与定义 Props 参数类型。
|
||||
2. 用 `React.useMemo` 优化渲染性能。
|
||||
3. 用 `App.defaultProps` 定义 Props 的默认值。
|
||||
|
||||
#### FAQ
|
||||
|
||||
> 为什么不用 React.memo?
|
||||
|
||||
推荐使用 `React.useMemo` 而不是 `React.memo`,因为在组件通信时存在 `React.useContext` 的用法,这种用法会使所有用到的组件重渲染,只有 `React.useMemo` 能处理这种场景的按需渲染。
|
||||
|
||||
> 没有性能问题的组件也要使用 useMemo 吗?
|
||||
|
||||
要,考虑未来维护这个组件的时候,随时可能会通过 `useContext` 等注入一些数据,这时候谁会想起来添加 `useMemo` 呢?
|
||||
|
||||
> 为什么不用解构方式代替 defaultProps?
|
||||
|
||||
虽然解构方式书写 `defaultProps` 更优雅,但存在一个硬伤:对于对象类型每次 Rerender 时引用都会变化,这会带来性能问题,因此不要这么做。
|
||||
|
||||
### 局部状态
|
||||
|
||||
局部状态有三种,根据常用程度依次排列: `useState` `useRef` `useReducer` 。
|
||||
|
||||
#### useState
|
||||
|
||||
```tsx
|
||||
const [hide, setHide] = React.useState(false);
|
||||
const [name, setName] = React.useState('BI');
|
||||
```
|
||||
|
||||
状态函数名要表意,尽量聚集在一起申明,方便查阅。
|
||||
|
||||
#### useRef
|
||||
|
||||
```tsx
|
||||
const dom = React.useRef(null);
|
||||
```
|
||||
|
||||
`useRef` 尽量少用,大量 Mutable 的数据会影响代码的可维护性。
|
||||
|
||||
但对于不需重复初始化的对象推荐使用 `useRef` 存储,比如 `new G2()` 。
|
||||
|
||||
#### useReducer
|
||||
|
||||
局部状态不推荐使用 `useReducer` ,会导致函数内部状态过于复杂,难以阅读。 `useReducer` 建议在多组件间通信时,结合 `useContext` 一起使用。
|
||||
|
||||
#### FAQ
|
||||
|
||||
> 可以在函数内直接申明普通常量或普通函数吗?
|
||||
|
||||
不可以,Function Component 每次渲染都会重新执行,常量推荐放到函数外层避免性能问题,函数推荐使用 `useCallback` 申明。
|
||||
|
||||
### 函数
|
||||
|
||||
所有 Function Component 内函数必须用 `React.useCallback` 包裹,以保证准确性与性能。
|
||||
|
||||
```tsx
|
||||
const [hide, setHide] = React.useState(false);
|
||||
|
||||
const handleClick = React.useCallback(() => {
|
||||
setHide(isHide => !isHide)
|
||||
}, [])
|
||||
```
|
||||
|
||||
`useCallback` 第二个参数必须写,[eslint-plugin-react-hooks](https://www.npmjs.com/package/eslint-plugin-react-hooks) 插件会自动填写依赖项。
|
||||
|
||||
### 发请求
|
||||
|
||||
发请求分为操作型发请求与渲染型发请求。
|
||||
|
||||
#### 操作型发请求
|
||||
|
||||
操作型发请求,作为回调函数:
|
||||
|
||||
```tsx
|
||||
return React.useMemo(() => {
|
||||
return (
|
||||
<div onClick={requestService.addList} />
|
||||
)
|
||||
}, [requestService.addList])
|
||||
```
|
||||
|
||||
#### 渲染型发请求
|
||||
|
||||
渲染型发请求在 `useAsync` 中进行,比如刷新列表页,获取基础信息,或者进行搜索, **都可以抽象为依赖了某些变量,当这些变量变化时要重新取数** :
|
||||
|
||||
```tsx
|
||||
const { loading, error, value } = useAsync(async () => {
|
||||
return requestService.freshList(id);
|
||||
}, [requestService.freshList, id]);
|
||||
```
|
||||
|
||||
### 组件间通信
|
||||
|
||||
简单的组件间通信使用透传 Props 变量的方式,而频繁组件间通信使用 `React.useContext` 。
|
||||
|
||||
以一个复杂大组件为例,如果组件内部拆分了很多模块, **但需要共享很多内部状态** ,最佳实践如下:
|
||||
|
||||
#### 定义组件内共享状态 - store.ts
|
||||
|
||||
```tsx
|
||||
export const StoreContext = React.createContext<{
|
||||
state: State;
|
||||
dispatch: React.Dispatch<Action>;
|
||||
}>(null)
|
||||
|
||||
export interface State {};
|
||||
|
||||
export interface Action { type: 'xxx' } | { type: 'yyy' };
|
||||
|
||||
export const initState: State = {};
|
||||
|
||||
export const reducer: React.Reducer<State, Action> = (state, action) => {
|
||||
switch (action.type) {
|
||||
default:
|
||||
return state;
|
||||
}
|
||||
};
|
||||
```
|
||||
|
||||
#### 根组件注入共享状态 - main.ts
|
||||
|
||||
```tsx
|
||||
import { StoreContext, reducer, initState } from './store'
|
||||
|
||||
const AppProvider: React.FC = props => {
|
||||
const [state, dispatch] = React.useReducer(reducer, initState);
|
||||
|
||||
return React.useMemo(() => (
|
||||
<StoreContext.Provider value={{ state, dispatch }}>
|
||||
<App />
|
||||
</StoreContext.Provider>
|
||||
), [state, dispatch])
|
||||
};
|
||||
```
|
||||
|
||||
#### 任意子组件访问/修改共享状态 - child.ts
|
||||
|
||||
```tsx
|
||||
import { StoreContext } from './store'
|
||||
|
||||
const app: React.FC = () => {
|
||||
const { state, dispatch } = React.useContext(StoreContext);
|
||||
|
||||
return React.useMemo(() => (
|
||||
<div>{state.name}</div>
|
||||
), [state.name])
|
||||
};
|
||||
```
|
||||
|
||||
如上解决了 **多个联系紧密组件模块间便捷共享状态的问题** ,但有时也会遇到需要共享根组件 Props 的问题,**这种不可修改的状态不适合一并塞到 `StoreContext` 里**,我们新建一个 `PropsContext` 注入根组件的 Props:
|
||||
|
||||
```tsx
|
||||
const PropsContext = React.createContext<Props>(null)
|
||||
|
||||
const AppProvider: React.FC<Props> = props => {
|
||||
return React.useMemo(() => (
|
||||
<PropsContext.Provider value={props}>
|
||||
<App />
|
||||
</PropsContext.Provider>
|
||||
), [props])
|
||||
};
|
||||
```
|
||||
|
||||
#### 结合项目数据流
|
||||
|
||||
参考 [react-redux hooks](https://github.com/reduxjs/react-redux/blob/master/docs/api/hooks.md)。
|
||||
|
||||
### debounce 优化
|
||||
|
||||
比如当输入框频繁输入时,为了保证页面流畅,我们会选择在 `onChange` 时进行 `debounce` 。然而在 Function Component 领域中,我们有更优雅的方式实现。
|
||||
|
||||
> 其实在 Input 组件 `onChange` 使用 `debounce` 有一个问题,就是当 Input 组件 **受控** 时, `debounce` 的值不能及时回填,导致甚至无法输入的问题。
|
||||
|
||||
我们站在 Function Component 思维模式下思考这个问题:
|
||||
|
||||
1. React [scheduling](https://github.com/dt-fe/weekly/blob/v2/099.%E7%B2%BE%E8%AF%BB%E3%80%8AScheduling%20in%20React%E3%80%8B.md) 通过智能调度系统优化渲染优先级,我们其实不用担心频繁变更状态会导致性能问题。
|
||||
2. 如果联动一个文本还觉得慢吗? `onChange` 本不慢,大部分使用值的组件也不慢,没有必要从 `onChange` 源头开始就 `debounce` 。
|
||||
3. 找到渲染性能最慢的组件(比如 iframe 组件),**对一些频繁导致其渲染的入参进行 `useDebounce`** 。
|
||||
|
||||
下面是一个性能很差的组件,引用了变化频繁的 `text` (这个 `text` 可能是 `onChange` 触发改变的),我们利用 `useDebounce` 将其变更的频率慢下来即可:
|
||||
|
||||
```typescript
|
||||
const App: React.FC = ({ text }) => {
|
||||
// 无论 text 变化多快,textDebounce 最多 1 秒修改一次
|
||||
const textDebounce = useDebounce(text, 1000)
|
||||
|
||||
return useMemo(() => {
|
||||
// 使用 textDebounce,但渲染速度很慢的一堆代码
|
||||
}, [textDebounce])
|
||||
};
|
||||
```
|
||||
|
||||
使用 `textDebounce` 替代 `text` 可以将渲染频率控制在我们指定的范围内。
|
||||
|
||||
### useEffect 注意事项
|
||||
|
||||
事实上,`useEffect` 是最为怪异的 Hook,也是最难使用的 Hook。比如下面这段代码:
|
||||
|
||||
```tsx
|
||||
useEffect(() => {
|
||||
props.onChange(props.id)
|
||||
}, [props.onChange, props.id])
|
||||
```
|
||||
|
||||
如果 `id` 变化,则调用 `onChange`。但如果上层代码并没有对 `onChange` 进行合理的封装,导致每次刷新引用都会变动,则会产生严重后果。我们假设父级代码是这么写的:
|
||||
|
||||
```tsx
|
||||
class App {
|
||||
render() {
|
||||
return <Child id={this.state.id} onChange={id => this.setState({ id })} />
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
这样会导致死循环。虽然看上去 `<App>` 只是将更新 id 的时机交给了子元素 `<Child>`,但由于 `onChange` 函数在每次渲染时都会重新生成,因此引用总是在变化,就会出现一个无限死循环:
|
||||
|
||||
新 `onChange` -> `useEffect` 依赖更新 -> `props.onChange` -> 父级重渲染 -> 新 `onChange`...
|
||||
|
||||
想要阻止这个循环的发生,只要改为 `onChange={this.handleChange}` 即可,**`useEffect` 对外部依赖苛刻的要求,只有在整体项目都注意保持正确的引用时才能优雅生效。**
|
||||
|
||||
然而被调用处代码怎么写并不受我们控制,这就导致了不规范的父元素可能导致 React Hooks 产生死循环。
|
||||
|
||||
因此在使用 `useEffect` 时要注意调试上下文,注意父级传递的参数引用是否正确,如果引用传递不正确,有两种做法:
|
||||
|
||||
1. 使用 [useDeepCompareEffect](https://github.com/streamich/react-use/blob/master/docs/useDeepCompareEffect.md) 对依赖进行深比较。
|
||||
2. 使用 `useCurrentValue` 对引用总是变化的 props 进行包装:
|
||||
|
||||
```tsx
|
||||
function useCurrentValue<T>(value: T): React.RefObject<T> {
|
||||
const ref = React.useRef(null);
|
||||
ref.current = value;
|
||||
return ref;
|
||||
}
|
||||
|
||||
const App: React.FC = ({ onChange }) => {
|
||||
const onChangeCurrent = useCurrentValue(onChange)
|
||||
};
|
||||
```
|
||||
|
||||
`onChangeCurrent` 的引用保持不变,但每次都会指向最新的 `props.onChange`,从而可以规避这个问题。
|
||||
|
||||
## 总结
|
||||
|
||||
如果还有补充,欢迎在文末讨论。
|
||||
|
||||
如需了解 Function Component 或 Hooks 基础用法,可以参考往期精读:
|
||||
|
||||
- [精读《React Hooks》](https://github.com/dt-fe/weekly/blob/v2/079.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20Hooks%E3%80%8B.md)
|
||||
- [精读《怎么用 React Hooks 造轮子》](https://github.com/dt-fe/weekly/blob/v2/080.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%80%8E%E4%B9%88%E7%94%A8%20React%20Hooks%20%E9%80%A0%E8%BD%AE%E5%AD%90%E3%80%8B.md)
|
||||
- [精读《useEffect 完全指南》](https://github.com/dt-fe/weekly/blob/v2/096.%E7%B2%BE%E8%AF%BB%E3%80%8AuseEffect%20%E5%AE%8C%E5%85%A8%E6%8C%87%E5%8D%97%E3%80%8B.md)
|
||||
- [精读《Function Component 入门》](https://github.com/dt-fe/weekly/blob/v2/104.精读《Function%20Component%20入门》.md)
|
||||
|
||||
> 讨论地址是:[精读《React Hooks 最佳实践》 · Issue #202 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/202)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,175 @@
|
||||
## 简介
|
||||
|
||||
商业智能(Business Intelligence)简称 BI,即通过数据挖掘与分析找到商业洞察,助力商业成功。
|
||||
|
||||
一个完整的 BI 链路包含数据采集、数据清洗、数据挖掘、数据展现,其本质是对数据进行多维分析。前端的主要工作在数据展现环节,由于展示方式繁多、分析模型复杂且数据量大,前端环节的复杂度很高。
|
||||
|
||||
在 BI 做前端非常有挑战,开发者需要充分理解数据概念,而本身复杂度较高的可视化建站也只是 BI 的基础能力,想要建设 BI 的上层能力,比如探索式分析和数据洞察,都需要在前后端引入更复杂的计算模型。
|
||||
|
||||
本文作为一个引子,简单介绍笔者做 BI 的经验,后面如果有机会再写一个系列文章对细节进行阐述。
|
||||
|
||||
## 精读
|
||||
|
||||
国内目前处于 BI 1.0 阶段,也就是报表阶段,因此笔者将阐述这个阶段 BI 的核心开发概念。
|
||||
|
||||
> BI 2.0 探索式分析阶段是国内数据分析最前沿领域,这部分等开发完成后再分享。
|
||||
|
||||
BI 1.0 阶段的核心概念包括 **数据集、渲染引擎、数据模型、可视化** 这四个技术模块。
|
||||
|
||||
### 数据集
|
||||
|
||||
数据集即数据的集合,在 BI 领域更多指一种标准化的数据结构。
|
||||
|
||||
任何数据都可以封装成数据集,比如 txt 文本、excel、mysql 数据库等等。
|
||||
|
||||
数据集的基本形态是二维表格,列头表示字段,每一行就是一份数据,数据展示就是通过对这些数据字段进行多维度分析。
|
||||
|
||||
#### 数据集导入
|
||||
|
||||
一般来说数据集导入有两种方式,分别是本地文件上传与数据库链接。本地文件上传又分为多种文件类型处理,比如对 excel 的解析,可能还包括数据清洗;数据库链接分析可视化导入与 SQL 输入。
|
||||
|
||||
可视化导入需要提前对数据库进行结构分析,绘制出表结构与字段结构,不用理解 SQL 也可以进行可视化操作。
|
||||
|
||||
SQL 输入可以利用 [monaco-editor](https://github.com/microsoft/monaco-editor) 等 web 代码编辑器作为输入框,最好能结合智能提示提高 sql 编写效率。sql 智能提示可以参考往期精读 [精读《手写 SQL 编译器 - 智能提示》](https://github.com/dt-fe/weekly/blob/v2/085.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E6%99%BA%E8%83%BD%E6%8F%90%E7%A4%BA%E3%80%8B.md)。
|
||||
|
||||
#### 数据集建模
|
||||
|
||||
数据集建模一般包含 **维度度量建模、字段配置、层系建模**。
|
||||
|
||||
维度度量建模需要智能分析出字段属于维度还是度量,一般会结合字段实际的值或者字段名来智能判断字段类型,如果数据库信息中已存储了字段类型,就可以 100% 准确归类。
|
||||
|
||||
字段配置即对字段进行增删或修改,还可以新增聚合字段或对比字段。
|
||||
|
||||
聚合字段是指将一个字段表达式封装为一个新字段,这里也会用到一个简单的 sql 编辑器,只需要支持四则运算、字段提示、以及一些基本函数的组合即可。
|
||||
|
||||
对比字段是指新增的字段是基于已有字段在某个时间周期内的对比,比如对 UV 字段的年同比就可以封装为一个对比字段。对比字段在前端技术上没有什么难度,仅需理解概念即可。
|
||||
|
||||
### 渲染引擎
|
||||
|
||||
渲染引擎包括了对报表进行编辑与渲染的引擎,理论上可以合二为一。
|
||||
|
||||
渲染引擎的重要模块包括:画布拖拽、组件编辑、事件中心。
|
||||
|
||||
画布拖拽其实包含了组件自定义开发流程,到 CDN 发布、CDN 加载、组件拖拽、画布排版等一系列技术点,每个点展开都有写不完的细节,但好在这套功能属于通用建站基础功能点,本文就不再赘述。
|
||||
|
||||
组件编辑中,基本属性的编辑与属于通用建站领域的表单模型范畴,一般通过 UISchema 来描述通用表单,这块也不再赘述。组件编辑的另一部分就是数据编辑,这部分在后面数据模型章节里详细讲。
|
||||
|
||||
事件中心是渲染引擎部分,此功能在编辑状态需要禁用。这个功能可以实现图表联动、上卷下钻等数据能力。一个通用事件中心一般包括 **事件触发** 与 **事件响应** 两部分,基本结构如下:
|
||||
|
||||
```typescript
|
||||
interface Event {
|
||||
trigger:
|
||||
| {
|
||||
type: 'callback';
|
||||
callbackName: string;
|
||||
}
|
||||
| {
|
||||
type: 'listener';
|
||||
eventName: string;
|
||||
}
|
||||
| {
|
||||
type: 'system';
|
||||
name: string;
|
||||
};
|
||||
|
||||
action:
|
||||
| {
|
||||
type: 'dispatch';
|
||||
eventName: string;
|
||||
}
|
||||
| {
|
||||
type: 'jumpUrl';
|
||||
url: string;
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
`trigger` 即事件触发,包括基本的系统事件 `system`,比如定时器或者初始化自动触发;组件的回调 `callback` 比如当按钮被点击时;事件监听 `listener` 比如另一个事件被触发时,这个事件可能来自于 `action`。
|
||||
|
||||
`action` 即事件响应,包括基本的事件触发 `dispatch`,可以触发其他事件,可以构成一个事件链路;其他的 `action` 就是数据相关,可以用来做条件联动、字段联动、数据集联动等等,因为实现各异这里不做介绍。
|
||||
|
||||
事件机制还需要支持值传递,即事件触发源的值可以传递到事件响应方。值传递可以在触发源内部进行,比如当触发源是回调函数时,函数参数就自然作为值传递过去,触发源通过 `...args` 方式接收。
|
||||
|
||||
#### 数据钻取
|
||||
|
||||
配置了层系的字段都可以进行数据钻取。层系可以在数据集配置,也可以在报表编辑页配置,可以理解为一个顺序有关的文件夹,将文件夹作为字段使用时,默认生效的是第一个子元素,之后可以按照顺序分别进行下钻。
|
||||
|
||||
比如 “地区” 层系包含了国家、省、市、区,那么就可以按照这个层级进行数据上卷下钻。
|
||||
|
||||
如果一个字段是层系字段,图表需要有对应的操作区域进行上卷下钻,数据编辑区域也可以进行同样操作。数据钻取的计算过程不在图表内部处理,而是触发一个状态后,由渲染引擎将这个层系字段实例状态改为下钻到第 N 层,并且每下钻一次就多拿到一列的数据,由图表组件进行下钻展示。
|
||||
|
||||
一般来说下钻后数据仍是全量的,有时候为了避免数据量过大,比如在柱状图点击某个柱子进行下钻,只想看这个柱子下钻后的数据:比如 2017、2018、2019 年三年的数据,下钻到月后数据量是 3 x 12 = 36 条,但如果仅在 2019 年进行下钻,只想看 2019 年的 12 条数据,可以转化为下钻 + 筛选条件的模式:全局下钻展开后 36 条,在 2019 年上点击下钻后,增加一个筛选条件(年 = 2019),这样就达到了效果,整个流程对图表组件是无感知的。
|
||||
|
||||
### 数据模型
|
||||
|
||||
与通用表单模型 UISchema 相对应,数据模型笔者称之为 CubeSchema,因为 BI 领域对数据的多维处理模型成为 Cube 立方体,数据配置即表示如何对这个立方体进行查询,因此其配置表单成为 CubeSchema。
|
||||
|
||||
不管是探索式分析还是 BI 1.0 的报表阶段,数据模型的基本概念是通用的(探索式分析固定了行列,且增加了标记):将字段放置到不同的区域,这些区域的划分方式可以按照功能:横轴、纵轴;按照概念:维度、度量;按照探索分析思路:固化为行、列等等。
|
||||
|
||||
这块可能涉及到的技术点有:拖拽、批量选择+拖拽、双击后按照维度度量自动添加、图表切换后区域字段自动迁移、对字段拖拽的系列配置:限制数量、限制类型、限制数据集、是否重复等等。
|
||||
|
||||
拖拽可以用 [react-beautiful-dnd](https://github.com/atlassian/react-beautiful-dnd) 等库,与渲染引擎拖拽方案基本类似,遇到有层系的数据集还需支持嵌套层级的拖拽。
|
||||
|
||||
图表切换后字段迁移,可以将每个拖拽区域设置若干类型:
|
||||
|
||||
```json
|
||||
{
|
||||
"dataType": ["dimension"]
|
||||
}
|
||||
```
|
||||
|
||||
这样在切换后,维度类型的字段可以自动迁移到维度类型区域,如果对应区域字段数量达到了 `limit` 限制,就继续填充到下一个区域,直到字段用尽或区域填充完为止。
|
||||
|
||||
如果在探索式分析场景里,需要提前对字段进行维度度量建模,在切换时按照图表情况进行相应的处理。比如折线图切换到表格的情况:折线图是天然一个维度(主轴) + N 个度量的场景,表格是天然两个维度(行、列)+ 1 个度量的场景(也可以支持多个,对单元格进行再切分即可),那么从折线图切换到表格时,度量就会落到标记的文本区域;如果从拥有行和列的表格切换到柱状图(之所以无法切换到折线图,是因为表格的度量值一般是离散的,而折线图度量值一般是连续的),表格的行与列的字段会落到柱状图的维度轴,表现效果是对维度轴进行下钻。
|
||||
|
||||
> [精读《Tableau 探索式模型》](https://github.com/dt-fe/weekly/blob/v2/117.%E7%B2%BE%E8%AF%BB%E3%80%8ATableau%20%E6%8E%A2%E7%B4%A2%E5%BC%8F%E6%A8%A1%E5%9E%8B%E3%80%8B.md) 了解更多探索式分析。
|
||||
|
||||
数据模型还包括数据分析相关配置,比如设置对比字段,或者均值线等分析功能。这些数据计算工作放在后端,前端需要将配置项整理到取数接口中,并按照数据驱动的方式展现。
|
||||
|
||||
对于对比字段等 “拓展字段” 的分析功能,可以拓展通用取数接口,图表组件无感知,相当于多添加了几个隐藏字段;去特殊值等对标准数据进行操作的情况图表组件也无需感知。
|
||||
|
||||
聚类、均值线等需要图表组件额外展示的部分抽象为一套固定的数据格式透传给图表组件,由图表组件自行处理。
|
||||
|
||||
可以看出来,都是取数 + 展示,普通的前端业务与 BI 业务开发的区别:
|
||||
|
||||
普通前端业务是以业务逻辑为核心的,根据业务需要确定接口格式;BI 业务是以数据为核心的,围绕数据计算模型确定一套固定的接口格式,取数不依赖组件,所有组件对标准数据都有对应的展现。
|
||||
|
||||
### 可视化
|
||||
|
||||
与普通可视化组件不同,BI 可视化组件需要对接 CubeSchema 模型,同时还要支持 **大数据性能优化、边界数据展示优化、交互响应**。
|
||||
|
||||
对接 CubeSchema 即统一对接二维表格的数据,大部分组件都是二维以上结构展示,因此对接起来并不困难,有一些一维数据结构的组件比如单指标块就要舍弃其中的某一维,需要确定一套规则。
|
||||
|
||||
二维以上部分是较为通用的,虽然计算模型是基于 Cube N 维的,但组件可以通过标准轴进行多维度展开,或者说下钻来实现类似效果。对于折线图来说,轴的含义有限,可以用分面的方式展示多维数据。当然也有一些组件只适合展示特定维度数量的数据。
|
||||
|
||||
#### 大数据性能优化
|
||||
|
||||
可视化组件特别需要关注性能优化,因为 BI 查询出的数据量可能非常大,特别是多层下钻或基于地理的数据。
|
||||
|
||||
技术手段包括 GPU 渲染、缓存 canvas、多线程运算等,业务手段包括数据抽样、按需渲染可视区域、限制数据条数等等。
|
||||
|
||||
#### 边界数据展示优化
|
||||
|
||||
永远不知道数据集会给出怎样的数据,因此 BI 边界情况特别多,可能点非常密集,也可能丢失一些数据导致渲染异常。图表组件需要利用避让算法将密集的数据打散或着色,目的是为了容易阅读,对于丢失的异常数据也要有保护性的补全机制。
|
||||
|
||||
#### 交互响应
|
||||
|
||||
包括上卷下钻、点选、圈选、高亮等交互操作,这些操作反馈到渲染引擎导致数据变化并将新的数据灌入图表组件。
|
||||
|
||||
业务逻辑上这些交互操作并不复杂,难点在使用的可视化库是否有这个能力,以及如何统一交互行为。
|
||||
|
||||
## 总结
|
||||
|
||||
BI 领域的四大方向:数据集、渲染引擎、数据模型与可视化都有许多可以做深的技术点,每一块都需要深入沉淀几年技术经验才能做好,需要大量优秀人才通力协作才有可能做好。
|
||||
|
||||
目前我们在阿里数据中台正在打造一款面向未来的优秀 BI 工具,如果 BI 领域让你觉得有挑战,随时欢迎你的加入,联系邮箱:ziyi.hzy@alibaba-inc.com
|
||||
|
||||
> 讨论地址是:[精读《前端与 BI》 · Issue #208 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/208)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,293 @@
|
||||
## 1 概述
|
||||
|
||||
本期精读的是有限状态机管理工具 [robot](https://github.com/matthewp/robot) 源码。
|
||||
|
||||
有限状态机是指有限个数的状态之间相互切换的数学模型,在业务与游戏开发中有限状态都很常见,包括发请求也是一种有限状态机的模型。
|
||||
|
||||
笔者将在简介中介绍这个库的使用方式,在精读中介绍实现原理,最后总结在业务中使用的价值。
|
||||
|
||||
## 2 简介
|
||||
|
||||
这个库的核心就是利用 `createMachine` 创建一个有限状态机:
|
||||
|
||||
```typescript
|
||||
import { createMachine, state, transition } from 'robot3';
|
||||
|
||||
const machine = createMachine({
|
||||
inactive: state(
|
||||
transition('toggle', 'active')
|
||||
),
|
||||
active: state(
|
||||
transition('toggle', 'inactive')
|
||||
)
|
||||
});
|
||||
|
||||
export default machine;
|
||||
```
|
||||
|
||||
如上图所示,我们创建了一个有限状态机 `machine`,包含了两种状态:`inactive` 与 `active`,并且可以通过 `toggle` 动作在两种状态间做切换。
|
||||
|
||||
与 React 结合则有 [react-robot](https://github.com/matthewp/react-robot):
|
||||
|
||||
```tsx
|
||||
import { useMachine } from 'react-robot';
|
||||
import React from 'react';
|
||||
import machine from './machine'
|
||||
|
||||
function App() {
|
||||
const [current, send] = useMachine(machine);
|
||||
|
||||
return (
|
||||
<button type="button" onClick={() => send('toggle')}>
|
||||
State: {current.name}
|
||||
</button>
|
||||
)
|
||||
}
|
||||
```
|
||||
|
||||
通过 `useMachine` 拿到的 `current.name` 表示当前状态值,`send` 用来发送改变状态的指令。
|
||||
|
||||
至于为什么要用有限状态机管理工具,官方文档举了个例子 - 点击编辑后进入编辑态,点击保存后返回原始状态的例子:
|
||||
|
||||

|
||||
|
||||
点击 Edit 按钮后,将进入下图的状态,点击 Save 后如果输入的内容校验通过保存后再回到初始状态:
|
||||
|
||||

|
||||
|
||||
如果不用有限状态机,我们首先会创建两个变量存储是否处于编辑态,以及当前输入文本是什么:
|
||||
|
||||
```js
|
||||
let editMode = false;
|
||||
let title = '';
|
||||
```
|
||||
|
||||
如果再考虑和后端的交互,就会增加三个状态 - 保存中、校验、保存是否成功:
|
||||
|
||||
```js
|
||||
let editMode = false;
|
||||
let title = '';
|
||||
let saving = false;
|
||||
let validating = false;
|
||||
let saveHadError = false;
|
||||
```
|
||||
|
||||
就算使用 React、Vue 等框架数据驱动 UI,我们还是免不了对复杂状态进行管理。如果使用有限状态机实现,将是这样的:
|
||||
|
||||
```js
|
||||
import { createMachine, guard, immediate, invoke, state, transition, reduce } from 'robot3';
|
||||
|
||||
const machine = createMachine({
|
||||
preview: state(
|
||||
transition('edit', 'editMode',
|
||||
// Save the current title as oldTitle so we can reset later.
|
||||
reduce(ctx => ({ ...ctx, oldTitle: ctx.title }))
|
||||
)
|
||||
),
|
||||
editMode: state(
|
||||
transition('input', 'editMode',
|
||||
reduce((ctx, ev) => ({ ...ctx, title: ev.target.value }))
|
||||
),
|
||||
transition('cancel', 'cancel'),
|
||||
transition('save', 'validate')
|
||||
),
|
||||
cancel: state(
|
||||
immediate('preview',
|
||||
// Reset the title back to oldTitle
|
||||
reduce(ctx => ({ ...ctx, title: ctx.oldTitle })
|
||||
)
|
||||
),
|
||||
validate: state(
|
||||
// Check if the title is valid. If so go
|
||||
// to the save state, otherwise go back to editMode
|
||||
immediate('save', guard(titleIsValid)),
|
||||
immediate('editMode')
|
||||
)
|
||||
save: invoke(saveTitle,
|
||||
transition('done', 'preview'),
|
||||
transition('error', 'error')
|
||||
),
|
||||
error: state(
|
||||
// Should we provide a retry or...?
|
||||
)
|
||||
});
|
||||
```
|
||||
|
||||
其中 `immediate` 表示直接跳到下一个状态,`reduce` 则可以对状态机内部数据进行拓展。比如 `preview` 返回了 `oldTitle`,那么 `cancle` 时就可以通过 `ctx.oldTitle` 拿到;`invoke` 表示调用第一个函数后,再执行 `state`。
|
||||
|
||||
通过上面的代码我们可以看到使用状态机的好处:
|
||||
|
||||
1. 状态清晰,先罗列出某个业务逻辑的全部状态,避免遗漏。
|
||||
2. 状态转换安全。比如 `preview` 只能切换到 `edit` 状态,这样就算在错误的状态发错指令也不会产生异常情况。
|
||||
|
||||
## 3 精读
|
||||
|
||||
[robot](https://github.com/matthewp/robot) 重要的函数有 `createMachine, state, transition, immediate`,下面一一拆解说明。
|
||||
|
||||
### createMachine
|
||||
|
||||
[createMachine](https://github.com/matthewp/robot/blob/master/machine.js#L122) 表示创建状态机:
|
||||
|
||||
```js
|
||||
export function createMachine(current, states, contextFn = empty) {
|
||||
if(typeof current !== 'string') {
|
||||
contextFn = states || empty;
|
||||
states = current;
|
||||
current = Object.keys(states)[0];
|
||||
}
|
||||
if(d._create) d._create(current, states);
|
||||
return create(machine, {
|
||||
context: valueEnumerable(contextFn),
|
||||
current: valueEnumerable(current),
|
||||
states: valueEnumerable(states)
|
||||
});
|
||||
}
|
||||
```
|
||||
|
||||
可以看到,如果传递了一个对象,通过 `Object.keys(states)[0]` 拿到第一个状态作为当前状态(标记在 `current`),最终将保存三个属性:
|
||||
|
||||
- `context` 当前状态机内部属性,初始化是空的。
|
||||
- `current` 当前状态。
|
||||
- `states` 所有状态,也就是 `createMachine` 传递的第一个参数。
|
||||
|
||||
再看 `create` 函数:
|
||||
|
||||
```js
|
||||
let create = (a, b) => Object.freeze(Object.create(a, b));
|
||||
```
|
||||
|
||||
也就是创建了一个不修改的对象作为状态机。
|
||||
|
||||
这个是 `machine` 对象:
|
||||
|
||||
```js
|
||||
let machine = {
|
||||
get state() {
|
||||
return {
|
||||
name: this.current,
|
||||
value: this.states[this.current]
|
||||
};
|
||||
}
|
||||
};
|
||||
```
|
||||
|
||||
也就是说,状态机内部的状态管理是通过对象完成的,并提供了 `state()` 函数拿到当前的状态名和状态值。
|
||||
|
||||
### state
|
||||
|
||||
[state](https://github.com/matthewp/robot/blob/master/machine.js#L70) 用来描述状态支持哪些转换:
|
||||
|
||||
```js
|
||||
export function state(...args) {
|
||||
let transitions = filter(transitionType, args);
|
||||
let immediates = filter(immediateType, args);
|
||||
let desc = {
|
||||
final: valueEnumerable(args.length === 0),
|
||||
transitions: valueEnumerable(transitionsToMap(transitions))
|
||||
};
|
||||
if(immediates.length) {
|
||||
desc.immediates = valueEnumerable(immediates);
|
||||
desc.enter = valueEnumerable(enterImmediate);
|
||||
}
|
||||
return create(stateType, desc);
|
||||
}
|
||||
```
|
||||
|
||||
`transitions` 与 `immediates` 表示从 `args` 里拿到 `transition` 或 `immediate` 的结果。
|
||||
|
||||
方法是通过如下方式定义 `transition` 与 `immediate`:
|
||||
|
||||
```js
|
||||
export let transition = makeTransition.bind(transitionType);
|
||||
export let immediate = makeTransition.bind(immediateType, null);
|
||||
|
||||
function filter(Type, arr) {
|
||||
return arr.filter(value => Type.isPrototypeOf(value));
|
||||
}
|
||||
```
|
||||
|
||||
**那么如果一个函数是通过 `immediate` 创建的,就可以通过 `immediateType.isPrototypeOf()` 的校验,此方法适用范围很广,在任何库里都可以用来校验拿到对应函数创建的对象。**
|
||||
|
||||
如果参数数量为 0,表示这个状态是最终态,无法进行转换。**最后通过 `create` 创建一个对象,这个对象就是状态的值**。
|
||||
|
||||
### transition
|
||||
|
||||
[transition](https://github.com/matthewp/robot/blob/master/machine.js#L53) 是写在 `state` 中描述当前状态可以如何变换的函数,其实际函数是 `makeTransistion`:
|
||||
|
||||
```js
|
||||
function makeTransition(from, to, ...args) {
|
||||
let guards = stack(filter(guardType, args).map(t => t.fn), truthy, callBoth);
|
||||
let reducers = stack(filter(reduceType, args).map(t => t.fn), identity, callForward);
|
||||
return create(this, {
|
||||
from: valueEnumerable(from),
|
||||
to: valueEnumerable(to),
|
||||
guards: valueEnumerable(guards),
|
||||
reducers: valueEnumerable(reducers)
|
||||
});
|
||||
}
|
||||
```
|
||||
|
||||
由于:
|
||||
|
||||
```js
|
||||
export let transition = makeTransition.bind(transitionType);
|
||||
export let immediate = makeTransition.bind(immediateType, null);
|
||||
```
|
||||
|
||||
可见 `from` 为 `null` 即表示立即转换到状态 `to`。`transition` 最终返回一个对象,其中 `guards` 是从 `transition` 或 `immediate` 参数中找到的,由 `guards` 函数创建的对象,当这个对象回调函数执行成功时此状态才生效。
|
||||
|
||||
`...args` 对应 `transition('toggle', 'active')` 或 `immediate('save', guard(titleIsValid))`,而 `stack(filter(guardType, args).map(t => t.fn), truthy, callBoth)` 这句话就是从 `...args` 中寻找是否有 `guards`,`reducers` 同理。
|
||||
|
||||
最后看看状态是如何改变的,设置状态改变的函数是 [transitionTo](https://github.com/matthewp/robot/blob/master/machine.js#L136):
|
||||
|
||||
```js
|
||||
function transitionTo(service, fromEvent, candidates) {
|
||||
let { machine, context } = service;
|
||||
for(let { to, guards, reducers } of candidates) {
|
||||
if(guards(context)) {
|
||||
service.context = reducers.call(service, context, fromEvent);
|
||||
|
||||
let original = machine.original || machine;
|
||||
let newMachine = create(original, {
|
||||
current: valueEnumerable(to),
|
||||
original: { value: original }
|
||||
});
|
||||
|
||||
let state = newMachine.state.value;
|
||||
return state.enter(newMachine, service, fromEvent);
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
可以看到,如果存在 `guards`,则需要在 `guards` 执行返回成功时才可以正确改变状态。同时 `reducers` 可以修改 `context` 也在 `service.context = reducers.call(service, context, fromEvent);` 这一行体现了出来。最后通过生成一个新的状态机,并将 `current` 标记为 `to`。
|
||||
|
||||
最后我们看 `state.enter` 这个函数,这个函数在 [state](https://github.com/matthewp/robot/blob/master/machine.js#L79) 函数中有定义,其本质是继承了 `stateType`:
|
||||
|
||||
```js
|
||||
let stateType = { enter: identity };
|
||||
```
|
||||
|
||||
而 `identity` 这个函数就是立即执行函数:
|
||||
|
||||
```js
|
||||
let identity = a => a;
|
||||
```
|
||||
|
||||
因此相当于返回了新的状态机。
|
||||
|
||||
## 4 总结
|
||||
|
||||
有限状态机相比普通业务描述,其实是增加了一些状态间转化的约束来达到优化状态管理的目的,并且状态描述也会更规范一些,在业务中具有一定的实用性。
|
||||
|
||||
当然并不是所有业务都适用有限状态机,因为新框架还是有一些学习成本要考虑。最后通过源码的学习,我们又了解到一些新的框架级小技巧,可以灵活应用到自己的框架中。
|
||||
|
||||
> 讨论地址是:[精读《robot 源码 - 有限状态机》 · Issue #209 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/209)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,486 @@
|
||||
## 1 引言
|
||||
|
||||
在写这次精读之前,我想谈谈前端精读可以为读者带来哪些价值,以及如何评判这些价值。
|
||||
|
||||
前端精读已经写到第 123 篇了,大家已经不必担心它突然停止更新,因为我已养成每周写一篇文章的习惯,而读者也养成了每周看一篇的习惯。所以我想说的其实是一种更有生命力的自媒体运作方式,定期更新。一个定期更新的专栏比一个不不定期更新的专栏更有活力,也更受读者喜爱,因为读者能看到文章之间的联系,跟随作者一起成长。个人学习也是如此,养成定期学习的习惯,比在培训班突击几个月更有用,学会在生活中规律的学习,甚至好过读几年名牌大学。
|
||||
|
||||
前端精读想带给读者的不仅是一篇篇具体的内容和知识,知识是无穷无尽的,几万篇文章也说不完,但前端精读一直沿用了“引言-概述-精读-总结”这套学习模式,无论是前端任何领域的问题,还是对人生和世界的思考都可以套用,希望能为读者提供一套学习思维框架,让你能学习到如何找到好的文章,以及如何解读它。
|
||||
|
||||
至今已经选择了许多源码解读的题材,与培训思维的源码解读不同,我希望你不要带着面试的目的学习源码,因为这样会让你只局限在 react、vue 这种热门的框架上。前端精读选取的框架类型之所以广泛,是希望你能静下心来,吸取不同框架风格与作者的优势,培养一种优雅编码的气质。
|
||||
|
||||
进入正题,这次选择的文章 [《用 Babel 创造自定义 JS 语法》](https://lihautan.com/creating-custom-javascript-syntax-with-babel/) 也是培养编码气质的一类文章,虽然对你实际工作用处不大,但这篇文章可以培养几个程序员梦寐以求的能力:深入理解 Babel、深入理解框架拓展机制。理解一个复杂系统或培养框架思维不是一朝一夕的,但持续阅读这种文章可以让你越来越接近掌握它。
|
||||
|
||||
之所以选择 Babel,是因为 Babel 处理的一直是语法树相关的底层逻辑,编译原理是程序世界的基座之一,拥有很大的学习价值。所以我们的目的并不是像文章标题说的 - 创造一个自定义 JS 语法,因为你创造的语法只会让 JS 复杂体系更加混乱,但可以让你理解 Babel 解析标准 JS 语法的原理,以及看待新语法提案时,拥有从实现层面思考的能力。
|
||||
|
||||
最后,不必多说,能重温 Babel 经典的插件机制,你可以发现 Babel 的插件拓展机制和 Antrl4 很像,在设计业务模块拓展方案时也可以作为参考。
|
||||
|
||||
## 2 概述
|
||||
|
||||
我们要利用 Babel 实现 `function @@` 的新语法,用 `@@` 装饰的函数会自动柯里化:
|
||||
|
||||
```js
|
||||
// '@@' makes the function `foo` curried
|
||||
function @@ foo(a, b, c) {
|
||||
return a + b + c;
|
||||
}
|
||||
console.log(foo(1, 2)(3)); // 6
|
||||
```
|
||||
|
||||
可以看到,`function @@ foo` 描述的函数 `foo` 支持 `foo(1, 2)(3)` 这种柯里化调用。
|
||||
|
||||
实现方式分为两步:
|
||||
|
||||
1. Fork babel 源码。
|
||||
2. 创建一个 babel 转换器插件。
|
||||
|
||||
不要畏惧这些步骤,“如果你读完了这篇文章,你将成为同事眼中的 Babel 大神” - 原文。
|
||||
|
||||
首先 Fork babel 源码到本地,执行下面的命令可以初始化并编译 babel:
|
||||
|
||||
```bash
|
||||
$ make bootstrap
|
||||
$ make build
|
||||
```
|
||||
|
||||
babel 使用 [Makefile](https://opensource.com/article/18/8/what-how-makefile) 执行编译命令,并且采用 monorepo 管理,我们这次要关心的是 `package/babel-parser` 这个模块。
|
||||
|
||||
### 词法
|
||||
|
||||
首先要了解词法知识,更详细的可以阅读原文或精读之前的一篇系列文章:[精读《词法分析》](https://github.com/dt-fe/weekly/blob/v2/064.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E8%AF%8D%E6%B3%95%E5%88%86%E6%9E%90%E3%80%8B.md)。
|
||||
|
||||
要解析语法,首先要进行词法分析。任何语法输入都是一个字符串,比如 `function @@ foo(a, b, c)`,词法分析就是要将这个长度为 24 的字符拆分为一个个有语义的单词片段:`function` `@@` `foo` `(` `a` ..
|
||||
|
||||
由于 `@@` 是我们创造的语法,所以我们第一个任务就是让 babel 词法分析可以识别它。
|
||||
|
||||
下面是 `package/babel-parser` 的文件结构:
|
||||
|
||||
```text
|
||||
- src/
|
||||
- tokenizer/
|
||||
- parser/
|
||||
- plugins/
|
||||
- jsx/
|
||||
- typescript/
|
||||
- flow/
|
||||
- ...
|
||||
- test/
|
||||
```
|
||||
|
||||
可以看到,分为词法分析 `tokenizer`,语法分析 `parser`,以及支持一些特殊语法的插件,以及测试用例 `test`。
|
||||
|
||||
推荐使用 **Test-driven development (TDD) - 测试驱动开发的方式**,就是先写测试用例,再根据测试用例开发。这种开发方式在后端或者 babel 这种底层框架很常见,因为 TDD 方式开发的逻辑能保证测试用例 100% 覆盖,同时先看测试用例也是个很好的切面编程思维。
|
||||
|
||||
```js
|
||||
// packages/babel-parser/test/curry-function.js
|
||||
|
||||
import { parse } from '../lib';
|
||||
|
||||
function getParser(code) {
|
||||
return () => parse(code, { sourceType: 'module' });
|
||||
}
|
||||
|
||||
describe('curry function syntax', function() {
|
||||
it('should parse', function() {
|
||||
expect(getParser(`function @@ foo() {}`)()).toMatchSnapshot();
|
||||
});
|
||||
});
|
||||
```
|
||||
|
||||
可以利用 jest 直接测试这段代码:
|
||||
|
||||
```bash
|
||||
BABEL_ENV=test node_modules/.bin/jest -u packages/babel-parser/test/c
|
||||
```
|
||||
|
||||
结果会出现如下报错:
|
||||
|
||||
```text
|
||||
SyntaxError: Unexpected token (1:9)
|
||||
|
||||
at Parser.raise (packages/babel-parser/src/parser/location.js:39:63)
|
||||
at Parser.raise [as unexpected] (packages/babel-parser/src/parser/util.js:133:16)
|
||||
at Parser.unexpected [as parseIdentifierName] (packages/babel-parser/src/parser/expression.js:2090:18)
|
||||
at Parser.parseIdentifierName [as parseIdentifier] (packages/babel-parser/src/parser/expression.js:2052:23)
|
||||
at Parser.parseIdentifier (packages/babel-pars
|
||||
```
|
||||
|
||||
第 9 个字符就是 `@`,说明程序现在还不支持函数前面的 `@` 解析。我们还可以在错误堆栈中找到报错位置,并把当前 Token 与下一个 Token 打印出来:
|
||||
|
||||
```js
|
||||
// packages/babel-parser/src/parser/expression.js
|
||||
|
||||
parseIdentifierName(pos: number, liberal?: boolean): string {
|
||||
if (this.match(tt.name)) {
|
||||
// ...
|
||||
} else {
|
||||
console.log(this.state.type); // current token
|
||||
console.log(this.lookahead().type); // next token
|
||||
throw this.unexpected();
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
`this.state.type` 代表当前 Token,`this.lookahead().type` 表示下一个 Token。`lookahead` 是词法分析的专有词,表示向后查看。打印之后,我们会发现输出了两个 `@` Token:
|
||||
|
||||
```js
|
||||
TokenType {
|
||||
label: '@',
|
||||
// ...
|
||||
}
|
||||
```
|
||||
|
||||
下一步,我们需要让 babel 词法分析识别 `@@` 这个 Token。首先需要注册这个 Token:
|
||||
|
||||
```js
|
||||
// packages/babel-parser/src/tokenizer/types.js
|
||||
|
||||
export const types: { [name: string]: TokenType } = {
|
||||
// ...
|
||||
at: new TokenType('@'),
|
||||
atat: new TokenType('@@'),
|
||||
};
|
||||
```
|
||||
|
||||
注册了之后,我们要在遍历 Token 时增加判断 “如果当前字符是 `@` 且下一个字符也是 `@`,则整体构成了 `@@` Token 并且光标向后移动两格”:
|
||||
|
||||
```js
|
||||
// packages/babel-parser/src/tokenizer/index.js
|
||||
|
||||
getTokenFromCode(code: number): void {
|
||||
switch (code) {
|
||||
// ...
|
||||
case charCodes.atSign:
|
||||
// if the next character is a `@`
|
||||
if (this.input.charCodeAt(this.state.pos + 1) === charCodes.atSign) {
|
||||
// create `tt.atat` instead
|
||||
this.finishOp(tt.atat, 2);
|
||||
} else {
|
||||
this.finishOp(tt.at, 1);
|
||||
}
|
||||
return;
|
||||
// ...
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
再次运行测试文件,输出变成了:
|
||||
|
||||
```js
|
||||
// current token
|
||||
TokenType {
|
||||
label: '@@',
|
||||
// ...
|
||||
}
|
||||
|
||||
// next token
|
||||
TokenType {
|
||||
label: 'name',
|
||||
// ...
|
||||
}
|
||||
```
|
||||
|
||||
到这一步,已经能正确解析 `@@` Token 了。
|
||||
|
||||
## 语法
|
||||
|
||||
词法已经可以将 `@@` 解析为 `atat` Token,下一步我们就要利用这个 Token,让生成的 AST 结构中包含柯里化函数的信息,并利用 babel 插件在解析时实现柯里化功能。
|
||||
|
||||
首先我们可以在 [Babel AST explorer](https://lihautan.com/babel-ast-explorer/#?eyJiYWJlbFNldHRpbmdzIjp7InZlcnNpb24iOiI3LjYuMCJ9LCJ0cmVlU2V0dGluZ3MiOnsiaGlkZUVtcHR5Ijp0cnVlLCJoaWRlTG9jYXRpb24iOnRydWUsImhpZGVUeXBlIjp0cnVlfSwiY29kZSI6ImZ1bmN0aW9uICogZm9vKCkge30ifQ==) 看到 AST 解析的结构,我们拿 generator 函数测试,因为这个函数结构与柯里化函数类似:
|
||||
|
||||
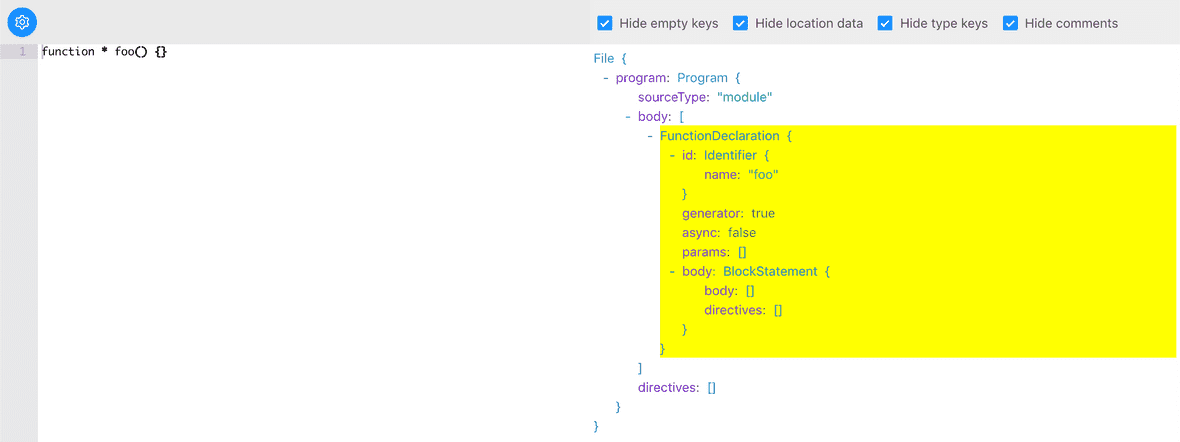
|
||||
|
||||
可以看到,babel 通过 `generator` `async` 属性来标识函数是否为 generator 或者 async 函数。同理,增加一个 `curry` 属性就可以实现第一步了:
|
||||
|
||||
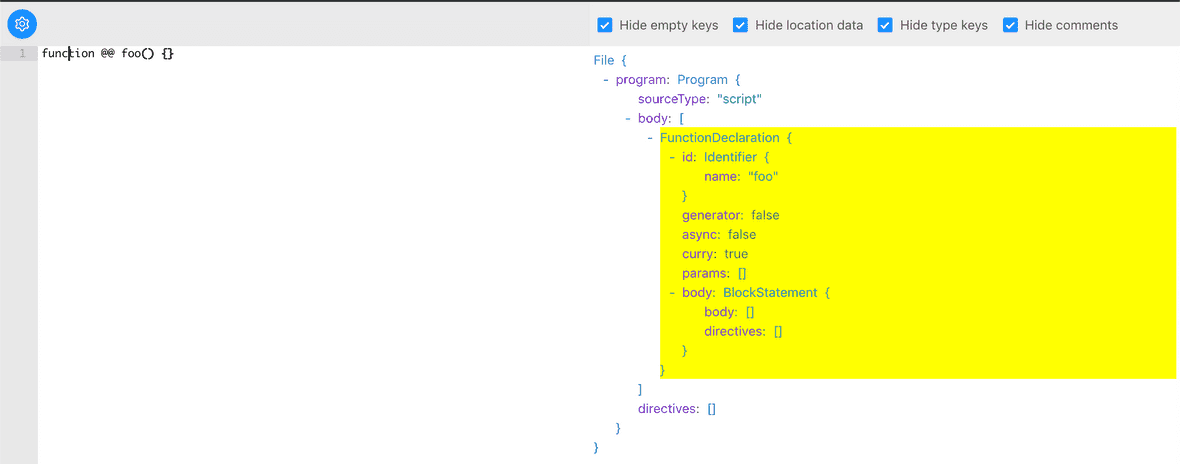
|
||||
|
||||
要实现如上效果,只需在词法分析 `parser/statement` 文件的 `parseFunction` 处新增 `atat` 解析即可:
|
||||
|
||||
```js
|
||||
// packages/babel-parser/src/parser/statement.js
|
||||
|
||||
export default class StatementParser extends ExpressionParser {
|
||||
// ...
|
||||
parseFunction<T: N.NormalFunction>(
|
||||
node: T,
|
||||
statement?: number = FUNC_NO_FLAGS,
|
||||
isAsync?: boolean = false
|
||||
): T {
|
||||
// ...
|
||||
node.generator = this.eat(tt.star);
|
||||
node.curry = this.eat(tt.atat);
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
`eat` 是吃掉的意思,实际上可以理解为吞掉这个 Token,这样做有两个效果:1. 为函数添加了 `curry` 属性 2. 吞掉了 `@@` 标识,保证所有 Token 都被识别是 AST 解析正确的必要条件。
|
||||
|
||||
关于递归下降语法分析的更多知识,可以参考 [精读《手写 SQL 编译器 - 语法分析》](https://github.com/dt-fe/weekly/blob/v2/066.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E8%AF%AD%E6%B3%95%E5%88%86%E6%9E%90%E3%80%8B.md),或者阅读原文。
|
||||
|
||||
我们再次执行测试函数,发现测试通过了,一切都在预料中。
|
||||
|
||||
## babel 插件
|
||||
|
||||
现在我们得到了标记了 `curry` 的 AST,那么最后需要一个 babel 解析插件,实现柯里化。
|
||||
|
||||
首先我们通过修改 babel 源码的方式实现的效果,是可以转化为自定义 babel parser 插件的:
|
||||
|
||||
```js
|
||||
// babel-plugin-transformation-curry-function.js
|
||||
|
||||
import customParser from './custom-parser';
|
||||
|
||||
export default function ourBabelPlugin() {
|
||||
return {
|
||||
parserOverride(code, opts) {
|
||||
return customParser.parse(code, opts);
|
||||
},
|
||||
};
|
||||
}
|
||||
```
|
||||
|
||||
这样就可以实现修改 babel 源码一样的效果,这也是做框架常用的插件机制。
|
||||
|
||||
其次我们要理解如何实现柯里化。柯里化可以通过柯里函数包装后实现:
|
||||
|
||||
```js
|
||||
function currying(fn) {
|
||||
const numParamsRequired = fn.length;
|
||||
function curryFactory(params) {
|
||||
return function (...args) {
|
||||
const newParams = params.concat(args);
|
||||
if (newParams.length >= numParamsRequired) {
|
||||
return fn(...newParams);
|
||||
}
|
||||
return curryFactory(newParams);
|
||||
}
|
||||
}
|
||||
return curryFactory([]);
|
||||
}
|
||||
|
||||
// from
|
||||
function @@ foo(a, b, c) {
|
||||
return a + b + c;
|
||||
}
|
||||
|
||||
// to
|
||||
const foo = currying(function foo(a, b, c) {
|
||||
return a + b + c;
|
||||
})
|
||||
```
|
||||
|
||||
柯里化函数通过构造参数数量相关的递归,当参数传入不足时返回一个新函数,并持久化之前传入的参数,最后当参数齐全后一次性调用函数。
|
||||
|
||||
我们需要做的是,将 `@@ foo` 解析为 `currying()` 函数包裹后的新函数。
|
||||
|
||||
下面就是我们熟悉的 babel 插件部分了:
|
||||
|
||||
```js
|
||||
// babel-plugin-transformation-curry-function.js
|
||||
|
||||
export default function ourBabelPlugin() {
|
||||
return {
|
||||
// ...
|
||||
visitor: {
|
||||
FunctionDeclaration(path) {
|
||||
if (path.get('curry').node) {
|
||||
// const foo = curry(function () { ... });
|
||||
path.node.curry = false;
|
||||
path.replaceWith(
|
||||
t.variableDeclaration('const', [
|
||||
t.variableDeclarator(
|
||||
t.identifier(path.get('id.name').node),
|
||||
t.callExpression(t.identifier('currying'), [
|
||||
t.toExpression(path.node),
|
||||
])
|
||||
),
|
||||
])
|
||||
);
|
||||
}
|
||||
},
|
||||
},
|
||||
};
|
||||
}
|
||||
```
|
||||
|
||||
`FunctionDeclaration` 就是 AST 的 visit 钩子,这个钩子在执行到函数时被触发,我们通过 `path.get('curry')` 拿到 **柯里化函数**,并利用 `replaceWith` 将这个函数构造为一个被 `currying` 函数包裹的新函数。
|
||||
|
||||
剩下最后一个问题:`currying` 函数源码放在哪里。
|
||||
|
||||
第一种方式,创建类似 `babel-plugin-transformation-curry-function` 这样的插件,在 babel 解析时将 `currying` 函数注册到全局,这是全局思维的方案。
|
||||
|
||||
第二种是模块化解决方案,创建一个自定义的 `@babel/helpers`,注册一个 `currying` 标识:
|
||||
|
||||
```js
|
||||
// packages/babel-helpers/src/helpers.js
|
||||
helpers.currying = helper("7.6.0")`
|
||||
export default function currying(fn) {
|
||||
const numParamsRequired = fn.length;
|
||||
function curryFactory(params) {
|
||||
return function (...args) {
|
||||
const newParams = params.concat(args);
|
||||
if (newParams.length >= numParamsRequired) {
|
||||
return fn(...newParams);
|
||||
}
|
||||
return curryFactory(newParams);
|
||||
}
|
||||
}
|
||||
return curryFactory([]);
|
||||
}
|
||||
`;
|
||||
```
|
||||
|
||||
在 visit 函数使用 `addHelper` 方式拿到 `currying`:
|
||||
|
||||
```js
|
||||
path.replaceWith(
|
||||
t.variableDeclaration('const', [
|
||||
t.variableDeclarator(
|
||||
t.identifier(path.get('id.name').node),
|
||||
t.callExpression(this.addHelper("currying"), [
|
||||
t.toExpression(path.node),
|
||||
])
|
||||
),
|
||||
])
|
||||
);
|
||||
```
|
||||
|
||||
这样在 babel 转换后,就会自动 import helper,并引用 helper 中导出的 `currying`。
|
||||
|
||||
最后原文末尾留下了一些延伸阅读内容,感兴趣的同学可以 [点击到原文](https://lihautan.com/creating-custom-javascript-syntax-with-babel/)。
|
||||
|
||||
## 3 精读
|
||||
|
||||
读完这篇文章,相信你不仅对 babel 插件有了更深刻的认识,而且还掌握了如何为 js 添加新语法这种黑魔法。
|
||||
|
||||
我来帮你从 babel 这篇文章总结一些编程模型和知识点,借助 babel 创造自定义语法的实例,加深对它们的理解。
|
||||
|
||||
### TDD
|
||||
|
||||
Test-driven development 即测试驱动的开发模式。
|
||||
|
||||
从文章的例子可以看出,创造一个新语法,可以先在测试用例先写上这个语法,通过执行测试命令通过报错堆栈一步步解决问题。这种方式开发可以让测试覆盖率更高,目的更专注,更容易保障代码质量。
|
||||
|
||||
### 联想编程
|
||||
|
||||
联想编程不属于任何编程模型,但从简介的思路来看,作者把 “为 babel 创建一个新 js 语法” 看作一种探案式探索过程,通过错误堆栈和代码阅读,一步一步通过合理联想实现最终目的。
|
||||
|
||||
在 AST 那一节,还借助了 [Babel AST explorer](https://lihautan.com/babel-ast-explorer/#?eyJiYWJlbFNldHRpbmdzIjp7InZlcnNpb24iOiI3LjYuMCJ9LCJ0cmVlU2V0dGluZ3MiOnsiaGlkZUVtcHR5Ijp0cnVlLCJoaWRlTG9jYXRpb24iOnRydWUsImhpZGVUeXBlIjp0cnVlfSwiY29kZSI6ImZ1bmN0aW9uICogZm9vKCkge30ifQ==) 工具查看 AST 结构,通过联想到 generator 函数找到类似的 AST 结构,并找到拓展 AST 的突破口。
|
||||
|
||||
随着解决问题的不同,联想方式也不同,如果能够举一反三,对不同场景都能合理的联想,才算是具备了技术专家的软素质。
|
||||
|
||||
### 词法、语法分析
|
||||
|
||||
词法、语法分析属于编译原理的知识,理解词法拆分、递归下降,可以帮助你技术走的更深。
|
||||
|
||||
不论是 Babel 插件的使用、还是 Babel 增加自定义 JS 语法,都要具备基本编译原理知识。编译原理知识还能帮助你开发在线编辑器,做智能语法提示等等。
|
||||
|
||||
### 插件机制
|
||||
|
||||
如下是 babel 自定义 parser 的插件拓展方式:
|
||||
|
||||
```js
|
||||
export default function ourBabelPlugin() {
|
||||
return {
|
||||
parserOverride(code, opts) {
|
||||
return customParser.parse(code, opts);
|
||||
},
|
||||
};
|
||||
}
|
||||
```
|
||||
|
||||
这只是插件拓展的一种,有申明式,也有命令式;有用 JS 书写的,也有用 JSON 书写的。babel 选择了通过对象方式拓展,是比较适合对 AST 结构统一处理的。
|
||||
|
||||
做框架首先要确定接口规范,比如 parser,先按照接口规范实现一套官方解析,对接时按照接口进行对接,就可以自然而然被用户自定义插件替代了。
|
||||
|
||||
可以参考的文章: [精读《插件化思维》](https://github.com/dt-fe/weekly/blob/v2/053.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%8F%92%E4%BB%B6%E5%8C%96%E6%80%9D%E7%BB%B4%E3%80%8B.md)
|
||||
|
||||
### 柯里化
|
||||
|
||||
柯里化是面试经常考察的一个知识点,我们能学到的有两点:理解递归、理解如何将函数变成柯里化。
|
||||
|
||||
这里再拓展一下,我们还可以想到 JS 尾递归优化。如何快速写一个支持尾递归的函数?
|
||||
|
||||
```js
|
||||
const fn = tailCallOptimize(() => {
|
||||
if ( /* xxx */ ) {
|
||||
fn()
|
||||
}
|
||||
})
|
||||
```
|
||||
|
||||
通过封装 `tailCallOptimize` 函数,可以很方便的构造一个支持尾递归的函数,这个函数可以这么写:
|
||||
|
||||
```js
|
||||
export function tailCallOptimize<T>(f: T): T {
|
||||
let value: any;
|
||||
let active = false;
|
||||
const accumulated: any[] = [];
|
||||
return function accumulator(this: any) {
|
||||
accumulated.push(arguments);
|
||||
if (!active) {
|
||||
active = true;
|
||||
while (accumulated.length) {
|
||||
value = (f as any).apply(this, accumulated.shift());
|
||||
}
|
||||
active = false;
|
||||
return value;
|
||||
}
|
||||
};
|
||||
}
|
||||
```
|
||||
|
||||
感兴趣的读者可以在评论里解释一下这个函数的原理。
|
||||
|
||||
### AST visit
|
||||
|
||||
遍历 AST 树常采用的方案是做一个遍历器 visitor,所以在遍历过程中进行拓展常采用 babel 这种方式:
|
||||
|
||||
```js
|
||||
return {
|
||||
// ...
|
||||
visitor: {
|
||||
FunctionDeclaration(path) {
|
||||
if (path.get('curry').node) {
|
||||
// const foo = curry(function () { ... });
|
||||
path.node.curry = false;
|
||||
path.replaceWith(
|
||||
t.variableDeclaration('const', [
|
||||
t.variableDeclarator(
|
||||
t.identifier(path.get('id.name').node),
|
||||
t.callExpression(t.identifier('currying'), [
|
||||
t.toExpression(path.node),
|
||||
])
|
||||
),
|
||||
])
|
||||
);
|
||||
}
|
||||
},
|
||||
},
|
||||
};
|
||||
```
|
||||
|
||||
`visitor` 下每一个 key 名都是遍历过程中的拓展点,比如上面的例子,我们可以对函数定义位置进行拓展和改写。
|
||||
|
||||
### 内置函数注册
|
||||
|
||||
babel 提供了两种内置函数注册方式,一种类似 polyfill,在全局注册 window 级的变量,另一种是模块化的方式。
|
||||
|
||||
除此之外,可以学习的是 babel 通过 `this.addHelper("currying")` 这种插件拓展方式,在编译后会自动从 helper 引入对应的模块,前提是 `@babel/helper` 需要注册 `currying` 这个 helper。
|
||||
|
||||
babel 将编译过程隐藏了起来,通过一些高度封装的函数调用,以较为语义化方式书写插件,这样写出来的代码也容易理解。
|
||||
|
||||
## 4 总结
|
||||
|
||||
《用 Babel 创造自定义 JS 语法》这篇文章虽然说的是 babel 相关知识,但可以从中提取到许多通用知识,这就是现在还去理解 babel 的原因。
|
||||
|
||||
从某个功能点为切面,走一遍框架的完整流程是一种高效的进阶学习方式,如果你也有看到类似这样的文章,欢迎推荐出来。
|
||||
|
||||
> 讨论地址是:[精读《用 Babel 创造自定义 JS 语法》 · Issue #210 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/210)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,372 @@
|
||||
## 1 引言
|
||||
|
||||
Flex 与 Grid 相比就像功能键盘和触摸屏。触摸屏的控制力相比功能键盘来说就像是降维打击,因为功能键盘只能上下左右控制(x、y 轴),而触摸屏打破了布局障碍,直接从(z 轴)触达,这样 **无论 UI 内部布局再复杂,都可以通过 touch 直接定位。**
|
||||
|
||||
Flex 是一维布局方式,我们需要不断嵌套 Div 才能形成复杂结构,而一旦布局产生了变化,原有嵌套结构如果不能 “兼容变化” 到新结构,代码就需要重构。而 Grid 就像触摸屏一样,可以二维布局,即便布局方式做了翻天覆地的调整,也仅需少量修改就能适配。
|
||||
|
||||
这就是这次精读 [用 css grid 重新思考布局](https://www.freecodecamp.org/news/css-grid-changes-how-we-can-think-about-structuring-our-content/) 的原因,理解这个革命性布局技术给布局,甚至代码逻辑组织带来的变化。
|
||||
|
||||
## 2 概述
|
||||
|
||||
作者首先抛出了 Flex 的问题,其实是 `block` `float` `flex` 这三种布局模式的通病:
|
||||
|
||||
- 布局结构由 Div 层级结构描述,导致 Div 层级复杂且遇到结构变更时难以维护。
|
||||
- 定制能力弱。Flex 布局有一些不受控制的智能设定,比如宽度 50% 的子元素会被同级元素挤到 50% 以下,这种智能化在某些场景是需要的,但由于没有提供像 Grid 的 `minmax` 之类的 API,所以定制型不足。
|
||||
|
||||
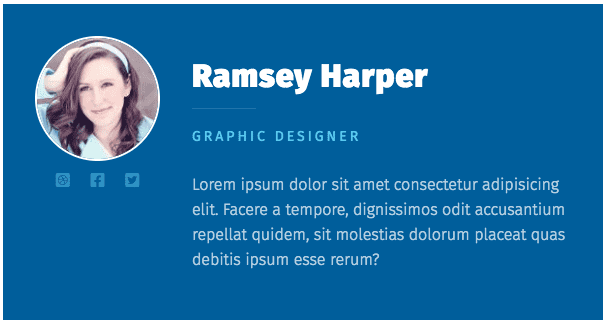
|
||||
|
||||
举个例子,上图的结构用 Flex 描述可能是这样的:
|
||||
|
||||
```html
|
||||
<div class="card">
|
||||
<div class="profile-sidebar">
|
||||
<img src="https://i.pravatar.cc/125?image=3" alt="" class="profile-img" />
|
||||
<ul class="social-list">
|
||||
<li>
|
||||
<a href="#" class="social-link"
|
||||
><i class="fab fa-dribbble-square"></i
|
||||
></a>
|
||||
</li>
|
||||
<li>
|
||||
<a href="#" class="social-link"
|
||||
><i class="fab fa-facebook-square"></i
|
||||
></a>
|
||||
</li>
|
||||
<li>
|
||||
<a href="#" class="social-link"
|
||||
><i class="fab fa-twitter-square"></i
|
||||
></a>
|
||||
</li>
|
||||
</ul>
|
||||
</div>
|
||||
<div class="profile-body">
|
||||
<h2 class="profile-name">Ramsey Harper</h2>
|
||||
<p class="profile-position">Graphic Designer</p>
|
||||
<p class="profile-info">
|
||||
Lorem ipsum dolor sit amet consectetur adipisicing elit. Facere a tempore,
|
||||
dignissimos odit accusantium repellat quidem, sit molestias dolorum
|
||||
placeat quas debitis ipsum esse rerum?
|
||||
</p>
|
||||
</div>
|
||||
</div>
|
||||
```
|
||||
|
||||
利用 HTML 嵌套结构,我们将图形纵向分成两大块,然后在每块内部继续嵌套划分布局,这是最经典的布局行为了。
|
||||
|
||||
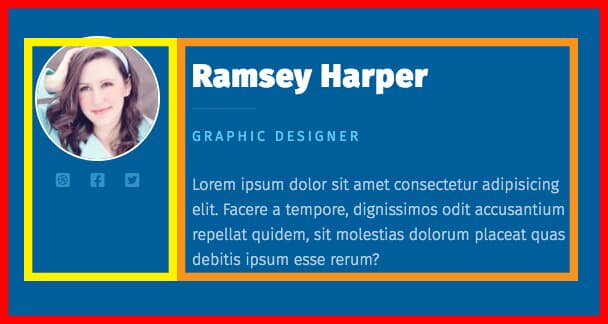
|
||||
|
||||
样式文件里,我们需要对每层布局进行描述,同时支持多分辨率弹性布局,包括顶层 `card` 容器在内的一些样式需要做一定调整:
|
||||
|
||||
```scss
|
||||
.card {
|
||||
width: 80%;
|
||||
margin: 0 auto;
|
||||
display: flex;
|
||||
flex-direction: column;
|
||||
max-width: 600px;
|
||||
background: #005e9b;
|
||||
flex-basis: 250px;
|
||||
color: white;
|
||||
padding: 2em;
|
||||
text-align: center;
|
||||
}
|
||||
|
||||
.profile-info {
|
||||
font-weight: 300;
|
||||
opacity: 0.7;
|
||||
}
|
||||
|
||||
.profile-sidebar {
|
||||
margin-right: 2em;
|
||||
text-align: center;
|
||||
}
|
||||
|
||||
.profile-name {
|
||||
letter-spacing: 1px;
|
||||
font-size: 2rem;
|
||||
margin: 0.75em 0 0;
|
||||
line-height: 1;
|
||||
}
|
||||
|
||||
.profile-name::after {
|
||||
content: "";
|
||||
display: block;
|
||||
width: 2em;
|
||||
height: 1px;
|
||||
background: #5bcbf0;
|
||||
margin: 0.5em auto 0.65em;
|
||||
opacity: 0.25;
|
||||
}
|
||||
|
||||
.profile-position {
|
||||
text-transform: uppercase;
|
||||
font-size: 0.875rem;
|
||||
letter-spacing: 3px;
|
||||
margin: 0 0 2em;
|
||||
line-height: 1;
|
||||
color: #5bcbf0;
|
||||
}
|
||||
|
||||
.profile-img {
|
||||
max-width: 100%;
|
||||
border-radius: 50%;
|
||||
border: 2px solid white;
|
||||
}
|
||||
|
||||
.social-list {
|
||||
list-style: none;
|
||||
justify-content: space-evenly;
|
||||
display: flex;
|
||||
min-width: 125px;
|
||||
max-width: 175px;
|
||||
margin: 0 auto;
|
||||
padding: 0;
|
||||
}
|
||||
|
||||
.social-link {
|
||||
color: #5bcbf0;
|
||||
opacity: 0.5;
|
||||
}
|
||||
|
||||
.social-link:hover,
|
||||
.social-link:focus {
|
||||
opacity: 1;
|
||||
}
|
||||
|
||||
.bio {
|
||||
padding: 2em;
|
||||
display: flex;
|
||||
flex-direction: column;
|
||||
justify-content: center;
|
||||
}
|
||||
|
||||
@media (min-width: 450px) {
|
||||
.bio {
|
||||
text-align: left;
|
||||
max-width: 350px;
|
||||
}
|
||||
}
|
||||
|
||||
.bio-title {
|
||||
color: #0090d1;
|
||||
font-size: 1.25rem;
|
||||
letter-spacing: 1px;
|
||||
text-transform: uppercase;
|
||||
line-height: 1;
|
||||
margin: 0;
|
||||
}
|
||||
|
||||
.bio-body {
|
||||
color: #555;
|
||||
}
|
||||
|
||||
.profile {
|
||||
display: flex;
|
||||
align-items: flex-start;
|
||||
}
|
||||
|
||||
@media (min-width: 450px) {
|
||||
.card {
|
||||
flex-direction: row;
|
||||
text-align: left;
|
||||
}
|
||||
|
||||
.profile-name::after {
|
||||
margin-left: 0;
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
让我们看看 Grid 是怎么做的吧!Grid 有许多 API,我们重点看 `grid-template-areas` 这个属性,利用它,我们可以不关心模块的 HTML 结构,直接平铺方式描述:
|
||||
|
||||
```html
|
||||
<div class="card">
|
||||
<img src="https://i.pravatar.cc/125?image=3" alt="" class="profile-img" />
|
||||
<ul class="social-list">
|
||||
<li>
|
||||
<a href="#" class="social-link"><i class="fab fa-dribbble-square"></i></a>
|
||||
</li>
|
||||
<li>
|
||||
<a href="#" class="social-link"><i class="fab fa-facebook-square"></i></a>
|
||||
</li>
|
||||
<li>
|
||||
<a href="#" class="social-link"><i class="fab fa-twitter-square"></i></a>
|
||||
</li>
|
||||
</ul>
|
||||
<h2 class="profile-name">Ramsey Harper</h2>
|
||||
<p class="profile-position">Graphic Designer</p>
|
||||
<p class="profile-info">
|
||||
Lorem ipsum dolor sit amet consectetur adipisicing elit. Facere a tempore,
|
||||
dignissimos odit accusantium repellat quidem, sit molestias dolorum placeat
|
||||
quas debitis ipsum esse rerum?
|
||||
</p>
|
||||
</div>
|
||||
```
|
||||
|
||||
可以看到,使用 Grid 可以将 UI 结构与 HTML 结构分离,HTML 结构仅描述包含关系,我们只需在样式文件中描述具体 UI 结构。
|
||||
|
||||
样式文件只截取 Grid 相关部分:
|
||||
|
||||
```scss
|
||||
.card {
|
||||
width: 80%;
|
||||
margin: 0 auto;
|
||||
display: flex;
|
||||
flex-direction: column;
|
||||
max-width: 600px;
|
||||
background: #005e9b;
|
||||
flex-basis: 250px;
|
||||
color: white;
|
||||
padding: 2em;
|
||||
text-align: left;
|
||||
|
||||
display: grid;
|
||||
grid-template-columns: 1fr 3fr;
|
||||
grid-column-gap: 2em;
|
||||
grid-template-areas:
|
||||
"image name"
|
||||
"image position"
|
||||
"social description";
|
||||
}
|
||||
|
||||
.profile-name {
|
||||
grid-area: name;
|
||||
}
|
||||
.profile-position {
|
||||
grid-area: position;
|
||||
}
|
||||
.profile-info {
|
||||
grid-area: description;
|
||||
}
|
||||
.profile-img {
|
||||
grid-area: image;
|
||||
}
|
||||
.social-list {
|
||||
grid-area: social;
|
||||
}
|
||||
```
|
||||
|
||||
可以看到,`grid-template-areas` 是进一步抽象的语法,将页面结构通过直观的文本描述,无论是理解还是修改都更为轻松。
|
||||
|
||||
这种描述方式适配不同分辨率下也具有优势,只要重组 `grid-template-areas` 即可:
|
||||
|
||||
```scss
|
||||
@media (min-width: 600px) {
|
||||
.card {
|
||||
text-align: left;
|
||||
grid-template-columns: 1fr 3fr;
|
||||
grid-template-areas:
|
||||
"image name"
|
||||
"image position"
|
||||
"social description";
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
归根结底,Grid 通过二维结构描述,将子元素布局控制收到了父级,使布局描述更加直观。
|
||||
|
||||
最后作者也提到,Flex 依然有使用场景,即简单的一维结构,或者 `space-between` 等 Flex 独有语法的情况。因此推荐整体、复杂的二维布局采用 Grid,一维的简单布局采用 Flex。
|
||||
|
||||
## 3 精读
|
||||
|
||||
Grid 的布局思路给了我很多启发,HTML 结构与 UI 结构的分离有助于减少 DIV 的层级结构,使代码看上去更清晰。
|
||||
|
||||
也许有人会疑惑,Grid 无非将 HTML 布局部分功能挪到了 CSS,整体复杂度应该不变。其实,从 `grid-template-areas` 这个 API 可以看到,Grid 不仅仅将布局功能抽到 CSS 中,更是将布局描述进行了一层抽象,使代码更易维护。
|
||||
|
||||
### 抽象,再抽象
|
||||
|
||||
为什么 Grid 可以对布局进行抽象?因为 Grid 将二维结构都掌握在手中,得到了更大的布局能力,才能进一步将结构化语法抽象为字符串的描述。
|
||||
|
||||
抽象的好处是不言而喻的,你觉得一堆嵌套的 DIV 与下面的代码,哪个更易读呢?
|
||||
|
||||
```scss
|
||||
.card {
|
||||
grid-template-areas:
|
||||
"image name"
|
||||
"image position"
|
||||
"social description";
|
||||
}
|
||||
```
|
||||
|
||||
这就是抽象的好处,一般来说,代码抽象程度越高就越易读,越易维护。
|
||||
|
||||
再看一个 Chrome Grid 插件,将 Grid 可视化显示出来,并可以以 UI 方式进行调整:
|
||||
|
||||
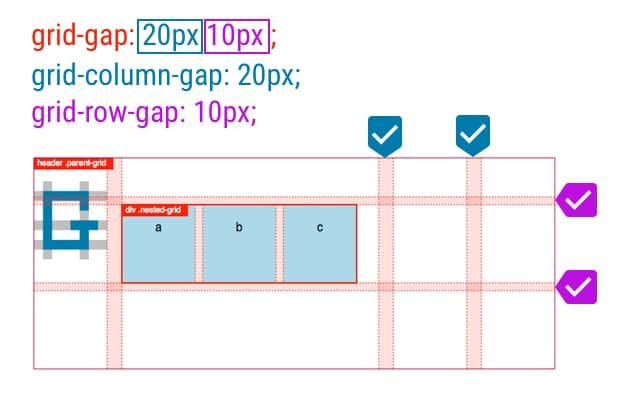
|
||||
|
||||
UI 是对文本的再抽象,同时可以规避一些不可能存在的语法,比如:
|
||||
|
||||
```scss
|
||||
.card {
|
||||
grid-template-areas:
|
||||
"image name"
|
||||
"image position"
|
||||
"social image";
|
||||
}
|
||||
```
|
||||
|
||||
布局只能以凸多边形方式拓展,不可能分离,也不可能突然插入一个其他模块而变成凹多边形。因此 UI 可以将这个错误规避,并简化为横竖多条线的方式对 UI 进行划分,显然这种描述方式效率更高。
|
||||
|
||||
不得不说,Grid 以及图形化插件的探索,是布局领域的一大进步,是不断抽象的尝试,要解决的问题只有一个:如何提供一种更直观的描述 UI 的方式。
|
||||
|
||||
### 布局对模块化的影响
|
||||
|
||||
Grid 将布局方式提高了一个维度,会直接影响到 JS 模块化方式。
|
||||
|
||||
尤其是以 JSX 组织代码的情况下,一个模块等于 UI + JS,通过嵌套方式的布局会让我们更倾向于站在 UI 视角划分模块。
|
||||
|
||||

|
||||
|
||||
比如对于上图模块,如果用 Flex 方式布局,我们可能会首先创建模块 X 作为左侧容器,子元素是 A 和 B,创建模块 Y 作为右侧容器,子元素是 C 以及新容器 Z,Z 容器的子元素是 D 和 E。
|
||||
|
||||
如果你的第一印象是这么组织代码,不得不承认模块化会受到布局方式的影响。虽然许多时候这样划分是正确的,但当这 5 个模块各自没有关联时,我们创建的容器 X、Y、Z 就失去了复用性,在新的组合场景我们又要重新组合一遍。
|
||||
|
||||
但是在 Grid 语法中,我们不需要 X、Y、Z,只需要用 [css grid generator](https://cssgrid-generator.netlify.com/) 按照上图的方式拖拖拽拽即可自动生成如下布局代码:
|
||||
|
||||
```scss
|
||||
.parent {
|
||||
display: grid;
|
||||
grid-template-columns: 3fr repeat(2, 1fr);
|
||||
grid-template-rows: repeat(5, 1fr);
|
||||
grid-column-gap: 0px;
|
||||
grid-row-gap: 0px;
|
||||
}
|
||||
|
||||
.div1 {
|
||||
grid-area: 1 / 1 / 3 / 2;
|
||||
}
|
||||
.div2 {
|
||||
grid-area: 3 / 1 / 6 / 2;
|
||||
}
|
||||
.div3 {
|
||||
grid-area: 1 / 2 / 2 / 4;
|
||||
}
|
||||
.div4 {
|
||||
grid-area: 2 / 2 / 6 / 3;
|
||||
}
|
||||
.div5 {
|
||||
grid-area: 2 / 3 / 6 / 4;
|
||||
}
|
||||
```
|
||||
|
||||
其实 `grid-template-columns` `grid-template-rows` 组合起来使用比 `grid-template-areas` 更强大,但是纯代码方式描述没有 `grid-template-areas` 直观,可是配合一些可视化系统就非常直观了:
|
||||
|
||||

|
||||
|
||||
将 A ~ E 这 5 个模块布局抽出来后,它们之间的关系就打平了,我们可以完全从逻辑视角审视如何做模块化了。
|
||||
|
||||
## 4 总结
|
||||
|
||||
CSS Grid 本质上是一种二维布局的语法,相比 [Block](https://www.w3schools.com/Css/css_inline-block.asp)、[Flex](https://www.w3schools.com/Css/css3_flexbox.asp) 等一维布局方案,多了一个维度可以同时从行与列角度定义布局,因此派生出 `grid-template-areas` 等语法,整体上更内聚更直观,抽象度也更高了。
|
||||
|
||||
理解了这些也就理解了布局未来的发展方向,**让布局与 Dom 分离** 一直是前端的一个梦想,开发 UI 部分时,只需关心页面由哪些模块组成,去实现这些模块就行了,而不需要关心模块之间应该如何组合。在描述组合时,可以通过可视化或比较抽象的字符串描述布局的结构,并对应到写好的模块上,这样的代码维护性远高于用 DIV 描述结构的方案。
|
||||
|
||||
> 讨论地址是:[精读《用 css grid 重新思考布局》 · Issue #211 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/211)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,136 @@
|
||||
## 1 引言
|
||||
|
||||
函数式语言在深度学习领域应用很广泛,因为函数式与深度学习模型的契合度很高,[The Beauty of Functional Languages in Deep Learning — Clojure and Haskell](https://www.welcometothejungle.co/fr/articles/btc-deep-learning-clojure-haskell) 就很好的诠释了这个道理。
|
||||
|
||||
通过这篇文章可以加深我们对深度学习与函数式编程的理解。
|
||||
|
||||
## 2 概述与精读
|
||||
|
||||
深度学习是机器学习中基于人工神经网络模型的一个分支,通过模拟多层神经元的自编码神经网络,将特征逐步抽象化,这需要多维度、大数据量的输入。[TensorFlow](https://www.tensorflow.org/) 和 [PyTorch](https://pytorch.org/) 是比较著名的 Python 深度学习框架,同样 [Keras](https://blog.rstudio.com/2017/09/05/keras-for-r/) 在 R 语言中也很著名。然而在生产环境中,基于 **性能和安全性** 的考虑,一般会使用函数式语言 [Clojure](https://www.clojure.org/) 或 [Haskell](https://www.haskell.org/)。
|
||||
|
||||
在生产环境中,可能要并发出里几百万个参数,因此面临的挑战是:如何高效、安全的执行这些运算。
|
||||
|
||||
**所以为什么函数式编程语言可以胜任深度学习的计算要求呢?** 深度学习的计算模型本质上是数学模型,而数学模型本质上和函数式编程思路是一致的:数据不可变且函数间可以任意组合。这意味着使用函数式编程语言可以更好的表达深度学习的计算过程,因此更容易理解与维护,同时函数式语言内置的 Immutable 数据结构也保障了并发的安全性。
|
||||
|
||||
另外函数式语言的函数之间都是相互隔离的,即便在多线程环境下也不会发生竞争和死锁的情况,函数式编程语言会自动处理这些情况。
|
||||
|
||||
比如说 [Clojure](https://www.clojure.org/),**它甚至可在两个同时修改同一引用的程序并发运行时,自动重试其中之一,而不需要手动加锁**:
|
||||
|
||||
```clojure
|
||||
(import ‘(java.util.concurrent Executors))
|
||||
(defn test-stm [nitems nthreads niters]
|
||||
(let [refs (map ref (repeat nitems 0))
|
||||
pool (Executors/newFixedThreadPool nthreads)
|
||||
tasks (map (fn [t]
|
||||
(fn []
|
||||
(dotimes [n niters]
|
||||
(dosync
|
||||
(doseq [r refs]
|
||||
(alter r + 1 t))))))
|
||||
(range nthreads))]
|
||||
(doseq [future (.invokeAll pool tasks)]
|
||||
(.get future))
|
||||
(.shutdown pool)
|
||||
(map deref refs)))
|
||||
(test-stm 10 10 10000) -> (550000 550000 550000 550000 550000 550000 550000 550000 550000 550000)
|
||||
```
|
||||
|
||||
上面的代码创建了引用(refs),同时创建了多个线程自增这个引用对象,按理说每个线程都修改这个引用会导致竞争状态出现,但从结果来看是正常的,说明 Clojure 引擎在执行时会自动解决这个问题。实际上当两个线程出现竞争而失败时,Clojure 会自动重试其中之一。
|
||||
|
||||
> [原文介绍](https://clojure.org/about/concurrent_programming)
|
||||
|
||||
**Clojure 的另一个优势是并行效率高:**
|
||||
|
||||
```clojure
|
||||
(defn calculate-pixels-2 []
|
||||
(let [n (* *width* *height*)
|
||||
work (partition (/ n 16) (range 0 n))
|
||||
result (pmap (fn [x]
|
||||
(doall (map
|
||||
(fn [p]
|
||||
(let [row (rem p *width*) col (int (/ p *height*))]
|
||||
(get-color (process-pixel (/ row (double *width*)) (/ col (double *height*))))))
|
||||
x)))
|
||||
work)]
|
||||
(doall (apply concat result))))
|
||||
```
|
||||
|
||||
使用 `partition` 结合 `pmap` 可以使并发效率达到最大化,也就是 CPU 几乎都消耗在实际计算上,而不是并行的任务管理与上下文切换。Clojure 凭借 `partition` 对计算进行分区,采取分而治之并对分区计算结果进行合并的思路优化了并发性能。
|
||||
|
||||
> [原文介绍](http://www.fatvat.co.uk/2009/05/jvisualvm-and-clojure.html)
|
||||
|
||||
Clojure 另一个特性是函数链式调用:
|
||||
|
||||
```clojure
|
||||
;; pipe arg to function
|
||||
(-> "x" f1) ; "x1"
|
||||
|
||||
;; pipe. function chaining
|
||||
(-> "x" f1 f2) ; "x12"
|
||||
```
|
||||
|
||||
其中 `(-> "x" f1 f2)` 等价于 `f2(f1("x"))`,这种描述不仅更简洁清晰,也更接近于实际数学模型。
|
||||
|
||||
> [原文介绍](http://xahlee.info/clojure/clojure_function_chaining.html)
|
||||
|
||||
最后,Clojure 还具备计算安全性,计算过程不会修改已有的数据,因此在神经网络的任何一层的原始值都会保留,每层计算都可以独立运行且函数永远幂等。
|
||||
|
||||
[Haskell](https://www.haskell.org/) 也有独特的优势,**它具有类型推断、惰性求值等特性**,被认为更适合用于机器学习。
|
||||
|
||||
类型推断即 Haskell 类型都是静态的,如果试图赋予错误的类型会报错。
|
||||
|
||||
Haskell 的另一个优势是可以非常清晰的描述数学模型。
|
||||
|
||||
想想一般数学模型是怎么描述函数的:
|
||||
|
||||
```text
|
||||
fn =>
|
||||
f1 = 1
|
||||
f2 = 9
|
||||
f3 = 16
|
||||
n > 2, fn = 3fn-3 + 2fn-2 + fn-1
|
||||
```
|
||||
|
||||
一般语言用 `if-else` 描述等价关系,但 Haskell 可以几乎原汁原味的还原函数定义过程:
|
||||
|
||||
```haskell
|
||||
solve :: Int -> Interger
|
||||
solve 1 = 1
|
||||
solve 2 = 9
|
||||
solve 3 = 16
|
||||
solve n = 3 * solve (n - 3) + 2 * solve (n - 2) + solve (n - 1)
|
||||
```
|
||||
|
||||
这使得阅读 Haskell 代码和阅读数学公式一样轻松。
|
||||
|
||||
> [原文](https://blog.jle.im/entry/purely-functional-typed-models-1.html)
|
||||
|
||||
Haskell 另一个优势是惰性求值,即计算会在真正用到时才进行,而不会在计算前提前消费掉,比如:
|
||||
|
||||
```haskell
|
||||
let x = [1..]
|
||||
let y = [2,4 ..]
|
||||
head (tail tail( (zip x y)))
|
||||
```
|
||||
|
||||
可以看到,`x` 与 `y` 分别是 `1,2,3,4,5,6...` 与 `2,4,6,8...` 的无限数组,而 `zip` 函数将其整合为一个新数组 `(1,2),(2,4),(3,6),(4,8)...` 这也是无限数组,如果将 `zip` 函数执行完那么程序就会永远执行下去。但 Haskell 却不会陷入死循环,而是直接输出第一位数字 `1`。这就是惰性计算的特性,无论数组有多长,只有真正用到某项时才对其进行计算,所以哪怕初始数据量或计算量很大,实际消耗的运算资源只取决于这次计算实际用到的部分。
|
||||
|
||||
由于深度学习数据量巨大,惰性求值可以忽略海量数据输入,大大提升计算性能。
|
||||
|
||||
## 3 总结
|
||||
|
||||
本文介绍了为什么深度学习更适合使用函数式语言,以及介绍了 Clojure 与 Haskell 语言的共性:安全性、高性能,以及各自独有的特性,证明了为何这两种语言更适合用在深度学习中。
|
||||
|
||||
在前端领域说到函数式或函数之美,大部分时候想到的是 Class Component 与 Function Component 的关系,这个理解是较为片面的。通过本文我们可以了解到,函数式的思想与数学表达式思想如出一辙,以写数学公式的思维方式写代码,就是一种较好的函数式编程思路。
|
||||
|
||||
函数式应该只有表达式,没有语句,这是因为函数式是为了处理运算而诞生的,因此很适合用在深度学习领域。
|
||||
|
||||
> 讨论地址是:[精读《深度学习 - 函数式之美》 · Issue #212 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/212)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
Reference in New Issue
Block a user