Compare commits
| Author | SHA1 | Date | |
|---|---|---|---|
 ascoders |
0198bcc55b | ||
|
ascoders
|
35d659397a | ||
|
黄子毅
|
b08b26b691 | ||
|
ascoders
|
4b56ab4ed6 | ||
|
october-rain
|
5bfd19a828 | ||
|
ascoders
|
5e75ab4be0 | ||
|
ascoders
|
7f1ec4b1c6 | ||
|
ascoders
|
2214f4faad | ||
|
ascoders
|
a625f6f24c | ||
|
ascoders
|
a66c2fb578 | ||
|
ascoders
|
1662fad4ae | ||
|
黄子毅
|
600563222d | ||
|
Careteen
|
cbc75a5353 | ||
|
ascoders
|
4cb5a8400a | ||
|
ascoders
|
b7c0ee0700 | ||
|
黄子毅
|
9455f3b7d3 | ||
|
zzt
|
a639f81e7b | ||
|
zzt
|
3bbea7136f | ||
|
ascoders
|
868900fb76 | ||
|
ascoders
|
9e470a441a | ||
|
ascoders
|
b1a43d4843 | ||
|
ascoders
|
9cb731cb36 | ||
|
ascoders
|
93828e08b2 | ||
|
ascoders
|
0b06c714fa | ||
|
ascoders
|
cf5cc265cb | ||
|
ascoders
|
366c6c90c3 | ||
|
ascoders
|
98cc6ace48 | ||
|
ascoders
|
751d78be0a | ||
|
黄子毅
|
acfb7fd442 | ||
|
xch1029
|
750e2cec32 | ||
|
ascoders
|
d01463fc9e | ||
|
ascoders
|
534e5a0f49 | ||
|
黄子毅
|
3b2b2adde4 | ||
|
Jim Gao
|
e905d37dab | ||
|
ascoders
|
14dbde8615 | ||
|
ascoders
|
62afd07694 | ||
|
黄子毅
|
933862c0cd | ||
|
黄子毅
|
d4d87b029f | ||
|
11os
|
ed6a7d10c2 | ||
|
ascoders
|
6e36e81748 | ||
|
ascoders
|
f3a50ce6f7 | ||
|
黄子毅
|
c8c9f7c7d9 | ||
|
黄子毅
|
7eeecc34d2 | ||
|
itLeizhou
|
c8448215c7 | ||
|
ascoders
|
050f00b3e5 | ||
|
ascoders
|
b661e2329a | ||
|
黄子毅
|
8691358638 | ||
|
ascoders
|
8116ed1f72 | ||
|
ascoders
|
6ccc12acfe | ||
|
ascoders
|
41a9d364a0 | ||
|
neverland
|
499a766252 | ||
|
黄子毅
|
af0f3dd04d | ||
|
LiuL0703
|
3cd0bb8761 | ||
|
ascoders
|
fa6d19f415 | ||
|
ascoders
|
7fce362c17 | ||
|
ascoders
|
fe93fce942 | ||
|
黄子毅
|
088df6eda6 | ||
|
mixbo
|
62ed443234 | ||
|
ascoders
|
49fd947437 | ||
|
ascoders
|
d4eb4ee606 | ||
|
ascoders
|
04c67e183d | ||
|
ascoders
|
86ccf45f85 | ||
|
ascoders
|
3f9febce36 | ||
|
黄子毅
|
140da78305 | ||
|
AmagiDDmxh
|
12c85b9418 | ||
|
黄子毅
|
4cee1951da | ||
|
915016229
|
548fde2f85 | ||
|
ascoders
|
1ed6ac5c48 | ||
|
ascoders
|
4b1fa0c7c6 | ||
|
ascoders
|
d0609b0e77 | ||
|
ascoders
|
0cc317e9f1 | ||
|
黄子毅
|
8dad1ef1af | ||
|
黄子毅
|
e81a26600f | ||
|
ascoders
|
18a495ec39 | ||
|
ascoders
|
713c88518f | ||
|
黄子毅
|
a7fa58f620 | ||
|
黄子毅
|
50e042c90d | ||
|
陈煜坚
|
b2c02f7892 | ||
|
陈煜坚
|
b91e09f170 | ||
|
黄子毅
|
68cd8d1966 | ||
|
kongmoumou
|
fa28d1513c | ||
|
ascoders
|
14f93ddd71 | ||
|
ascoders
|
da81242d9b | ||
|
ascoders
|
89c50fc032 | ||
|
ascoders
|
c81446eff5 | ||
|
黄子毅
|
d5f96ff5a3 | ||
|
黄子毅
|
db3449ace1 | ||
|
Kai Qi
|
1dddebbb1f | ||
|
蔡小伦
|
77e2da3f2d | ||
|
ascoders
|
019076e87f | ||
|
ascoders
|
18e058af5b | ||
|
ascoders
|
fe7b930b95 | ||
|
黄子毅
|
1a9be6aaf8 | ||
|
向晚
|
3110990b90 | ||
|
黄子毅
|
e5e2d49ae1 | ||
|
ascoders
|
94381de60b | ||
|
fltenwall
|
70f20e6861 | ||
|
ascoders
|
fab11f31d2 | ||
|
ascoders
|
8af572d9f9 | ||
|
ascoders
|
0c542af0ab | ||
|
ascoders
|
4b3aae675d | ||
|
ascoders
|
532d3bd6f0 | ||
|
黄子毅
|
cb20d65c2c | ||
|
谭九鼎
|
07b6017451 | ||
|
黄子毅
|
2c5f8ca4f3 | ||
|
ascoders
|
cd543b1fd4 | ||
|
feikerwu
|
88560b6626 | ||
|
ascoders
|
1cf5e339c9 | ||
|
ascoders
|
4ac67508f4 | ||
|
ascoders
|
d2044c4636 | ||
|
ascoders
|
59629228f9 | ||
|
黄子毅
|
eeb4272d49 | ||
|
ascoders
|
e8ae8557d2 | ||
|
ascoders
|
f0ab10ac09 | ||
|
trojan0523
|
b7b0409cd5 | ||
|
ascoders
|
13963fbdd2 | ||
|
ascoders
|
9b9d02b9de | ||
|
黄子毅
|
ec65f684bb | ||
|
ascoders
|
022b1fdbbd | ||
|
黄子毅
|
ff121c7e1b | ||
|
JRoger
|
a04380c1c1 | ||
|
Linear-Enter
|
3646b36db5 | ||
|
ascoders
|
aaaa28953b | ||
|
ascoders
|
9609101870 | ||
|
黄子毅
|
afb601a303 | ||
|
ascoders
|
c72477ed7d | ||
|
ascoders
|
dc09550e0c | ||
|
ascoders
|
dc66e76dd1 | ||
|
黄子毅
|
cecef87d13 | ||
|
Dengju Deng
|
d0ca3a348f | ||
|
ascoders
|
de4e309f39 | ||
|
ascoders
|
ea56ac10ce | ||
|
ascoders
|
90660c6d34 | ||
|
黄子毅
|
fcf04083a5 | ||
|
黄子毅
|
a1ea12a736 | ||
|
黄子毅
|
02a795bb8a | ||
|
黄子毅
|
6bffed8eb5 | ||
|
黄子毅
|
ddd5ceb74a | ||
|
rmlzy
|
3c6cee2f49 | ||
|
rmlzy
|
fc2f0c6f68 | ||
|
rmlzy
|
0dcf208315 | ||
|
rmlzy
|
7730834e83 | ||
|
rmlzy
|
91875ab232 | ||
|
黄子毅
|
d81e6d7813 | ||
|
黄子毅
|
3e299d85e9 | ||
|
ascoders
|
455e1693f4 | ||
|
rmlzy
|
2a17e62107 | ||
|
rmlzy
|
0a090cf0a7 | ||
|
ascoders
|
c13f0af435 | ||
|
ascoders
|
8ee7995ddc | ||
|
黄子毅
|
0e8c749e68 | ||
|
Jie Peng
|
ee0450ffb2 | ||
|
ascoders
|
e0d8be6916 | ||
|
ascoders
|
7c4d37a428 | ||
|
ascoders
|
eeaebad903 | ||
|
黄子毅
|
c624e7e607 | ||
|
kamilic
|
0f724a20cf | ||
|
黄子毅
|
c7922c4a0e | ||
|
Jihchi Lee
|
9d98f72fd3 | ||
|
ascoders
|
db9a256efa | ||
|
ascoders
|
aedfdd4b91 | ||
|
ascoders
|
99d5c51d42 | ||
|
黄子毅
|
086b733288 | ||
|
Jihchi Lee
|
6f9ccaef9e | ||
|
ascoders
|
dba92f52b5 | ||
|
ascoders
|
61512fba55 | ||
|
ascoders
|
542faafe04 | ||
|
ascoders
|
70468eae8a | ||
|
ascoders
|
9e0c2027d2 | ||
|
ascoders
|
6ac4e965bb | ||
|
ascoders
|
5edddb5890 | ||
|
ascoders
|
706ac612ff | ||
|
ascoders
|
444a56e333 | ||
|
ascoders
|
2e966d717d | ||
|
ascoders
|
237d856cfe | ||
|
ascoders
|
d12c076774 | ||
|
ascoders
|
3e3cc53715 | ||
|
ascoders
|
ea4d30385a | ||
|
ascoders
|
1b03871be8 | ||
|
ascoders
|
42e068aab7 | ||
|
ascoders
|
280efe4545 | ||
|
ascoders
|
9b54c138a7 | ||
|
ascoders
|
c253b7d60f | ||
|
ascoders
|
367bba2692 | ||
|
ascoders
|
e888c4e22c | ||
|
ascoders
|
8a3425b5e3 | ||
|
ascoders
|
9081bde65e | ||
|
ascoders
|
4f783678da | ||
|
ascoders
|
299a60a881 | ||
|
ascoders
|
7e651219b0 | ||
|
ascoders
|
e1e7bc6f57 | ||
|
ascoders
|
beed8434ec | ||
|
ascoders
|
ab13166c0a | ||
|
ascoders
|
71a48cde3b | ||
|
黄子毅
|
c603ac0d1d | ||
|
Samuel Chia
|
316d3d98aa | ||
|
ascoders
|
0465cf43db | ||
|
ascoders
|
65de19ddb6 | ||
|
ascoders
|
9c0f11cc55 | ||
|
ascoders
|
754ceb3d5a | ||
|
ascoders
|
dcc5247ba0 | ||
|
ascoders
|
02de198a8b | ||
|
ascoders
|
b7cfc4c6e3 | ||
|
ascoders
|
46a094e711 | ||
|
ascoders
|
b5cd1b2379 | ||
|
ascoders
|
cfe94e6aa7 | ||
|
黄子毅
|
3362f25775 | ||
|
William
|
87f9704831 | ||
|
ascoders
|
6c7084dfe1 | ||
|
ascoders
|
164590159d | ||
|
黄子毅
|
b8ab46d26b | ||
|
深樹
|
183b4fc41a | ||
|
ascoders
|
2b7ab34978 | ||
|
ascoders
|
2ca7132569 | ||
|
黄子毅
|
aac9aa34f8 | ||
|
黄子毅
|
ad8a645462 | ||
|
深樹
|
2dbe4d6368 | ||
|
ascoders
|
d76253ef75 | ||
|
ascoders
|
46b68f1933 | ||
|
JeromeLin
|
8aab27bc3f | ||
|
黄子毅
|
22f118e1b7 | ||
|
JeromeLin
|
922eb6dc59 | ||
|
黄子毅
|
20526273d3 | ||
|
Nickbing Lao
|
f3222c646b | ||
|
ascoders
|
9ae28c5e85 | ||
|
ascoders
|
e72318adb4 | ||
|
ascoders
|
2682dc0504 | ||
|
ascoders
|
8b4611b47a | ||
|
ascoders
|
25938c60a6 | ||
|
ascoders
|
9920f0dbb7 | ||
|
ascoders
|
90f7d89db7 | ||
|
黄子毅
|
6ddbdbbbb2 | ||
|
NaturelLee
|
3c8c9fd5ef | ||
|
ascoders
|
91a9bf82fd | ||
|
ascoders
|
4603ac77d8 | ||
|
ascoders
|
998940af1b | ||
|
ascoders
|
24ed724eab | ||
|
ascoders
|
33b71628ab | ||
|
ascoders
|
2dbf1429ba | ||
|
ascoders
|
9867c1ee9d | ||
|
ascoders
|
e8a0539984 | ||
|
ascoders
|
685e8ba32a | ||
|
黄子毅
|
6c9493df7b | ||
|
深樹
|
1994438792 | ||
|
ascoders
|
60be3e354b | ||
|
ascoders
|
9d0bb5c996 | ||
|
ascoders
|
304dc5fc36 | ||
|
ascoders
|
819b6d7452 | ||
|
ascoders
|
b066c8a5d7 | ||
|
ascoders
|
80fb60c6fb | ||
|
ascoders
|
6a2031899d | ||
|
ascoders
|
aedcc2fd56 | ||
|
ascoders
|
757eb403ac | ||
|
ascoders
|
87c2745395 | ||
|
ascoders
|
0d3d8ef54c | ||
|
ascoders
|
53d5ee1960 | ||
|
ascoders
|
92a8dfc55c | ||
|
ascoders
|
c59f46cc1d | ||
|
黄子毅
|
ef3904a2f6 | ||
|
迷渡
|
994c5844d9 | ||
|
ascoders
|
3881e51b08 | ||
|
ascoders
|
815ae1367a | ||
|
ascoders
|
84ed47dbdf | ||
|
ascoders
|
252980724a | ||
|
黄子毅
|
225aab476d | ||
|
深樹
|
f065539266 | ||
|
ascoders
|
f8d81fc3f5 | ||
|
ascoders
|
43e264cc07 | ||
|
ascoders
|
957737959f | ||
|
ascoders
|
000e6511e6 | ||
|
ascoders
|
a652284bbc | ||
|
ascoders
|
1b88e5ac06 | ||
|
ascoders
|
79ba9ec6a1 | ||
|
黄子毅
|
a4acf09d8b | ||
|
lz-lee
|
872ef2e346 | ||
|
黄子毅
|
8795ae0aaa | ||
|
Kerminate
|
23c4190d7e | ||
|
Kerminate
|
75d0109102 | ||
|
Kerminate
|
893bb2d97a | ||
|
ascoders
|
0c2c8c6c03 | ||
|
ascoders
|
97a313ca1e | ||
|
黄子毅
|
3fd57e26b8 | ||
|
Linear-Enter
|
aee6f6d6bb | ||
|
ascoders
|
00fd6e541a | ||
|
ascoders
|
6cc1af4ca9 | ||
|
ascoders
|
ed27df0fe2 | ||
|
ascoders
|
14ebdf19ca | ||
|
ascoders
|
e89a1b0c7e | ||
|
ascoders
|
a1bd0ec7a5 | ||
|
黄子毅
|
82d3665606 | ||
|
changyuqing
|
67a289e750 | ||
|
ascoders
|
1b0a7ed8ea | ||
|
ascoders
|
21ba3e0640 | ||
|
ascoders
|
d5159b914e | ||
|
黄子毅
|
c45a3d09d5 | ||
|
vivaxy
|
c3ea6f2b17 | ||
|
ascoders
|
fb98d1febc | ||
|
ascoders
|
036a9779eb | ||
|
ascoders
|
beb89cf31b | ||
|
黄子毅
|
5d65a777bd | ||
|
coke
|
115d108404 | ||
|
黄子毅
|
f573e16473 | ||
|
jack-Lo
|
ac53e3a325 | ||
|
ascoders
|
d3dad3b151 | ||
|
ascoders
|
7843682b1e | ||
|
黄子毅
|
11c34a9edc | ||
|
ascoders
|
923c3990f7 | ||
|
Kerminate
|
b091d40925 | ||
|
ascoders
|
5c76c9d567 | ||
|
ascoders
|
0ad9a98d33 | ||
|
ascoders
|
b9fb7c80f2 | ||
|
ascoders
|
03519c41f6 | ||
|
ascoders
|
8ff1e9e21a | ||
|
ascoders
|
93882be318 | ||
|
黄子毅
|
d0dee4bbd7 | ||
|
Linear-Enter
|
3cc44000eb | ||
|
Linear-Enter
|
46cdabeb86 | ||
|
ascoders
|
71258f1b83 | ||
|
ascoders
|
1d95103bfb | ||
|
ascoders
|
b9d9292040 | ||
|
黄子毅
|
7ce55795a2 | ||
|
Linear-Enter
|
2a420c455e | ||
|
ascoders
|
069cf8f947 | ||
|
ascoders
|
af86669e18 | ||
|
ascoders
|
50c4409e29 | ||
|
ascoders
|
5c44507443 | ||
|
ascoders
|
ffb736eb6d | ||
|
黄子毅
|
abc677a5f0 | ||
|
ascoders
|
3c78a1a659 | ||
|
ascoders
|
507df796b0 | ||
|
ascoders
|
0f58ce27dc | ||
|
ascoders
|
51c8f3bb69 | ||
|
vivaxy
|
c4da7262cb | ||
|
ascoders
|
a513286318 | ||
|
ascoders
|
509dfe2c97 | ||
|
ascoders
|
806ee0177a | ||
|
ascoders
|
fe4afdf89c | ||
|
ascoders
|
caec16066a | ||
|
ascoders
|
7f53bde9a3 | ||
|
ascoders
|
63e2ca4d0d | ||
|
黄子毅
|
9dbd1fb7b9 | ||
|
黄子毅
|
7d8816c2c2 | ||
|
黄子毅
|
44ae420f52 | ||
|
mr_left
|
683b22d1ae | ||
|
mr_left
|
4e58379585 | ||
|
mr_left
|
1342144fef | ||
|
ascoders
|
a41f452df0 | ||
|
ascoders
|
0950c4cdaf | ||
|
ascoders
|
46ad26c1a4 | ||
|
ascoders
|
6dd26bee54 | ||
|
ascoders
|
37d6b5f3f0 | ||
|
黄子毅
|
f23e88338f | ||
|
MT
|
3dda46d760 | ||
|
MT
|
cd6a00bf3a | ||
|
ascoders
|
6aad1da704 | ||
|
ascoders
|
03a5a0f484 | ||
|
ascoders
|
0066b890d4 | ||
|
黄子毅
|
e0caf77d0a | ||
|
hustcc
|
1517e86999 | ||
|
黄子毅
|
c8f86df3f3 | ||
|
leoxu
|
752d598d27 | ||
|
ascoders
|
e5fd022f00 | ||
|
ascoders
|
f78c4fb511 | ||
|
ascoders
|
41a90e5991 | ||
|
黄子毅
|
a4efe24cca | ||
|
Veron
|
1a3b36074e | ||
|
黄子毅
|
8dad4956b7 | ||
|
Linear-Enter
|
852d35501c | ||
|
ascoders
|
b9d95182a1 | ||
|
ascoders
|
bfa3ab7b55 | ||
|
黄子毅
|
304e4d3aa3 | ||
|
ascoders
|
62be743112 | ||
|
ascoders
|
6d27e723cd | ||
|
vivaxy
|
704c9cda9e | ||
|
黄子毅
|
44dd8057e2 | ||
|
leoxu
|
d956b15ad0 | ||
|
黄子毅
|
961d77b4d1 | ||
|
黄子毅
|
c763fc15bd | ||
|
leoxu
|
f9f04d711f | ||
|
leoxu
|
5d40208d45 | ||
|
ascoders
|
771bb9f914 | ||
|
ascoders
|
96f850e29f | ||
|
黄子毅
|
349e7df2b6 | ||
|
Linear-Enter
|
b198d57cf6 | ||
|
黄子毅
|
03b8840291 | ||
|
黄子毅
|
60899c0bf8 | ||
|
lengjing
|
648e113e66 | ||
|
chen tuo
|
61a5e74908 | ||
|
ascoders
|
d2273e72f6 | ||
|
ascoders
|
386b605c32 | ||
|
黄子毅
|
b60cca25d7 | ||
|
Linear-Enter
|
68e6c23f82 | ||
|
ascoders
|
a9d2c1d47a | ||
|
ascoders
|
cc364c4b2f | ||
|
ascoders
|
f65b11ea6b | ||
|
黄子毅
|
35458365c6 | ||
|
Kerminate
|
dde997ac27 | ||
|
ascoders
|
53ae9e077e | ||
|
ascoders
|
30bdcf13dd | ||
|
黄子毅
|
12b1b02539 | ||
|
黄子毅
|
2a92487a5e | ||
|
ascoders
|
b6487f8754 | ||
|
vivaxy
|
7a8e1b25dd | ||
|
vivaxy
|
44683fa1dc | ||
|
ascoders
|
3a4b82bc76 | ||
|
ascoders
|
4f2ed7b3cb | ||
|
黄子毅
|
a72795b099 | ||
|
ascoders
|
dea2acc384 | ||
|
ascoders
|
74f539cc34 | ||
|
程方
|
1947b9c08c | ||
|
黄子毅
|
e84c85cc1d | ||
|
ascoders
|
170c0f4525 | ||
|
ascoders
|
c836848228 | ||
|
曾浩
|
7b87d5c3c4 | ||
|
黄子毅
|
add5bdd01e | ||
|
曾浩
|
0633764a44 | ||
|
黄子毅
|
fcc183d523 | ||
|
ascoders
|
627db8a249 | ||
|
ascoders
|
b41530b37c | ||
|
ascoders
|
2062b652dd | ||
|
黄子毅
|
d8f2e0977d | ||
|
vivaxy
|
f4e75f5e21 | ||
|
黄子毅
|
365997863e | ||
|
黄子毅
|
ab6978da4a | ||
|
leoxu
|
f37d496f1b | ||
|
Kerminate
|
3bf34602b4 | ||
|
ascoders
|
274ffc0a9f | ||
|
ascoders
|
72e8b69dd7 | ||
|
黄子毅
|
62ac1d76b9 | ||
|
leoxu
|
e537efe7bd | ||
|
ascoders
|
f1871f59e5 | ||
|
ascoders
|
5d08eabde3 | ||
|
黄子毅
|
7e79c60a12 | ||
|
leoxu
|
9c051f6ab5 | ||
|
ascoders
|
065fab1546 | ||
|
ascoders
|
88cd38685d | ||
|
黄子毅
|
7de3c77c3b | ||
|
Cong Zhang
|
09978602c0 | ||
|
ascoders
|
fcb42f2dcf | ||
|
ascoders
|
0ef3cf16a9 | ||
|
黄子毅
|
baf666dbf8 | ||
|
ludy.hxy
|
74f1884f78 | ||
|
黄子毅
|
4f815df5ab | ||
|
Kerminate
|
35a8ee0a9e |
@@ -0,0 +1,2 @@
|
||||
/node_modules
|
||||
/yarn.lock
|
||||
@@ -0,0 +1,7 @@
|
||||
{
|
||||
"excludeFiles": [],
|
||||
"rules": {
|
||||
"no-long-code": 0,
|
||||
"no-trailing-punctuation": 0
|
||||
}
|
||||
}
|
||||
@@ -0,0 +1,6 @@
|
||||
language: node_js
|
||||
node_js:
|
||||
- "10"
|
||||
before_install:
|
||||
- npm i -g lint-md-cli
|
||||
script: lint-md ./
|
||||
@@ -1,54 +0,0 @@
|
||||
# 精读《Web fonts: when you need them, when you don’t》
|
||||
本期精读让我们来聊一聊Web Fonts,文章地址:[https://hackernoon.com/web-fonts-when-you-need-them-when-you-dont-a3b4b39fe0ae](https://hackernoon.com/web-fonts-when-you-need-them-when-you-dont-a3b4b39fe0ae)
|
||||
|
||||
## 文章简介
|
||||
文章分析了Web Fonts的优劣具体使用场景。
|
||||
|
||||
## 主要观点
|
||||
- 作者用一张流程图非常言简意赅地概括了文章的上半部分。
|
||||

|
||||
- 当然上半部分作者也讲了很多案例,其中一个很明显的案例就是维基百科利用字体来提升阅读体验,通过文章内的对比,能直观感受到这一点
|
||||
- 文章后半部分着力介绍了怎么解决Web Font的带来的弊端:认识FOUT带来的问题,如何使用现有的前端解决方案来尽可能避免这个问题,以及样式上优雅降级的几个方案。
|
||||
|
||||
## 把文章带入自己的开发环境
|
||||
作为一个中文开发者,在我们的开发技术栈中,Web Fonts绝对是属于使用频率比较低的那一类的。本次精读选择这篇文章,也正是一探这一个不常见的领域。
|
||||
|
||||
对于英文字母,26个字母可以解决大部分的问题,算上大小写和基本符号,一张ASCII码标就可以包含住。让我再扩展一下,到大部分的西文书写系统,几百个字符就能解决多语言显示的问题了。但是对于汉语而言,Web Fonts真的是,想说爱你不容易,因为常用的汉字就有几千个(你想象中国还有《千字文》这种儿童读物……)。字体这东西跟字符数量直接挂钩,是很难通过压缩来获得性能提升的。
|
||||
|
||||
通常的想法就是用多少,取多少,但是这个方法也就只能适用于标题美化等场景。对于一个系统性的前端工程,我们不可能去实现一个动态字符的字体文件(就是统计这个页面上会产生多少个字符,为这个字符集去生成一个字符子集)
|
||||
|
||||
虽然汉字书写系统和西文书写系统天生存在差异,但是把作者在文章中提出来的几个问题再站在中文的角度上再来看一下,也可以得到一个比较客观的答案。以下是我作为一个普通开发者的自问自答:
|
||||
|
||||
1. **字体对你的品牌很关键吗?**(需要特性字体的中文LOGO基本都用PNG和SVG解决了,Web Font不实用。)
|
||||
2. **字体让你的文字阅读起来更容易了吗?**(我平时开发产品没有成片聚集的文字,用无衬线字体就能满足需求。Web Font很好,我选择“微软雅黑”。)(注:泛指那些好用的支持全字集的系统自带字体;成片的文字适用衬线字体,个人认为中文的衬线字体,不同的字体带来的阅读体验还是有明显差别的。)
|
||||
3. **你需要在不同设备上显示一样的字体吗?**(好像还没这么苛求吧……微软雅黑好看,安卓上的Roboto也很不错啊,Roboto这种字体还针对移动设备有优化,何乐而不为。)
|
||||
4. **用了Web Font你会更开心吗?**(在icon中使用iconfont让我们告别了PNG Sprite图,嗯这很开心。至于文字上用Web Font,有好用的系统字体你不用,你这是何苦呢)(作者也说了,可能折腾半天还没系统字体看着舒服,那就是一行font-family的事情)
|
||||
|
||||
不同产品有着不同的场景,多像文章里问问自己会有最合适的答案。
|
||||
|
||||
## 关于FOUT和FOIT
|
||||
文章中大篇幅地在安利你使用Web Font,但是也很直白地指出了Web Font最大的问题,就是这个FOUT——Flash Of Unstyled Text。连作者毫不避讳地说了句:“噢我的老天,这太丑了!”
|
||||
|
||||
具体表现是采用了Web Font的文案会存在闪动,这个的根本原因在于相比于系统字体,Web Font最大的弊端在于它是异步加载的,你没有办法避免下载它所用的时间。文章中举了一个例子,在一个图文为主的页面中,一个542KB的字体文件,在第9秒才加载完成。在那之前只能以系统字体来展示,而在第9秒加载完成的时候,还会出现替换字体的情况,文字会突然跳动。
|
||||
|
||||
比FOUT更为极端的情况的是FOIT——Flash Of Invisible Text。很多浏览器的行为,并不是默认展示系统字体,而是直接隐藏。那么即使在极快的网速下也很难避免存在一个几百毫秒的时间滞后。
|
||||
|
||||
不过好在,有一个font-display的属性,可以在声明@font-face的时候配合使用。对于未加载Web Fonts的时候,auto属性可以选择隐藏也就是会产生FOIT,swap会产生替换也就是会产生FOUT,还有fallback和optional可以控制先FOIT后FOUT来达到折中方案。
|
||||
|
||||
还有一个思路,那就是预加载,对于字体,浏览器还是能够有效缓存的,如果能够做好预加载,还是不会太影响用户体验的。文章中就提到了一个方案,调用link的rel=preload来做预加载。因为通常加载字体是在CSS中的@font-face被读到的时候才去加载的,那么就会出现先加载CSS,后加载字体的情况。如果利用link预加载,那么在CSS中的@font-face被读到前就已经开始加载了,那么字体加载和CSS加载就可以同时加载,提升速度。
|
||||
|
||||
当然JS是万能的,也有一些库在支持这方面功能,例如bramstein/fontfaceobserver这样的。
|
||||
|
||||
愚以为,FO*T这种情况既然无法避免还是要具体情况具体分析的。如果你的用户网速够快,那么隐藏文字会更好,用户无感知;如果网速不确定,而且是文章为主的内容,那么内容至上就应该先用替代字体显示;如果你正在将Web Font应用在图标等东西上,那么我们自然不愿意看到满屏的方框方框,这种时候就选择隐藏吧。
|
||||
|
||||
文章也提了一点,如果你的字体授权很贵,但用户端深受FO*T折磨,那你还费这钱干嘛。
|
||||
|
||||
## 结论
|
||||
如果能解决FO*T的副作用,Web Font怎么舒服怎么用。但是中文字体大,常用西文字体诸如Google字体库又时常被墙,对于中国开发者,Web Font想说爱你不容易。(还是乖乖用微软雅黑吧,逃……
|
||||
|
||||
## 彩蛋
|
||||
文章里有一段很精彩的话,摘抄出来翻译一下:
|
||||
|
||||
> 如果这个世界上有这样一个Sketch或者Photoshop的插件,可以在你每次打开一个文件的时候,延迟十秒才显示出字体;那么世界上就没有那么多多余的字体了。
|
||||
>
|
||||
> (译者注:删光设计师的电脑里的奇怪字体也能达到相同目的,哈哈哈~)
|
||||
@@ -1,161 +0,0 @@
|
||||
本期精读的文章是: [coinhive官方文档](https://coinhive.com)及[Monero官方文档](https://getmonero.org/)
|
||||
|
||||
懒得看文章? 没关系.
|
||||
|
||||
咦, 怎么是官方文档?
|
||||
|
||||
本期精读有所不同, 注重实操, 先操作获取感性认识, 然后再介绍相关的概念, 由浅入深, 力求不纠缠细节, 但不遮盖环节. 阅读本文需要对加密货币有一些基本常识 (如果你是一个开发者但是完全没了解过加密货币, 可以参考[这里](http://piotrpasich.com/introduction-bitcoin-for-developers/)). 希望同学们看完本文能对加密货币领域有一个更深更切实的体感. 如果要了解更多细节, 文末总结的延伸阅读链接列表是最好的开始.
|
||||
|
||||
要注意一点, 文中很多说明是默认基于XMR和BTC的, 他们两个又同源, 机制非常相似. **所以很多命题判断并不适用于所有的成千上万的加密货币.** 正相反, 新的币种层出不穷, 几乎所有的惯例都被打破, 所有可能性都被尝试. 这一点以下不再做说明.
|
||||
|
||||
# 1 引言
|
||||
首先, tl;dr干货. 10行代码, 5分钟, 不需部署不需构建直接浏览器开挖.
|
||||
|
||||
- 本地创建文件test.html, 粘贴如下代码:
|
||||
```
|
||||
<!doctype html>
|
||||
<html>
|
||||
<head>
|
||||
<title>Mining</title>
|
||||
</head>
|
||||
<body>
|
||||
<div class="coinhive-miner"
|
||||
style="width: 256px; height: 310px"
|
||||
data-key="MUtCJzIDhrs01ERrf3qlqdawo35N0CYD">
|
||||
<em>Loading...</em>
|
||||
</div>
|
||||
<script src="https://authedmine.com/lib/simple-ui.min.js" async></script>
|
||||
</body>
|
||||
</html>
|
||||
```
|
||||
|
||||
- 本地双击打开. 等待JS加载, 点击widget "Start Mining". 开始挖矿! 如下图
|
||||
|
||||

|
||||
|
||||
不错, 数字已经在跳动, 风扇开始工作, 永无尽头的挖矿已经开始了. 那么重要的是, 挖出来的加密货币在哪呢? 原来上面的代码里用的还是我的API key, 所以还没挖到你自己那里 :P 继续下面的步骤
|
||||
|
||||
- 在coinhive注册账号并登陆. 它是做什么的? 别急, 后面会详细讲. 在coinhive/settings找到自己的API keypair, 把public key复制出来, 形如MUtCJzIDhrs01ERrf3qlqdawo35N0CYD
|
||||
|
||||
- 替换上面代码中的data-key部分, 重新开始挖矿. 好了, 现在挖出的Monero (这是啥? 详见下一节) 已经会到你自己的coinhive账户中. 用下图来说明, 你名下总计算过的Hash个数为264K, 当前难度换算为0.00002个Monero(Symbol:XMR). 当前难度为66G一个block, 一个block reward 5.87 XMR, 得到一个XMR是11.268G. 264K/11.268G = 0.0000234. 这就是你目前的收益.
|
||||
|
||||

|
||||
|
||||
- 查bitfinex可得现在XMR价格在375美元 (当你看到本文的时候, 价格可能早就又波动到不知哪里去了), 所以你 (以及你忠实勤劳的电脑) 获得的实际收益为0.000234 * 375 USD = 0.008775 USD, 快到一分钱了 :)
|
||||
|
||||
怎么样, 有没有一种浏览器点开即玩一刀999级的感觉. 以上操作的便捷直接, 是建立在无数前人大量的开发和基础设施建设之上的. 越是领域早期的工作, 越步履维艰, 收货也越丰厚. 如今加密货币已经走到了一个成年期, 逐渐稳定成熟起来.
|
||||
|
||||
接下来我们聚焦到上面过程的每个环节, 了解下拼图的每一块是怎样被构成全图的.
|
||||
|
||||
# 2 聚焦
|
||||
让我们从最终端最接近用户的环节开始, 逐一聚焦, 最后走完整条链路.
|
||||
|
||||
## 2.1 从浏览器说起
|
||||
本文标题叫浏览器挖矿, 也是和贴合前端的部分. 那么为什么可以在浏览器里挖矿? 为什么可以很多用户在多个终端浏览器同时为同一个人 (你) 挖矿?
|
||||
|
||||
我们知道, 挖矿是对加密货币产生机制的俗称. 主流大多采取Proof of Work (PoW) 机制. 最常见的PoW方式就是由网络中所有节点作为矿工, 每个节点都基于blockchain前面block已有信息计算一个新信息. 这个新信息的计算方式往往是某种hash function, 并且人为地被设置为需要巨大计算力和时间才能完成 (其具体难度一般也会实时调整). 当一个节点幸运地 (也依靠强大的算力) 第一个计算出结果后, 会把这个结果广播到网络中. 其他所有节点会验证这个结果 (我们知道非对称加密算法, 验证便宜而计算昂贵), 一旦证实就会停下手里的计算, 承认这个计算结果. 新的计算结果创造出新的块, 区块链的高度增加一层, 然后计算继续下去. 每一个块的生成一般在2-10分钟. 这个过程就被叫做挖矿.
|
||||
|
||||
既然是通用计算, 既然是算一个hash值, 那么民用级CPU和GPU, 浏览器或任何沙盒, 虚拟机, 移动设备当然就都可以. 在我们的例子中, 计算过程被做成分布式, 每个用户可以各自计算, 结果按chunk发回master汇总. 这样就实现了终端用户 - 浏览器 - 共同贡献计算资源 - 换为XMR的过程.
|
||||
|
||||
这就是对整个链路的一个描述. 从中我们会生出一些疑问, 比如:
|
||||
|
||||
> 给我看看具体算什么hash? 为什么要算XMR而不是比特币或者其他? 既然第一个算出的赢家通吃所有, 为什么我的收益却是线性的? 这种描述来看岂不是算力最大的一方**永远**都能算出结果而其他人颗粒无收吗?
|
||||
|
||||
要看具体算法, 没有问题. bitcoin在[这里](http://www.righto.com/2014/02/bitcoin-mining-hard-way-algorithms.html), XMR则看[CryptoNote Standard 008](https://cryptonote.org/cns/cns008.txt)
|
||||
|
||||
读完两个算法我们就有了以上疑问的答案:
|
||||
|
||||
### 2.1.1 为什么要算XMR而不是比特币或者其他
|
||||
XMR不是唯一选择, 但是BTC是一个不可选的选择. 因为double SHA-265在专业级GPU上会比CPU上快10^4倍 ([更多信息](https://en.bitcoin.it/wiki/Why_a_GPU_mines_faster_than_a_CPU)). 这样一百万用户合力浏览器挖矿还不如一架子双路Titan, 就失去了分布到终端用户的意义. 而CryptoNight在GPU上只比同价值CPU快2倍. 另外CryptoNight算法也被设计为不适用[ASIC](https://en.wikipedia.org/wiki/Application-specific_integrated_circuit).
|
||||
|
||||
怎么实现的? CryptoNight算法开宗明义地写明, 运算主体是Memory-Hard Loop, 而不是Computation-Hard Loop. 每个循环都要在内存中检索. 实际运行CryptoNight时, CPU都会用最快, 最接近ALU也是容量最小的L3 Cache. 换到GPU, 显存虽然很大, 却没有L3 Cache一样的极致读写速度优化, 而且由于内存读写成了瓶颈, GPU中的大量ALU也没了用武之地. 下图简略地描述了CryptoNight循环体的结构:
|
||||
|
||||

|
||||
|
||||
### 2.1.2 算力最大的一方永远都能算出结果
|
||||
看了比特币具体算法, 你应该明白了hash是靠不停改变nonce来生成的. 随机取一个值, 算了不对, 再随机取另一个nonce值... 既然是随机取, 就不会存在赢家恒赢.
|
||||
|
||||
### 2.1.3 为什么我的收益却是线性的
|
||||
这是一个隐蔽但是却非常重要的问题. 答案是, 本来确实是赢家通吃. 如果你的算力足够大, 挖矿时间足够长之后总会轮到你, 但是收益会有大幅波动.
|
||||
|
||||
就是因为如此, 矿工们逐渐建立了矿池组织. 大家把算力都投入到一起, 合力算, 然后不管这次实际是谁算出来, 都按照贡献的算力比例分配收益. 矿池是一个加密货币建立之初, 完全推崇去中心化时没有预料到的结构, 也产生了深远的影响. 现在来自中国矿池的算力早已超过网络50%, 他们会在挖出的块中打上矿池标记, 而这些矿池在加密货币的分叉, 路线图中也扮演举足轻重的角色.
|
||||
|
||||
所以你的算力并不是直接投入XMR网络中, 而是投入一个矿池. 在我们的例子里矿池就是coinhive, 只不过是一个比较特殊的矿池, 特殊在矿池成员都运作在浏览器中. 这就是为什么你会得到线性收益而不是all or none.
|
||||
|
||||
自古以来各行业都会自发产生行业工会, 建立类似保险和行业守则 / 规范这些人人为我我为人人的机制. 在crypto行业也不例外. 这是意料之外而情理之中.
|
||||
|
||||
## 2.2 在浏览器里发生了什么, 或, coinhive干了什么
|
||||
好, 我们搞清了一些基本的Monero挖矿机制, 下面来看看coinhive. 已经知道coinhive帮我们接入它的矿池, 让再小的算力也能按比例得到产出. 但是还有什么呢? 最关键的一点, coinhive是怎样把一个完整的mining过程拆分成小块, 让一个或许并不强大的设备上的浏览器, 也能快速接收task, 快速完成并且即时上传的呢?
|
||||
|
||||
废话不多说, 打开源码. 本项目没有开源, 构建完成后的在https://coinhive.com/lib/coinhive.min.js. 先做初步format处理, 发现有些工作完成在后端, worker shard一侧. 以下用松散的伪码总结一下client side的[main success scenario](https://wiki.ihris.org/wiki/Understanding_Use_Cases)流程 (注意很多地方简化了):
|
||||
|
||||
```
|
||||
- start
|
||||
- loadWorkerResource
|
||||
- load worker-asmjs.min.js
|
||||
- CRYPTONIGHT_WORKER_BLOB = createObjectURL(Blob(response_of_worker-asmjs.min.js))
|
||||
- _startNow -> _connectAfterSelfTest
|
||||
- selfTest -> verify(testJob),
|
||||
testJob = {
|
||||
verify_id: "1",
|
||||
nonce: "204f150c",
|
||||
result: "6a9c7dea83b079ce0e012907dd6929bcb0aeec3c1f06c032ca7c3386432bca00",
|
||||
blob: "0606c6d8cfd005cad45b0306350a730b0354d52f1b6d671063824287ce4a82c971d109d56d1f1b00000000ee2d1d4fd7c18bdc1b24abb902ac8ecc3d201ffb5904de9e476a7bbb0f9ec1ab04"
|
||||
};
|
||||
verify = if (!this._isReady) {
|
||||
this.verifyJob = job
|
||||
} else {
|
||||
this.worker.postMessage(job)
|
||||
}
|
||||
// 实例化若干个JobThread, 每个对应一个worker, worker实际执行asmjs.min.js
|
||||
- _connect // verify成功, 终于建立连接. 根据public key固定hash到一个shard池然后随机选一个shard, 建立websocket
|
||||
- websocket.onmessage: if (type==job) work()
|
||||
- work:
|
||||
do { hash(input, output) } while !(meetTarget(output));
|
||||
websocket.postMessage({nonce, output}) // hash done successfully. submit
|
||||
```
|
||||
|
||||
看一下这个过程, 结合[cns003 XMR blockchain specs](https://cryptonote.org/cns/cns003.txt). XMR的整体hash input很小, 是:
|
||||
```
|
||||
- size of [block_header, Merkle root hash, and the number of
|
||||
transactions] in bytes (varint)
|
||||
- block_header,
|
||||
- Merkle root hash,
|
||||
- number of transactions (varint).
|
||||
```
|
||||
|
||||
这样用websocket发过来毫无问题. 之后就是完全独立的计算, 调整nonce来算不同的hash结果. target就是当前难度的一个指示.
|
||||
|
||||
这样整条链路就比较清晰了. 再思考一下以下问题:
|
||||
|
||||
### 2.2.1 为什么XMR适宜分布式客户端计算
|
||||
因为能够利用每个用户的CPU和其中的**高速L3 Cache**. 这是中心化执行难以具备的条件.
|
||||
|
||||
任何时候当考虑要不要把某项操作推到客户端进行时, 都要想明白可以利用客户端的哪个资源, 这个资源在客户端是否有明显优势, 是否比后端中心化执行更有利. **很多时候答案是, 优势并不明显. 那么引入的网络通信成本, 法规成本, 额外开销可能就并不值得.**
|
||||
|
||||
## 2.3 最后的步骤
|
||||
到了这里, 最后剩余步骤就很标准模式化了. coinhive作为矿场, 代管着用户生产的加密货币. 用户发请求提出XMR, 就需要提到一个自己的钱包地址保管, 比如[MyMonero](https://mymonero.com). 也可以直接提到Exchange交易所, 在其中交易成其他币种, 包括法币, 然后电汇等等形式提现.
|
||||
|
||||
如果对钱包或者交易所感兴趣 (这两个也是很大的话题, 比如钱包分硬件钱包和软件钱包, 离线冷钱包和线上热钱包, private key和recover seeds. 交易所有多种多样的交易对, 有杠杆, 期货, 空和多, 多种挂单类型等等), 可以看[这里](https://www.blockchain-council.org/cryptocurrency/hot-wallet-vs-cold-wallet/)和[这里](https://github.com/txbits/txbits).
|
||||
|
||||
# 3 更多讨论
|
||||
|
||||
> 讨论地址是:[精读《全链路体验浏览器挖矿》 · Issue #55 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/55)
|
||||
|
||||
**如果你想参与讨论,请[点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,每周五发布。**
|
||||
|
||||
# 4 延伸阅读
|
||||
http://piotrpasich.com/introduction-bitcoin-for-developers
|
||||
|
||||
https://en.wikipedia.org/wiki/Monero_(cryptocurrency)
|
||||
|
||||
http://www.righto.com/2014/02/bitcoin-mining-hard-way-algorithms.html
|
||||
|
||||
https://cryptonote.org/cns/cns001.txt
|
||||
cns001-008是Specs集合
|
||||
|
||||
https://en.bitcoin.it/wiki/Why_a_GPU_mines_faster_than_a_CPU
|
||||
|
||||
https://en.wikipedia.org/wiki/Application-specific_integrated_circuit
|
||||
|
||||
https://github.com/txbits/txbits
|
||||
@@ -1,52 +0,0 @@
|
||||
# 精读《快速上手构建ARKit应用》
|
||||
|
||||
原文地址: [how-to-make-your-own-arkit-app-in-5-minutes-using-react-native](https://medium.com/@HippoAR/how-to-make-your-own-arkit-app-in-5-minutes-using-react-native-9d7ce109a4c2)
|
||||
|
||||
## 引言
|
||||
ARKit是苹果推出的增强现实套装,而react-native-arkit是基于此的上层封装。对于前端开发而言,这可能是最快上手ARKit的方式了,本周精读让我们来初窥ARKit和React Native ARKit这个库。
|
||||
|
||||
## 概要
|
||||
本次精读我们带来的是一篇《快速上手构建ARKit应用》,原文链接如上。原文标题更加直接,直译的话是“如何在5分钟里利用react native搭建出你自己的ARKit应用”。确实,这篇文章整体也非常明确,以跑起整个ARKit Demo为最直接最主要的目的。
|
||||
|
||||
跑起ARKit,也很简单。硬件上,只要有一台iPhone 6S以上的手机;软件上,只要准备好最新版本的XCode和日常开发要用的Node环境了就好。按照`react-native-arkit`的里面的README就可以跑起来了。这个库不
|
||||
|
||||
## 3 精读
|
||||
在开始精读前,我先抛出我的问题三连:Why AR? Why ARKit? Why React Native ARKit?
|
||||
|
||||
### 3.1 Why AR?
|
||||
在之前的第43期精读评论中,我们探讨了AR对于和前端结合的可能性。总的来说,AR把前端开发不再局限在有限的屏幕空间上,对于可视化等对前端展示空间有强烈需求的细分领域,AR是一个很值得研究的内容。如果对于这一块内容有兴趣,欢迎回看第43期精读评论 [《精读〈增强现实与可视化〉》](https://github.com/dt-fe/weekly/blob/master/43.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%A2%9E%E5%BC%BA%E7%8E%B0%E5%AE%9E%E4%B8%8E%E5%8F%AF%E8%A7%86%E5%8C%96%E3%80%8B.md)。
|
||||
|
||||
### 3.2 Why ARKit?
|
||||
为什么选择 ARKit 入手进行实验?其因有二。第一,相比于 Microsoft HoloLens 的价格,售价只有它三分之一的iPhone X无论是体积重量,还是性价比,抑或是保有量都是大大占优的。噢对,说到保有量,iPhone 6S及以上都支持ARKit。所以说iPhone是我们身边最容易接触到的AR设备是不为过的。第二,ARKit对于硬件的利用能力非一般的前端库可以做到的。大部分的AR前端库可以做到利用陀螺仪来构建一个三维立体空间。但是ARKit更进一步,他利用高频调用摄像头,通过对图像进行识别分析,可以进行空间感知,例如可以识别出一个平面。而这些都是ARKit所提供的,我们只需要调用它的能力就好了。对于开发者而言,ARKit会比一般的AR库更近一步。
|
||||
|
||||
### 3.3 Why React Native ARKit?
|
||||
对于当下的前端开发,所有事情可以分为两种——0. 可以用 JavaScript 写的 1. 其他。至于为什么选择`react-native-arkit`这个库,原因自然也可以理解。相比于用原生的Swift来开发,React Native 的开发方式对于前端而言明显是更加容易上手了。对于尝试新东西,这也未尝不可。
|
||||
|
||||
### 3.4 About Demo
|
||||
相比于原文中从初始化开始的步骤,官方还提供了一个已经配置好的[官方Demo](https://github.com/HippoAR/ReactNativeARKit)。使用这个,如果环境没有问题,的确只需要5分钟就可以跑起来一个ARKit应用了。
|
||||
|
||||
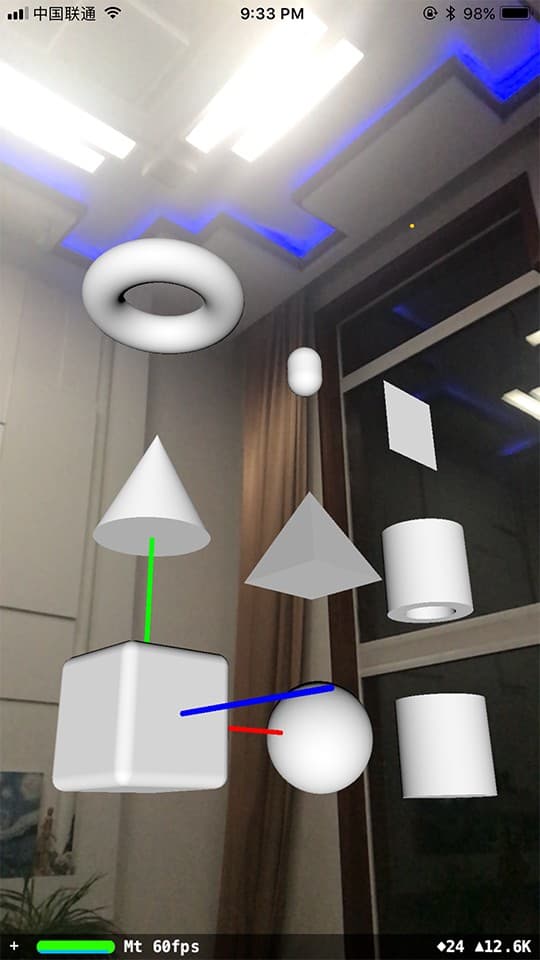
|
||||
|
||||
上面的图片来自原文,可以看到,在`react-native-arkit`这个库里面的所支持的9种基本图形和文字。使用如下已经封装好的React Native组件就可以直接使用了。
|
||||
|
||||
```javasctipt
|
||||
<ARKit.Box
|
||||
pos={{ x: 0, y: 0, z: 0 }}
|
||||
shape={{ width: 0.1, height: 0.1, length: 0.1, chamfer: 0.01 }}
|
||||
/>
|
||||
```
|
||||
|
||||
[几何构造](http://v.youku.com/v_show/id_XMzUxMjk3NjUxMg==.html)
|
||||
上面的一个视频片段是我们在跑起来Demo后的立体效果。可以很清楚地看到,ARKit感知到了房间这个立方体空间后所构建出来的AR的效果。
|
||||
|
||||
[平面识别](http://v.youku.com/v_show/id_XMzUxMjk3OTc0NA==.html)
|
||||
而最后的这段视频会更加有趣一些,中央的红圈的出现逻辑是停留在最近识别出的一个平面上。我们可以看到首先识别出了地面,红圈随地面而动;再移向桌面时,很快又识别出了桌面,重新生成了一个停留在桌面上的红圈。通过这一段可以看出无论是明暗划分明显的地面,还是堆满杂物的桌面,ARKit都可以很轻松的识别出来。
|
||||
|
||||
## 4. 总结
|
||||
苹果的ARKit对空间平面的感知能力胜过了一般的AR渲染库。而iPhone 6S就能跑的特性又让我们觉得AR其实并没有那么遥远。在此基础之上的React Native封装`react-native-arkit`,让我们通过JS就拥有操作ARKit的能力。这的确是一个快速上手ARKit的方式。
|
||||
|
||||
|
||||
## 5 更多讨论
|
||||
讨论地址是:[精读《快速上手构建ARKit应用》 · Issue #70 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/70)
|
||||
|
||||
如果你想参与讨论,请[点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,每周末发布。
|
||||
@@ -0,0 +1,174 @@
|
||||
本系列是 SQL 系列的开篇,介绍一些宏观与基础的内容。
|
||||
|
||||
## SQL 是什么?
|
||||
|
||||
SQL 是一种结构化查询语言,用于管理关系型数据库,我们 90% 接触的都是查询语法,但其实它包含完整的增删改查和事物处理功能。
|
||||
|
||||
## 声明式特性
|
||||
|
||||
SQL 属于声明式编程语言,而现代通用编程语言一般都是命令式的。但是不要盲目崇拜声明式语言,比如说它未来会代替低级的命令式语言,因为声明式本身也有它的缺点,它与命令式语言也有相通的地方。
|
||||
|
||||
为什么我们觉得声明式编程语言更高级?因为声明式语言抽象程度更高,比如 `select * from table1` 仅描述了要从 table1 查询数据,但查询的具体步骤的完全没提,这背后可能存在复杂的索引优化与锁机制,但我们都无需关心,这简直是编程的最高境界。
|
||||
|
||||
那为什么现在所有通用业务代码都是命令式呢?因为 **命令式给了我们描述具体实现的机会** ,而通用领域的编程正需要建立在严谨的实现细节上。比如校验用户权限这件事,即便 AI 编程提供了将 “登陆用户仅能访问有权限的资源” 转化为代码的能力,我们也不清楚资源具体指哪些,以及在权限转移过程中的资源所有权属于谁。
|
||||
|
||||
SQL 之所以能保留声明式特性,完全因为锁定了关系型数据管理这个特定领域,而恰恰对这个领域的需求是标准化且可枚举的,才使声明式成为可能。
|
||||
|
||||
基于命令式语言也完全可拓展出声明式能力,比如许多 ORM 提供了类似 `select({}).from({}).where({})` 之类的语法,甚至一个 `login()` 函数也是声明式编程的体现,因为调用者无需关心是如何登陆的,总之调用一下就完成了登陆,这不就是声明式的全部精髓吗?
|
||||
|
||||
## 语法分类
|
||||
|
||||
作为关系型数据库管理工具,SQL 需要定义、操纵与控制数据。
|
||||
|
||||
数据定义即修改数据库与表级别结构,这些是数据结构,或者是数据元信息,它不代表具体数据,但描述数据的属性。
|
||||
|
||||
数据操纵即修改一行行具体数据,增删改查。
|
||||
|
||||
数据控制即对事务、用户权限的管理与控制。
|
||||
|
||||
### 数据定义
|
||||
|
||||
DDL(Data Definition Language)数据定义,包括 `CREATE` `DROP` `ALTER` 方法。
|
||||
|
||||
### 数据操纵
|
||||
|
||||
DML(Data Manipulation Language)数据操纵,包括 `SELECT` `INSERT` `UPDATE` `DELETE` 方法。
|
||||
|
||||
### 数据控制
|
||||
|
||||
DCL(Data Control Language)数据控制,包括 `COMMIT`、`ROLLBACK` 等。
|
||||
|
||||
所有 SQL 操作都围绕这三种类型,其中数据操纵几乎占了 90% 的代码量,毕竟数据查询的诉求远大于写,数据写入对应数据采集,而数据查询对应数据分析,数据分析领域能玩出的花样远比数据采集要多。
|
||||
|
||||
PS:有些情况下,会把最重要的 `SELECT` 提到 DQL(Data Query Language)分类下,这样分类就变成了四个。
|
||||
|
||||
## 集合运算
|
||||
|
||||
SQL 世界的第一公民是集合,就像 JAVA 世界第一公民是对象。我们只有以集合的视角看待 SQL,才能更好的理解它。
|
||||
|
||||
何为集合视角,即所有的查询、操作都是二维数据结构中进行的,而非小学算术里的单个数字间加减乘除关系。
|
||||
|
||||
集合的运算一般有 `UNION` 并集、`EXCEPT` 差集、`INTERSECT` 交集,这些都是以行为单位的操作,而各种 JOIN 语句则是以列为单位的集合运算,也是后面提到的连接查询。
|
||||
|
||||
只要站在二维数据结构中进行思考,运算无非是横向或纵向的操作。
|
||||
|
||||
## 数据范式
|
||||
|
||||
数据范式分为五层,每层要求都比上一层更严苛,因此是一个可以逐步遵循的范式。数据范式要求数据越来越解耦,减少冗余。
|
||||
|
||||
比如第一范式要求每列都具有原子性,即都是不可分割的最小数据单元。如果数据采集时,某一列作为字符串存储,并且以 "|" 分割表示省市区,那么它就不具有原子性。
|
||||
|
||||
当然实际生产过程往往不都遵循这种标准,因为表不是孤立的,在数据处理流中,可能在某个环节再把列原子化,而原始数据为了压缩体积,进行列合并处理。
|
||||
|
||||
希望违反范式的还不仅是底层表,现在大数据处理场景下,越来越多的业务采用大宽表结构,甚至故意进行数据冗余以提升查询效率,列存储引擎就是针对这种场景设计的,所以数据范式在大数据场景下是可以变通的,但依然值得学习。
|
||||
|
||||
## 聚合
|
||||
|
||||
当采用 GROUP BY 分组聚合数据时,如希望针对聚合值筛选,就不能用 WHERE 限定条件了,因为 WHERE 是基于行的筛选,而不是针对组合的。(GROUP BY 对数据进行分组,我们称这些组为 “组合”),所以需要使用针对组合的筛选语句 HAVING:
|
||||
|
||||
```sql
|
||||
SELECT SUM(pv) FROM table
|
||||
GROUP BY city
|
||||
HAVING AVG(uv) > 100
|
||||
```
|
||||
|
||||
这个例子中,如果 HAVING 换成 WHERE 就没有意义,因为 WHERE 加聚合条件时,需要对所有数据进行合并,不符合当前视图的详细级别。(关于视图详细级别,在我之前写的 [精读《什么是 LOD 表达式》](https://github.com/ascoders/weekly/blob/master/%E5%89%8D%E6%B2%BF%E6%8A%80%E6%9C%AF/215.%E7%B2%BE%E8%AF%BB%E3%80%8A%E4%BB%80%E4%B9%88%E6%98%AF%20LOD%20%E8%A1%A8%E8%BE%BE%E5%BC%8F%E3%80%8B.md) 有详细说明)。
|
||||
|
||||
聚合如此重要,是因为我们分析数据必须在高 LEVEL 视角看,明细数据是看不出趋势的。而复杂的需求往往伴随着带有聚合的筛选条件,明白 SQL 是如何支持的非常重要。
|
||||
|
||||
## CASE 表达式
|
||||
|
||||
CASE 表达式分为简单与搜索 CASE 表达式,简单表达式:
|
||||
|
||||
```sql
|
||||
SELECT CASE pv WHEN 1 THEN 'low' ELSE 'high' END AS quality
|
||||
```
|
||||
|
||||
上面的例子利用 CASE 简单表达式形成了一个新字段,这种模式等于生成了业务自定义临时字段,在对当前表进行数据加工时非常有用。搜索 CASE 表达式能力完全覆盖简单 CASE 表达式:
|
||||
|
||||
```sql
|
||||
SELECT CASE WHEN pv < 100 THEN 'low' ELSE 'high' END AS quality
|
||||
```
|
||||
|
||||
可以看到,搜索 CASE 表达式可以用 “表达式” 描述条件,可以轻松完成更复杂的任务,甚至可以在表达式里使用子查询、聚合等手段,这些都是高手写 SQL 的惯用技巧,所以 CASE 表达式非常值得深入学习。
|
||||
|
||||
## 复杂查询
|
||||
|
||||
SELECT 是 SQL 最复杂的部分,其中就包含三种复杂查询模式,分别是连接查询与子查询。
|
||||
|
||||
### 连接查询
|
||||
|
||||
指 JOIN 查询,比如 LEFT JOIN、RIGHT JOIN、INNER JOIN。
|
||||
|
||||
在介绍聚合时我们提到了,连接查询本质上就是对列进行拓展,而两个表之间不会无缘无故合成一个,所以必须有一个外键作为关系纽带:
|
||||
|
||||
```sql
|
||||
SELECT A.pv, B.uv
|
||||
FROM table1 as t1 LEFT JOIN table2 AS P t2
|
||||
ON t1.productId = t2.productId
|
||||
```
|
||||
|
||||
连接查询不仅拓展了列,还会随之拓展行,而拓展方式与连接的查询的类型有关。除了连接查询别的表,还可以连接查询自己,比如:
|
||||
|
||||
```sql
|
||||
SELECT t1.pv AS pv1, P2.pv AS pv2
|
||||
FROM tt t1, tt t2
|
||||
```
|
||||
|
||||
这种子连接查询结果就是自己对自己的笛卡尔积,可通过 WHERE 筛选去重,后面会有文章专门介绍。
|
||||
|
||||
### 子查询与视图
|
||||
|
||||
子查询就是 SELECT 里套 SELECT,一般来说 SELECT 会从内到外执行,只有在关联子查询模式下,才会从外到内执行。
|
||||
|
||||
而如果把子查询保存下来,就是一个视图,这个视图并不是实体表,所以很灵活,且数据会随着原始表数据而变化:
|
||||
|
||||
```sql
|
||||
CREATE VIEW countryGDP (country, gdp)
|
||||
AS
|
||||
SELECT country, SUM(gdp)
|
||||
FROM tt
|
||||
GROUP BY country
|
||||
```
|
||||
|
||||
之后 `countryGDP` 这个视图就可以作为临时表来用了。
|
||||
|
||||
这种模式其实有点违背 SQL 声明式的特点,因为定义视图类似于定义变量,如果继续写下去,势必会形成一定命令式思维逻辑,但这是无法避免的。
|
||||
|
||||
## 事务
|
||||
|
||||
当 SQL 执行一连串操作时,难免遇到不执行完就会出现脏数据的问题,所以事务可以保证操作的原子性。一般来说每个 DML 操作都是一个内置事务,而 SQL 提供的 START TRANSACTION 就是让我们可以自定义事务范围,使一连串业务操作都可以包装在一起,成为一个原子性操作。
|
||||
|
||||
对 SQL 来说,原子性操作是非常安全的,即失败了不会留下任何痕迹,成功了会全部成功,不会存在中间态。
|
||||
|
||||
## OLAP
|
||||
|
||||
OLAP(OnLine Analytical Processing)即实时数据分析,是 BI 工具背后计算引擎实现的基础。
|
||||
|
||||
现在越来越多的 SQL 数据库支持了窗口函数实现,用于实现业务上的 runningSum 或 runningAvg 等功能,这些都是数据分析中很常见的。
|
||||
|
||||
以 runningSum 为例,比如双十一实时表的数据是以分钟为单位的实时 GMV,而我们要做一张累计到当前时间的 GMV 汇总折线图,Y 轴就需要支持 `running_sum(GMV)` 这样的表达式,而这背后可能就是通过窗口函数实现的。
|
||||
|
||||
当然也不是所有业务函数都由 SQL 直接提供,业务层仍需实现大量内存函数,在 JAVA 层计算,这其中一部分是需要下推到 SQL 执行的,只有内存函数与下推函数结合在一起,才能形成我们在 BI 工具看到的复杂计算字段效果。
|
||||
|
||||
## 总结
|
||||
|
||||
SQL 是一种声明式语言,一个看似简单的查询语句,在引擎层往往对应着复杂的实现,这就是 SQL 为何如此重要却又如此普及的原因。
|
||||
|
||||
虽然 SQL 容易上手,但要系统的理解它,还得从结构化数据与集合的概念开始进行思想转变。
|
||||
|
||||
不要小看 CASE 语法,它不仅与容易与编程语言的 CASE 语法产生混淆,本身结合表达式进行条件分支判断,是许多数据分析师在日常工作中最长用的套路。
|
||||
|
||||
现在使用简单 SQL 创建应用的场景越来越少了,但 BI 场景下,基于 SQL 的增强表达式场景越来越多了,本系列我就是以理解 BI 场景下查询表达式为目标创建的,希望能够学以致用。
|
||||
|
||||
> 讨论地址是:[精读《SQL 入门》· Issue #398 · ascoders/weekly](https://github.com/ascoders/weekly/issues/398)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/ascoders/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
|
||||
|
||||
@@ -0,0 +1,199 @@
|
||||
SQL 为什么要支持聚合查询呢?
|
||||
|
||||
这看上去是个幼稚的问题,但我们还是一步步思考一下。数据以行为粒度存储,最简单的 SQL 语句是 `select * from test`,拿到的是整个二维表明细,但仅做到这一点远远不够,出于以下两个目的,需要 SQL 提供聚合函数:
|
||||
|
||||
1. 明细数据没有统计意义,比如我想知道今天的营业额一共有多少,而不太关心某桌客人消费了多少。
|
||||
2. 虽然可以先把数据查到内存中再聚合,但在数据量非常大的情况下很容易把内存撑爆,可能一张表一天的数据量就有 10TB,而 10TB 数据就算能读到内存里,聚合计算可能也会慢到难以接受。
|
||||
|
||||
另外聚合本身也有一定逻辑复杂度,而 SQL 提供了聚合函数与分组聚合能力,可以方便快速的统计出有业务价值的聚合数据,这奠定了 SQL 语言的分析价值,因此大部分分析软件直接采用 SQL 作为直接面向用户的表达式。
|
||||
|
||||
## 聚合函数
|
||||
|
||||
常见的聚合函数有:
|
||||
|
||||
- COUNT:计数。
|
||||
- SUM:求和。
|
||||
- AVG:求平均值。
|
||||
- MAX:求最大值。
|
||||
- MIN:求最小值。
|
||||
|
||||
### COUNT
|
||||
|
||||
COUNT 用来计算有多少条数据,比如我们看 id 这一列有多少条:
|
||||
|
||||
```sql
|
||||
SELECT COUNT(id) FROM test
|
||||
```
|
||||
|
||||
但我们发现其实查任何一列的 COUNT 都是一样的,那传入 id 有什么意义呢?没必要特殊找一个具体列指代呀,所以也可以写成:
|
||||
|
||||
```sql
|
||||
SELECT COUNT(*) FROM test
|
||||
```
|
||||
|
||||
但这两者存在微妙差异。SQL 存在一种很特殊的值类型 `NULL`,如果 COUNT 指定了具体列,则统计时会跳过此列值为 `NULL` 的行,而 `COUNT(*)` 由于未指定具体列,所以就算包含了 `NULL`,甚至某一行所有列都为 `NULL`,也都会包含进来。所以 `COUNT(*)` 查出的结果一定大于等于 `COUNT(c1)`。
|
||||
|
||||
当然任何聚合函数都可以跟随查询条件 WHERE,比如:
|
||||
|
||||
```sql
|
||||
SELECT COUNT(*) FROM test
|
||||
WHERE is_gray = 1
|
||||
```
|
||||
|
||||
### SUM
|
||||
|
||||
SUM 求和所有项,因此必须作用于数值字段,而不能用于字符串。
|
||||
|
||||
```sql
|
||||
SELECT SUM(cost) FROM test
|
||||
```
|
||||
|
||||
SUM 遇到 NULL 值时当 0 处理,因为这等价于忽略。
|
||||
|
||||
### AVG
|
||||
|
||||
AVG 求所有项均值,因此必须作用于数值字段,而不能用于字符串。
|
||||
|
||||
```sql
|
||||
SELECT AVG(cost) FROM test
|
||||
```
|
||||
|
||||
AVG 遇到 NULL 值时采用了最彻底的忽略方式,即 NULL 完全不参与分子与分母的计算,就像这一行数据不存在一样。
|
||||
|
||||
### MAX、MIN
|
||||
|
||||
MAX、MIN 分别求最大与最小值,与上面不同的是,也可以作用于字符串上,因此可以根据字母判断大小,从大到小依次对应 `a-z`,但即便能算,也没有实际意义且不好理解,因此不建议对字符串求极值。
|
||||
|
||||
```sql
|
||||
SELECT MAX(cost) FROM test
|
||||
```
|
||||
|
||||
### 多个聚合字段
|
||||
|
||||
虽然都是聚合函数,但 MAX、MIN 严格意义上不算是聚合函数,因为它们只是寻找了满足条件的行。可以看看下面两段查询结果的对比:
|
||||
|
||||
```sql
|
||||
SELECT MAX(cost), id FROM test -- id: 100
|
||||
SELECT SUM(cost), id FROM test -- id: 1
|
||||
```
|
||||
|
||||
第一条查询可以找到最大值那一行的 id,而第二条查询的 id 是无意义的,因为不知道归属在哪一行,所以只返回了第一条数据的 id。
|
||||
|
||||
当然,如果同时计算 MAX、MIN,那么此时 id 也只返回第一条数据的值,因为这个查询结果对应了复数行:
|
||||
|
||||
```sql
|
||||
SELECT MAX(cost), MIN(cost), id FROM test -- id: 1
|
||||
```
|
||||
|
||||
基于这些特性,最好不要混用聚合与非聚合,也就是一条查询一旦有一个字段是聚合的,那么所有字段都要聚合。
|
||||
|
||||
现在很多 BI 引擎的自定义字段都有这条限制,因为混用聚合与非聚合在自定义内存计算时处理起来边界情况很多,虽然 SQL 能支持,但业务自定义的函数可能不支持。
|
||||
|
||||
## 分组聚合
|
||||
|
||||
分组聚合就是 GROUP BY,其实可以把它当作一种高级的条件语句。
|
||||
|
||||
举个例子,查询每个国家的 GDP 总量:
|
||||
|
||||
```sql
|
||||
SELECT SUM(GDP) FROM amazing_table
|
||||
GROUP BY country
|
||||
```
|
||||
|
||||
返回的结果就会按照国家进行分组,这时,聚合函数就变成了在组内聚合。
|
||||
|
||||
其实如果我们只想看中、美的 GDP,用非分组也可以查,只是要分成两条 SQL:
|
||||
|
||||
```sql
|
||||
SELECT SUM(GDP) FROM amazing_table
|
||||
WHERE country = '中国'
|
||||
|
||||
SELECT SUM(GDP) FROM amazing_table
|
||||
WHERE country = '美国'
|
||||
```
|
||||
|
||||
所以 GROUP BY 也可理解为,将某个字段的所有可枚举的情况都查了出来,并整合成一张表,每一行代表了一种枚举情况,不需要分解为一个个 WHERE 查询了。
|
||||
|
||||
### 多字段分组聚合
|
||||
|
||||
GROUP BY 可以对多个维度使用,含义等价于表格查询时行/列拖入多个维度。
|
||||
|
||||
上面是 BI 查询工具视角,如果没有上下文,可以看下面这个递进描述:
|
||||
|
||||
- 按照多个字段进行分组聚合。
|
||||
- 多字段组合起来成为唯一 Key,即 `GROUP BY a,b` 表示 a,b 合在一起描述一个组。
|
||||
- `GROUP BY a,b,c` 查询结果第一列可能看到许多重复的 a 行,第二列看到重复 b 行,但在同一个 a 值内不会重复,c 在 b 行中同理。
|
||||
|
||||
下面是一个例子:
|
||||
|
||||
```sql
|
||||
SELECT SUM(GDP) FROM amazing_table
|
||||
GROUP BY province, city, area
|
||||
```
|
||||
|
||||
查询结果为:
|
||||
|
||||
```text
|
||||
浙江 杭州 余杭区
|
||||
浙江 杭州 西湖区
|
||||
浙江 宁波 海曙区
|
||||
浙江 宁波 江北区
|
||||
北京 .........
|
||||
```
|
||||
|
||||
### GROUP BY + WHERE
|
||||
|
||||
WHERE 是根据行进行条件筛选的。因此 GROUP BY + WHERE 并不是在组内做筛选,而是对整体做筛选。
|
||||
|
||||
但由于按行筛选,其实组内或非组内结果都完全一样,所以我们几乎无法感知这种差异:
|
||||
|
||||
```sql
|
||||
SELECT SUM(GDP) FROM amazing_table
|
||||
GROUP BY province, city, area
|
||||
WHERE industry = 'internet'
|
||||
```
|
||||
|
||||
然而,忽略这个差异会导致我们在聚合筛选时碰壁。
|
||||
|
||||
比如要筛选出平均分大于 60 学生的成绩总和,如果不使用子查询,是无法在普通查询中在 WHERE 加聚合函数实现的,比如下面就是一个语法错误的例子:
|
||||
|
||||
```sql
|
||||
SELECT SUM(score) FROM amazing_table
|
||||
WHERE AVG(score) > 60
|
||||
```
|
||||
|
||||
不要幻想上面的 SQL 可以执行成功,不要在 WHERE 里使用聚合函数。
|
||||
|
||||
### GROUP BY + HAVING
|
||||
|
||||
HAVING 是根据组进行条件筛选的。因此可以在 HAVING 使用聚合函数:
|
||||
|
||||
```sql
|
||||
SELECT SUM(score) FROM amazing_table
|
||||
GROUP BY class_name
|
||||
HAVING AVG(score) > 60
|
||||
```
|
||||
|
||||
上面的例子中可以正常查询,表示按照班级分组看总分,且仅筛选出平均分大于 60 的班级。
|
||||
|
||||
所以为什么 HAVING 可以使用聚合条件呢?因为 HAVING 筛选的是组,所以可以对组聚合后过滤掉不满足条件的组,这样是有意义的。而 WHERE 是针对行粒度的,聚合后全表就只有一条数据,无论过滤与否都没有意义。
|
||||
|
||||
但要注意的是,GROUP BY 生成派生表是无法利用索引筛选的,所以 WHERE 可以利用给字段建立索引优化性能,而 HAVING 针对索引字段不起作用。
|
||||
|
||||
## 总结
|
||||
|
||||
聚合函数 + 分组可以实现大部分简单 SQL 需求,在写 SQL 表达式时,需要思考这样的表达式是如何计算的,比如 `MAX(c1), c2` 是合理的,而 `SUM(c1), c2` 这个 `c2` 就是无意义的。
|
||||
|
||||
最后记住 WHERE 是 GROUP BY 之前执行的,HAVING 针对组进行筛选。
|
||||
|
||||
> 讨论地址是:[精读《SQL 聚合查询》· Issue #401 · ascoders/weekly](https://github.com/ascoders/weekly/issues/401)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/ascoders/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
|
||||
|
||||
@@ -0,0 +1,176 @@
|
||||
SQL 复杂查询指的就是子查询。
|
||||
|
||||
为什么子查询叫做复杂查询呢?因为子查询相当于查询嵌套查询,因为嵌套导致复杂度几乎可以被无限放大(无限嵌套),因此叫复杂查询。下面是一个最简单的子查询例子:
|
||||
|
||||
```sql
|
||||
SELECT pv FROM (
|
||||
SELECT pv FROM test
|
||||
)
|
||||
```
|
||||
|
||||
上面的例子等价于 `SELECT pv FROM test`,但因为把表的位置替换成了一个新查询,所以摇身一变成为了复杂查询!所以复杂查询不一定真的复杂,甚至可能写出和普通查询等价的复杂查询,要避免这种无意义的行为。
|
||||
|
||||
我们也要借此机会了解为什么子查询可以这么做。
|
||||
|
||||
### 理解查询的本质
|
||||
|
||||
当我们查一张表时,数据库认为我们在查什么?
|
||||
|
||||
这点很重要,因为下面两个语句都是合法的:
|
||||
|
||||
```sql
|
||||
SELECT pv FROM test
|
||||
|
||||
SELECT pv FROM (
|
||||
SELECT pv FROM test
|
||||
)
|
||||
```
|
||||
|
||||
为什么数据库可以把子查询当作表呢?为了统一理解这些概念,我们有必要对查询内容进行抽象理解:**任意查询位置都是一条或多条记录**。
|
||||
|
||||
比如 `test` 这张表,显然是多条记录(当然只有一行就是一条记录),而 `SELECT pv FROM test` 也是多条记录,然而因为 `FROM` 后面可以查询任意条数的记录,所以这两种语法都支持。
|
||||
|
||||
不仅是 `FROM` 可以跟单条或多条记录,甚至 `SELECT`、`GROUP BY`、`WHERE`、`HAVING` 后都可以跟多条记录,这个后面再说。
|
||||
|
||||
说到这,也就很好理解子查询的变种了,比如我们可以在子查询内使用 `WHERE` 或 `GROUP BY` 等等,因为无论如何,只要查询结果是多条记录就行了:
|
||||
|
||||
```sql
|
||||
SELECT sum(people) as allPeople, sum(gdp), city FROM (
|
||||
SELECT people, gdp, city FROM test
|
||||
GROUP BY city
|
||||
HAVING sum(gdp) > 10000
|
||||
)
|
||||
```
|
||||
|
||||
这个例子就有点业务含义了。子查询是从内而外执行的,因此我们先看内部的逻辑:按照城市分组,筛选出总 GDP 超过一万的所有地区的人口数量明细。外层查询再把人口数加总,这样就能对比每个 GDP 超过一万的地区,总人口和总 GDP 分别是多少,方便对这些重点城市做对比。
|
||||
|
||||
不过这个例子看起来还是不太自然,因为我们没必要写成复杂查询,其实简单查询也是等价的:
|
||||
|
||||
```sql
|
||||
SELECT sum(people) as allPeople, sum(gdp), city FROM test
|
||||
GROUP BY city
|
||||
HAVING sum(gdp) > 10000
|
||||
```
|
||||
|
||||
那为什么要多此一举呢?因为复杂查询的真正用法并不在这里。
|
||||
|
||||
### 视图
|
||||
|
||||
正因为子查询的存在,我们才可能以类似抽取变量的方式,抽取子查询,这个抽取出来的抽象就是视图:
|
||||
|
||||
```sql
|
||||
CREATE VIEW my_table(people, gdp, city)
|
||||
AS
|
||||
SELECT sum(people) as allPeople, sum(gdp), city FROM test
|
||||
GROUP BY city
|
||||
HAVING sum(gdp) > 10000
|
||||
|
||||
SELECT sum(people) as allPeople, sum(gdp), city FROM my_table
|
||||
```
|
||||
|
||||
这样的好处是,这个视图可以被多条 SQL 语句复用,不仅可维护性变好了,执行时也仅需查询一次。
|
||||
|
||||
要注意的是,SELECT 可以使用任何视图,但 INSERT、DELETE、UPDATE 用于视图时,需要视图满足一下条件:
|
||||
|
||||
1. 未使用 DISTINCT 去重。
|
||||
2. FROM 单表。
|
||||
3. 未使用 GROUP BY 和 HAVING。
|
||||
|
||||
因为上面几种模式都会导致视图成为聚合后的数据,不方便做除了查以外的操作。
|
||||
|
||||
另外一个知识点就是物化视图,即使用 MATERIALIZED 描述视图:
|
||||
|
||||
```sql
|
||||
CREATE MATERIALIZED VIEW my_table(people, gdp, city)
|
||||
AS ...
|
||||
```
|
||||
|
||||
这种视图会落盘,为什么要支持这个特性呢?因为普通视图作为临时表,无法利用索引等优化手段,查询性能较低,所以物化视图是较为常见的性能优化手段。
|
||||
|
||||
说到性能优化手段,还有一些比较常见的理念,即把读的复杂度分摊到写的时候,比如提前聚合新表落盘或者对 CASE 语句固化为字段等,这里先不展开。
|
||||
|
||||
### 标量子查询
|
||||
|
||||
上面说了,WHERE 也可以跟子查询,比如:
|
||||
|
||||
```sql
|
||||
SELECT city FROM test
|
||||
WHERE gdp > (
|
||||
SELECT avg(gdp) from test
|
||||
)
|
||||
```
|
||||
|
||||
这样可以查询出 gdp 大于平均值的城市。
|
||||
|
||||
那为什么不能直接这么写呢?
|
||||
|
||||
```sql
|
||||
SELECT city FROM test
|
||||
WHERE gdp > avg(gdp) -- 报错,WHERE 无法使用聚合函数
|
||||
```
|
||||
|
||||
看上去很美好,但其实第一篇我们就介绍了,WHERE 不能跟聚合查询,因为这样会把整个父查询都聚合起来。那为什么子查询可以?因为子查询聚合的是子查询啊,父查询并没有被聚合,所以这才符合我们的意图。
|
||||
|
||||
所以上面例子不合适的地方在于,直接在当前查询使用 `avg(gdp)` 会导致聚合,而我们并不想聚合当前查询,但又要通过聚合拿到平均 GDP,所以就要使用子查询了!
|
||||
|
||||
回过头来看,为什么这一节叫标量子查询?标量即单一值,因为 `avg(gdp)` 聚合出来的只有一个值,所以 WHERE 可以把它当做一个单一数值使用。反之,如果子查询没有使用聚合函数,或 GROUP BY 分组,那么就不能使用 `WHERE >` 这种语法,但可以使用 `WHERE IN`,这涉及到单条与多条记录的思考,我们接着看下一节。
|
||||
|
||||
### 单条和多条记录
|
||||
|
||||
介绍标量子查询时说到了,`WHERE >` 的值必须时单一值。但其实 WHERE 也可以跟返回多条记录的子查询结果,只要使用合理的条件语句,比如 IN:
|
||||
|
||||
```sql
|
||||
SELECT area FROM test
|
||||
WHERE gdp IN (
|
||||
SELECT max(gdp) from test
|
||||
GROUP BY city
|
||||
)
|
||||
```
|
||||
|
||||
上面的例子,子查询按照城市分组,并找到每一组 GDP 最大的那条记录,所以如果数据粒度是区域,那么我们就查到了每个城市 GDP 最大的那些记录,然后父查询通过 WHERE IN 找到 gdp 符合的复数结果,所以最后就把每个城市最大 gdp 的区域列了出来。
|
||||
|
||||
但实际上 `WHERE >` 语句跟复数查询结果也不会报错,但没有任何意义,所以我们要理解查询结果是单条还是多条,在 WHERE 判断时选择合适的条件。WHERE 适合跟复数查询结果的语法有:`WHERE IN`、`WHERE SOME`、`WHERE ANY`。
|
||||
|
||||
### 关联子查询
|
||||
|
||||
所谓关联子查询,即父子查询间存在关联,既然如此,子查询肯定不能单独优先执行,毕竟和父查询存在关联嘛,所以关联子查询是先执行外层查询,再执行内层查询的。要注意的是,对每一行父查询,子查询都会执行一次,因此性能不高(当然 SQL 会对相同参数的子查询结果做缓存)。
|
||||
|
||||
那这个关联是什么呢?关联的是每一行父查询时,对子查询执行的条件。这么说可能有点绕,举个例子:
|
||||
|
||||
```sql
|
||||
SELECT * FROM test where gdp > (
|
||||
select avg(gdp) from test
|
||||
group by city
|
||||
)
|
||||
```
|
||||
|
||||
对这个例子来说,想要查找 gdp 大于按城市分组的平均 gdp,比如北京地区按北京比较,上海地区按上海比较。但很可惜这样做是不行的,因为父子查询没有关联,SQL 并不知道要按照相同城市比较,因此只要加一个 WHERE 条件,就变成关联子查询了:
|
||||
|
||||
```sql
|
||||
SELECT * FROM test as t1 where gdp > (
|
||||
select avg(gdp) from test as t2 where t1.city = t2.city
|
||||
group by city
|
||||
)
|
||||
```
|
||||
|
||||
就是在每次判断 `WHERE gdp >` 条件时,重新计算子查询结果,将平均值限定在相同的城市,这样就符合需求了。
|
||||
|
||||
## 总结
|
||||
|
||||
学会灵活运用父子查询,就掌握了复杂查询了。
|
||||
|
||||
SQL 第一公民是集合,所以所谓父子查询就是父子集合的灵活组合,这些集合可以出现在几乎任何位置,根据集合的数量、是否聚合、关联条件,就派生出了标量查询、关联子查询。
|
||||
|
||||
更深入的了解就需要大量实战案例了,但万变不离其宗,掌握了复杂查询后,就可以理解大部分 SQL 案例了。
|
||||
|
||||
> 讨论地址是:[精读《SQL 复杂查询》· Issue #403 · ascoders/weekly](https://github.com/ascoders/weekly/issues/403)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/ascoders/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
|
||||
|
||||
@@ -0,0 +1,154 @@
|
||||
CASE 表达式分为简单表达式与搜索表达式,其中搜索表达式可以覆盖简单表达式的全部能力,我也建议只写搜索表达式,而不要写简单表达式。
|
||||
|
||||
简单表达式:
|
||||
|
||||
```sql
|
||||
SELECT CASE city
|
||||
WHEN '北京' THEN 1
|
||||
WHEN '天津' THEN 2
|
||||
ELSE 0
|
||||
END AS abc
|
||||
FROM test
|
||||
```
|
||||
|
||||
搜索表达式:
|
||||
|
||||
```sql
|
||||
SELECT CASE
|
||||
WHEN city = '北京' THEN 1
|
||||
WHEN city = '天津' THEN 2
|
||||
ELSE 0
|
||||
END AS abc
|
||||
FROM test
|
||||
```
|
||||
|
||||
明显可以看出,简单表达式只是搜索表达式 `a = b` 的特例,因为无法书写任何符号,只要条件换成 `a > b` 就无法胜任了,而搜索表达式不但可以轻松胜任,甚至可以写聚合函数。
|
||||
|
||||
## CASE 表达式里的聚合函数
|
||||
|
||||
为什么 CASE 表达式里可以写聚合函数?
|
||||
|
||||
因为本身表达式就支持聚合函数,比如下面的语法,我们不会觉得奇怪:
|
||||
|
||||
```sql
|
||||
SELECT sum(pv), avg(uv) from test
|
||||
```
|
||||
|
||||
本身 SQL 就支持多种不同的聚合方式同时计算,所以将其用在 CASE 表达式里,也是顺其自然的:
|
||||
|
||||
```sql
|
||||
SELECT CASE
|
||||
WHEN count(city) = 100 THEN 1
|
||||
WHEN sum(dau) > 200 THEN 2
|
||||
ELSE 0
|
||||
END AS abc
|
||||
FROM test
|
||||
```
|
||||
|
||||
只要 SQL 表达式中存在聚合函数,那么整个表达式都聚合了,此时访问非聚合变量没有任何意义。所以上面的例子,即便在 CASE 表达式中使用了聚合,其实也不过是聚合了一次后,按照条件进行判断罢了。
|
||||
|
||||
这个特性可以解决很多实际问题,比如将一些复杂聚合判断条件的结果用 SQL 结构输出,那么很可能是下面这种写法:
|
||||
|
||||
```sql
|
||||
SELECT CASE
|
||||
WHEN 聚合函数(字段) 符合什么条件 THEN xxx
|
||||
... 可能有 N 个
|
||||
ELSE NULL
|
||||
END AS abc
|
||||
FROM test
|
||||
```
|
||||
|
||||
这也可以认为是一种行转列的过程,即 **把行聚合后的结果通过一条条 CASE 表达式形成一个个新的列**。
|
||||
|
||||
## 聚合与非聚合不能混用
|
||||
|
||||
我们希望利用 CASE 表达式找出那些 pv 大于平均值的行,以下这种想当然的写法是错误的:
|
||||
|
||||
```sql
|
||||
SELECT CASE
|
||||
WHEN pv > avg(pv) THEN 'yes'
|
||||
ELSE 'no'
|
||||
END AS abc
|
||||
FROM test
|
||||
```
|
||||
|
||||
原因是,只要 SQL 中存在聚合表达式,那么整条 SQL 就都是聚合的,所以返回的结果只有一条,而我们期望查询结果不聚合,只是判断条件用到了聚合结果,那么就要使用子查询。
|
||||
|
||||
为什么子查询可以解决问题?因为子查询的聚合发生在子查询,而不影响当前父查询,理解了这一点,就知道为什么下面的写法才是正确的了:
|
||||
|
||||
```sql
|
||||
SELECT CASE
|
||||
WHEN pv > ( SELECT avg(pv) from test ) THEN 'yes'
|
||||
ELSE 'no'
|
||||
END AS abc
|
||||
FROM test
|
||||
```
|
||||
|
||||
这个例子也说明了 CASE 表达式里可以使用子查询,因为子查询是先计算的,所以查询结果在哪儿都能用,CASE 表达式也不例外。
|
||||
|
||||
## WHERE 中的 CASE
|
||||
|
||||
WHERE 后面也可以跟 CASE 表达式的,用来做一些需要特殊枚举处理的筛选。
|
||||
|
||||
比如下面的例子:
|
||||
|
||||
```sql
|
||||
SELECT * FROM demo WHERE
|
||||
CASE
|
||||
WHEN city = '北京' THEN true
|
||||
ELSE ID > 5
|
||||
END
|
||||
```
|
||||
|
||||
本来我们要查询 ID 大于 5 的数据,但我想对北京这个城市特别对待,那么就可以在判断条件中再进行 CASE 分支判断。
|
||||
|
||||
这个场景在 BI 工具里等价于,创建一个 CASE 表达式字段,可以拖入筛选条件生效。
|
||||
|
||||
## GROUP BY 中的 CASE
|
||||
|
||||
想不到吧,GROUP BY 里都可以写 CASE 表达式:
|
||||
|
||||
```sql
|
||||
SELECT isPower, sum(gdp) FROM test GROUP BY CASE
|
||||
WHEN isPower = 1 THEN city, area
|
||||
ELSE city
|
||||
END
|
||||
```
|
||||
|
||||
上面例子表示,计算 GDP 时,对于非常发达的城市,按照每个区粒度查看聚合结果,也就是看的粒度更细一些,而对于欠发达地区,本身 gdp 也不高,直接按照城市粒度看聚合结果。
|
||||
|
||||
这样,就按照不同的条件对数据进行了分组聚合。由于返回行结果是混在一起的,像这个例子,可以根据 isPower 字段是否为 1 判断,是否按照城市、区域进行了聚合,如果没有其他更显著的标识,可能导致无法区分不同行的聚合粒度,因此谨慎使用。
|
||||
|
||||
## ORDER BY 中的 CASE
|
||||
|
||||
同样,ORDER BY 使用 CASE 表达式,会将排序结果按照 CASE 分类进行分组,每组按照自己的规则排序,比如:
|
||||
|
||||
```sql
|
||||
SELECT * FROM test ORDER BY CASE
|
||||
WHEN isPower = 1 THEN gdp
|
||||
ELSE people
|
||||
END
|
||||
```
|
||||
|
||||
上面的例子,对发达地区采用 gdp 排序,否则采用人口数量排序。
|
||||
|
||||
## 总结
|
||||
|
||||
CASE 表达式总结一下有如下特点:
|
||||
|
||||
1. 支持简单与搜索两种写法,推荐搜索写法。
|
||||
2. 支持聚合与子查询,需要注意不同情况的特点。
|
||||
3. 可以写在 SQL 查询的几乎任何地方,只要是可以写字段的地方,基本上就可以替换为 CASE 表达式。
|
||||
4. 除了 SELECT 外,CASE 表达式还广泛应用在 INSERT 与 UPDATE,其中 UPDATE 的妙用是不用将 SQL 拆分为多条,所以不用担心数据变更后对判断条件的二次影响。
|
||||
|
||||
> 讨论地址是:[精读《SQL CASE 表达式》· Issue #404 · ascoders/weekly](https://github.com/ascoders/weekly/issues/404)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/ascoders/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
|
||||
|
||||
@@ -0,0 +1,124 @@
|
||||
窗口函数形如:
|
||||
|
||||
```sql
|
||||
表达式 OVER (PARTITION BY 分组字段 ORDER BY 排序字段)
|
||||
```
|
||||
|
||||
有两个能力:
|
||||
|
||||
1. 当表达式为 `rank()` `dense_rank()` `row_number()` 时,拥有分组排序能力。
|
||||
2. 当表达式为 `sum()` 等聚合函数时,拥有累计聚合能力。
|
||||
|
||||
无论何种能力,**窗口函数都不会影响数据行数,而是将计算平摊在每一行**。
|
||||
|
||||
这两种能力需要区分理解。
|
||||
|
||||
## 底表
|
||||
|
||||
<img width=500 src="https://s1.ax1x.com/2022/03/26/qdUL60.png">
|
||||
|
||||
以上是示例底表,共有 8 条数据,城市1、城市2 两个城市,下面各有地区1~4,每条数据都有该数据的人口数。
|
||||
|
||||
## 分组排序
|
||||
|
||||
如果按照人口排序,`ORDER BY people` 就行了,但如果我们想在城市内排序怎么办?
|
||||
|
||||
此时就要用到窗口函数的分组排序能力:
|
||||
|
||||
<img width=500 src="https://s1.ax1x.com/2022/03/26/qddfIg.png">
|
||||
|
||||
```sql
|
||||
SELECT *, rank() over (PARTITION BY city ORDER BY people) FROM test
|
||||
```
|
||||
|
||||
该 SQL 表示在 city 组内按照 people 进行排序。
|
||||
|
||||
其实 PARTITION BY 也是可选的,如果我们忽略它:
|
||||
|
||||
```sql
|
||||
SELECT *, rank() over (ORDER BY people) FROM test
|
||||
```
|
||||
|
||||
也是生效的,但该语句与普通 ORDER BY 等价,因此利用窗口函数进行分组排序时,一般都会使用 PARTITION BY。
|
||||
|
||||
### 各分组排序函数的差异
|
||||
|
||||
我们将 `rank()` `dense_rank()` `row_number()` 的结果都打印出来:
|
||||
|
||||
```sql
|
||||
SELECT *,
|
||||
rank() over (PARTITION BY city ORDER BY people),
|
||||
dense_rank() over (PARTITION BY city ORDER BY people),
|
||||
row_number() over (PARTITION BY city ORDER BY people)
|
||||
FROM test
|
||||
```
|
||||
|
||||
<img width=500 src="https://s1.ax1x.com/2022/03/26/qd0uh4.png">
|
||||
|
||||
其实从结果就可以猜到,这三个函数在处理排序遇到相同值时,对排名统计逻辑有如下差异:
|
||||
|
||||
1. `rank()`: 值相同时排名相同,但占用排名数字。
|
||||
2. `dense_rank()`: 值相同时排名相同,但不占用排名数字,整体排名更加紧凑。
|
||||
3. `row_number()`: 无论值是否相同,都强制按照行号展示排名。
|
||||
|
||||
上面的例子可以优化一下,因为所有窗口逻辑都是相同的,我们可以利用 WINDOW AS 提取为一个变量:
|
||||
|
||||
```sql
|
||||
SELECT *,
|
||||
rank() over wd, dense_rank() over wd, row_number() over wd
|
||||
FROM test
|
||||
WINDOW wd as (PARTITION BY city ORDER BY people)
|
||||
```
|
||||
|
||||
## 累计聚合
|
||||
|
||||
我们之前说过,凡事使用了聚合函数,都会让查询变成聚合模式。如果不用 GROUP BY,聚合后返回行数会压缩为一行,即使用了 GROUP BY,返回的行数一般也会大大减少,因为分组聚合了。
|
||||
|
||||
然而使用窗口函数的聚合却不会导致返回行数减少,那么这种聚合是怎么计算的呢?我们不如直接看下面的例子:
|
||||
|
||||
```sql
|
||||
SELECT *,
|
||||
sum(people) over (PARTITION BY city ORDER BY people)
|
||||
FROM test
|
||||
```
|
||||
|
||||
<img width=500 src="https://s1.ax1x.com/2022/03/26/qdsDJS.png">
|
||||
|
||||
可以看到,在每个 city 分组内,按照 people 排序后进行了 **累加**(相同的值会合并在一起),这就是 BI 工具一般说的 RUNNGIN_SUM 的实现思路,当然一般我们排序规则使用绝对不会重复的日期,所以不会遇到第一个红框中合并计算的问题。
|
||||
|
||||
累计函数还有 `avg()` `min()` 等等,这些都一样可以作用于窗口函数,其逻辑可以按照下图理解:
|
||||
|
||||
<img width=400 src="https://s1.ax1x.com/2022/03/26/qd6or9.png">
|
||||
|
||||
你可能有疑问,直接 `sum(上一行结果,下一行)` 不是更方便吗?为了验证猜想,我们试试 `avg()` 的结果:
|
||||
|
||||
<img width=400 src="https://s1.ax1x.com/2022/03/26/qdciIP.png">
|
||||
|
||||
可见,如果直接利用上一行结果的缓存,那么 avg 结果必然是不准确的,所以窗口累计聚合是每行重新计算的。当然也不排除对于 sum、max、min 做额外性能优化的可能性,但 avg 只能每行重头计算。
|
||||
|
||||
### 与 GROUP BY 组合使用
|
||||
|
||||
窗口函数是可以与 GROUP BY 组合使用的,遵循的规则是,窗口范围对后面的查询结果生效,所以其实并不关心是否进行了 GROUP BY。我们看下面的例子:
|
||||
|
||||
<img width=500 src="https://s1.ax1x.com/2022/03/26/qdgMOH.png">
|
||||
|
||||
按照地区分组后进行累加聚合,是对 GROUP BY 后的数据行粒度进行的,而不是之前的明细行。
|
||||
|
||||
## 总结
|
||||
|
||||
窗口函数在计算组内排序或累计 GVM 等场景非常有用,我们只要牢记两个知识点就行了:
|
||||
|
||||
1. 分组排序要结合 PARTITION BY 才有意义。
|
||||
2. 累计聚合作用于查询结果行粒度,支持所有聚合函数。
|
||||
|
||||
> 讨论地址是:[精读《SQL 窗口函数》· Issue #405 · ascoders/weekly](https://github.com/ascoders/weekly/issues/405)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/ascoders/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
|
||||
|
||||
@@ -0,0 +1,151 @@
|
||||
SQL grouping 解决 OLAP 场景总计与小计问题,其语法分为几类,但要解决的是同一个问题:
|
||||
|
||||
ROLLUP 与 CUBE 是封装了规则的 GROUPING SETS,而 GROUPING SETS 则是最原始的规则。
|
||||
|
||||
为了方便理解,让我们从一个问题入手,层层递进吧。
|
||||
|
||||
## 底表
|
||||
|
||||
<img width=500 src="https://s1.ax1x.com/2022/03/26/qdUL60.png">
|
||||
|
||||
以上是示例底表,共有 8 条数据,城市1、城市2 两个城市,下面各有地区1~4,每条数据都有该数据的人口数。
|
||||
|
||||
现在想计算人口总计,以及各城市人口小计。在没有掌握 grouping 语法前,我们只能通过两个 select 语句 union 后得到:
|
||||
|
||||
```sql
|
||||
SELECT city, sum(people) FROM test GROUP BY city
|
||||
union
|
||||
SELECT '合计' as city, sum(people) FROM test
|
||||
```
|
||||
|
||||
<img width=500 src="https://s1.ax1x.com/2022/04/04/qbKPRs.png">
|
||||
|
||||
但两条 select 语句聚合了两次,性能是一个不小的开销,因此 SQL 提供了 GROUPING SETS 语法解决这个问题。
|
||||
|
||||
## GROUPING SETS
|
||||
|
||||
GROUP BY GROUPING SETS 可以指定任意聚合项,比如我们要同时计算总计与分组合计,就要按照空内容进行 GROUP BY 进行一次 sum,再按照 city 进行 GROUP BY 再进行一次 sum,换成 GROUPING SETS 描述就是:
|
||||
|
||||
```sql
|
||||
SELECT
|
||||
city, area,
|
||||
sum(people)
|
||||
FROM test
|
||||
GROUP BY GROUPING SETS((), (city, area))
|
||||
```
|
||||
|
||||
其中 `GROUPING SETS((), (city, area))` 表示分别按照 `()`、`(city, area)` 聚合计算总计。返回结果是:
|
||||
|
||||
<img width=500 src="https://s1.ax1x.com/2022/04/04/qbRnWF.png">
|
||||
|
||||
可以看到,值为 NULL 的行就是我们要的总计,其值是没有任何 GROUP BY 限制算出来的。
|
||||
|
||||
类似的,我们还可以写 `GROUPING SETS((), (city), (city, area), (area))` 等任意数量、任意组合的 GROUP BY 条件。
|
||||
|
||||
通过这种规则计算的数据我们称为 “超级分组记录”。我们发现 “超级分组记录” 产生的 NULL 值很容易和真正的 NULL 值弄混,所以 SQL 提供了 GROUPING 函数解决这个问题。
|
||||
|
||||
## 函数 GROUPING
|
||||
|
||||
对于超级分组记录产生的 NULL,是可以被 `GROUPING()` 函数识别为 1 的:
|
||||
|
||||
```sql
|
||||
SELECT
|
||||
GROUPING(city),
|
||||
GROUPING(area),
|
||||
sum(people)
|
||||
FROM test
|
||||
GROUP BY GROUPING SETS((), (city, area))
|
||||
```
|
||||
|
||||
具体效果见下图:
|
||||
|
||||
<img width=500 src="https://s1.ax1x.com/2022/04/04/qbRLpF.png">
|
||||
|
||||
可以看到,但凡是超级分组计算出来的字段都会识别为 1,我们利用之前学习的 [SQL CASE 表达式](https://github.com/ascoders/weekly/blob/master/SQL/234.SQL%20CASE%20%E8%A1%A8%E8%BE%BE%E5%BC%8F.md) 将其转换为总计、小计字样,就可以得出一张数据分析表了:
|
||||
|
||||
```sql
|
||||
SELECT
|
||||
CASE WHEN GROUPING(city) = 1 THEN '总计' ELSE city END,
|
||||
CASE WHEN GROUPING(area) = 1 THEN '小计' ELSE area END,
|
||||
sum(people)
|
||||
FROM test
|
||||
GROUP BY GROUPING SETS((), (city, area))
|
||||
```
|
||||
|
||||
<img width=500 src="https://s1.ax1x.com/2022/04/04/qbRz01.png">
|
||||
|
||||
然后前端表格展示时,将第一行 “总计”、“小计” 单元格合并为 “总计”,就完成了总计这个 BI 可视化分析功能。
|
||||
|
||||
## ROLLUP
|
||||
|
||||
ROLLUP 是卷起的意思,是一种特定规则的 GROUPING SETS,以下两种写法是等价的:
|
||||
|
||||
```sql
|
||||
SELECT sum(people) FROM test
|
||||
GROUP BY ROLLUP(city)
|
||||
|
||||
-- 等价于
|
||||
SELECT sum(people) FROM test
|
||||
GROUP BY GROUPING SETS((), (city))
|
||||
```
|
||||
|
||||
再看一组等价描述:
|
||||
|
||||
```sql
|
||||
SELECT sum(people) FROM test
|
||||
GROUP BY ROLLUP(city, area)
|
||||
|
||||
-- 等价于
|
||||
SELECT sum(people) FROM test
|
||||
GROUP BY GROUPING SETS((), (city), (city, area))
|
||||
```
|
||||
|
||||
发现规律了吗?ROLLUP 会按顺序把 GROUP BY 内容 “一个个卷起来”。用 GROUPING 函数判断超级分组记录对 ROLLUP 同样适用。
|
||||
|
||||
## CUBE
|
||||
|
||||
CUBE 又有所不同,它对内容进行了所有可能性展开(所以叫 CUBE)。
|
||||
|
||||
类比上面的例子,我们再写两组等价的展开:
|
||||
|
||||
```sql
|
||||
SELECT sum(people) FROM test
|
||||
GROUP BY CUBE(city)
|
||||
|
||||
-- 等价于
|
||||
SELECT sum(people) FROM test
|
||||
GROUP BY GROUPING SETS((), (city))
|
||||
```
|
||||
|
||||
上面的例子因为只有一项还看不出来,下面两项分组就能看出来了:
|
||||
|
||||
```sql
|
||||
SELECT sum(people) FROM test
|
||||
GROUP BY CUBE(city, area)
|
||||
|
||||
-- 等价于
|
||||
SELECT sum(people) FROM test
|
||||
GROUP BY GROUPING SETS((), (city), (area), (city, area))
|
||||
```
|
||||
|
||||
所谓 CUBE,是一种多维形状的描述,二维时有 2^1 种展开,三维时有 2^2 种展开,四维、五维依此类推。可以想象,如果用 CUBE 描述了很多组合,复杂度会爆炸。
|
||||
|
||||
## 总结
|
||||
|
||||
学习了 GROUPING 语法,以后前端同学的你不会再纠结这个问题了吧:
|
||||
|
||||
> 产品开启了总计、小计,我们是额外取一次数还是放到一起获取啊?
|
||||
|
||||
这个问题的标准答案和原理都在这篇文章里了。PS:对于不支持 GROUPING 语法数据库,要想办法屏蔽,就像前端 polyfill 一样,是一种降级方案。至于如何屏蔽,参考文章开头提到的两个 SELECT + UNION。
|
||||
|
||||
> 讨论地址是:[精读《SQL grouping》· Issue #406 · ascoders/weekly](https://github.com/ascoders/weekly/issues/406)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/ascoders/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
|
||||
|
||||

|
Before Width: | Height: | Size: 23 KiB |

|
Before Width: | Height: | Size: 487 KiB |

|
Before Width: | Height: | Size: 44 KiB |

|
Before Width: | Height: | Size: 342 KiB |

|
Before Width: | Height: | Size: 818 KiB |

|
Before Width: | Height: | Size: 52 KiB |

|
Before Width: | Height: | Size: 69 KiB |

|
Before Width: | Height: | Size: 556 KiB |

|
Before Width: | Height: | Size: 19 KiB |

|
Before Width: | Height: | Size: 128 KiB |

|
Before Width: | Height: | Size: 24 KiB |

|
Before Width: | Height: | Size: 12 KiB |

|
Before Width: | Height: | Size: 414 KiB |

|
Before Width: | Height: | Size: 117 KiB |

|
Before Width: | Height: | Size: 62 KiB |

|
Before Width: | Height: | Size: 11 KiB |

|
Before Width: | Height: | Size: 136 KiB |

|
Before Width: | Height: | Size: 125 KiB |

|
Before Width: | Height: | Size: 9.0 KiB |

|
Before Width: | Height: | Size: 119 KiB |

|
Before Width: | Height: | Size: 6.3 KiB |

|
Before Width: | Height: | Size: 34 KiB |

|
Before Width: | Height: | Size: 32 KiB |

|
Before Width: | Height: | Size: 15 KiB |

|
Before Width: | Height: | Size: 203 KiB |

|
Before Width: | Height: | Size: 62 KiB |

|
Before Width: | Height: | Size: 35 KiB |

|
Before Width: | Height: | Size: 396 KiB |

|
Before Width: | Height: | Size: 40 KiB |

|
Before Width: | Height: | Size: 67 KiB |

|
Before Width: | Height: | Size: 42 KiB |

|
Before Width: | Height: | Size: 21 KiB |

|
Before Width: | Height: | Size: 33 KiB |

|
Before Width: | Height: | Size: 50 KiB |

|
Before Width: | Height: | Size: 30 KiB |

|
Before Width: | Height: | Size: 19 KiB |

|
Before Width: | Height: | Size: 68 KiB |

|
Before Width: | Height: | Size: 102 KiB |

|
Before Width: | Height: | Size: 82 KiB |

|
Before Width: | Height: | Size: 20 KiB |

|
Before Width: | Height: | Size: 20 KiB |

|
Before Width: | Height: | Size: 392 KiB |

|
Before Width: | Height: | Size: 47 KiB |

|
Before Width: | Height: | Size: 337 KiB |

|
Before Width: | Height: | Size: 294 KiB |

|
Before Width: | Height: | Size: 90 KiB |

|
Before Width: | Height: | Size: 48 KiB |

|
Before Width: | Height: | Size: 37 KiB |

|
Before Width: | Height: | Size: 9.7 KiB |

|
Before Width: | Height: | Size: 35 KiB |

|
Before Width: | Height: | Size: 18 KiB |

|
Before Width: | Height: | Size: 43 KiB |

|
Before Width: | Height: | Size: 312 KiB |

|
Before Width: | Height: | Size: 8.0 KiB |

|
Before Width: | Height: | Size: 121 KiB |

|
Before Width: | Height: | Size: 62 KiB |
@@ -0,0 +1,35 @@
|
||||
/**
|
||||
* 发布辅助脚本
|
||||
* @author 黄子毅
|
||||
*/
|
||||
|
||||
const fs = require("fs");
|
||||
|
||||
const dirs = [
|
||||
"前沿技术",
|
||||
"设计模式",
|
||||
"编译原理",
|
||||
"源码解读",
|
||||
"商业思考",
|
||||
"算法",
|
||||
"SQL"
|
||||
];
|
||||
|
||||
dirs.forEach((dir) => {
|
||||
const readDir = fs.readdirSync(`./${dir}`);
|
||||
|
||||
console.log(`### ${dir}\n`);
|
||||
|
||||
readDir
|
||||
.sort((left, right) => left.split(".")[0] - right.split(".")[0])
|
||||
.forEach((dirName) => {
|
||||
console.log(
|
||||
`- <a href="./${dir}/${encodeURIComponent(dirName)}">${dirName.replace(
|
||||
".md",
|
||||
""
|
||||
)}</a>`
|
||||
);
|
||||
});
|
||||
|
||||
console.log("");
|
||||
});
|
||||
@@ -0,0 +1,29 @@
|
||||
{
|
||||
"name": "weekly",
|
||||
"version": "1.0.0",
|
||||
"description": "前端界的好文精读,每周更新!",
|
||||
"main": "index.js",
|
||||
"scripts": {
|
||||
"test": "echo \"Error: no test specified\" && exit 1"
|
||||
},
|
||||
"repository": {
|
||||
"type": "git",
|
||||
"url": "git+https://github.com/dt-fe/weekly.git"
|
||||
},
|
||||
"author": "",
|
||||
"license": "ISC",
|
||||
"bugs": {
|
||||
"url": "https://github.com/dt-fe/weekly/issues"
|
||||
},
|
||||
"homepage": "https://github.com/dt-fe/weekly#readme",
|
||||
"dependencies": {
|
||||
"esm": "^3.2.25",
|
||||
"husky": "^3.0.4",
|
||||
"lint-md-cli": "^0.1.1"
|
||||
},
|
||||
"husky": {
|
||||
"hooks": {
|
||||
"pre-commit": "npx lint-md ./"
|
||||
}
|
||||
}
|
||||
}
|
||||
@@ -1,23 +1,280 @@
|
||||
# 前端精读
|
||||
|
||||
<a href="https://travis-ci.org/ascoders/weekly">
|
||||
<img src="https://travis-ci.org/ascoders/weekly.svg?branch=v2" alt="CircleCI Status">
|
||||
</a>
|
||||
|
||||
前端界的好文精读,每周更新!
|
||||
|
||||
- [周刊参考池](https://github.com/dt-fe/weekly/issues/2)
|
||||
最新精读:<a href="./前沿技术/237.%E7%B2%BE%E8%AF%BB%E3%80%8ATypescript%204.5-4.6%20%E6%96%B0%E7%89%B9%E6%80%A7%E3%80%8B.md">237.精读《Typescript 4.5-4.6 新特性》</a>
|
||||
|
||||
素材来源:[周刊参考池](https://github.com/ascoders/weekly/issues/2)
|
||||
|
||||
现已涵盖:
|
||||
|
||||
- 结合大厂工作经验解读的 [前沿技术](./前沿技术),[源码解读](./源码解读)。
|
||||
- 逐渐加入一些后端技术解读。
|
||||
- 一些 [商业思考](./商业思考)。
|
||||
- 已完成 [编译原理](./编译原理)、[设计模式](./设计模式) 两大基础模块。
|
||||
|
||||
### 前沿技术
|
||||
|
||||
- <a href="./前沿技术/1.%E7%B2%BE%E8%AF%BB%E3%80%8Ajs%20%E6%A8%A1%E5%9D%97%E5%8C%96%E5%8F%91%E5%B1%95%E3%80%8B.md">1.精读《js 模块化发展》</a>
|
||||
- <a href="./前沿技术/2.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%A8%A1%E6%80%81%E6%A1%86%E7%9A%84%E6%9C%80%E4%BD%B3%E5%AE%9E%E8%B7%B5%E3%80%8B.md">2.精读《模态框的最佳实践》</a>
|
||||
- <a href="./前沿技术/3.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%89%8D%E5%90%8E%E7%AB%AF%E6%B8%B2%E6%9F%93%E4%B9%8B%E4%BA%89%E3%80%8B.md">3.精读《前后端渲染之争》</a>
|
||||
- <a href="./前沿技术/4.%E7%B2%BE%E8%AF%BB%E3%80%8AAsyncAwait%20%E4%BC%98%E8%B6%8A%E4%B9%8B%E5%A4%84%E3%80%8B.md">4.精读《AsyncAwait 优越之处》</a>
|
||||
- <a href="./前沿技术/5.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%B0%91%E5%B7%A5%E5%8F%94%E5%8D%95%E9%A1%B5%E6%95%B0%E6%8D%AE%E6%B5%81%E6%96%B9%E6%A1%88%E3%80%8B.md">5.精读《民工叔单页数据流方案》</a>
|
||||
- <a href="./前沿技术/6.%E7%B2%BE%E8%AF%BB%E3%80%8AJavaScript%20%E9%94%99%E8%AF%AF%E5%A0%86%E6%A0%88%E5%A4%84%E7%90%86%E3%80%8B.md">6.精读《JavaScript 错误堆栈处理》</a>
|
||||
- <a href="./前沿技术/7.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AF%B7%E5%81%9C%E6%AD%A2%20css-in-js%20%E7%9A%84%E8%A1%8C%E4%B8%BA%E3%80%8B.md">7.精读《请停止 css-in-js 的行为》</a>
|
||||
- <a href="./前沿技术/8.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%85%A5%E5%9D%91%20React%20%E5%89%8D%E6%B2%A1%E6%9C%89%E4%BA%BA%E4%BC%9A%E5%91%8A%E8%AF%89%E4%BD%A0%E7%9A%84%E4%BA%8B%E3%80%8B.md">8.精读《入坑 React 前没有人会告诉你的事》</a>
|
||||
- <a href="./前沿技术/9.%E7%B2%BE%E8%AF%BB%E3%80%8AImmutable%20%E7%BB%93%E6%9E%84%E5%85%B1%E4%BA%AB%E3%80%8B.md">9.精读《Immutable 结构共享》</a>
|
||||
- <a href="./前沿技术/10.%E7%B2%BE%E8%AF%BB%E3%80%8AWeb%20Components%20%E7%9A%84%E5%9B%B0%E5%A2%83%E3%80%8B.md">10.精读《Web Components 的困境》</a>
|
||||
- <a href="./前沿技术/11.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%89%8D%E7%AB%AF%E8%B0%83%E8%AF%95%E6%8A%80%E5%B7%A7%E3%80%8B.md">11.精读《前端调试技巧》</a>
|
||||
- <a href="./前沿技术/12.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20%E9%AB%98%E9%98%B6%E7%BB%84%E4%BB%B6%E3%80%8B.md">12.精读《React 高阶组件》</a>
|
||||
- <a href="./前沿技术/13.%E7%B2%BE%E8%AF%BB%E3%80%8AThis%20%E5%B8%A6%E6%9D%A5%E7%9A%84%E5%9B%B0%E6%83%91%E3%80%8B.md">13.精读《This 带来的困惑》</a>
|
||||
- <a href="./前沿技术/14.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%9E%B6%E6%9E%84%E8%AE%BE%E8%AE%A1%E4%B9%8B%20DCI%E3%80%8B.md">14.精读《架构设计之 DCI》</a>
|
||||
- <a href="./前沿技术/15.%E7%B2%BE%E8%AF%BB%E3%80%8ATC39%20%E4%B8%8E%20ECMAScript%20%E6%8F%90%E6%A1%88%E3%80%8B.md">15.精读《TC39 与 ECMAScript 提案》</a>
|
||||
- <a href="./前沿技术/16.%E7%B2%BE%E8%AF%BB%E3%80%8ACSS%20Animations%20vs%20Web%20Animations%20API%E3%80%8B.md">16.精读《CSS Animations vs Web Animations API》</a>
|
||||
- <a href="./前沿技术/17.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%A6%82%E4%BD%95%E5%AE%89%E5%85%A8%E5%9C%B0%E4%BD%BF%E7%94%A8%20React%20context%E3%80%8B.md">17.精读《如何安全地使用 React context》</a>
|
||||
- <a href="./前沿技术/18.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E5%AE%8C%E7%BE%8E%E7%9A%84%E6%97%A5%E6%9C%9F%E9%80%89%E6%8B%A9%E5%99%A8%E3%80%8B.md">18.精读《设计完美的日期选择器》</a>
|
||||
- <a href="./前沿技术/19.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%9C%80%E4%BD%B3%E5%89%8D%E7%AB%AF%E9%9D%A2%E8%AF%95%E9%A2%98%E3%80%8B%E5%8F%8A%E9%9D%A2%E8%AF%95%E5%AE%98%E6%8A%80%E5%B7%A7.md">19.精读《最佳前端面试题》及面试官技巧</a>
|
||||
- <a href="./前沿技术/20.%E7%B2%BE%E8%AF%BB%E3%80%8ANestjs%E3%80%8B%E6%96%87%E6%A1%A3.md">20.精读《Nestjs》文档</a>
|
||||
- <a href="./前沿技术/21.%E7%B2%BE%E8%AF%BB%E3%80%8AWeb%20fonts%3A%20when%20you%20need%20them%2C%20when%20you%20don%E2%80%99t%E3%80%8B.md">21.精读《Web fonts: when you need them, when you don’t》</a>
|
||||
- <a href="./前沿技术/22.%E7%B2%BE%E8%AF%BB%E3%80%8AV8%20%E5%BC%95%E6%93%8E%E7%89%B9%E6%80%A7%E5%B8%A6%E6%9D%A5%E7%9A%84%E7%9A%84%20JS%20%E6%80%A7%E8%83%BD%E5%8F%98%E5%8C%96%E3%80%8B.md">22.精读《V8 引擎特性带来的的 JS 性能变化》</a>
|
||||
- <a href="./前沿技术/23.%E7%B2%BE%E8%AF%BB%E3%80%8AAPI%20%E8%AE%BE%E8%AE%A1%E5%8E%9F%E5%88%99%E3%80%8B.md">23.精读《API 设计原则》</a>
|
||||
- <a href="./前沿技术/24.%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%8E%B0%E4%BB%A3%20JavaScript%20%E6%A6%82%E8%A7%88%E3%80%8B.md">24.精读《现代 JavaScript 概览》</a>
|
||||
- <a href="./前沿技术/25.%E7%B2%BE%E8%AF%BB%E3%80%8Anull%20%3E%3D%200%3F%E3%80%8B.md">25.精读《null >= 0?》</a>
|
||||
- <a href="./前沿技术/26.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%8A%A0%E5%AF%86%E5%AA%92%E4%BD%93%E6%89%A9%E5%B1%95%E3%80%8B.md">26.精读《加密媒体扩展》</a>
|
||||
- <a href="./前沿技术/27.%E7%B2%BE%E8%AF%BB%E3%80%8Acss-in-js%20%E6%9D%80%E9%B8%A1%E7%94%A8%E7%89%9B%E5%88%80%E3%80%8B.md">27.精读《css-in-js 杀鸡用牛刀》</a>
|
||||
- <a href="./前沿技术/28.%E7%B2%BE%E8%AF%BB%E3%80%8A2017%20%E5%89%8D%E7%AB%AF%E6%80%A7%E8%83%BD%E4%BC%98%E5%8C%96%E5%A4%87%E5%BF%98%E5%BD%95%E3%80%8B.md">28.精读《2017 前端性能优化备忘录》</a>
|
||||
- <a href="./前沿技术/29.%E7%B2%BE%E8%AF%BB%E3%80%8AJS%20%E4%B8%AD%E7%9A%84%E5%86%85%E5%AD%98%E7%AE%A1%E7%90%86%E3%80%8B.md">29.精读《JS 中的内存管理》</a>
|
||||
- <a href="./前沿技术/30.%E7%B2%BE%E8%AF%BB%E3%80%8AJavascript%20%E4%BA%8B%E4%BB%B6%E5%BE%AA%E7%8E%AF%E4%B8%8E%E5%BC%82%E6%AD%A5%E3%80%8B.md">30.精读《Javascript 事件循环与异步》</a>
|
||||
- <a href="./前沿技术/31.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%88%91%E4%B8%8D%E5%86%8D%E4%BD%BF%E7%94%A8%E9%AB%98%E9%98%B6%E7%BB%84%E4%BB%B6%E3%80%8B.md">31.精读《我不再使用高阶组件》</a>
|
||||
- <a href="./前沿技术/32.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20Router4.0%20%E8%BF%9B%E9%98%B6%E6%A6%82%E5%BF%B5%E3%80%8B.md">32.精读《React Router4.0 进阶概念》</a>
|
||||
- <a href="./前沿技术/33.%E7%B2%BE%E8%AF%BB%E3%80%8A30%20%E8%A1%8C%20js%20%E4%BB%A3%E7%A0%81%E5%88%9B%E5%BB%BA%E7%A5%9E%E7%BB%8F%E7%BD%91%E7%BB%9C%E3%80%8B.md">33.精读《30 行 js 代码创建神经网络》</a>
|
||||
- <a href="./前沿技术/34.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20%E4%BB%A3%E7%A0%81%E6%95%B4%E6%B4%81%E4%B9%8B%E9%81%93%E3%80%8B.md">34.精读《React 代码整洁之道》</a>
|
||||
- <a href="./前沿技术/35.%E7%B2%BE%E8%AF%BB%E3%80%8Adob%20-%20%E6%A1%86%E6%9E%B6%E5%AE%9E%E7%8E%B0%E3%80%8B.md">35.精读《dob - 框架实现》</a>
|
||||
- <a href="./前沿技术/36.%E7%B2%BE%E8%AF%BB%E3%80%8AWhen%20You%20%E2%80%9CGit%E2%80%9D%20in%20Trouble-%20a%20Version%20Control%20Story%E3%80%8B.md">36.精读《When You “Git” in Trouble- a Version Control Story》</a>
|
||||
- <a href="./前沿技术/37.%E7%B2%BE%E8%AF%BB%E3%80%8Ahow%20we%20position%20and%20what%20we%20compare%E3%80%8B.md">37.精读《how we position and what we compare》</a>
|
||||
- <a href="./前沿技术/38.%E7%B2%BE%E8%AF%BB%E3%80%8Adob%20-%20%E6%A1%86%E6%9E%B6%E4%BD%BF%E7%94%A8%E3%80%8B.md">38.精读《dob - 框架使用》</a>
|
||||
- <a href="./前沿技术/39.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%85%A8%E9%93%BE%E8%B7%AF%E4%BD%93%E9%AA%8C%E6%B5%8F%E8%A7%88%E5%99%A8%E6%8C%96%E7%9F%BF%E3%80%8B.md">39.精读《全链路体验浏览器挖矿》</a>
|
||||
- <a href="./前沿技术/40.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%88%9D%E6%8E%A2%20Reason%20%E4%B8%8E%20GraphQL%E3%80%8B.md">40.精读《初探 Reason 与 GraphQL》</a>
|
||||
- <a href="./前沿技术/41.%E7%B2%BE%E8%AF%BB%E3%80%8AAnt%20Design%203.0%20%E8%83%8C%E5%90%8E%E7%9A%84%E6%95%85%E4%BA%8B%E3%80%8B.md">41.精读《Ant Design 3.0 背后的故事》</a>
|
||||
- <a href="./前沿技术/42.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%89%8D%E7%AB%AF%E6%95%B0%E6%8D%AE%E6%B5%81%E5%93%B2%E5%AD%A6%E3%80%8B.md">42.精读《前端数据流哲学》</a>
|
||||
- <a href="./前沿技术/43.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%A2%9E%E5%BC%BA%E7%8E%B0%E5%AE%9E%E4%B8%8E%E5%8F%AF%E8%A7%86%E5%8C%96%E3%80%8B.md">43.精读《增强现实与可视化》</a>
|
||||
- <a href="./前沿技术/44.%E7%B2%BE%E8%AF%BB%E3%80%8ARekit%20Studio%E3%80%8B.md">44.精读《Rekit Studio》</a>
|
||||
- <a href="./前沿技术/45.%E7%B2%BE%E8%AF%BB%E3%80%8AReact's%20new%20Context%20API%E3%80%8B.md">45.精读《React's new Context API》</a>
|
||||
- <a href="./前沿技术/46.%E7%B2%BE%E8%AF%BB%E3%80%8Areact-rxjs%E3%80%8B.md">46.精读《react-rxjs》</a>
|
||||
- <a href="./前沿技术/47.%E7%B2%BE%E8%AF%BB%E3%80%8Awebpack4.0%20%E5%8D%87%E7%BA%A7%E6%8C%87%E5%8D%97%E3%80%8B.md">47.精读《webpack4.0 升级指南》</a>
|
||||
- <a href="./前沿技术/49.%E7%B2%BE%E8%AF%BB%E3%80%8ACompilers%20are%20the%20New%20Frameworks%E3%80%8B.md">49.精读《Compilers are the New Frameworks》</a>
|
||||
- <a href="./前沿技术/50.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%BF%AB%E9%80%9F%E4%B8%8A%E6%89%8B%E6%9E%84%E5%BB%BA%20ARKit%20%E5%BA%94%E7%94%A8%E3%80%8B.md">50.精读《快速上手构建 ARKit 应用》</a>
|
||||
- <a href="./前沿技术/51.%E7%B2%BE%E8%AF%BB%E3%80%8AElements%20of%20Web%20Dev%E3%80%8B.md">51.精读《Elements of Web Dev》</a>
|
||||
- <a href="./前沿技术/52.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%9B%BE%E8%A7%A3%20ES%20%E6%A8%A1%E5%9D%97%E3%80%8B.md">52.精读《图解 ES 模块》</a>
|
||||
- <a href="./前沿技术/53.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%8F%92%E4%BB%B6%E5%8C%96%E6%80%9D%E7%BB%B4%E3%80%8B.md">53.精读《插件化思维》</a>
|
||||
- <a href="./前沿技术/54.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%9C%A8%E6%B5%8F%E8%A7%88%E5%99%A8%E8%BF%90%E8%A1%8C%20serverRender%E3%80%8B.md">54.精读《在浏览器运行 serverRender》</a>
|
||||
- <a href="./前沿技术/55.%E7%B2%BE%E8%AF%BB%E3%80%8Aasync%20await%20%E6%98%AF%E6%8A%8A%E5%8F%8C%E5%88%83%E5%89%91%E3%80%8B.md">55.精读《async await 是把双刃剑》</a>
|
||||
- <a href="./前沿技术/56.%E7%B2%BE%E8%AF%BB%E3%80%8A%E9%87%8D%E6%96%B0%E6%80%9D%E8%80%83%20Redux%E3%80%8B.md">56.精读《重新思考 Redux》</a>
|
||||
- <a href="./前沿技术/57.%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%8E%B0%E4%BB%A3%20js%20%E6%A1%86%E6%9E%B6%E5%AD%98%E5%9C%A8%E7%9A%84%E6%A0%B9%E6%9C%AC%E5%8E%9F%E5%9B%A0%E3%80%8B.md">57.精读《现代 js 框架存在的根本原因》</a>
|
||||
- <a href="./前沿技术/58.%E7%B2%BE%E8%AF%BB%E3%80%8ATypescript2.0%20-%202.9%E3%80%8B.md">58.精读《Typescript2.0 - 2.9》</a>
|
||||
- <a href="./前沿技术/59.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%A6%82%E4%BD%95%E5%88%A9%E7%94%A8%20Nodejs%20%E7%9B%91%E5%90%AC%E6%96%87%E4%BB%B6%E5%A4%B9%E3%80%8B.md">59.精读《如何利用 Nodejs 监听文件夹》</a>
|
||||
- <a href="./前沿技术/60.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%A6%82%E4%BD%95%E5%9C%A8%20nodejs%20%E4%BD%BF%E7%94%A8%E7%8E%AF%E5%A2%83%E5%8F%98%E9%87%8F%E3%80%8B.md">60.精读《如何在 nodejs 使用环境变量》</a>
|
||||
- <a href="./前沿技术/61.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20%E5%85%AB%E7%A7%8D%E6%9D%A1%E4%BB%B6%E6%B8%B2%E6%9F%93%E3%80%8B.md">61.精读《React 八种条件渲染》</a>
|
||||
- <a href="./前沿技术/62.%E7%B2%BE%E8%AF%BB%E3%80%8AJS%20%E5%BC%95%E6%93%8E%E5%9F%BA%E7%A1%80%E4%B9%8B%20Shapes%20and%20Inline%20Caches%E3%80%8B.md">62.精读《JS 引擎基础之 Shapes and Inline Caches》</a>
|
||||
- <a href="./前沿技术/63.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20%E7%9A%84%E5%A4%9A%E6%80%81%E6%80%A7%E3%80%8B.md">63.精读《React 的多态性》</a>
|
||||
- <a href="./前沿技术/68.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%A1%A1%E9%87%8F%E7%94%A8%E6%88%B7%E4%BD%93%E9%AA%8C%E3%80%8B.md">68.精读《衡量用户体验》</a>
|
||||
- <a href="./前沿技术/69.%E7%B2%BE%E8%AF%BB%E3%80%8ASQL%20vs%20Flux%E3%80%8B.md">69.精读《SQL vs Flux》</a>
|
||||
- <a href="./前沿技术/72.%E7%B2%BE%E8%AF%BB%E3%80%8AREST%2C%20GraphQL%2C%20Webhooks%2C%20%26%20gRPC%20%E5%A6%82%E4%BD%95%E9%80%89%E5%9E%8B%E3%80%8B.md">72.精读《REST, GraphQL, Webhooks, & gRPC 如何选型》</a>
|
||||
- <a href="./前沿技术/74.%E7%B2%BE%E8%AF%BB%E3%80%8A12%20%E4%B8%AA%E8%AF%84%E4%BC%B0%20JS%20%E5%BA%93%E4%BD%A0%E9%9C%80%E8%A6%81%E5%85%B3%E5%BF%83%E7%9A%84%E4%BA%8B%E3%80%8B.md">74.精读《12 个评估 JS 库你需要关心的事》</a>
|
||||
- <a href="./前沿技术/76.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%B0%88%E8%B0%88%20Web%20Workers%E3%80%8B.md">76.精读《谈谈 Web Workers》</a>
|
||||
- <a href="./前沿技术/77.%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%94%A8%20Reduce%20%E5%AE%9E%E7%8E%B0%20Promise%20%E4%B8%B2%E8%A1%8C%E6%89%A7%E8%A1%8C%E3%80%8B.md">77.精读《用 Reduce 实现 Promise 串行执行》</a>
|
||||
- <a href="./前沿技术/79.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20Hooks%E3%80%8B.md">79.精读《React Hooks》</a>
|
||||
- <a href="./前沿技术/80.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%80%8E%E4%B9%88%E7%94%A8%20React%20Hooks%20%E9%80%A0%E8%BD%AE%E5%AD%90%E3%80%8B.md">80.精读《怎么用 React Hooks 造轮子》</a>
|
||||
- <a href="./前沿技术/81.%E7%B2%BE%E8%AF%BB%E3%80%8A%E4%BD%BF%E7%94%A8%20CSS%20%E5%B1%9E%E6%80%A7%E9%80%89%E6%8B%A9%E5%99%A8%E3%80%8B.md">81.精读《使用 CSS 属性选择器》</a>
|
||||
- <a href="./前沿技术/83.%E7%B2%BE%E8%AF%BB%E3%80%8AReact16%20%E6%96%B0%E7%89%B9%E6%80%A7%E3%80%8B.md">83.精读《React16 新特性》</a>
|
||||
- <a href="./前沿技术/84.%E7%B2%BE%E8%AF%BB%E3%80%8ATypescript%203.2%20%E6%96%B0%E7%89%B9%E6%80%A7%E3%80%8B.md">84.精读《Typescript 3.2 新特性》</a>
|
||||
- <a href="./前沿技术/86.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%9B%BD%E9%99%85%E5%8C%96%E5%B8%83%E5%B1%80%20-%20Logical%20Properties%E3%80%8B.md">86.精读《国际化布局 - Logical Properties》</a>
|
||||
- <a href="./前沿技术/87.%E7%B2%BE%E8%AF%BB%E3%80%8AsetState%20%E5%81%9A%E4%BA%86%E4%BB%80%E4%B9%88%E3%80%8B.md">87.精读《setState 做了什么》</a>
|
||||
- <a href="./前沿技术/88.%E7%B2%BE%E8%AF%BB%E3%80%8ACaches%20API%E3%80%8B.md">88.精读《Caches API》</a>
|
||||
- <a href="./前沿技术/89.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%A6%82%E4%BD%95%E7%BC%96%E8%AF%91%E5%89%8D%E7%AB%AF%E9%A1%B9%E7%9B%AE%E4%B8%8E%E7%BB%84%E4%BB%B6%E3%80%8B.md">89.精读《如何编译前端项目与组件》</a>
|
||||
- <a href="./前沿技术/91.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%AD%A3%E5%88%99%20ES2018%E3%80%8B.md">91.精读《正则 ES2018》</a>
|
||||
- <a href="./前沿技术/94.%E7%B2%BE%E8%AF%BB%E3%80%8AServerless%20%E7%BB%99%E5%89%8D%E7%AB%AF%E5%B8%A6%E6%9D%A5%E4%BA%86%E4%BB%80%E4%B9%88%E3%80%8B.md">94.精读《Serverless 给前端带来了什么》</a>
|
||||
- <a href="./前沿技术/95.%E7%B2%BE%E8%AF%BB%E3%80%8AFunction%20VS%20Class%20%E7%BB%84%E4%BB%B6%E3%80%8B.md">95.精读《Function VS Class 组件》</a>
|
||||
- <a href="./前沿技术/96.%E7%B2%BE%E8%AF%BB%E3%80%8AuseEffect%20%E5%AE%8C%E5%85%A8%E6%8C%87%E5%8D%97%E3%80%8B.md">96.精读《useEffect 完全指南》</a>
|
||||
- <a href="./前沿技术/97.%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%BC%96%E5%86%99%E6%9C%89%E5%BC%B9%E6%80%A7%E7%9A%84%E7%BB%84%E4%BB%B6%E3%80%8B.md">97.精读《编写有弹性的组件》</a>
|
||||
- <a href="./前沿技术/99.%E7%B2%BE%E8%AF%BB%E3%80%8AScheduling%20in%20React%E3%80%8B.md">99.精读《Scheduling in React》</a>
|
||||
- <a href="./前沿技术/100.%E7%B2%BE%E8%AF%BB%E3%80%8AV8%20%E5%BC%95%E6%93%8E%20Lazy%20Parsing%E3%80%8B.md">100.精读《V8 引擎 Lazy Parsing》</a>
|
||||
- <a href="./前沿技术/101.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%8C%81%E7%BB%AD%E9%9B%86%E6%88%90%20vs%20%E6%8C%81%E7%BB%AD%E4%BA%A4%E4%BB%98%20vs%20%E6%8C%81%E7%BB%AD%E9%83%A8%E7%BD%B2%E3%80%8B.md">101.精读《持续集成 vs 持续交付 vs 持续部署》</a>
|
||||
- <a href="./前沿技术/102.%E7%B2%BE%E8%AF%BB%E3%80%8AMonorepo%20%E7%9A%84%E4%BC%98%E5%8A%BF%E3%80%8B.md">102.精读《Monorepo 的优势》</a>
|
||||
- <a href="./前沿技术/104.%E7%B2%BE%E8%AF%BB%E3%80%8AFunction%20Component%20%E5%85%A5%E9%97%A8%E3%80%8B.md">104.精读《Function Component 入门》</a>
|
||||
- <a href="./前沿技术/105.%E7%B2%BE%E8%AF%BB%E3%80%8AWhat's%20new%20in%20javascript%E3%80%8B.md">105.精读《What's new in javascript》</a>
|
||||
- <a href="./前沿技术/107.%E7%B2%BE%E8%AF%BB%E3%80%8AOptional%20chaining%E3%80%8B.md">107.精读《Optional chaining》</a>
|
||||
- <a href="./前沿技术/109.%E7%B2%BE%E8%AF%BB%E3%80%8AVue3.0%20Function%20API%E3%80%8B.md">109.精读《Vue3.0 Function API》</a>
|
||||
- <a href="./前沿技术/111.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%89%8D%E7%AB%AF%E6%9C%AA%E6%9D%A5%E5%B1%95%E6%9C%9B%E3%80%8B.md">111.精读《前端未来展望》</a>
|
||||
- <a href="./前沿技术/112.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%BA%90%E7%A0%81%E5%AD%A6%E4%B9%A0%E3%80%8B.md">112.精读《源码学习》</a>
|
||||
- <a href="./前沿技术/113.%E7%B2%BE%E8%AF%BB%E3%80%8ANodejs%20V12%E3%80%8B.md">113.精读《Nodejs V12》</a>
|
||||
- <a href="./前沿技术/117.%E7%B2%BE%E8%AF%BB%E3%80%8ATableau%20%E6%8E%A2%E7%B4%A2%E5%BC%8F%E6%A8%A1%E5%9E%8B%E3%80%8B.md">117.精读《Tableau 探索式模型》</a>
|
||||
- <a href="./前沿技术/118.%E7%B2%BE%E8%AF%BB%E3%80%8A%E4%BD%BF%E7%94%A8%20css%20%E5%8F%98%E9%87%8F%E7%94%9F%E6%88%90%E9%A2%9C%E8%89%B2%E4%B8%BB%E9%A2%98%E3%80%8B.md">118.精读《使用 css 变量生成颜色主题》</a>
|
||||
- <a href="./前沿技术/119.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%89%8D%E7%AB%AF%E6%B7%B1%E6%B0%B4%E5%8C%BA%E3%80%8B.md">119.精读《前端深水区》</a>
|
||||
- <a href="./前沿技术/120.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20Hooks%20%E6%9C%80%E4%BD%B3%E5%AE%9E%E8%B7%B5%E3%80%8B.md">120.精读《React Hooks 最佳实践》</a>
|
||||
- <a href="./前沿技术/121.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%89%8D%E7%AB%AF%E4%B8%8E%20BI%E3%80%8B.md">121.精读《前端与 BI》</a>
|
||||
- <a href="./前沿技术/123.%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%94%A8%20Babel%20%E5%88%9B%E9%80%A0%E8%87%AA%E5%AE%9A%E4%B9%89%20JS%20%E8%AF%AD%E6%B3%95%E3%80%8B.md">123.精读《用 Babel 创造自定义 JS 语法》</a>
|
||||
- <a href="./前沿技术/124.%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%94%A8%20css%20grid%20%E9%87%8D%E6%96%B0%E6%80%9D%E8%80%83%E5%B8%83%E5%B1%80%E3%80%8B.md">124.精读《用 css grid 重新思考布局》</a>
|
||||
- <a href="./前沿技术/125.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0%20-%20%E5%87%BD%E6%95%B0%E5%BC%8F%E4%B9%8B%E7%BE%8E%E3%80%8B.md">125.精读《深度学习 - 函数式之美》</a>
|
||||
- <a href="./前沿技术/126.%E7%B2%BE%E8%AF%BB%E3%80%8ANuxtjs%E3%80%8B.md">126.精读《Nuxtjs》</a>
|
||||
- <a href="./前沿技术/127.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20Conf%202019%20-%20Day1%E3%80%8B.md">127.精读《React Conf 2019 - Day1》</a>
|
||||
- <a href="./前沿技术/129.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20Conf%202019%20-%20Day2%E3%80%8B.md">129.精读《React Conf 2019 - Day2》</a>
|
||||
- <a href="./前沿技术/132.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%AD%A3%E4%BA%A4%E7%9A%84%20React%20%E7%BB%84%E4%BB%B6%E3%80%8B.md">132.精读《正交的 React 组件》</a>
|
||||
- <a href="./前沿技术/133.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%AF%BB%E6%89%BE%E6%A1%86%E6%9E%B6%E8%AE%BE%E8%AE%A1%E7%9A%84%E5%B9%B3%E8%A1%A1%E7%82%B9%E3%80%8B.md">133.精读《寻找框架设计的平衡点》</a>
|
||||
- <a href="./前沿技术/134.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%88%91%E5%9C%A8%E9%98%BF%E9%87%8C%E6%95%B0%E6%8D%AE%E4%B8%AD%E5%8F%B0%E5%A4%A7%E5%89%8D%E7%AB%AF%E3%80%8B.md">134.精读《我在阿里数据中台大前端》</a>
|
||||
- <a href="./前沿技术/138.%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%B2%BE%E9%80%9A%20console.log%E3%80%8B.md">138.精读《精通 console.log》</a>
|
||||
- <a href="./前沿技术/139.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20JSON%20Parser%E3%80%8B.md">139.精读《手写 JSON Parser》</a>
|
||||
- <a href="./前沿技术/140.%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%BB%93%E5%90%88%20React%20%E4%BD%BF%E7%94%A8%E5%8E%9F%E7%94%9F%20Drag%20Drop%20API%E3%80%8B.md">140.精读《结合 React 使用原生 Drag Drop API》</a>
|
||||
- <a href="./前沿技术/141.%E7%B2%BE%E8%AF%BB%E3%80%8AuseRef%20%E4%B8%8E%20createRef%20%E7%9A%84%E5%8C%BA%E5%88%AB%E3%80%8B.md">141.精读《useRef 与 createRef 的区别》</a>
|
||||
- <a href="./前沿技术/142.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%A6%82%E4%BD%95%E5%81%9A%E5%A5%BD%20CodeReview%E3%80%8B.md">142.精读《如何做好 CodeReview》</a>
|
||||
- <a href="./前沿技术/143.%E7%B2%BE%E8%AF%BB%E3%80%8ASuspense%20%E6%94%B9%E5%8F%98%E5%BC%80%E5%8F%91%E6%96%B9%E5%BC%8F%E3%80%8B.md">143.精读《Suspense 改变开发方式》</a>
|
||||
- <a href="./前沿技术/144.%E7%B2%BE%E8%AF%BB%E3%80%8AWebpack5%20%E6%96%B0%E7%89%B9%E6%80%A7%20-%20%E6%A8%A1%E5%9D%97%E8%81%94%E9%82%A6%E3%80%8B.md">144.精读《Webpack5 新特性 - 模块联邦》</a>
|
||||
- <a href="./前沿技术/145.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20Router%20v6%E3%80%8B.md">145.精读《React Router v6》</a>
|
||||
- <a href="./前沿技术/146.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20Hooks%20%E6%95%B0%E6%8D%AE%E6%B5%81%E3%80%8B.md">146.精读《React Hooks 数据流》</a>
|
||||
- <a href="./前沿技术/147.%20%E7%B2%BE%E8%AF%BB%E3%80%8A%40types%20react%20%E5%80%BC%E5%BE%97%E6%B3%A8%E6%84%8F%E7%9A%84%20TS%20%E6%8A%80%E5%B7%A7%E3%80%8B.md">147. 精读《@types react 值得注意的 TS 技巧》</a>
|
||||
- <a href="./前沿技术/148.%20%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20Error%20Boundaries%E3%80%8B.md">148. 精读《React Error Boundaries》</a>
|
||||
- <a href="./前沿技术/149.%20%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20%E6%80%A7%E8%83%BD%E8%B0%83%E8%AF%95%E3%80%8B.md">149. 精读《React 性能调试》</a>
|
||||
- <a href="./前沿技术/150.%20%E7%B2%BE%E8%AF%BB%E3%80%8ADeno%201.0%20%E4%BD%A0%E9%9C%80%E8%A6%81%E4%BA%86%E8%A7%A3%E7%9A%84%E3%80%8B.md">150. 精读《Deno 1.0 你需要了解的》</a>
|
||||
- <a href="./前沿技术/152.%20%E7%B2%BE%E8%AF%BB%E3%80%8Arecoil%E3%80%8B.md">152. 精读《recoil》</a>
|
||||
- <a href="./前沿技术/153.%20%E7%B2%BE%E8%AF%BB%E3%80%8Asnowpack%E3%80%8B.md">153. 精读《snowpack》</a>
|
||||
- <a href="./前沿技术/154.%20%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%94%A8%20React%20%E5%81%9A%E6%8C%89%E9%9C%80%E6%B8%B2%E6%9F%93%E3%80%8B.md">154. 精读《用 React 做按需渲染》</a>
|
||||
- <a href="./前沿技术/157.%20%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%A6%82%E4%BD%95%E6%AF%94%E8%BE%83%20Object%20%E5%AF%B9%E8%B1%A1%E3%80%8B.md">157. 精读《如何比较 Object 对象》</a>
|
||||
- <a href="./前沿技术/158.%20%E7%B2%BE%E8%AF%BB%E3%80%8ATypescript%204%E3%80%8B.md">158. 精读《Typescript 4》</a>
|
||||
- <a href="./前沿技术/159.%20%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%AF%B9%E4%BD%8E%E4%BB%A3%E7%A0%81%E6%90%AD%E5%BB%BA%E7%9A%84%E7%90%86%E8%A7%A3%E3%80%8B.md">159. 精读《对低代码搭建的理解》</a>
|
||||
- <a href="./前沿技术/160.%20%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%87%BD%E6%95%B0%E7%BC%93%E5%AD%98%E3%80%8B.md">160. 精读《函数缓存》</a>
|
||||
- <a href="./前沿技术/161.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%8F%AF%E8%A7%86%E5%8C%96%E6%90%AD%E5%BB%BA%E6%80%9D%E8%80%83%20-%20%E5%AF%8C%E6%96%87%E6%9C%AC%E6%90%AD%E5%BB%BA%E3%80%8B.md">161.精读《可视化搭建思考 - 富文本搭建》</a>
|
||||
- <a href="./前沿技术/162.%E7%B2%BE%E8%AF%BB%E3%80%8ATasks%2C%20microtasks%2C%20queues%20and%20schedules%E3%80%8B.md">162.精读《Tasks, microtasks, queues and schedules》</a>
|
||||
- <a href="./前沿技术/163.%E7%B2%BE%E8%AF%BB%E3%80%8ASpring%20%E6%A6%82%E5%BF%B5%E3%80%8B.md">163.精读《Spring 概念》</a>
|
||||
- <a href="./前沿技术/164.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%95%B0%E6%8D%AE%E6%90%AD%E5%BB%BA%E5%BC%95%E6%93%8E%20bi-designer%20API-%E8%AE%BE%E8%AE%A1%E5%99%A8%E3%80%8B.md">164.精读《数据搭建引擎 bi-designer API-设计器》</a>
|
||||
- <a href="./前沿技术/165.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%95%B0%E6%8D%AE%E6%90%AD%E5%BB%BA%E5%BC%95%E6%93%8E%20bi-designer%20API-%E7%BB%84%E4%BB%B6%E3%80%8B.md">165.精读《数据搭建引擎 bi-designer API-组件》</a>
|
||||
- <a href="./前沿技术/166.%E7%B2%BE%E8%AF%BB%E3%80%8ABI%20%E6%90%AD%E5%BB%BA%20-%20%E7%AD%9B%E9%80%89%E6%9D%A1%E4%BB%B6%E3%80%8B.md">166.精读《BI 搭建 - 筛选条件》</a>
|
||||
- <a href="./前沿技术/190.%E7%B2%BE%E8%AF%BB%E3%80%8ADOM%20diff%20%E5%8E%9F%E7%90%86%E8%AF%A6%E8%A7%A3%E3%80%8B.md">190.精读《DOM diff 原理详解》</a>
|
||||
- <a href="./前沿技术/191.%E7%B2%BE%E8%AF%BB%E3%80%8A%E9%AB%98%E6%80%A7%E8%83%BD%E8%A1%A8%E6%A0%BC%E3%80%8B.md">191.精读《高性能表格》</a>
|
||||
- <a href="./前沿技术/192.%E7%B2%BE%E8%AF%BB%E3%80%8ADOM%20diff%20%E6%9C%80%E9%95%BF%E4%B8%8A%E5%8D%87%E5%AD%90%E5%BA%8F%E5%88%97%E3%80%8B.md">192.精读《DOM diff 最长上升子序列》</a>
|
||||
- <a href="./前沿技术/193.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20Server%20Component%E3%80%8B.md">193.精读《React Server Component》</a>
|
||||
- <a href="./前沿技术/194.%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%AE%97%E6%B3%95%E5%9F%BA%E7%A1%80%E6%95%B0%E6%8D%AE%E7%BB%93%E6%9E%84%E3%80%8B.md">194.精读《算法基础数据结构》</a>
|
||||
- <a href="./前沿技术/195.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%96%B0%E4%B8%80%E4%BB%A3%E5%89%8D%E7%AB%AF%E6%9E%84%E5%BB%BA%E5%B7%A5%E5%85%B7%E5%AF%B9%E6%AF%94%E3%80%8B.md">195.精读《新一代前端构建工具对比》</a>
|
||||
- <a href="./前沿技术/196.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%89%8D%E7%AB%AF%E8%81%8C%E4%B8%9A%E8%A7%84%E5%88%92%20-%202021%20%E5%B9%B4%E3%80%8B.md">196.精读《前端职业规划 - 2021 年》</a>
|
||||
- <a href="./前沿技术/197.%E7%B2%BE%E8%AF%BB%E3%80%8A%E4%BD%8E%E4%BB%A3%E7%A0%81%E9%80%BB%E8%BE%91%E7%BC%96%E6%8E%92%E3%80%8B.md">197.精读《低代码逻辑编排》</a>
|
||||
- <a href="./前沿技术/202.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%2018%E3%80%8B.md">202.精读《React 18》</a>
|
||||
- <a href="./前沿技术/204.%E7%B2%BE%E8%AF%BB%E3%80%8A%E9%BB%98%E8%AE%A4%E3%80%81%E5%91%BD%E5%90%8D%E5%AF%BC%E5%87%BA%E7%9A%84%E5%8C%BA%E5%88%AB%E3%80%8B.md">204.精读《默认、命名导出的区别》</a>
|
||||
- <a href="./前沿技术/205.%E7%B2%BE%E8%AF%BB%E3%80%8AJS%20with%20%E8%AF%AD%E6%B3%95%E3%80%8B.md">205.精读《JS with 语法》</a>
|
||||
- <a href="./前沿技术/206.%E7%B2%BE%E8%AF%BB%E3%80%8A%E4%B8%80%E7%A7%8D%20Hooks%20%E6%95%B0%E6%8D%AE%E6%B5%81%E7%AE%A1%E7%90%86%E6%96%B9%E6%A1%88%E3%80%8B.md">206.精读《一种 Hooks 数据流管理方案》</a>
|
||||
- <a href="./前沿技术/207.%E7%B2%BE%E8%AF%BB%E3%80%8ATypescript%20infer%20%E5%85%B3%E9%94%AE%E5%AD%97%E3%80%8B.md">207.精读《Typescript infer 关键字》</a>
|
||||
- <a href="./前沿技术/208.%E7%B2%BE%E8%AF%BB%E3%80%8ATypescript%204.4%E3%80%8B.md">208.精读《Typescript 4.4》</a>
|
||||
- <a href="./前沿技术/209.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%8D%95%E8%8E%B7%E6%89%80%E6%9C%89%E5%BC%82%E6%AD%A5%20error%E3%80%8B.md">209.精读《捕获所有异步 error》</a>
|
||||
- <a href="./前沿技术/210.%E7%B2%BE%E8%AF%BB%E3%80%8Aclass%20static%20block%E3%80%8B.md">210.精读《class static block》</a>
|
||||
- <a href="./前沿技术/211.%E7%B2%BE%E8%AF%BB%E3%80%8AMicrosoft%20Power%20Fx%E3%80%8B.md">211.精读《Microsoft Power Fx》</a>
|
||||
- <a href="./前沿技术/212.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%8F%AF%E7%BB%B4%E6%8A%A4%E6%80%A7%E6%80%9D%E8%80%83%E3%80%8B.md">212.精读《可维护性思考》</a>
|
||||
- <a href="./前沿技术/213.%E7%B2%BE%E8%AF%BB%E3%80%8APrisma%20%E7%9A%84%E4%BD%BF%E7%94%A8%E3%80%8B.md">213.精读《Prisma 的使用》</a>
|
||||
- <a href="./前沿技术/214.%E7%B2%BE%E8%AF%BB%E3%80%8Aweb%20streams%E3%80%8B.md">214.精读《web streams》</a>
|
||||
- <a href="./前沿技术/215.%E7%B2%BE%E8%AF%BB%E3%80%8A%E4%BB%80%E4%B9%88%E6%98%AF%20LOD%20%E8%A1%A8%E8%BE%BE%E5%BC%8F%E3%80%8B.md">215.精读《什么是 LOD 表达式》</a>
|
||||
- <a href="./前沿技术/216.%E7%B2%BE%E8%AF%BB%E3%80%8A15%20%E5%A4%A7%20LOD%20%E8%A1%A8%E8%BE%BE%E5%BC%8F%20-%20%E4%B8%8A%E3%80%8B.md">216.精读《15 大 LOD 表达式 - 上》</a>
|
||||
- <a href="./前沿技术/217.%E7%B2%BE%E8%AF%BB%E3%80%8A15%20%E5%A4%A7%20LOD%20%E8%A1%A8%E8%BE%BE%E5%BC%8F%20-%20%E4%B8%8B%E3%80%8B.md">217.精读《15 大 LOD 表达式 - 下》</a>
|
||||
- <a href="./前沿技术/218.%E7%B2%BE%E8%AF%BB%E3%80%8ARust%20%E6%98%AF%20JS%20%E5%9F%BA%E5%BB%BA%E7%9A%84%E6%9C%AA%E6%9D%A5%E3%80%8B.md">218.精读《Rust 是 JS 基建的未来》</a>
|
||||
- <a href="./前沿技术/219.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%B7%B1%E5%85%A5%E4%BA%86%E8%A7%A3%E7%8E%B0%E4%BB%A3%E6%B5%8F%E8%A7%88%E5%99%A8%E4%B8%80%E3%80%8B.md">219.精读《深入了解现代浏览器一》</a>
|
||||
- <a href="./前沿技术/220.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%B7%B1%E5%85%A5%E4%BA%86%E8%A7%A3%E7%8E%B0%E4%BB%A3%E6%B5%8F%E8%A7%88%E5%99%A8%E4%BA%8C%E3%80%8B.md">220.精读《深入了解现代浏览器二》</a>
|
||||
- <a href="./前沿技术/221.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%B7%B1%E5%85%A5%E4%BA%86%E8%A7%A3%E7%8E%B0%E4%BB%A3%E6%B5%8F%E8%A7%88%E5%99%A8%E4%B8%89%E3%80%8B.md">221.精读《深入了解现代浏览器三》</a>
|
||||
- <a href="./前沿技术/222.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%B7%B1%E5%85%A5%E4%BA%86%E8%A7%A3%E7%8E%B0%E4%BB%A3%E6%B5%8F%E8%A7%88%E5%99%A8%E5%9B%9B%E3%80%8B.md">222.精读《深入了解现代浏览器四》</a>
|
||||
- <a href="./前沿技术/223.%E7%B2%BE%E8%AF%BB%E3%80%8ARecords%20%26%20Tuples%20%E6%8F%90%E6%A1%88%E3%80%8B.md">223.精读《Records & Tuples 提案》</a>
|
||||
- <a href="./前沿技术/224.%E7%B2%BE%E8%AF%BB%E3%80%8ARecords%20%26%20Tuples%20for%20React%E3%80%8B.md">224.精读《Records & Tuples for React》</a>
|
||||
- <a href="./前沿技术/225.%E7%B2%BE%E8%AF%BB%E3%80%8AExcel%20JS%20API%E3%80%8B.md">225.精读《Excel JS API》</a>
|
||||
- <a href="./前沿技术/226.%E7%B2%BE%E8%AF%BB%E3%80%8A2021%20%E5%89%8D%E7%AB%AF%E6%96%B0%E7%A7%80%E5%9B%9E%E9%A1%BE%E3%80%8B.md">226.精读《2021 前端新秀回顾》</a>
|
||||
- <a href="./前沿技术/228.%E7%B2%BE%E8%AF%BB%E3%80%8Apipe%20operator%20for%20JavaScript%E3%80%8B.md">228.精读《pipe operator for JavaScript》</a>
|
||||
- <a href="./前沿技术/230.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%AF%B9%20Markdown%20%E7%9A%84%E6%80%9D%E8%80%83%E3%80%8B.md">230.精读《对 Markdown 的思考》</a>
|
||||
- <a href="./前沿技术/237.%E7%B2%BE%E8%AF%BB%E3%80%8ATypescript%204.5-4.6%20%E6%96%B0%E7%89%B9%E6%80%A7%E3%80%8B.md">237.精读《Typescript 4.5-4.6 新特性》</a>
|
||||
|
||||
### 设计模式
|
||||
|
||||
- <a href="./设计模式/167.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Abstract%20Factory%20%E6%8A%BD%E8%B1%A1%E5%B7%A5%E5%8E%82%E3%80%8B.md">167.精读《设计模式 - Abstract Factory 抽象工厂》</a>
|
||||
- <a href="./设计模式/168.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Builder%20%E7%94%9F%E6%88%90%E5%99%A8%E3%80%8B.md">168.精读《设计模式 - Builder 生成器》</a>
|
||||
- <a href="./设计模式/169.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Factory%20Method%20%E5%B7%A5%E5%8E%82%E6%96%B9%E6%B3%95%E3%80%8B.md">169.精读《设计模式 - Factory Method 工厂方法》</a>
|
||||
- <a href="./设计模式/170.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Prototype%20%E5%8E%9F%E5%9E%8B%E6%A8%A1%E5%BC%8F%E3%80%8B.md">170.精读《设计模式 - Prototype 原型模式》</a>
|
||||
- <a href="./设计模式/171.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Singleton%20%E5%8D%95%E4%BE%8B%E6%A8%A1%E5%BC%8F%E3%80%8B.md">171.精读《设计模式 - Singleton 单例模式》</a>
|
||||
- <a href="./设计模式/172.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Adapter%20%E9%80%82%E9%85%8D%E5%99%A8%E6%A8%A1%E5%BC%8F%E3%80%8B.md">172.精读《设计模式 - Adapter 适配器模式》</a>
|
||||
- <a href="./设计模式/173.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Bridge%20%E6%A1%A5%E6%8E%A5%E6%A8%A1%E5%BC%8F%E3%80%8B.md">173.精读《设计模式 - Bridge 桥接模式》</a>
|
||||
- <a href="./设计模式/174.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Composite%20%E7%BB%84%E5%90%88%E6%A8%A1%E5%BC%8F%E3%80%8B.md">174.精读《设计模式 - Composite 组合模式》</a>
|
||||
- <a href="./设计模式/175.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Decorator%20%E8%A3%85%E9%A5%B0%E5%99%A8%E6%A8%A1%E5%BC%8F%E3%80%8B.md">175.精读《设计模式 - Decorator 装饰器模式》</a>
|
||||
- <a href="./设计模式/176.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Facade%20%E5%A4%96%E8%A7%82%E6%A8%A1%E5%BC%8F%E3%80%8B.md">176.精读《设计模式 - Facade 外观模式》</a>
|
||||
- <a href="./设计模式/177.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Flyweight%20%E4%BA%AB%E5%85%83%E6%A8%A1%E5%BC%8F%E3%80%8B.md">177.精读《设计模式 - Flyweight 享元模式》</a>
|
||||
- <a href="./设计模式/178.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Proxy%20%E4%BB%A3%E7%90%86%E6%A8%A1%E5%BC%8F%E3%80%8B.md">178.精读《设计模式 - Proxy 代理模式》</a>
|
||||
- <a href="./设计模式/179.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Chain%20of%20Responsibility%20%E8%81%8C%E8%B4%A3%E9%93%BE%E6%A8%A1%E5%BC%8F%E3%80%8B.md">179.精读《设计模式 - Chain of Responsibility 职责链模式》</a>
|
||||
- <a href="./设计模式/180.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Command%20%E5%91%BD%E4%BB%A4%E6%A8%A1%E5%BC%8F%E3%80%8B.md">180.精读《设计模式 - Command 命令模式》</a>
|
||||
- <a href="./设计模式/181.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Interpreter%20%E8%A7%A3%E9%87%8A%E5%99%A8%E6%A8%A1%E5%BC%8F%E3%80%8B.md">181.精读《设计模式 - Interpreter 解释器模式》</a>
|
||||
- <a href="./设计模式/182.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Iterator%20%E8%BF%AD%E4%BB%A3%E5%99%A8%E6%A8%A1%E5%BC%8F%E3%80%8B.md">182.精读《设计模式 - Iterator 迭代器模式》</a>
|
||||
- <a href="./设计模式/183.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Mediator%20%E4%B8%AD%E4%BB%8B%E8%80%85%E6%A8%A1%E5%BC%8F%E3%80%8B.md">183.精读《设计模式 - Mediator 中介者模式》</a>
|
||||
- <a href="./设计模式/184.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Memoto%20%E5%A4%87%E5%BF%98%E5%BD%95%E6%A8%A1%E5%BC%8F%E3%80%8B.md">184.精读《设计模式 - Memoto 备忘录模式》</a>
|
||||
- <a href="./设计模式/185.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Observer%20%E8%A7%82%E5%AF%9F%E8%80%85%E6%A8%A1%E5%BC%8F%E3%80%8B.md">185.精读《设计模式 - Observer 观察者模式》</a>
|
||||
- <a href="./设计模式/186.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20State%20%E7%8A%B6%E6%80%81%E6%A8%A1%E5%BC%8F%E3%80%8B.md">186.精读《设计模式 - State 状态模式》</a>
|
||||
- <a href="./设计模式/187.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Strategy%20%E7%AD%96%E7%95%A5%E6%A8%A1%E5%BC%8F%E3%80%8B.md">187.精读《设计模式 - Strategy 策略模式》</a>
|
||||
- <a href="./设计模式/188.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Template%20Method%20%E6%A8%A1%E7%89%88%E6%A8%A1%E5%BC%8F%E3%80%8B.md">188.精读《设计模式 - Template Method 模版模式》</a>
|
||||
- <a href="./设计模式/189.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F%20-%20Visitor%20%E8%AE%BF%E9%97%AE%E8%80%85%E6%A8%A1%E5%BC%8F%E3%80%8B.md">189.精读《设计模式 - Visitor 访问者模式》</a>
|
||||
|
||||
### 编译原理
|
||||
|
||||
- <a href="./编译原理/64.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E8%AF%8D%E6%B3%95%E5%88%86%E6%9E%90%E3%80%8B.md">64.精读《手写 SQL 编译器 - 词法分析》</a>
|
||||
- <a href="./编译原理/65.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E6%96%87%E6%B3%95%E4%BB%8B%E7%BB%8D%E3%80%8B.md">65.精读《手写 SQL 编译器 - 文法介绍》</a>
|
||||
- <a href="./编译原理/66.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E8%AF%AD%E6%B3%95%E5%88%86%E6%9E%90%E3%80%8B.md">66.精读《手写 SQL 编译器 - 语法分析》</a>
|
||||
- <a href="./编译原理/67.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E5%9B%9E%E6%BA%AF%E3%80%8B.md">67.精读《手写 SQL 编译器 - 回溯》</a>
|
||||
- <a href="./编译原理/70.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E8%AF%AD%E6%B3%95%E6%A0%91%E3%80%8B.md">70.精读《手写 SQL 编译器 - 语法树》</a>
|
||||
- <a href="./编译原理/71.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E9%94%99%E8%AF%AF%E6%8F%90%E7%A4%BA%E3%80%8B.md">71.精读《手写 SQL 编译器 - 错误提示》</a>
|
||||
- <a href="./编译原理/78.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E6%80%A7%E8%83%BD%E4%BC%98%E5%8C%96%E4%B9%8B%E7%BC%93%E5%AD%98%E3%80%8B.md">78.精读《手写 SQL 编译器 - 性能优化之缓存》</a>
|
||||
- <a href="./编译原理/85.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E6%99%BA%E8%83%BD%E6%8F%90%E7%A4%BA%E3%80%8B.md">85.精读《手写 SQL 编译器 - 智能提示》</a>
|
||||
|
||||
### 源码解读
|
||||
|
||||
- <a href="./源码解读/48.%E7%B2%BE%E8%AF%BB%E3%80%8AImmer.js%E3%80%8B%E6%BA%90%E7%A0%81.md">48.精读《Immer.js》源码</a>
|
||||
- <a href="./源码解读/73.%E7%B2%BE%E8%AF%BB%E3%80%8Asqorn%20%E6%BA%90%E7%A0%81%E3%80%8B.md">73.精读《sqorn 源码》</a>
|
||||
- <a href="./源码解读/75.%E7%B2%BE%E8%AF%BB%E3%80%8AEpitath%20%E6%BA%90%E7%A0%81%20-%20renderProps%20%E6%96%B0%E7%94%A8%E6%B3%95%E3%80%8B.md">75.精读《Epitath 源码 - renderProps 新用法》</a>
|
||||
- <a href="./源码解读/82.%E7%B2%BE%E8%AF%BB%E3%80%8AHtm%20-%20Hyperscript%20%E6%BA%90%E7%A0%81%E3%80%8B.md">82.精读《Htm - Hyperscript 源码》</a>
|
||||
- <a href="./源码解读/92.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20PowerPlug%20%E6%BA%90%E7%A0%81%E3%80%8B.md">92.精读《React PowerPlug 源码》</a>
|
||||
- <a href="./源码解读/93.%E7%B2%BE%E8%AF%BB%E3%80%8Asyntax-parser%20%E6%BA%90%E7%A0%81%E3%80%8B.md">93.精读《syntax-parser 源码》</a>
|
||||
- <a href="./源码解读/98.%E7%B2%BE%E8%AF%BB%E3%80%8Areact-easy-state%20%E6%BA%90%E7%A0%81%E3%80%8B.md">98.精读《react-easy-state 源码》</a>
|
||||
- <a href="./源码解读/110.%E7%B2%BE%E8%AF%BB%E3%80%8AInject%20Instance%20%E6%BA%90%E7%A0%81%E3%80%8B.md">110.精读《Inject Instance 源码》</a>
|
||||
- <a href="./源码解读/122.%E7%B2%BE%E8%AF%BB%E3%80%8Arobot%20%E6%BA%90%E7%A0%81%20-%20%E6%9C%89%E9%99%90%E7%8A%B6%E6%80%81%E6%9C%BA%E3%80%8B.md">122.精读《robot 源码 - 有限状态机》</a>
|
||||
- <a href="./源码解读/128.%E7%B2%BE%E8%AF%BB%E3%80%8AHooks%20%E5%8F%96%E6%95%B0%20-%20swr%20%E6%BA%90%E7%A0%81%E3%80%8B.md">128.精读《Hooks 取数 - swr 源码》</a>
|
||||
- <a href="./源码解读/130.%E7%B2%BE%E8%AF%BB%E3%80%8Aunstated%20%E4%B8%8E%20unstated-next%20%E6%BA%90%E7%A0%81%E3%80%8B.md">130.精读《unstated 与 unstated-next 源码》</a>
|
||||
- <a href="./源码解读/151.%20%E7%B2%BE%E8%AF%BB%E3%80%8A%40umijs%20use-request%E3%80%8B%E6%BA%90%E7%A0%81.md">151. 精读《@umijs use-request》源码</a>
|
||||
- <a href="./源码解读/155.%20%E7%B2%BE%E8%AF%BB%E3%80%8Ause-what-changed%20%E6%BA%90%E7%A0%81%E3%80%8B.md">155. 精读《use-what-changed 源码》</a>
|
||||
- <a href="./源码解读/156.%20%E7%B2%BE%E8%AF%BB%E3%80%8Areact-intersection-observer%20%E6%BA%90%E7%A0%81%E3%80%8B.md">156. 精读《react-intersection-observer 源码》</a>
|
||||
- <a href="./源码解读/227.%20%E7%B2%BE%E8%AF%BB%E3%80%8Azustand%20%E6%BA%90%E7%A0%81%E3%80%8B.md">227. 精读《zustand 源码》</a>
|
||||
- <a href="./源码解读/229.%E7%B2%BE%E8%AF%BB%E3%80%8Avue-lit%20%E6%BA%90%E7%A0%81%E3%80%8B.md">229.精读《vue-lit 源码》</a>
|
||||
|
||||
### 商业思考
|
||||
|
||||
- <a href="./商业思考/90.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%9E%81%E5%AE%A2%E5%85%AC%E5%9B%AD%202019%E3%80%8B.md">90.精读《极客公园 2019》</a>
|
||||
- <a href="./商业思考/103.%E7%B2%BE%E8%AF%BB%E3%80%8A%E4%B8%BA%E4%BB%80%E4%B9%88%E4%B8%93%E5%AE%B6%E4%B8%8D%E5%86%8D%E5%85%B3%E5%BF%83%E6%8A%80%E6%9C%AF%E7%BB%86%E8%8A%82%E3%80%8B.md">103.精读《为什么专家不再关心技术细节》</a>
|
||||
- <a href="./商业思考/106.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%95%B0%E6%8D%AE%E4%B9%8B%E4%B8%8A%C2%B7%E6%99%BA%E6%85%A7%E4%B9%8B%E5%85%89%20-%202018%E3%80%8B.md">106.精读《数据之上·智慧之光 - 2018》</a>
|
||||
- <a href="./商业思考/108.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%99%BA%E8%83%BD%E5%95%86%E4%B8%9A%E3%80%8B.md">108.精读《智能商业》</a>
|
||||
- <a href="./商业思考/114.%E7%B2%BE%E8%AF%BB%E3%80%8A%E8%B0%81%E5%9C%A8%E4%B8%96%E7%95%8C%E4%B8%AD%E5%BF%83%E3%80%8B.md">114.精读《谁在世界中心》</a>
|
||||
- <a href="./商业思考/115.%E7%B2%BE%E8%AF%BB%E3%80%8ATableau%20%E5%85%A5%E9%97%A8%E3%80%8B.md">115.精读《Tableau 入门》</a>
|
||||
- <a href="./商业思考/116.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%88%B7%E6%96%B0%E3%80%8B.md">116.精读《刷新》</a>
|
||||
- <a href="./商业思考/131.%E7%B2%BE%E8%AF%BB%E3%80%8A%E4%BB%8E%200%20%E5%88%B0%201%E3%80%8B.md">131.精读《从 0 到 1》</a>
|
||||
- <a href="./商业思考/135.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%9E%81%E5%AE%A2%E5%85%AC%E5%9B%AD%20IFX%20-%20%E4%B8%8A%E3%80%8B.md">135.精读《极客公园 IFX - 上》</a>
|
||||
- <a href="./商业思考/136.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%9E%81%E5%AE%A2%E5%85%AC%E5%9B%AD%20IFX%20-%20%E4%B8%8B%E3%80%8B.md">136.精读《极客公园 IFX - 下》</a>
|
||||
- <a href="./商业思考/137.%E7%B2%BE%E8%AF%BB%E3%80%8A%E5%BD%93%E6%88%91%E5%9C%A8%E5%88%86%E4%BA%AB%E7%9A%84%E6%97%B6%E5%80%99%EF%BC%8C%E6%88%91%E5%9C%A8%E5%81%9A%E4%BB%80%E4%B9%88%EF%BC%9F%E3%80%8B.md">137.精读《当我在分享的时候,我在做什么?》</a>
|
||||
|
||||
### 算法
|
||||
|
||||
- <a href="./算法/198.%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%AE%97%E6%B3%95%20-%20%E5%8A%A8%E6%80%81%E8%A7%84%E5%88%92%E3%80%8B.md">198.精读《算法 - 动态规划》</a>
|
||||
- <a href="./算法/199.%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%AE%97%E6%B3%95%20-%20%E6%BB%91%E5%8A%A8%E7%AA%97%E5%8F%A3%E3%80%8B.md">199.精读《算法 - 滑动窗口》</a>
|
||||
- <a href="./算法/200.%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%AE%97%E6%B3%95%20-%20%E5%9B%9E%E6%BA%AF%E3%80%8B.md">200.精读《算法 - 回溯》</a>
|
||||
- <a href="./算法/201.%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%AE%97%E6%B3%95%20-%20%E4%BA%8C%E5%8F%89%E6%A0%91%E3%80%8B.md">201.精读《算法 - 二叉树》</a>
|
||||
- <a href="./算法/203.%E7%B2%BE%E8%AF%BB%E3%80%8A%E7%AE%97%E6%B3%95%20-%20%E4%BA%8C%E5%8F%89%E6%90%9C%E7%B4%A2%E6%A0%91%E3%80%8B.md">203.精读《算法 - 二叉搜索树》</a>
|
||||
|
||||
### SQL
|
||||
|
||||
- <a href="./SQL/231.SQL%20%E5%85%A5%E9%97%A8.md">231.SQL 入门</a>
|
||||
- <a href="./SQL/232.SQL%20%E8%81%9A%E5%90%88%E6%9F%A5%E8%AF%A2.md">232.SQL 聚合查询</a>
|
||||
- <a href="./SQL/233.SQL%20%E5%A4%8D%E6%9D%82%E6%9F%A5%E8%AF%A2.md">233.SQL 复杂查询</a>
|
||||
- <a href="./SQL/234.SQL%20CASE%20%E8%A1%A8%E8%BE%BE%E5%BC%8F.md">234.SQL CASE 表达式</a>
|
||||
- <a href="./SQL/235.SQL%20%E7%AA%97%E5%8F%A3%E5%87%BD%E6%95%B0.md">235.SQL 窗口函数</a>
|
||||
- <a href="./SQL/236.SQL%20grouping.md">236.SQL grouping</a>
|
||||
|
||||
## 关注前端精读微信公众号
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
## Special Sponsors
|
||||
|
||||
<table>
|
||||
<tbody>
|
||||
<tr>
|
||||
<td align="center" valign="middle">
|
||||
<a href="https://e.coding.net/?utm_source=weekly" target="_blank">
|
||||
<img width="300" src="https://img.alicdn.com/tfs/TB107D.QbrpK1RjSZTEXXcWAVXa-1000-332.png">
|
||||
</a>
|
||||
</td>
|
||||
</tr>
|
||||
</tbody>
|
||||
</table>
|
||||
|
||||
@@ -8,9 +8,9 @@
|
||||
|
||||
# 1 引言
|
||||
|
||||
<img src="assets/1/cube.jpeg" alt="logo" width="500" />
|
||||
<img src="https://img.alicdn.com/imgextra/i4/O1CN01mvDKCM1owPSsLDBmI_!!6000000005289-2-tps-475-297.png" alt="logo" width="500" />
|
||||
|
||||
> 如今,Javascript 模块化规范非常方便、自然,但这个新规范仅执行了2年,就在 4 年前,js 的模块化还停留在运行时支持,10 年前,通过后端模版定义、注释定义模块依赖。对经历过来的人来说,历史的模块化方式还停留在脑海中,反而新上手的同学会更快接受现代的模块化规范。
|
||||
> 如今,Javascript 模块化规范非常方便、自然,但这个新规范仅执行了 2 年,就在 4 年前,js 的模块化还停留在运行时支持,10 年前,通过后端模版定义、注释定义模块依赖。对经历过来的人来说,历史的模块化方式还停留在脑海中,反而新上手的同学会更快接受现代的模块化规范。
|
||||
|
||||
但为什么要了解 Javascript 模块化发展的历史呢?因为凡事都有两面性,了解 Javascript 模块化规范,有利于我们思考出更好的模块化方案,纵观历史,从 1999 年开始,模块化方案最多维持两年,就出现了新的替代方案,比原有的模块化更清晰、强壮,我们不能被现代模块化方式限制住思维,因为现在的 ES2015 模块化方案距离发布也仅仅过了两年。
|
||||
|
||||
@@ -26,7 +26,7 @@
|
||||
|
||||
**外部依赖定义 (2007)**: 这种定义方式在 cocos2d-js 开发中普遍使用,其核心思想是将依赖抽出单独文件定义,这种方式不利于项目管理,毕竟依赖抽到代码之外,我是不是得两头找呢?所以才有通过 webpack 打包为一个文件的方式暴力替换为 commonjs 的方式出现。
|
||||
|
||||
**Sandbox模式 (2009)**: 这种模块化方式很简单,暴力,将所有模块塞到一个 `sanbox` 变量中,硬伤是无法解决明明冲突问题,毕竟都塞到一个 `sandbox` 对象里,而 `Sandbox` 对象也需要定义在全局,存在被覆盖的风险。模块化需要保证全局变量尽量干净,目前为止的模块化方案都没有很好的做到这一点。
|
||||
**Sandbox 模式 (2009)**: 这种模块化方式很简单,暴力,将所有模块塞到一个 `sandbox` 变量中,硬伤是无法解决命名冲突问题,毕竟都塞到一个 `sandbox` 对象里,而 `Sandbox` 对象也需要定义在全局,存在被覆盖的风险。模块化需要保证全局变量尽量干净,目前为止的模块化方案都没有很好的做到这一点。
|
||||
|
||||
**依赖注入 (2009)**: 就是大家熟知的 angular1.0,依赖注入的思想现在已广泛运用在 react、vue 等流行框架中。但依赖注入和解决模块化问题还差得远。
|
||||
|
||||
@@ -52,7 +52,7 @@
|
||||
|
||||
这篇文章所提供的模块化历史的方案都是逻辑模块化,**从 CommonJS 方案开始前端把服务端的解决方案搬过来之后,算是看到标准物理与逻辑统一的模块化**。但之后前端工程不得不引入模块化构建这一步。正是这一步给前端开发无疑带来了诸多的不便,尤其是现在我们开发过程中经常为了优化这个工具带了很多额外的成本。
|
||||
|
||||
从 CommonJS 之前其实都只是封装,并没有一套模块化规范,这个就有些像类与包的概念。我在10年左右用的最多的还是 YUI2,YUI2 是用 namespace 来做模块化的,但有很多问题没有解决,比如多版本共存,因此后来 YUI3 出来了。
|
||||
从 CommonJS 之前其实都只是封装,并没有一套模块化规范,这个就有些像类与包的概念。我在 10 年左右用的最多的还是 YUI2,YUI2 是用 namespace 来做模块化的,但有很多问题没有解决,比如多版本共存,因此后来 YUI3 出来了。
|
||||
|
||||
```javascript
|
||||
YUI().use('node', 'event', function (Y) {
|
||||
@@ -81,7 +81,7 @@ YUI3 的 sandbox 像极了差不多同时出现的 AMD 规范,但早期 yahoo
|
||||
|
||||
对于 js 模块化,最近出现的 `<script type="module">` 方式,虽然还没有得到浏览器原生支持,但也是我比较看好的未来趋势,这样就连 webpack 的拆包都不需要了,直接把源代码传到服务器,配合 http2.0 完美抛开预编译的枷锁。
|
||||
|
||||
上述三中方案都不依赖预编译,分别实现了 html、css、js 模块化,相信这就是未来。
|
||||
上述三种方案都不依赖预编译,分别实现了 html、css、js 模块化,相信这就是未来。
|
||||
|
||||
### 模块化标准推进速度仍然缓慢
|
||||
|
||||
@@ -103,7 +103,7 @@ YUI3 的 sandbox 像极了差不多同时出现的 AMD 规范,但早期 yahoo
|
||||
|
||||
> 看到大家基本都提到了 HTTP/2,对这项技术解决前端模块化及资源打包等工程问题抱有非常大的期待。很多人也认为 HTTP/2 普及后,基本就没有 Webpack 什么事情了。
|
||||
|
||||
不过 Webpack 作者 @sokra 在他的文章 [webpack & HTTP/2](https://medium.com/webpack/webpack-http-2-7083ec3f3ce6#.zdo4juvgo) 里提到了一个新的 Webpack 插件 `AggressiveSplittingPlugin`。简单的说,这款插件就是为了充分利用 HTTP/2 的文件缓存能力,将你的业务代码自动拆分成若干个数十 KB 的小文件。后续若其中任意一个文件发生变化,可以保证其他的小 chunck 不需要重新下载。
|
||||
不过 Webpack 作者 @sokra 在他的文章 [webpack & HTTP/2](https://medium.com/webpack/webpack-http-2-7083ec3f3ce6#.zdo4juvgo) 里提到了一个新的 Webpack 插件 `AggressiveSplittingPlugin`。简单的说,这款插件就是为了充分利用 HTTP/2 的文件缓存能力,将你的业务代码自动拆分成若干个数十 KB 的小文件。后续若其中任意一个文件发生变化,可以保证其他的小 chunk 不需要重新下载。
|
||||
|
||||
可见,**即使不断的有新技术出现,也依然需要配套的工具来将前端工程问题解决方案推向极致。**
|
||||
|
||||
@@ -118,7 +118,7 @@ YUI3 的 sandbox 像极了差不多同时出现的 AMD 规范,但早期 yahoo
|
||||
### 补充阅读
|
||||
|
||||
- [JavaScript 模块化七日谈](https://huangxuan.me/2015/07/09/js-module-7day/)
|
||||
- [JavaScript模块化编程简史(2009-2016)](https://yuguo.us/weblog/javascript-module-development-history/)
|
||||
- [JavaScript 模块化编程简史(2009-2016)](https://yuguo.us/weblog/javascript-module-development-history/)
|
||||
|
||||
# 总结
|
||||
|
||||
@@ -136,4 +136,4 @@ YUI3 的 sandbox 像极了差不多同时出现的 AMD 规范,但早期 yahoo
|
||||
|
||||
至此,对于 javascript 模块化讨论已接近尾声,对其优缺点也基本达成了一致。前端复杂度不断提高,促使着模块化的改进,代理(浏览器、node) 的支持程度,与前端特殊性(流量、缓存)可能前端永远也离不开构建工具,新的标准会让这些工作做的更好,同时取代、增强部分特征,前端的未来是更加美好的,复杂度也更高。
|
||||
|
||||
**如果你想参与讨论,请[点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,每周五发布。**
|
||||
**如果你想参与讨论,请[点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,每周五发布。**
|
||||
@@ -7,29 +7,29 @@
|
||||
|
||||
我为什么要选这篇文章呢?
|
||||
|
||||
就在前几天的 Google I/O 2017上, Polymer 正式发布了 [Polymer 2.0](https://www.polymer-project.org/blog/2017-05-15-time-for-two) 版本.
|
||||
就在前几天的 Google I/O 2017 上, Polymer 正式发布了 [Polymer 2.0](https://www.polymer-project.org/blog/2017-05-15-time-for-two) 版本.
|
||||
|
||||
来看一下 Polymer 2.0 的一些变化:
|
||||
- 使用 Shadow DOM v1 代替 Polymer.dom. Shady DOM从 Polymer 中分离出来。
|
||||
- 使用 Shadow DOM v1 代替 Polymer.dom. Shady DOM 从 Polymer 中分离出来。
|
||||
- 使用 标准的 ES6 类和 Custom Elements v1 来自定义元素.
|
||||
- 还有数据系统的改进和生命周期的变更.
|
||||
|
||||
可以看到, Polymer 的这次升级主要是将 Shadow Dom 和 Custom Elements 升级到 v1 版本, 以获得更多浏览器的原生支持. 下一 代Web Components - v1规范,Chrome 已经支持了,Web Components 规范中的2个主要部分 - [Shadow Dom](https://www.chromestatus.com/feature/4667415417847808) 和 [Custom Elements](https://www.chromestatus.com/feature/4696261944934400). Safari在10版本中, 支持了 [Shadow DOM v1](https://webkit.org/status/#feature-shadow-dom) 规范并且完成了在Webkit内核中对 [Custom Elements v1](https://webkit.org/blog/7027/introducing-custom-elements/) 规范的实现;Firefox对 [Shadow DOM](https://platform-status.mozilla.org/#shadow-dom) 和 [Custom Elements v1规范](https://platform-status.mozilla.org/#custom-elements) 支持正在开发中;Edge也将对 [Shadow DOM](https://developer.microsoft.com/en-us/microsoft-edge/platform/status/shadowdom/) 和 [Custom Elements](https://developer.microsoft.com/en-us/microsoft-edge/platform/status/customelements/) 支持规划到他们的开发roadmap中。
|
||||
可以看到, Polymer 的这次升级主要是将 Shadow Dom 和 Custom Elements 升级到 v1 版本, 以获得更多浏览器的原生支持. 下一 代 Web Components - v1 规范,Chrome 已经支持了,Web Components 规范中的 2 个主要部分 - [Shadow Dom](https://www.chromestatus.com/feature/4667415417847808) 和 [Custom Elements](https://www.chromestatus.com/feature/4696261944934400). Safari 在 10 版本中, 支持了 [Shadow DOM v1](https://webkit.org/status/#feature-shadow-dom) 规范并且完成了在 Webkit 内核中对 [Custom Elements v1](https://webkit.org/blog/7027/introducing-custom-elements/) 规范的实现;Firefox 对 [Shadow DOM](https://platform-status.mozilla.org/#shadow-dom) 和 [Custom Elements v1 规范](https://platform-status.mozilla.org/#custom-elements) 支持正在开发中;Edge 也将对 [Shadow DOM](https://developer.microsoft.com/en-us/microsoft-edge/platform/status/shadowdom/) 和 [Custom Elements](https://developer.microsoft.com/en-us/microsoft-edge/platform/status/customelements/) 支持规划到他们的开发 roadmap 中。
|
||||
|
||||
这段时间, 大家都在讨论 react, vue, angular, 这些框架. 或者 该使用 redux 还 是 mobx 做数据管理. 在这个契机下, 我想我们可以不单单去思考这些框架, 也可以更多地去思考和了解 Web Components 标准. 对于 Web Components标准有一些思考. 所以我选了一篇关于 Web Components 的文章, 想让大家对于 Web Components 的发展, 和 Web Componets 与现在的主流框架如何协作有更多的思考和讨论.
|
||||
这段时间, 大家都在讨论 react, vue, angular, 这些框架. 或者 该使用 redux 还 是 mobx 做数据管理. 在这个契机下, 我想我们可以不单单去思考这些框架, 也可以更多地去思考和了解 Web Components 标准. 对于 Web Components 标准有一些思考. 所以我选了一篇关于 Web Components 的文章, 想让大家对于 Web Components 的发展, 和 Web Componets 与现在的主流框架如何协作有更多的思考和讨论.
|
||||
|
||||
|
||||
# 2 内容概要
|
||||
|
||||
**The broken promise of Web Components**
|
||||
原文作者dmitriid主要是在喷Web Components从2011年到2017年这6年间毫无进展, 一共产出了6份标准, 其中两份已经被弃用. 几乎只有一个主流浏览器(chrome) 支持.
|
||||
原文作者 dmitriid 主要是在喷 Web Components 从 2011 年到 2017 年这 6 年间毫无进展, 一共产出了 6 份标准, 其中两份已经被弃用. 几乎只有一个主流浏览器(chrome) 支持.
|
||||
|
||||

|
||||
|
||||
|
||||
- Web Components 这些规范强依赖 JS 的实现
|
||||
- Custom Elements 是 JS 脚本的一部分
|
||||
- HTML Templates 的出现就是为了被JS 脚本使用
|
||||
- HTML Templates 的出现就是为了被 JS 脚本使用
|
||||
- Shadow Dom 也需要配合 JS 脚本使用
|
||||
- 只有 HTML imports 可以脱离 JS 脚本使用
|
||||
- Web Components 操作 DOM
|
||||
@@ -38,16 +38,16 @@
|
||||
- 为了突破限制使用不同的方法来传递数据
|
||||
- CSS 作用域, 可以见上次精读[《请停止 css-in-js 的行为》](https://github.com/dt-fe/weekly/issues/12)
|
||||
|
||||
**来看一下Polymer 的 核心成员 Rob Dodson 对于本文的回应: Regarding the broken promise of Web Components**
|
||||
**来看一下 Polymer 的 核心成员 Rob Dodson 对于本文的回应: Regarding the broken promise of Web Components**
|
||||
|
||||
- Web Components 特性需要被浏览器支持,必须有平缓的过渡,良好的兼容,以及成熟的方案,因此推进速度会比较慢一些。
|
||||
- React 很棒, 但是也不要忽略其他基于 Web Components 的优秀库比如 [Amp](https://www.ampproject.org/)
|
||||
- 对于 DOM 更新的抽象比如 React/JSX很赞, 但是也带来了一些损耗. 在旧的移动设备上, 加载一个大的js 包性能依旧不理想, 最佳的做法是拆分你的 JS 包, 按需加载.
|
||||
- 使用 JSX 和 虚拟 DOM是很酷, 也可以直接把 JSX 用在 Web Components 内, 像[SkateJS](https://github.com/skatejs/skatejs)库, 已经在做这个事情了.
|
||||
- 没有标准的数据绑定, Polymer的数据绑定, 现在是基于[MDV](https://github.com/toolkitchen/mdv), 很多开发者更倾向于基于 Observables或者 ES6 Proxies的数据绑定方案.
|
||||
- 处理组件的字符串属性是很烦人, 但是由于每一个组件都是一个类的实例, 可以利用ES6 的 getters/setters来改变属性.
|
||||
- 对于 DOM 更新的抽象比如 React/JSX 很赞, 但是也带来了一些损耗. 在旧的移动设备上, 加载一个大的 js 包性能依旧不理想, 最佳的做法是拆分你的 JS 包, 按需加载.
|
||||
- 使用 JSX 和 虚拟 DOM 是很酷, 也可以直接把 JSX 用在 Web Components 内, 像[SkateJS](https://github.com/skatejs/skatejs)库, 已经在做这个事情了.
|
||||
- 没有标准的数据绑定, Polymer 的数据绑定, 现在是基于[MDV](https://github.com/toolkitchen/mdv), 很多开发者更倾向于基于 Observables 或者 ES6 Proxies 的数据绑定方案.
|
||||
- 处理组件的字符串属性是很烦人, 但是由于每一个组件都是一个类的实例, 可以利用 ES6 的 getters/setters 来改变属性.
|
||||
|
||||
Rob Dodson对于 Web Components 依然充满信心, 但是也承认推进标准总会有各种阻碍, 不可能像推荐框架一样快速把事情解决.
|
||||
Rob Dodson 对于 Web Components 依然充满信心, 但是也承认推进标准总会有各种阻碍, 不可能像推荐框架一样快速把事情解决.
|
||||
|
||||
# 3 精读
|
||||
|
||||
@@ -55,11 +55,11 @@ Rob Dodson对于 Web Components 依然充满信心, 但是也承认推进标准
|
||||
[@camsong](https://www.zhihu.com/people/078cc0fb15845759ad8295b0f0e50099) [@黄子毅](https://github.com/ascoders) [@杨森](https://www.zhihu.com/people/c93b7957f6308990c7e3b16103c9356b) [@rccoder](https://github.com/rccoder) [@alcat2008](https://github.com/alcat2008)精读由此归纳。
|
||||
|
||||
### 标准与框架
|
||||
Web Components 作为一个标准,骨子里的进度就会落后于当前可行的技术体系。正如文中所说,浏览器厂商 ship 一个新功能是很严肃的,很可能会影响到一票的线上业务,甚至会影响到一个产业(遥想当年 [Chrome Extension 禁用 NPAPI](https://blog.chromium.org/2013/09/saying-goodbye-to-our-old-friend-npapi.html)时的一片哀鸿遍野,许多返利插件都使用了这种技术)。那么 Web Components的缓慢推进也在情理之中了.
|
||||
即使真的有一天这个标准建立起来,Web Components作为浏览器底层特性不应该拿出来和React这类应用层框架相比较. 未来Web Components会做为浏览器非常重要的特性存在。API偏低层操作,会易用性不够. 在很长时间内开发者依旧会使用 React/Vue/Angular/Polymer 这样的框架,Web Components可能会做为这些框架的底层做一些 浏览器层面上的支持.
|
||||
Web Components 作为一个标准,骨子里的进度就会落后于当前可行的技术体系。正如文中所说,浏览器厂商 ship 一个新功能是很严肃的,很可能会影响到一票的线上业务,甚至会影响到一个产业(遥想当年 [Chrome Extension 禁用 NPAPI](https://blog.chromium.org/2013/09/saying-goodbye-to-our-old-friend-npapi.html)时的一片哀鸿遍野,许多返利插件都使用了这种技术)。那么 Web Components 的缓慢推进也在情理之中了.
|
||||
即使真的有一天这个标准建立起来,Web Components 作为浏览器底层特性不应该拿出来和 React 这类应用层框架相比较. 未来 Web Components 会做为浏览器非常重要的特性存在。API 偏低层操作,会易用性不够. 在很长时间内开发者依旧会使用 React/Vue/Angular/Polymer 这样的框架,Web Components 可能会做为这些框架的底层做一些 浏览器层面上的支持.
|
||||
|
||||
### 不需要 vendor 的自定义组件间调用
|
||||
在 Webpack 大行其道的时代,想在运行时做到组件即引即用变得很困难,因为这些组件大多是通过 React/Vue/Angular 开发的。不得不考虑引入一大堆 Vendor 包,这些 Vendor 里可能还必须包含 React 这类两个版本不能同时使用的库。目前我们团队在做组件化方案时就遇到这个问题,只能想办法避免两个版本的出现。你可以说这是 React 或 Webpack 引入的问题,但并没有看到 Web Compnents 标准化的解决方案。我想未来Web Components可能会作为浏览器的底层, 出现基于底层的标准方案来做组件间的相互应用的方法.
|
||||
在 Webpack 大行其道的时代,想在运行时做到组件即引即用变得很困难,因为这些组件大多是通过 React/Vue/Angular 开发的。不得不考虑引入一大堆 Vendor 包,这些 Vendor 里可能还必须包含 React 这类两个版本不能同时使用的库。目前我们团队在做组件化方案时就遇到这个问题,只能想办法避免两个版本的出现。你可以说这是 React 或 Webpack 引入的问题,但并没有看到 Web Compnents 标准化的解决方案。我想未来 Web Components 可能会作为浏览器的底层, 出现基于底层的标准方案来做组件间的相互应用的方法.
|
||||
|
||||
|
||||
### 为什么对 Web components 讨论不断
|
||||
@@ -69,7 +69,7 @@ Web Components 作为一个标准,骨子里的进度就会落后于当前可
|
||||
但使用前端框架的问题也日益暴露,随着前端框架种类的增多,同一个框架不同版本之间无法共存,导致组件无法跨框架复用,甚至只能固定在框架的某个版本,这与前端未来的模块化发展是相违背的,我们越是与之抗衡,就越希望 Web components 能站出来解决这个问题,因为浏览器原生支持模块化,相当于将 react angular vue 的能力内置在浏览器中,而且一定会向前兼容(这也是 Web components 推进缓慢的原因)。
|
||||
|
||||
# 4 总结
|
||||
我觉得 Web Components作为浏览器底层特性不应该拿出来和React, vue 这类应用层框架相比较. Web Components 的方向以及提供的价值都不会跟 应用框架一致. 而 Web Components 作为未来的 Web 组件标准 , 它在任何生态中都可以运行良好. 我倒是更加期待应用层去基于 Web Components 去做更多的实现, 让组件超越框架存在, 可以在不同技术栈中使用.
|
||||
我觉得 Web Components 作为浏览器底层特性不应该拿出来和 React, vue 这类应用层框架相比较. Web Components 的方向以及提供的价值都不会跟 应用框架一致. 而 Web Components 作为未来的 Web 组件标准 , 它在任何生态中都可以运行良好. 我倒是更加期待应用层去基于 Web Components 去做更多的实现, 让组件超越框架存在, 可以在不同技术栈中使用.
|
||||
|
||||
|
||||
> 讨论地址是:[精读《Web Components 的困境》 · Issue #15 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/15)
|
||||
@@ -0,0 +1,147 @@
|
||||
# 一、摘要
|
||||
|
||||
相信大家以前应该接触过持续集成(Continuous integration)持续交付(continuous delivery)持续发布(continuous deployment)的概念,下面我们来说说三者的差异以及团队如何入手 CI/CD。
|
||||
|
||||
作者:猫神。
|
||||
|
||||
# 二、差异
|
||||
|
||||
### 2.1 CI 持续集成
|
||||
|
||||
开发者尽量时时刻刻合并开发分支至主干分支。避免直到发布日才开始合并,掉入集成地狱。无论何时新分支集成至项目,持续集成可以自动化测试持续验证应用是否正常。
|
||||
|
||||
### 2.2 CD 持续交付
|
||||
|
||||
持续交付是持续集成的扩展,可以保证稳定的发布产品新特性。这意味着基于自动化测试,你可以也可以一键自动化发布。理论上,持续交付可以决定是按天,按周,按双周发布产品。如果确实希望能够享受持续交付的好处,那么应该尽快发布到新产品中。一旦出现问题时能尽早排除。
|
||||
|
||||
### 2.3 CD 持续部署
|
||||
|
||||
持续部署是持续交付的下一步。通过这一步,每个新特性都自动的部署到产品中。但是如果出现未通过的测试用例将会终止自动部署。持续部署可以加速用户反馈新特性,避免发布日带来的压力。开发可以着力于开发系统,开发结束后几分钟就可以触达到用户。
|
||||
|
||||
# 三、协作
|
||||
|
||||
CI/CD 具体是个什么样的流程呢,如下图所示,差异仅在于是否自动部署。
|
||||
|
||||
<img src="https://img.alicdn.com/tfs/TB1sNtaTrPpK1RjSZFFXXa5PpXa-884-426.png" />
|
||||
|
||||
现在开发都讲究投入产出比,那么 CI/CD 具体需要做些什么呢?
|
||||
|
||||
### Continuous Intergretion 持续集成
|
||||
|
||||
投入:
|
||||
|
||||
- 需要为每个新特性编写测试用例
|
||||
|
||||
- 需要搭建持续集成服务器,监控主干仓库,并自动运行测试用例
|
||||
|
||||
- 开发需要尽量频繁的合并分支,至少一天一次
|
||||
|
||||
产出:
|
||||
|
||||
- 更少的 bug,因为自动化测试可以回归测试产品
|
||||
- 编译部署产品更简化,因为集成的问题都尽早的解决了
|
||||
- 开发者可以尽量减少上下文切换,因为构建的时候就暴露问题,尽早解决了
|
||||
- 测试成本降低,因为 CI 服务器可以一秒运行几百个测试用例
|
||||
- 测试团队花更少的时间测试,可以重点关注测试上的改进。
|
||||
|
||||
### Continuous delivery 持续交付
|
||||
|
||||
投入:
|
||||
|
||||
- 需要有持续集成的基础,测试用例需要覆盖足够的代码
|
||||
- 部署需要自动化,用户只需要手动触发,剩余的部署应该自动化
|
||||
- 团队需要增加新特性标志,避免未完成的新特性进入待发布的产品
|
||||
|
||||
产出:
|
||||
|
||||
- 部署软件变得非常简单。团队不需要花费 n 天准备发布。
|
||||
- 可以提高发布频率,加速新特性触达用户进程。
|
||||
- 小的更改,对决策的压力要小得多,可以更快地迭代。
|
||||
|
||||
### Continuous deployment 持续部署
|
||||
|
||||
投入:
|
||||
|
||||
- 测试必须要做到足够。测试的质量将决定发布的质量。
|
||||
- 文档建设需要和产品部署保持同步。
|
||||
- 新特性的发布需要协调其他部门,包括售后支持&市场&推广等。
|
||||
|
||||
产出:
|
||||
|
||||
- 快速的发布节奏,因为每个新特性一旦完成都会自动的发布给用户。
|
||||
- 发布风险降低,修复问题更容易,因为每次变更都是小步迭代发布。
|
||||
- 用户可以看到持续性的优化和质量提升,而不是非要等到按月,按季度,甚至按年
|
||||
|
||||
如果开发的是一个新项目,暂时还没有任何用户,那么每次提交代码后发布将会特别简单,可以随时随地发布。一旦产品开始开发后,就需要提高测试文化,并确保在构建应用程序时增加代码覆盖率。当您准备好面向用户发布时,您将有一个非常好的连续部署过程,在该过程中,所有新的更改都将在自动发布到生产环境之前进行测试。
|
||||
|
||||
如果正在开发的是一个老系统,就需要放慢节奏,开始打造持续集成&持续交付。首先可以完成一些简单可自动化执行的单元测试,不需要考虑复杂的端到端的测试。另外,应该尽快尝试自动化部署,搭建可以自动化部署的临时环境。因为自动化部署,可以让开发者去优化测试用例,而不是停下来联调发布。
|
||||
一旦开始按日发布产品,我们可以考虑持续部署,但一定要保证团队已经准备好这种方式,文档 & 售后支持 & 市场。这些步骤都需要加入到新产品发布节奏中,因为和用户直接打交道的是他们。
|
||||
|
||||
# 四、如何开始持续集成
|
||||
|
||||
## 4.1 了解测试类型
|
||||
|
||||
为了获得 CI 的所有好处,每次代码变更后,我们需要自动运行测试用例。我们需要在每个分支运行测试用例,而不是仅仅在主干分支。这样可以最快速的找到问题,最小化问题影响面。
|
||||
在初始阶段并不需要实现所有的测试类型。一开始可以以单元测试入手,随着时间扩展覆盖面。
|
||||
|
||||
- 单元测试:范围非常小,验证每个独立方法级别的操作。
|
||||
- 集成测试:保证模块间运行正常,包括多个模块、多个服务。
|
||||
- 验收测试:与集成测试类似,但是仅关注业务 case,而不是模块内部本身。
|
||||
- UI 测试:从用户的角度保证呈现正确运行。
|
||||
|
||||
并不是所有的测试都是对等的,实际运行中可以做些取舍。
|
||||
|
||||
<img src="https://img.alicdn.com/tfs/TB18278TmrqK1RjSZK9XXXyypXa-346-269.png" />
|
||||
|
||||
单元测试实现起来既快成本又低,因为它们主要是对小代码块进行检查。另一方面,UI 测试实施起来很复杂,运行起来很慢,因为它们通常需要启动一个完整的环境以及多个服务来模拟浏览器或移动行为。因此,实际情况可能希望限制复杂的 UI 测试的数量,并依赖基础上良好的单元测试来快速构建,并尽快获得开发人员的反馈。
|
||||
|
||||
### 4.2 自动运行测试
|
||||
|
||||
要采用持续集成,您需要对推回到主分支的每个变更运行测试。要做到这一点,您需要有一个服务来监视您的存储库,并听取对代码库的新推送。您可以从企业预置型解决方案和云端解决方案中进行选择。您需要考虑以下因素来选择服务器:
|
||||
|
||||
- 代码托管在哪里?CI 服务可以访问您的代码库吗?您对代码的生存位置有特殊的限制吗?
|
||||
- 应用程序需要哪些操作系统和资源?应用程序环境是否受支持?能安装正确的依赖项来构建和测试软件吗?
|
||||
- 测试需要多少资源?一些云应用程序可能对您可以使用的资源有限制。如果软件消耗大量资源,可能希望将 CI 服务器宿主在防火墙后面。
|
||||
- 团队中有多少开发人员?当团队实践 CI 时,每天都会将许多更改推回到主存储库中。对于开发人员来说,要获得快速的反馈,您需要减少构建的队列时间,并且您需要使用能够提供正确并发性的服务或服务器。
|
||||
在过去,通常需要安装一个独立的 CI 服务器,如 Bamboo 或 Jenkins,但现在您可以在云端找到更简单的解决方案。例如,如果您的代码托管在 BitBucket 云上,那么您可以使用存储库中的 Pipelines 功能在每次推送时运行测试,而无需配置单独的服务器或构建代理,也无需限制并发性。
|
||||
- 使用代码覆盖率查找未测试的代码。一旦您采用了自动化测试,最好将它与一个测试覆盖工具结合起来,帮助了解测试套件覆盖了多少代码库。代码覆盖率定在 80%以上是很好的,但要注意不要将高覆盖率与良好的测试套件混淆。代码覆盖工具将帮助您找到未经测试的代码,但在一天结束的时候,测试的质量会产生影响。如果刚开始,不要急于获得代码库的 100%覆盖率,而是使用测试覆盖率工具来找出应用程序的关键部分,这些部分还没有测试并从那里开始。
|
||||
- 重构是一个添加测试的机会。如果您将要对应用程序进行重大更改,那么应该首先围绕可能受到影响的特性编写验收测试。这将为您提供一个安全网,以确保在重构代码或添加新功能后,原始行为不会受到影响。
|
||||
|
||||
# 五、接受 CI 文化
|
||||
|
||||
自动化测试是 CI 的关键,但同时也需要团队成员接受 CI 文化,并不是心血来潮晒两天鱼,并且需要保证编译畅通无阻。QA 可以帮助团队建设测试文化。他们不再需要手动测试应用程序的琐碎功能,现在他们可以投入更多的时间来提供支持开发人员的工具,并帮助他们采用正确的测试策略。一旦开始采用持续集成,QA 工程师将能够专注于使用更好的工具和数据集促进测试,并帮助开发人员提高编写更好代码的能力。
|
||||
|
||||
- 尽早集成。如果很长时间不合并代码,代码冲突的风险就越高,代码冲突的范围就越广。如果发现某些分支会影响已经存在的分支,需要增加发布关闭标签,避免发布时两个分支冲突。
|
||||
- 保证编译时时刻刻畅通。一旦发现任何编译问题,立刻修复,否则可能会带来更多的错误。测试套件需要尽快反馈测试结果,或者优先返回短时间测试(单元测试)的结果,否则开发者可能就切换回开发了。一旦编译出错,需要通知给开发者,或者更进一步给出一个 dashboard,每个人都可以在这里查看编译结果。
|
||||
- 把测试用例纳入流程的一部分。确保每个分支都有自动化测试用例。似乎编写测试用例拖慢了项目节奏,但是它可以减少回归时间,减少每次迭代带来的 bug。而且每次测试通过后,将会非常有信息合并到主干分支,因为新增的内容不影响以前的功能。
|
||||
- 修 bug 的时候编写测试用例。把 bug 的每个场景都编写成测试用例,避免再次出现。
|
||||
|
||||
# 六、集成测试 5 个步骤
|
||||
|
||||
1. 从最严格的代码部分入手测试
|
||||
2. 搭建一个自动构建的服务自动运行测试用例,在每次提交代码后。
|
||||
3. 确保团队成员每天合并变更
|
||||
4. 代码出现问题及时修复
|
||||
5. 为每个新实现的操作编写测试用例。
|
||||
可能看着很简单,但是要求团队能够真正落地。一开始你需要放慢发布的脚步,需要和 pd、用户沟通确保不上线没有测试用例的新功能。我们的建议是从小处入手,通过简单的测试来适应新的例程,然后再着手实现更复杂更难管理的测试套件。
|
||||
|
||||
# 七、说说笔者的团队
|
||||
|
||||
以上文章主要是说明团队实现 CI/CD 的取舍和可行性步骤。下面来说说希望 CI/CD 给笔者团队带来什么样的变化。目前笔者团队已经实现前端项目发布编译工程化,采用的是基于 webpack 的自建工具云构建模式。但现在面临的问题是 1. 交互的系统比较多,交互系统提供的接入源变更后,需要人工通知其他系统手动触发编译,而且每次手动编译都需要在本地切换到指定分支,然后手动触发云构建,2. 多人协作,分支拆分较细,需要手动合并分支,触发编译。整个流程冗长,而且中间存在人力沟通成本,容易产生沟通误差。所以首先希望解决的是 CI 自动化,当依赖变更后或者分支合并后,自动集成,自动编译。当然生产环境暂时还不敢瞎搞,但大部分重复编译的工作量主要集中在预发环境,所以手动部署生产环境的成本还是可以接受的。CI 自动化之前,需要提供系统之间交互的单元测试用例,每次 CI 后自动运行单元测试用例,最好能打通 QA 的测试用例,进行回归测试。流程对比如下:
|
||||
|
||||
<img src="https://img.alicdn.com/tfs/TB1jIw.TgDqK1RjSZSyXXaxEVXa-1950-662.png"/>
|
||||
可以看出引入CI后,我们的成本是需要搭建CI服务器,新增单元测试、打通回归测试案例,但前者可以加快系统编译效率,后者可以进一步的提升代码质量,减少回归测试时间,这些成本都是可以接受的。市面上已有很多开源持续集成工具,例如我们熟悉的Jenkins,还有TeamCity、Travis CI、GO CD、Bamboo、Gitlab CI、CircleCI……等等等等。目前还在继续调研中,这片文章应该会有第二篇,说说后续的实践和CD。
|
||||
|
||||
> 讨论地址是:[精读《持续集成 vs 持续交付 vs 持续部署》 · Issue #147 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/147)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
**special Sponsors**
|
||||
|
||||
- [DevOps 全流程平台](https://e.coding.net/?utm_source=weekly)
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,151 @@
|
||||
# 1. 引言
|
||||
|
||||
本周精读的文章是 [The many Benefits of Using a Monorepo](https://pspdfkit.com/blog/2019/benefits-of-a-monorepo/)。
|
||||
|
||||
现在介绍 Monorepo 的文章很多,可以分为如下几类:直接介绍 [Lerna](https://github.com/lerna/lerna) API 的;介绍如何从独立仓库迁移到 Lerna 的;通过举例子说明 Monorepo 重要性的。
|
||||
|
||||
本文属于第三种,从 Android 与 IOS 的开发故事说明了 Monorepo 的重要性。
|
||||
|
||||
笔者之所以选择这篇文章,不是因为其故事写的好,而是认可这种具有普适性的解决思路。毕竟 Lerna 作为 Monorepo 的实现之一也并不尽善尽美,而不同场景对 Monorepo 依赖的原因、功能也有所不同,所以希望借这篇文章,从理论上解释清楚为什么会产生 Monorepo,以及 Monorepo 可以解决哪些问题,这样在工作遇到问题时,才能想清楚自己要的是什么。
|
||||
|
||||
# 2. 概述
|
||||
|
||||
作者的一个项目是 PDF 服务,简称 PSPDFKit,需要同时兼顾 Android 与 IOS 平台,项目的发展经历了如下几个阶段。
|
||||
|
||||
## 初始阶段
|
||||
|
||||
在 2011 到 2013 年间,PSPDFKit 仅支持 IOS 平台,但最终项目需要支持 Android,因此开了一个新仓库放置 Android 代码。Android 仓库的代码不仅在 UI 上不同,同时解析 PDF 文档的核心代码也不同,这是因为 IOS 平台上使用内置 PDF 渲染引擎同时做了一些业务拓展,但使用的 OC 代码无法在 Android 使用。
|
||||
|
||||
最终新建了两个仓库 `PSPDFKit-Android` 与 `Core` 。
|
||||
|
||||
仓库 Core 中代码依赖 Android 平台 JNI 的支持,所以并不能实现 Core 一处修改,两处都生效的愿望,而我们又希望两边功能始终兼容,且减少分支过多带来的潜在的冲突,因此花了很久才意识到应该将这两个仓库合并起来。
|
||||
|
||||
## 考虑使用 Monorepo
|
||||
|
||||
由于 Android 的整套流程自己控制的,因此总是可以快速修复用户提出的 BUG,然而 IOS 提供的 CGPDF 总会遇上各种问题。所以在 2014 年,我们开启了一个庞大的项目,重写 IOS 的 Core 库。有三中方式可供选择:
|
||||
|
||||
1. 在 IOS 代码中引用 `PSPDFKit-Android`。
|
||||
2. 将 `PSPDFKit-Android` 提取到 `Core` 仓库中并分别维护。
|
||||
3. 将 IOS 与 Android 代码合并到一个仓库中。
|
||||
|
||||
经过讨论,最终作者的团队选择了第三种方案,因此目录结构类似如下:
|
||||
|
||||
```bash
|
||||
- ios-platform
|
||||
- android-platform
|
||||
- core
|
||||
```
|
||||
|
||||
## 特例
|
||||
|
||||
Web 与后台服务代码一直是一个特例,我们认为这些内容相对独立,所以没有将其代码放置到 Monorepo 中。
|
||||
|
||||
直到一年后,开始探索 WebAssembly 时,PSPDFKit-web 模块就出现了,因为可以利用 WebAssembly 将 Core 的代码编译并在 Web 平台使用,因此 Core 仓库与 Web 仓库的关系变得非常紧密,最终,我们将 Web、Server 也都迁移到 Monorepo 中了。
|
||||
|
||||
## 问题
|
||||
|
||||
Monorepo 瑕不掩瑜,但作者还是列举了一些缺陷。
|
||||
|
||||
由于源码在一起,仓库变更非常常见,存储空间也变得很大,甚至几 GB,CI 测试运行时间也会变长。即便如此,团队中任何人都不想回到 git submodules 多仓库的方式。
|
||||
|
||||
# 3. 精读
|
||||
|
||||
总的来说,**虽然拆分子仓库、拆分子 NPM 包(For web)是进行项目隔离的天然方案,但当仓库内容出现关联时,没有任何一种调试方式比源码放在一起更高效。**
|
||||
|
||||
**工程化的最终目的是让业务开发可以 100% 聚焦在业务逻辑上**,那么这不仅仅是脚手架、框架需要从自动化、设计上解决的问题,这涉及到仓库管理的设计。
|
||||
|
||||
一个理想的开发环境可以抽象成这样:
|
||||
|
||||
“只关心业务代码,可以直接跨业务复用而不关心复用方式,调试时所有代码都在源码中。”
|
||||
|
||||
在前端开发环境中,多 Git Repo,多 Npm 则是这个理想的阻力,它们导致复用要关心版本号,调试需要 Npm Link。
|
||||
|
||||
另外对于多仓库的缺点,文中还有一些没有提到的因素,这里一并列举出来:
|
||||
|
||||
**管理、调试困难**
|
||||
|
||||
多个 git 仓库管理起来天然是麻烦的。对于功能类似的模块,如果拆成了多个仓库,无论对于多人协作还是独立开发,都需要打开多个仓库页面。
|
||||
|
||||
虽然 vscode 通过 [Workspaces](https://code.visualstudio.com/docs/editor/multi-root-workspaces) 解决多仓库管理的问题,但在多人协作的场景下,无法保证每个人的环境配置一致。
|
||||
|
||||
对于共用的包通过 Npm 安装,如果不能接受调试编译后的代码,或每次 npm link 一下,就没有办法调试依赖的子包。
|
||||
|
||||
**分支管理混乱**
|
||||
|
||||
假如一个仓库提供给 A、B 两个项目用,而 B 项目优先开发了功能 b,无法与 A 项目兼容,此时就要在这个仓库开一个 `feature/b` 的分支支持这个功能,并且在未来合并到主干同步到项目 A。
|
||||
|
||||
一旦需要开分支的组件变多了,且之间出来依赖关联,分支管理复杂度就会呈指数上升。
|
||||
|
||||
**依赖关系复杂**
|
||||
|
||||
独立仓库间组件版本号的维护需要手动操作,因为源代码不在一起,所以没有办法整体分析依赖,自动化管理版本号的依赖。
|
||||
|
||||
**三方依赖版本可能不一致**
|
||||
|
||||
一个独立的包拥有一套独立的开发环境,难以保证子模块的版本和主项目完全一直,就存在运行结果不一致的风险。
|
||||
|
||||
**占用总空间大**
|
||||
|
||||
正常情况下,一个公司的业务项目只有一个主干,多 git repo 的方式浪费了大量存储空间重复安装比如 React 等大型模块,时间久了可能会占用几十 GB 的额外空间,对于没有外接硬盘的同学来说,定期清理不用的项目下 `node_modules` 也是一件麻烦事。
|
||||
|
||||
**不利于团队协作**
|
||||
|
||||
一个大项目可能会用到数百个二方包,不同二方包的维护频率不同,权限不同,仓库位置也不同,主仓库对它们的依赖方式也不同。
|
||||
|
||||
一旦其中一个包进行了非正常改动,就会影响到整个项目,而我们精力有限,只盯着主仓库,往往会栽在不起眼的二方包发布上。
|
||||
|
||||
所以对于一个非常复杂,又具有技术挑战的大型系统在协作人员多的情况下出现问题的概率非常大,需要通过 Review 制度避免错误的发生,那么将所有相关的源码聚合在一个仓库下,是更好管理的。
|
||||
|
||||
## 理想 monorepo 的设计
|
||||
|
||||
参考 [Lerna](https://github.com/lerna/lerna) 的规范,以 `packages` 作为子模块根文件夹,笔者设计一个理想的 monorepo 结构:
|
||||
|
||||
```bash
|
||||
.
|
||||
├── packages
|
||||
│ ├─ module-a
|
||||
│ │ ├─ src # 模块 a 的源码
|
||||
│ │ └─ package.json # 自动生成的,仅模块 a 的依赖
|
||||
│ └─ module-b
|
||||
│ ├─ src # 模块 b 的源码
|
||||
│ └─ package.json # 自动生成的,仅模块 b 的依赖
|
||||
├── tsconfig.json # 配置文件,对整个项目生效
|
||||
├── .eslintrc # 配置文件,对整个项目生效
|
||||
├── node_modules # 整个项目只有一个外层 node_modules
|
||||
└── package.json # 包含整个项目所有依赖
|
||||
```
|
||||
|
||||
所有全局配置文件只有一个,这样不会导致 IDE 遇到子文件夹中的配置文件,导致全局配置失效或异常。`node_modules` 也只有一个,既保证了项目依赖的一致性,又避免了依赖被重复安装,节省空间的同时还提高了安装速度。
|
||||
|
||||
**兄弟模块之间通过模块 `package.json` 定义的 `name` 相互引用,保证模块之间的独立性,但又不需要真正发布或安装这个模块,通过 `tsconfig.json` 的 `paths` 与 `webpack` 的 `alias` 共同实现虚拟模块路径的效果。**
|
||||
|
||||
再结合 [Lerna](https://github.com/lerna/lerna) 根据联动发布功能,使每个子模块都可以独立发布。
|
||||
|
||||
# 4. 总结
|
||||
|
||||
[Lerna](https://github.com/lerna/lerna) 是业界知名度最高的 Monorepo 管理工具,功能完整。但由于通用性要求非常高,需要支持任意项目间 Monorepo 的组合,因此在 `packages` 文件夹下的配置文件还是与独立仓库保持一致,这样在 TS 环境下会造成配置截断的问题。同时包之间的引用也通过更通用的 [symlink](https://nodejs.org/dist/latest-v12.x/docs/api/fs.html#fs_fs_symlink_target_path_type_callback) 完成,这导致了还是要在子模块目录存在 `node_modules` 文件夹,而且效果依赖项目初始化命令。
|
||||
|
||||
如果加一些限定条件,比如基于 Webpack + Typescript 环境的 Monorepo,可以换一套思路,利用这些工具自身运行时功能,减少更多模版代码或配置文件,进一步提升 Monorepo 的效果。
|
||||
|
||||
对于别名映射,对 [symlink](https://nodejs.org/dist/latest-v12.x/docs/api/fs.html#fs_fs_symlink_target_path_type_callback) 与 [alias](https://webpack.js.org/configuration/resolve/#resolvealias) 进行对比:
|
||||
|
||||
- symlink: 更通用,适合任何构建器。但需要初始化,且在每个关联模块下新增 `node_modules` 文件夹。
|
||||
- alias: 限定构建器。但不需要初始化,不新增文件夹,甚至可以运行时动态修改别名配置。
|
||||
|
||||
可见如果限定了构建器,别名映射可以做得更轻量,且无需初始化。
|
||||
|
||||
今天的问题是,你的项目需要使用 Monorepo 吗?你对 Monorepo 有其他要求吗?
|
||||
|
||||
> 讨论地址是:[精读《Monorepo 的优势》 · Issue #151 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/151)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
**special Sponsors**
|
||||
|
||||
- [DevOps 全流程平台](https://e.coding.net/?utm_source=weekly)
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,429 @@
|
||||
# 1. 引言
|
||||
|
||||
本周精读的内容是:[Google I/O 19](https://www.youtube.com/watch?v=c0oy0vQKEZE)。
|
||||
|
||||
2019 年 Google I/O 介绍了一些激动人心的 JS 新特性,这些特性有些已经被主流浏览器实现,并支持 polyfill,有些还在草案阶段。
|
||||
|
||||
我们可以看到 JS 语言正变得越来越严谨,不同规范间也逐渐完成了闭环,而且在不断吸纳其他语言的优秀特性,比如 WeakRef,让 JS 在成为使用范围最广编程语言的同时,也越成为编程语言的集大成者,让我们有信心继续跟随 JS 生态,不用被新生的小语种分散精力。
|
||||
|
||||
# 2. 精读
|
||||
|
||||
本视频共介绍了 16 个新特性。
|
||||
|
||||
## private class fields
|
||||
|
||||
私有成员修饰符,用于 Class:
|
||||
|
||||
```js
|
||||
class IncreasingCounter {
|
||||
#count = 0;
|
||||
|
||||
get value() {
|
||||
return this.#count;
|
||||
}
|
||||
|
||||
increment() {
|
||||
this.#count++;
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
通过 `#` 修饰的成员变量或成员函数就成为了私有变量,如果试图在 Class 外部访问,则会抛出异常:
|
||||
|
||||
```js
|
||||
const counter = new IncreasingCounter()
|
||||
counter.#count
|
||||
// -> SyntaxError
|
||||
counter.#count = 42
|
||||
// -> SyntaxError
|
||||
```
|
||||
|
||||
虽然 `#` 这个关键字被吐槽了很多次,但结论已经尘埃落定了,只是个语法形式而已,不用太纠结。
|
||||
|
||||
目前仅 Chrome、Nodejs 支持。
|
||||
|
||||
## Regex matchAll
|
||||
|
||||
正则匹配支持了 `matchAll` API,可以更方便进行正则递归了:
|
||||
|
||||
```js
|
||||
const string = 'Magic hex number: DEADBEEF CAFE'
|
||||
const regex = /\b\p{ASCII_Hex_Digit}+\b/gu/
|
||||
for (const match of string.matchAll(regex)) {
|
||||
console.log(match)
|
||||
}
|
||||
|
||||
// Output:
|
||||
// ['DEADBEEF', index: 19, input: 'Magic hex number: DEADBEEF CAFE']
|
||||
// ['CAFE', index: 28, input: 'Magic hex number: DEADBEEF CAFE']
|
||||
```
|
||||
|
||||
相比以前在 `while` 语句里循环正则匹配,这个 API 真的是相当的便利。And more,还顺带提到了 `Named Capture Groups`,这个在之前的 [精读《正则 ES2018》](https://github.com/dt-fe/weekly/blob/v2/091.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%AD%A3%E5%88%99%20ES2018%E3%80%8B.md#22-named-capture-groups) 中也有提到,具体可以点过去阅读,也可以配合 `matchAll` 一起使用。
|
||||
|
||||
## Numeric literals
|
||||
|
||||
大数字面量的支持,比如:
|
||||
|
||||
```js
|
||||
1234567890123456789 * 123;
|
||||
// -> 151851850485185200000
|
||||
```
|
||||
|
||||
这样计算结果是丢失精度的,但只要在数字末尾加上 `n`,就可以正确计算大数了:
|
||||
|
||||
```js
|
||||
1234567890123456789n * 123n;
|
||||
// -> 151851850485185185047n
|
||||
```
|
||||
|
||||
目前 BigInt 已经被 Chrome、Firefox、Nodejs 支持。
|
||||
|
||||
## BigInt formatting
|
||||
|
||||
为了方便阅读,大数还支持了国际化,可以适配成不同国家的语言表达形式:
|
||||
|
||||
```js
|
||||
const nf = new Intl.NumberFormat("fr");
|
||||
nf.format(12345678901234567890n);
|
||||
// -> '12 345 678 901 234 567 890'
|
||||
```
|
||||
|
||||
记住 `Intl` 这个内置变量,后面还有不少国际化用途。
|
||||
|
||||
同时,为了方便程序员阅读代码,大数还支持带分隔符的书写方式,可以使用 `useGrouping` 属性配置,默认为 `true`:
|
||||
|
||||
```js
|
||||
const nf = new Intl.NumberFormat("fr", { useGrouping: true });
|
||||
nf.format(12345678901234567890n);
|
||||
// -> '12 345 678 901 234 567 890'
|
||||
```
|
||||
|
||||
目前已经被 Chrome、Firefox、Nodejs 支持。
|
||||
|
||||
## flat & flatmap
|
||||
|
||||
等价于 lodash [flatten](https://lodash.com/docs/4.17.11#flatten) 功能:
|
||||
|
||||
```js
|
||||
const array = [1, [2, [3]]];
|
||||
array.flat();
|
||||
// -> [1, 2, [3]]
|
||||
```
|
||||
|
||||
还支持自定义深度,如果支持 `Infinity` 无限层级:
|
||||
|
||||
```js
|
||||
const array = [1, [2, [3]]];
|
||||
array.flat(Infinity);
|
||||
// -> [1, 2, 3]
|
||||
```
|
||||
|
||||
这样我们就可以配合 `.map` 使用:
|
||||
|
||||
```js
|
||||
[2, 3, 4].map(duplicate).flat();
|
||||
```
|
||||
|
||||
因为这个用法太常见,js 内置了 `flatMap` 函数代替 `map`,与上面的效果是等价的:
|
||||
|
||||
```js
|
||||
[2, 3, 4].flatMap(duplicate);
|
||||
```
|
||||
|
||||
目前已经被 Chrome、Firefox、Safari、Nodejs 支持。
|
||||
|
||||
## fromEntries
|
||||
|
||||
`fromEntries` 是 `Object.fromEntries` 的语法,用来将对象转化为数组的描述:
|
||||
|
||||
```js
|
||||
const object = { x: 42, y: 50, abc: 9001 };
|
||||
const entries = Object.entries(object);
|
||||
// -> [['x', 42], ['y', 50]]
|
||||
```
|
||||
|
||||
这样就可以对对象的 key 与 value 进行加工处理,并通过 `fromEntries` API 重新转回对象:
|
||||
|
||||
```js
|
||||
const object = { x: 42, y: 50, abc: 9001 }
|
||||
const result = Object.fromEntries(
|
||||
Object.entries(object)
|
||||
.filter(([ key, value]) => key.length === 1)
|
||||
.map(([ key, value ]) => [ key, value * 2])
|
||||
)
|
||||
// -> { x: 84, y: 100 }
|
||||
```
|
||||
|
||||
不仅如此,还可以将 object 快速转化为 Map:
|
||||
|
||||
```js
|
||||
const map = new Map(Object.entries(object));
|
||||
```
|
||||
|
||||
目前已经被 Chrome、Firefox、Safari、Nodejs 支持。
|
||||
|
||||
## Map to Object conversion
|
||||
|
||||
`fromEntries` 建立了 object 与 map 之间的桥梁,我们还可以将 Map 快速转化为 object:
|
||||
|
||||
```js
|
||||
const objectCopy = Object.fromEntries(map);
|
||||
```
|
||||
|
||||
目前已经被 Chrome、Firefox、Safari、Nodejs 支持。
|
||||
|
||||
## globalThis
|
||||
|
||||
> 业务代码一般不需要访问全局的 window 变量,但是框架与库一般需要,比如 polyfill。
|
||||
|
||||
访问全局的 this 一般会做四个兼容,因为 js 在不同运行环境下,全局 this 的变量名都不一样:
|
||||
|
||||
```js
|
||||
const getGlobalThis = () => {
|
||||
if (typeof self !== "undefined") return self; // web worker 环境
|
||||
if (typeof window !== "undefined") return window; // web 环境
|
||||
if (typeof global !== "undefined") return global; // node 环境
|
||||
if (typeof this !== "undefined") return this; // 独立 js shells 脚本环境
|
||||
throw new Error("Unable to locate global object");
|
||||
};
|
||||
```
|
||||
|
||||
因此整治一下规范也合情合理:
|
||||
|
||||
```js
|
||||
globalThis; // 在任何环境,它就是全局的 this
|
||||
```
|
||||
|
||||
目前已经被 Chrome、Firefox、Safari、Nodejs 支持。
|
||||
|
||||
## Stable sort
|
||||
|
||||
就是稳定排序结果的功能,比如下面的数组:
|
||||
|
||||
```js
|
||||
const doggos = [
|
||||
{ name: "Abby", rating: 12 },
|
||||
{ name: "Bandit", rating: 13 },
|
||||
{ name: "Choco", rating: 14 },
|
||||
{ name: "Daisy", rating: 12 },
|
||||
{ name: "Elmo", rating: 12 },
|
||||
{ name: "Falco", rating: 13 },
|
||||
{ name: "Ghost", rating: 14 }
|
||||
];
|
||||
|
||||
doggos.sort((a, b) => b.rating - a.rating);
|
||||
```
|
||||
|
||||
最终排序结果可能如下:
|
||||
|
||||
```js
|
||||
[
|
||||
{ name: "Choco", rating: 14 },
|
||||
{ name: "Ghost", rating: 14 },
|
||||
{ name: "Bandit", rating: 13 },
|
||||
{ name: "Falco", rating: 13 },
|
||||
{ name: "Abby", rating: 12 },
|
||||
{ name: "Daisy", rating: 12 },
|
||||
{ name: "Elmo", rating: 12 }
|
||||
];
|
||||
```
|
||||
|
||||
也可能如下:
|
||||
|
||||
```js
|
||||
[
|
||||
{ name: "Ghost", rating: 14 },
|
||||
{ name: "Choco", rating: 14 },
|
||||
{ name: "Bandit", rating: 13 },
|
||||
{ name: "Falco", rating: 13 },
|
||||
{ name: "Abby", rating: 12 },
|
||||
{ name: "Daisy", rating: 12 },
|
||||
{ name: "Elmo", rating: 12 }
|
||||
];
|
||||
```
|
||||
|
||||
注意 `choco` 与 `Ghost` 的位置可能会颠倒,这是因为 JS 引擎可能只关注 `sort` 函数的排序,而在顺序相同时,不会保持原有的排序规则。现在通过 **Stable sort** 规范,可以确保这个排序结果是稳定的。
|
||||
|
||||
目前已经被 Chrome、Firefox、Safari、Nodejs 支持。
|
||||
|
||||
## Intl.RelativeTimeFormat
|
||||
|
||||
`Intl.RelativeTimeFormat` 可以对时间进行语义化翻译:
|
||||
|
||||
```js
|
||||
const rtf = new Intl.RelativeTimeFormat("en", { numeric: "auto" });
|
||||
|
||||
rtf.format(-1, "day");
|
||||
// -> 'yesterday'
|
||||
rtf.format(0, "day");
|
||||
// -> 'today'
|
||||
rtf.format(1, "day");
|
||||
// -> 'tomorrow'
|
||||
rtf.format(-1, "week");
|
||||
// -> 'last week'
|
||||
rtf.format(0, "week");
|
||||
// -> 'this week'
|
||||
rtf.format(1, "week");
|
||||
// -> 'next week'
|
||||
```
|
||||
|
||||
不同语言体系下,`format` 会返回不同的结果,通过控制 `RelativeTimeFormat` 的第一个参数 `en` 决定,比如可以切换为 `ta-in`。
|
||||
|
||||
## Intl.ListFormat
|
||||
|
||||
`ListFormat` 以列表的形式格式化数组:
|
||||
|
||||
```js
|
||||
const lfEnglish = new Intl.ListFormat("en");
|
||||
lfEnglish.format(["Ada", "Grace"]);
|
||||
// -> 'Ada and Grace'
|
||||
```
|
||||
|
||||
可以通过第二个参数指定连接类型:
|
||||
|
||||
```js
|
||||
const lfEnglish = new Intl.ListFormat("en", { type: "disjunction" });
|
||||
lfEnglish.format(["Ada", "Grace"]);
|
||||
// -> 'Ada or Grace'
|
||||
```
|
||||
|
||||
目前已经被 Chrome、Nodejs 支持。
|
||||
|
||||
## Intl.DateTimeFormat -> formatRange
|
||||
|
||||
`DateTimeFormat` 可以定制日期格式化输出:
|
||||
|
||||
```js
|
||||
const start = new Date(startTimestamp);
|
||||
// -> 'May 7, 2019'
|
||||
const end = new Date(endTimestamp);
|
||||
// -> 'May 9, 2019'
|
||||
const fmt = new Intl.DateTimeFormat("en", {
|
||||
year: "numeric",
|
||||
month: "long",
|
||||
day: "numeric"
|
||||
});
|
||||
const output = `${fmt.format(start)} - ${fmt.format(end)}`;
|
||||
// -> 'May 7, 2019 - May 9, 2019'
|
||||
```
|
||||
|
||||
最后一句,也可以通过 `formatRange` 函数代替:
|
||||
|
||||
```js
|
||||
const output = fmt.formatRange(start, end);
|
||||
// -> 'May 7 - 9, 2019'
|
||||
```
|
||||
|
||||
目前已经被 Chrome 支持。
|
||||
|
||||
## Intl.Locale
|
||||
|
||||
定义国际化本地化的相关信息:
|
||||
|
||||
```js
|
||||
const locale = new Intl.Locale("es-419-u-hc-h12", {
|
||||
calendar: "gregory"
|
||||
});
|
||||
locale.language;
|
||||
// -> 'es'
|
||||
locale.calendar;
|
||||
// -> 'gregory'
|
||||
locale.hourCycle;
|
||||
// -> 'h12'
|
||||
locale.region;
|
||||
// -> '419'
|
||||
locale.toString();
|
||||
// -> 'es-419-u-ca-gregory-hc-h12'
|
||||
```
|
||||
|
||||
目前已经被 Chrome、Nodejs 支持。
|
||||
|
||||
## Top-Level await
|
||||
|
||||
支持在根节点生效 `await`,比如:
|
||||
|
||||
```js
|
||||
const result = await doSomethingAsync();
|
||||
doSomethingElse();
|
||||
```
|
||||
|
||||
目前还没有支持。
|
||||
|
||||
## Promise.allSettled/Promise.any
|
||||
|
||||
`Promise.allSettled` 类似 `Promise.all`、`Promise.any` 类似 `Promise.race`,区别是,在 Promise reject 时,`allSettled` 不会 reject,而是也当作 fulfilled 的信号。
|
||||
|
||||
举例来说:
|
||||
|
||||
```js
|
||||
const promises = [
|
||||
fetch("/api-call-1"),
|
||||
fetch("/api-call-2"),
|
||||
fetch("/api-call-3")
|
||||
];
|
||||
|
||||
await Promise.allSettled(promises);
|
||||
```
|
||||
|
||||
即便某个 `fetch` 失败了,也不会导致 `reject` 的发生,这样在不在乎是否有项目失败,只要拿到都结束的信号的场景很有用。
|
||||
|
||||
对于 `Promise.any` 则稍有不同:
|
||||
|
||||
```js
|
||||
const promises = [
|
||||
fetch("/api-call-1"),
|
||||
fetch("/api-call-2"),
|
||||
fetch("/api-call-3")
|
||||
];
|
||||
|
||||
try {
|
||||
const first = await Promise.any(promises);
|
||||
// Any of ths promises was fulfilled.
|
||||
console.log(first);
|
||||
} catch (error) {
|
||||
// All of the promises were rejected.
|
||||
}
|
||||
```
|
||||
|
||||
只要有子项 fulfilled,就会完成 `Promise.any`,哪怕第一个 Promise reject 了,而第二个 Promise fulfilled 了,`Promise.any` 也会 fulfilled,而对于 `Promise.race`,这种场景会直接 rejected。
|
||||
|
||||
如果所有子项都 rejected,那 `Promise.any` 也只好 rejected 啦。
|
||||
|
||||
目前已经被 Chrome、Firefox 支持。
|
||||
|
||||
## WeakRef
|
||||
|
||||
WeakRef 是从 OC 抄过来的弱引用概念。
|
||||
|
||||
为了解决这个问题:当对象被引用后,由于引用的存在,导致对象无法被 GC。
|
||||
|
||||
所以如果建立了弱引用,那么对象就不会因为存在的这段引用关系而影响 GC 了!
|
||||
|
||||
具体用法是:
|
||||
|
||||
```js
|
||||
const obj = {};
|
||||
const weakObj = new WeakRef(obj);
|
||||
```
|
||||
|
||||
使用 `weakObj` 与 `obj` 没有任何区别,唯一不同时,`obj` 可能随时被 GC,而一旦被 GC,弱引用拿到的对象可能就变成 `undefined`,所以要做好错误保护。
|
||||
|
||||
# 3. 总结
|
||||
|
||||
JS 这几个特性提升了 JS 语言的成熟性、完整性,而且看到其访问控制能力、规范性、国际化等能力有着重加强,解决的都是 JS 最普遍遇到的痛点问题。
|
||||
|
||||
那么,这些 JS 特性中,你最喜欢哪一条呢?想吐槽哪一条呢?欢迎留言。
|
||||
|
||||
> 讨论地址是:[精读《What's new in javascript》 · Issue #159 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/159)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
**special Sponsors**
|
||||
|
||||
- [DevOps 全流程平台](https://e.coding.net/?utm_source=weekly)
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,383 @@
|
||||
# 1. 引言
|
||||
|
||||
备受开发者喜爱的特性 [Optional chaining](https://github.com/tc39/proposal-optional-chaining) 在 2019.6.5 进入了 stage2,让我们详细读一下草案,了解一下这个特性的用法以及讨论要点。
|
||||
|
||||
借着这次精读草案,让我们了解一下一个完整草案的标准文档结构是怎样的。
|
||||
|
||||
一个新特性的文档,首先要描述 **起因** 是什么,也就是为什么要增加这个特性,大家不会没有理由的就增加一个特性。其次是**其他语言是否有现成的实现版本**,参考他们并进行归纳总结,可以增加思考角度的全面性。
|
||||
|
||||
第三点就是 **语法介绍**,也就进入了新特性的正题,这里要详细介绍所有可能的使用情况。第四点是 **语义**,也就是诠释语法的含义。
|
||||
|
||||
然后是可选的 **是否有不支持的情况**,对于不支持的点是否有意而为之,为什么?此处一般会留下讨论的 ISSUE。然后是 **暂不考虑的点**,是由于性价比低、使用场景少,或者实现成本高的原因,为什么某些已经想到的点暂不考虑,这里也会留下讨论的 ISSUE。
|
||||
|
||||
后面一般还有 “正在讨论的点”、“FAQ”、“草案进度”、“参考文献”、“相关问题”、“预先讨论资料” 等内容。
|
||||
|
||||
# 2. 概述&精读
|
||||
|
||||
首先让我们回顾一下什么是 **“Optional chaining”**。
|
||||
|
||||
## 起因介绍
|
||||
|
||||
当访问一个深层树形结构的对象时,我们总需要判断中间节点属性是否存在:
|
||||
|
||||
```js
|
||||
var street = user.address && user.address.street;
|
||||
```
|
||||
|
||||
而且很多 API 返回的属性都可能为 Null,而我们往往只想获取非 Null 时的结果:
|
||||
|
||||
```js
|
||||
var fooInput = myForm.querySelector('input[name=foo]')
|
||||
var fooValue = fooInput ? fooInput.value : undefined
|
||||
```
|
||||
|
||||
> 笔者这里补充,在人机交互的领域,可能为 Null 的情况很多。首先是交互行为模块很多,行为复杂,很容易导致数据分散且难以预测(可能为空),仅是 DOM 元素就需要太多兼容,因为 DOM 被修改的实际太多了,大家都在共享一个可变的结构;其次是交互过程中间状态很多,出现状态残缺的可能性也很大,就拿 SQL 解析为例:后端只要检测 Query 是否正确就可以了,但前端的 SQL 编辑器需要在输入不完整的情况下给出提示,也就是在语法树错误的情况下给出提示,因此需要进行容错。
|
||||
|
||||
而 Optional chaining 可以解决为了容错而写过多重复代码的问题:
|
||||
|
||||
```js
|
||||
var street = user.address?.street
|
||||
var fooValue = myForm.querySelector('input[name=foo]')?.value
|
||||
```
|
||||
|
||||
正如上面的例子:如果 `user.address` 为 `undefined`,那 `street` 拿到的就是 `undefined`,而不是报错。
|
||||
|
||||
配合另一个在 stage2 的新特性 [Nullish Coalescing](https://github.com/tc39/proposal-nullish-coalescing) 做默认值处理非常方便:
|
||||
|
||||
```js
|
||||
// falls back to a default value when response.setting is missing or nullish
|
||||
// (response.settings == null) or when respsonse.setting.animationDuration is missing
|
||||
// or nullish (response.settings.animationDuration == null)
|
||||
const animationDuration = response.settings?.animationDuration ?? 300;
|
||||
```
|
||||
|
||||
`??` 号可以理解为 “默认值场景下的 `||`”:
|
||||
|
||||
```js
|
||||
const response = {
|
||||
settings: {
|
||||
nullValue: null,
|
||||
height: 400,
|
||||
animationDuration: 0,
|
||||
headerText: '',
|
||||
showSplashScreen: false
|
||||
}
|
||||
};
|
||||
|
||||
const undefinedValue = response.settings?.undefinedValue ?? 'some other default'; // result: 'some other default'
|
||||
const nullValue = response.settings?.nullValue ?? 'some other default'; // result: 'some other default'
|
||||
const headerText = response.settings?.headerText ?? 'Hello, world!'; // result: ''
|
||||
const animationDuration = response.settings?.animationDuration ?? 300; // result: 0
|
||||
const showSplashScreen = response.settings?.showSplashScreen ?? true; // result: false
|
||||
```
|
||||
|
||||
`0 || 1` 的结果是 `1`,因为 `0` 判定为 `false`,而 `||` 在前面的变量为 `false` 型才继续执行,而我们想要的是 “前面的对象不存在时才使用后面的值”。`??` 则代表了 “前面的对象不存在” 这个含义,即便值为 `0` 也会认为这个值是存在的。
|
||||
|
||||
Optional chaining 也可以用在方法上:
|
||||
|
||||
```js
|
||||
iterator.return?.()
|
||||
```
|
||||
|
||||
或者试图调用某些未被实现的方法:
|
||||
|
||||
```js
|
||||
if (myForm.checkValidity?.() === false) { // skip the test in older web browsers
|
||||
// form validation fails
|
||||
return;
|
||||
}
|
||||
```
|
||||
|
||||
比如某个旧版本浏览器不支持 `myForm.checkValidity` 方法,则不会报错,而是返回 `false`。
|
||||
|
||||
## 已有实现调研
|
||||
|
||||
Optional chaining 在 C#、Swift、CoffeeScript、Kotlin、Dart、Ruby、Groovy 已经实现了,且实现方式均有差异,可以看到每个语言在实现语法时都是有取舍的,但是大方向基本是相同的。
|
||||
|
||||
想了解其他语言是如何实现 Optional chaining 的读者可以 [点击阅读原文](https://github.com/tc39/proposal-optional-chaining#prior-art)。
|
||||
|
||||
这些语言实现 Optional chaining 的差异基本在 **语法、支持范围、边界情况处理** 等不同,所以如果你每天要在不同语言之间切换工作,看似相同的语法,但不同的细节可能把你绕晕(所以会的语言多,只会让你变成一个速记字典,满脑子都是哪些语言在哪些语法讨论倾向哪一边,选择了哪些特性这些毫无意义的结论,如果不想记这些,基础语法都没有掌握怎么好意思说会这门语言呢?所以学 JS 就够了)。
|
||||
|
||||
## 语法
|
||||
|
||||
Optional Chaining 的语法有三种使用场景:
|
||||
|
||||
```js
|
||||
obj?.prop // optional static property access
|
||||
obj?.[expr] // optional dynamic property access
|
||||
func?.(...args) // optional function or method call
|
||||
```
|
||||
|
||||
也就是将 `.` 替换为 `?.`,但要注意第二行与第三行稍稍有点反直觉,比如在函数调用时,需要将 `func(...args)` 写为 `func?.(...args)`。至于为什么语法不是 `func?(...args)` 这种简洁一点的表达方式,在 FAQ 中有提到这个例子:
|
||||
|
||||
`obj?[expr].filter(fun):0` 引擎难以判断 `obj?[expr]` 是 Optional Chaning,亦或这是一个普通的三元运算语句。
|
||||
|
||||
可见,要支持 `?.` 这个看似简单的语法,在整个 JS 语法体系中要考虑的边界情况很多。
|
||||
|
||||
即便是 `?.` 这样完整的用法,也需要注意 `foo?.3:0` 这种情况,不能将 `foo?.` 解析为 Optional chanining,而要将其解析为 `foo? .3 : 0`,这需要解析引擎支持 lookahead 特性。
|
||||
|
||||
## 语义
|
||||
|
||||
**当 `?.` 前面的变量值为 `null` 或 `undefined` 时,`?.` 返回的结果为 `undefined`**。
|
||||
|
||||
```js
|
||||
a?.b // undefined if `a` is null/undefined, `a.b` otherwise.
|
||||
a == null ? undefined : a.b
|
||||
|
||||
a?.[x] // undefined if `a` is null/undefined, `a[x]` otherwise.
|
||||
a == null ? undefined : a[x]
|
||||
|
||||
a?.b() // undefined if `a` is null/undefined
|
||||
a == null ? undefined : a.b() // throws a TypeError if `a.b` is not a function
|
||||
// otherwise, evaluates to `a.b()`
|
||||
|
||||
a?.() // undefined if `a` is null/undefined
|
||||
a == null ? undefined : a() // throws a TypeError if `a` is neither null/undefined, nor a function
|
||||
// invokes the function `a` otherwise
|
||||
```
|
||||
|
||||
### 短路
|
||||
|
||||
所谓短路,就是指引入了 Optional chaining 后,某些看似一定会执行的语句在特定情况下会短路(终止执行),比如:
|
||||
|
||||
```js
|
||||
a?.[++x] // `x` is incremented if and only if `a` is not null/undefined
|
||||
a == null ? undefined : a[++x]
|
||||
```
|
||||
|
||||
第一个例子,如果 `a` 时 `null/undefined`,就不会执行 `++x`。
|
||||
|
||||
原因是这段代码部分等价于 `a == null ? undefined : a[++x]`,如果 `a == null` 为真,自然不会执行 `a[++x]` 这个语句。但由于 Optional chaining 使这个语句变得 “简洁了”,虽然带来了便利,但也可能导致看不清完整的执行逻辑,引发误判。
|
||||
|
||||
所以看到 `?.` 语句时,一定要反射性的思考一下,这个语句会触发 “短路”。
|
||||
|
||||
### 长“短路”
|
||||
|
||||
Optional chaining 在 JS 的规范中,作用域仅限于调用处。看下面的例子:
|
||||
|
||||
```js
|
||||
a?.b.c(++x).d // if `a` is null/undefined, evaluates to undefined. Variable `x` is not incremented.
|
||||
// otherwise, evaluates to `a.b.c(++x).d`.
|
||||
a == null ? undefined : a.b.c(++x).d
|
||||
```
|
||||
|
||||
可以看到 `?.` 仅在 `a?.` 这一层生效,而不是对后续的 `b.c`、`c(++x).d` 继续生效。而对于 C+ 与 CoffeeScript,这个语法是对后续所有 `get` 生效的(**这里再次提醒,不要用 `CoffeeScript` 了,因为对于相同语法,语义都发生了变化,对你与你的同事都是巨大的理解负担,或者说没有人愿意注意,为什么代码在 `CoffeeScript` 里不报错,而转移到 JS 就报错了,是因为 Optional chaining 语义不一致造成的。**)。
|
||||
|
||||
正因为 Optional chaining 在 JS 语法中仅对当前位置起保护作用,因此一个调用语句中允许出现多个 `?.` 调用:
|
||||
|
||||
```js
|
||||
a?.b[3].c?.(x).d
|
||||
a == null ? undefined : a.b[3].c == null ? undefined : a.b[3].c(x).d
|
||||
// (as always, except that `a` and `a.b[3].c` are evaluated only once)
|
||||
```
|
||||
|
||||
上面这段代码,对 `a?.b`、`c?.(x)` 的访问与调用是安全的,而对于 `b[3]`、 `b[3].c`、`c?.(x).d` 的调用是不安全的。
|
||||
|
||||
在 FAQ 环节也提到了,为什么不学习 C# 与 CoffeeScript 的语义,将安全保护从 `a?.` 之后就一路 “贯穿” 下去?
|
||||
|
||||
原因是 JS 对 Optional chaining 的理解不同导致的。Optional chaining 仅仅是安全访问保护,不代表 `try catch`,也就是它不会捕获异常,举一个例子:
|
||||
|
||||
```js
|
||||
a?.b()
|
||||
```
|
||||
|
||||
这个调用,在 `a.b` 不是一个函数时依然会报错,原因就是 Optional chaining 仅提供了对属性访问的安全保护,不代表对整个执行过程进行安全保护,该抛出异常还是会抛出异常,因此 Optional chaining 没有必要对后面的属性访问安全性负责。
|
||||
|
||||
笔者认为 TC39 对这个属性的理解是合理的,否则用 `try catch` 就能代替 Optional chaining 了。**让一个特性仅实现分内的功能,是每个前端从业者都要具备的思维能力。**
|
||||
|
||||
> PS:笔者再多提一句,在任何技术设计领域,这个概念都适用。想想你设计的功能,写过的函数,如果为了图方便,扩大了其功能,终究会带来整体设计的混乱,适得其反。
|
||||
|
||||
### 边界情况 - 分组
|
||||
|
||||
我们知道,JS 代码可以通过括号的方式进行分组,分组内的代码拥有更高的执行优先级。那么在 Optional chaining 场景下考虑这个情况:
|
||||
|
||||
```js
|
||||
(a?.b).c
|
||||
(a == null ? undefined : a.b).c
|
||||
```
|
||||
|
||||
与不带括号的进行对比:
|
||||
|
||||
```js
|
||||
a?.b.c
|
||||
a == null ? undefined : a.b.c
|
||||
```
|
||||
|
||||
我们会发现,由于括号提高了优先级,导致在 `a` 为 `null/undefined` 时,解析出了 `undefined.c` 这个必定报错的荒谬语法。因此我们不要试图为 Optional chaining 进行括号分组,这样会打破逻辑顺序,使安全保护不但不生效,反而导致报错。
|
||||
|
||||
### Optional delete
|
||||
|
||||
中文大概可以翻译为 “安全删除” 吧,也就是 JS 的 Optional chaining 支持下面的使用方式:
|
||||
|
||||
```js
|
||||
delete a?.b
|
||||
a == null ? true : delete a.b
|
||||
```
|
||||
|
||||
这样不论 `b` 是否存在,得到的都是 `b` 删除成功的信号(返回值 `true`)。
|
||||
|
||||
至于为什么要支持 Optional delete,草案里也有提到,笔者认为非常有意思:
|
||||
|
||||
讨论重点应该是 “我们为什么不支持 Optional delete”,而不是 “我们为什么要支持 Optional delete”,有点像反证法的思路。由于 Optional delete 具备一定的使用场景,而且支持方式零成本(改写为 `a == null ? true : delete a.b` 即可),所以就支持它吧!
|
||||
|
||||
## 不支持的特性
|
||||
|
||||
下面三个特性不支持,原因是没什么使用场景:
|
||||
|
||||
- 安全的 construction:`new a?.()`
|
||||
- 安全的 template literal:a?.\`string\`
|
||||
- 上面两者的结合:`new a?.b()`, a?.b\`string\`
|
||||
|
||||
首先看 new 一个对象,如果 new 出来的结果是 `undefined`,那这个返回值使用起来也没有意义。
|
||||
|
||||
对于第二个安全的 template literal 来说,比如下面的语法:
|
||||
|
||||
```js
|
||||
a?.b
|
||||
`c`
|
||||
```
|
||||
|
||||
会被解析为
|
||||
|
||||
```js
|
||||
a == null ? undefined : a.b`c`
|
||||
```
|
||||
|
||||
那么对于下面这种翻译结果:
|
||||
|
||||
```js
|
||||
a == null ? undefined : a.b `c`
|
||||
```
|
||||
|
||||
目前不会有人这么写代码,因为这种语法的使用场景一般都是 “前面的属性必定存在时的简化语法”,比如 `styled-components` 的:
|
||||
|
||||
```js
|
||||
div`
|
||||
width: 300px;
|
||||
`
|
||||
```
|
||||
|
||||
而如果解析为:
|
||||
|
||||
```js
|
||||
(a == null ? undefined : a?.b) `c`
|
||||
```
|
||||
|
||||
则更不会有人愿意尝试这种写法,所以安全的 template literal 这种需求是不存在的,自然第三种需求也是不存在的。
|
||||
|
||||
下面一个不支持的特性,虽然有一定使用场景,但依然被否定的:
|
||||
|
||||
- 安全的赋值:`a?.b = c`
|
||||
|
||||
[讨论 ISSUE](https://github.com/tc39/proposal-optional-chaining/issues/18)
|
||||
|
||||
笔者总结一下,一共有这几种令人烦恼的地方,导致大家不想支持 **安全赋值** 特性:
|
||||
|
||||
**短路特性导致的理解成本:**
|
||||
|
||||
比如 `a?.b = c()`,如果 `a` 为 `null/undefined`,那么函数 `c()` 就不会被执行,这种语法太违背开发者的常识,如果支持这个特性带来的理解负担会很大。
|
||||
|
||||
**连带考虑场景很多:**
|
||||
|
||||
如果支持了这种看似简单的赋值场景,那么至少还有下面五种赋值场景需要考虑到:
|
||||
|
||||
- 简单赋值: `a?.b = c`
|
||||
- 聚合赋值: `a?.b += c, a?.b >>= c`
|
||||
- 自增,自减: `a?.b++, --a?.b`
|
||||
- 解构赋值: `{ x: a?.b } = c, [ a?.b ] = c`
|
||||
- for 循环中的临时赋值: `for (a?.b in c), for (a?.b of c)`
|
||||
|
||||
总和这几种考虑,支持安全赋值会带来更多灵活的用法,导致代码复杂度陡增(想想你的同事大量使用上面的后四种例子,你绝对想要找他决斗,因为这种写法和乱用 window 变量一样,在 JS 允许的框架内写出难以维护的逻辑,像是钻了法律的孔子),因此 TC39 决定不支持这种用法,从源头上杜绝被滥用。
|
||||
|
||||
以上不支持的功能点会在静态编译时被禁止,但以后也许会重新讨论。
|
||||
|
||||
另外对于 Class 的私有变量是否支持 `a?.#b` `a?.#b()` 还在讨论中,这取决于私有成员变量草案是否能最终落地。
|
||||
|
||||
## 暂不讨论的点
|
||||
|
||||
目前有两个 Optional chaining 功能点暂不讨论,分别是 [Optional spread](https://github.com/tc39/proposal-optional-chaining/issues/55) 与 [Optional destructuring](https://github.com/tc39/proposal-optional-chaining/issues/74)
|
||||
|
||||
对于 Optional spread,建议是:
|
||||
|
||||
```js
|
||||
const arr = [...?listOne, ...?listTwo];
|
||||
foo(...?args);
|
||||
```
|
||||
|
||||
但由于可以结合 [Nullish Coalescing](https://github.com/tc39/proposal-nullish-coalescing) 达到同样的效果:
|
||||
|
||||
```js
|
||||
foo(...args ?? [])
|
||||
```
|
||||
|
||||
所以暂时不深入讨论,因为存在意义不大。
|
||||
|
||||
对于 Optional destructuring,建议是:
|
||||
|
||||
|
||||
```js
|
||||
// const baz = obj?.foo?.bar?.baz;
|
||||
const { baz } = obj?.foo?.bar?;
|
||||
```
|
||||
|
||||
也就是对于解构用法,在最后一个位置添加 `?`,使其能安全的解构。
|
||||
|
||||
但由于基于这个特性会演变出太多的使用变体:
|
||||
|
||||
```js
|
||||
const {foo ?: {bar ?: {baz}}} = obj?
|
||||
```
|
||||
|
||||
或者
|
||||
|
||||
```js
|
||||
const {
|
||||
foo?: {
|
||||
bar?: { baz }
|
||||
}
|
||||
} = obj;
|
||||
```
|
||||
|
||||
对开发者的理解成本压力较大,毕竟 Optional chaining 的出发点只是 `?.` 这么简单。而且对于默认值,我们又有 `??` 语法可以快速满足,因此这个特性的讨论也被搁置了。
|
||||
|
||||
## 余下的 Q&A
|
||||
|
||||
大部分 Q&A 在上面的解读都有提及,下面列出剩余的两个 Q&A:
|
||||
|
||||
### 为什么语法是 `?.` 而不是 `.?` ?
|
||||
|
||||
原因是与三元运算符冲突了,思考下面的用法:
|
||||
|
||||
```js
|
||||
1.?foo : bar
|
||||
```
|
||||
|
||||
在 js 中,`1.` 等价于 `1`,那么这就是一个标准的三元运算表达式,因此 `.?` 语法会产生歧义,只能选择 `?.`。
|
||||
|
||||
### 为什么 `null?.b` 的结果不是 `null` 呢?
|
||||
|
||||
由于 `.` 表达式不关心 `.` 前面对象的类型,因为它的目的是访问 `.` 后面的属性,因此不会因为 `null?.b` 就返回 `null`,而是统一返回 `undefined`。
|
||||
|
||||
最后,需要 TC39 最终审核后,Optional chaining 才能进入 Stage3,我们拭目以待吧!
|
||||
|
||||
# 3. 总结
|
||||
|
||||
写一篇 JS 特性草案的完整解读真的很累,以后也许很少有机会这么完整的解读草案了,但希望借着这次解读 Optional chaining 的机会,让大家理解 TC39 是如何制定草案的,草案都在讨论什么,怎么讨论的,流程有哪些。
|
||||
|
||||
同时,还希望让大家意识到,为一个语言添加一个看似简单的新特性有多么的不容易,一个简单的 `?.` 语法就牵涉到与三元运算符、分组、解构等等已存在语法的交织与冲突,所以想要安全又妥当的添加一个新特性,参与讨论的人必须对 JS 语言有完整全面的理解,同时也要对边界情况考虑的很周全,懂得对语法融会贯通。
|
||||
|
||||
最后,希望大家可以意识到,JS 这么重量级的语言,一个新的语法特性其实也是这么三言两语讨论下来的,其中不乏有一些拍脑袋的地方、对于“即可也可”的情况,稍稍结合一些具体案例就定下来其中一种的现象也是存在的,甚至对于某些规范点根本不存在一个完美的 “真理”,比如为什么语法是 `?.` 而不是 `a&.b`(Ruby 使用的就是 `&.`),认清了这种情况存在,就不会执着于 “语法的学习”,而转向更底层,更有用的 “语义的学习”,并能通过阅读 TC39 的草案了解其他语言的实现差异,从而快速掌握其他语言的语法。
|
||||
|
||||
> 讨论地址是:[精读《Optional chaining》 · Issue #165 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/165)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
**special Sponsors**
|
||||
|
||||
- [DevOps 全流程平台](https://e.coding.net/?utm_source=weekly)
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,340 @@
|
||||
# 1. 引言
|
||||
|
||||
Vue 3.0 的发布引起了轩然大波,让我们解读下它的 [function api RFC](https://github.com/vuejs/rfcs/blob/function-apis/active-rfcs/0000-function-api.md#comparison-with-react-hooks) 详细了解一下 Vue 团队是怎么想的吧!
|
||||
|
||||
首先官方回答了几个最受关注的问题:
|
||||
|
||||
**Vue 3.0 是否有 break change,就像 Python 3 / Angular 2 一样?**
|
||||
|
||||
不,100% 兼容 Vue 2.0,且暂未打算废弃任何 API(未来也不)。之前有草案试图这么做,但由于用户反馈太猛,被撤回了。
|
||||
|
||||
**Vue 3.0 的设计盖棺定论了吗?**
|
||||
|
||||
没有呀,这次精读的稿子就是 RFC(Request For Comments),翻译成中文就是 “意见征求稿”,还在征求大家意见中哦。
|
||||
|
||||
**这 RFC 咋这么复杂?**
|
||||
|
||||
RFC 是写给贡献者/维护者的,要考虑许多边界情况与细节,所以当然会复杂很多喽!当然 Vue 本身使用起来还是很简单的。
|
||||
|
||||
> Vue 本身 Mutable + Template 就注定了是个用起来简单(约定 + 自然),实现起来复杂(解析 + 双绑)的框架。
|
||||
|
||||
**这次改动很像在模仿 React,为啥不直接用 React?**
|
||||
|
||||
首先 Template 机制还是没变,其次模仿的是 Hooks 而不是 React 全部,如果你不喜欢这个改动,那你更不会喜欢用 React。
|
||||
|
||||
PS: 问这个问题的人,一定没有同时理解 React 与 Vue,其实这两个框架到现在差别蛮大的,后面精读会详细说明。
|
||||
|
||||
下面正式进入 Vue 3.0 Function API 的介绍。
|
||||
|
||||
# 2. 概述
|
||||
|
||||
Vue 函数式基本 Demo:
|
||||
|
||||
```vue
|
||||
<template>
|
||||
<div>
|
||||
<span>count is {{ count }}</span>
|
||||
<span>plusOne is {{ plusOne }}</span>
|
||||
<button @click="increment">count++</button>
|
||||
</div>
|
||||
</template>
|
||||
|
||||
<script>
|
||||
import { value, computed, watch, onMounted } from 'vue'
|
||||
|
||||
export default {
|
||||
setup() {
|
||||
// reactive state
|
||||
const count = value(0)
|
||||
// computed state
|
||||
const plusOne = computed(() => count.value + 1)
|
||||
// method
|
||||
const increment = () => { count.value++ }
|
||||
// watch
|
||||
watch(() => count.value * 2, val => {
|
||||
console.log(`count * 2 is ${val}`)
|
||||
})
|
||||
// lifecycle
|
||||
onMounted(() => {
|
||||
console.log(`mounted`)
|
||||
})
|
||||
// expose bindings on render context
|
||||
return {
|
||||
count,
|
||||
plusOne,
|
||||
increment
|
||||
}
|
||||
}
|
||||
}
|
||||
</script>
|
||||
```
|
||||
|
||||
函数式风格的入口是 `setup` 函数,采用了函数式风格后可以享受如下好处:类型自动推导、减少打包体积。
|
||||
|
||||
`setup` 函数返回值就是注入到页面模版的变量。我们也可以返回一个函数,通过使用 `value` 这个 API 产生属性并修改:
|
||||
|
||||
```jsx
|
||||
import { value } from 'vue'
|
||||
|
||||
const MyComponent = {
|
||||
setup(props) {
|
||||
const msg = value('hello')
|
||||
const appendName = () => {
|
||||
msg.value = `hello ${props.name}`
|
||||
}
|
||||
return {
|
||||
msg,
|
||||
appendName
|
||||
}
|
||||
},
|
||||
template: `<div @click="appendName">{{ msg }}</div>`
|
||||
}
|
||||
```
|
||||
|
||||
要注意的是,`value()` 返回的是一个对象,通过 `.value` 才能访问到其真实值。
|
||||
|
||||
为何 `value()` 返回的是 Wrappers 而非具体值呢?原因是 Vue 采用双向绑定,只有对象形式访问值才能保证访问到的是最终值,这一点类似 React 的 `useRef()` API 的 `.current` 规则。
|
||||
|
||||
那既然所有 `value()` 返回的值都是 Wrapper,那直接给模版使用时要不要调用 `.value` 呢?**答案是否定的,直接使用即可,模版会自动 `Unwrapping`:**
|
||||
|
||||
```jsx
|
||||
const MyComponent = {
|
||||
setup() {
|
||||
return {
|
||||
count: value(0)
|
||||
}
|
||||
},
|
||||
template: `<button @click="count++">{{ count }}</button>`
|
||||
}
|
||||
```
|
||||
|
||||
接下来是 **Hooks**,下面是一个使用 Hooks 实现获得鼠标实时位置的例子:
|
||||
|
||||
```jsx
|
||||
function useMouse() {
|
||||
const x = value(0)
|
||||
const y = value(0)
|
||||
const update = e => {
|
||||
x.value = e.pageX
|
||||
y.value = e.pageY
|
||||
}
|
||||
onMounted(() => {
|
||||
window.addEventListener('mousemove', update)
|
||||
})
|
||||
onUnmounted(() => {
|
||||
window.removeEventListener('mousemove', update)
|
||||
})
|
||||
return { x, y }
|
||||
}
|
||||
|
||||
// in consuming component
|
||||
const Component = {
|
||||
setup() {
|
||||
const { x, y } = useMouse()
|
||||
const { z } = useOtherLogic()
|
||||
return { x, y, z }
|
||||
},
|
||||
template: `<div>{{ x }} {{ y }} {{ z }}</div>`
|
||||
}
|
||||
```
|
||||
|
||||
可以看到,`useMouse` 将所有与 “处理鼠标位置” 相关的逻辑都封装了进去,乍一看与 React Hooks 很像,但是有两个区别:
|
||||
|
||||
1. `useMouse` 函数内改变 `x`、`y` 后,不会重新触发 `setup` 执行。
|
||||
2. `x` `y` 拿到的都是 Wrapper 而不是原始值,且这个值会动态变化。
|
||||
|
||||
另一个重要 API 就是 **`watch`**,它的作用类似 React Hooks 的 **useEffect**,但实现原理和调用时机其实完全不一样。
|
||||
|
||||
`watch` 的目的是监听某些变量变化后执行逻辑,比如当 `id` 变化后重新取数:
|
||||
|
||||
```jsx
|
||||
const MyComponent = {
|
||||
props: {
|
||||
id: Number
|
||||
},
|
||||
setup(props) {
|
||||
const data = value(null)
|
||||
watch(() => props.id, async (id) => {
|
||||
data.value = await fetchData(id)
|
||||
})
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
之所以要 `watch`,因为在 Vue 中,`setup` 函数仅执行一次,所以不像 React Function Component,每次组件 `props` 变化都会重新执行,因此无论是在变量、`props` 变化时如果想做一些事情,都需要包裹在 `watch` 中。
|
||||
|
||||
后面还有 `unwatching`、生命周期函数、依赖注入,都是一些语法定义,感兴趣可以继续[阅读原文](https://github.com/vuejs/rfcs/blob/function-apis/active-rfcs/0000-function-api.md#dependency-injection),笔者就不赘述了。
|
||||
|
||||
# 3. 精读
|
||||
|
||||
对于 Vue 3.0 的 Function API + Hooks 与 React Function Component + Hooks,笔者做一些对比。
|
||||
|
||||
## Vue 与 React 逻辑结构
|
||||
|
||||
React Function Component 与 Hooks,虽然在实现原理上,与 Vue3.0 存在 Immutable 与 Mutable、JSX 与 Template 的区别,但逻辑理解上有着相通之处。
|
||||
|
||||
```ts
|
||||
const MyComponent = {
|
||||
setup(props) {
|
||||
const x = value(0)
|
||||
|
||||
const setXRandom = () => {
|
||||
x.value = Math.random()
|
||||
}
|
||||
|
||||
return { x, setXRandom }
|
||||
},
|
||||
template: `
|
||||
<button @onClick="setXRandom"/>{{x}}</button>
|
||||
`
|
||||
}
|
||||
```
|
||||
|
||||
虽然在 Vue 中,`setup` 函数仅执行一次,看上去与 React 函数完全不一样(React 函数每次都执行),但其实 Vue 将渲染层(Template)与数据层(setup)分开了,而 React 合在了一起。
|
||||
|
||||
我们可以利用 React Hooks 将数据层与渲染层完全隔离:
|
||||
|
||||
```jsx
|
||||
// 类似 vue 的 setup 函数
|
||||
function useMyComponentSetup(props) {
|
||||
const [x, setX] = useState(0)
|
||||
|
||||
const setXRandom = useCallback(() => {
|
||||
setX(Math.random())
|
||||
}, [setX])
|
||||
|
||||
return { x, setXRandom }
|
||||
}
|
||||
|
||||
// 类似 vue 的 template 函数
|
||||
function MyComponent(props: { name: String }) {
|
||||
const { x, setXRandom } = useMyComponentSetup(props)
|
||||
|
||||
return (
|
||||
<button onClick={setXRandom}>{x}</button>
|
||||
)
|
||||
}
|
||||
```
|
||||
|
||||
这源于 JSX 与 Template 的根本区别。JSX 使模版与 JS 可以写在一起,因此数据层与渲染层可以耦合在一起写(也可以拆分),但 Vue 采取的 Template 思路使数据层强制分离了,这也使代码分层更清晰了。
|
||||
|
||||
而实际上 Vue3.0 的 `setup` 函数也是可选的,再配合其支持的 TSX 功能,与 React 真的只有 Mutable 的区别了:
|
||||
|
||||
```jsx
|
||||
// 这是个 Vue 组件
|
||||
const MyComponent = createComponent((props: { msg: string }) => {
|
||||
return () => h('div', props.msg)
|
||||
})
|
||||
```
|
||||
|
||||
我们很难评价 Template 与 JSX 的好坏,但为了更透彻的理解 Vue 与 React,需要抛开 JSX&Template,Mutable&Immutable 去看,其实去掉这两个框架无关的技术选型,React@16 与 Vue@3 已经非常像了。
|
||||
|
||||
> Vue3.0 的精髓是学习了 React Hooks 概念,因此正好可以用 Hooks 在 React 中模拟 Vue 的 setup 函数。
|
||||
|
||||
关于这两套技术选型,已经是相对完美的组合,不建议在 JSX 中再实现类似 Mutable + JSX 的花样来(因为喜欢 Mutable 可以用 Vue 呀):
|
||||
|
||||
- Vue:Mutable + Template
|
||||
- React:Immutable + JSX
|
||||
|
||||
真正影响编码习惯的就是 Mutable 与 Immutable,使用 Vue 就坚定使用 Mutable,使用 React 就坚定使用 Immutable,这样能最大程度发挥两套框架的价值。
|
||||
|
||||
## Vue Hooks 与 React Hooks 的差异
|
||||
|
||||
先看 React Hooks 的简单语法:
|
||||
|
||||
```jsx
|
||||
const [ count, setCount ] = useState(0)
|
||||
|
||||
const setToOne = () => setCount(1)
|
||||
```
|
||||
|
||||
Vue Hooks 的简单语法:
|
||||
|
||||
```jsx
|
||||
const count = value(0)
|
||||
|
||||
const setToOne = () => count.value = 1
|
||||
```
|
||||
|
||||
之所以 React 返回的 `count` 是一个数字,是因为 Immutable 规则,而 Vue 返回的 `count` 是个对象,拥有 `count.value` 属性,也是因为 Vue Mutable 规则导致,这使得 Vue 定义的所有变量都类似 React 中 `useRef` 定义变量,因此不存 React `capture value` 的特性。
|
||||
|
||||
> 关于 capture value 更多信息,可以阅读 [精读《Function VS Class 组件》 Capute Value 介绍](https://github.com/dt-fe/weekly/blob/v2/095.%E7%B2%BE%E8%AF%BB%E3%80%8AFunction%20VS%20Class%20%E7%BB%84%E4%BB%B6%E3%80%8B.md#capture-props)
|
||||
|
||||
另外,对于 Hooks 的值变更机制也不同,我们看 Vue 的代码:
|
||||
|
||||
```jsx
|
||||
const Component = {
|
||||
setup() {
|
||||
const { x, y } = useMouse()
|
||||
const { z } = useOtherLogic()
|
||||
return { x, y, z }
|
||||
},
|
||||
template: `<div>{{ x }} {{ y }} {{ z }}</div>`
|
||||
}
|
||||
```
|
||||
|
||||
由于 `setup` 函数仅执行一次,怎么做到当 `useMouse` 导致 `x`、`y` 值变化时,可以在 `setup` 中拿到最新的值?
|
||||
|
||||
在 React 中,`useMouse` 如果修改了 `x` 的值,那么使用 `useMouse` 的函数就会被重新执行,以此拿到最新的 `x`,而在 Vue 中,将 Hooks 与 Mutable 深度结合,通过包装 `x.value`,使得当 `x` 变更时,引用保持不变,仅值发生了变化。所以 Vue 利用 Proxy 监听机制,可以做到 `setup` 函数不重新执行,但 Template 重新渲染的效果。
|
||||
|
||||
这就是 Mutable 的好处,Vue Hooks 中,不需要 `useMemo` `useCallback` `useRef` 等机制,仅需一个 `value` 函数,直观的 Mutable 修改,就可以实现 React 中一套 Immutable 性能优化后的效果,这个是 Mutable 的魅力所在。
|
||||
|
||||
## Vue Hooks 的优势
|
||||
|
||||
笔者对 RFC 中对 Vue、React Hooks 的对比做一个延展解释:
|
||||
|
||||
首先最大的不同:`setup` 仅执行一遍,而 React Function Component 每次渲染都会执行。
|
||||
|
||||
**Vue 的代码使用更符合 JS 直觉。**
|
||||
|
||||
这句话直截了当戳中了 JS 软肋,JS 并非是针对 Immutable 设计的语言,所以 Mutable 写法非常自然,而 Immutable 的写法就比较别扭。
|
||||
|
||||
当 Hooks 要更新值时,Vue 只要用等于号赋值即可,而 React Hooks 需要调用赋值函数,**当对象类型复杂时,还需借助第三方库才能保证进行了正确的 Immutable 更新。**
|
||||
|
||||
**对 Hooks 使用顺序无要求,而且可以放在条件语句里。**
|
||||
|
||||
对 React Hooks 而言,调用必须放在最前面,而且不能被包含在条件语句里,这是因为 React Hooks 采用下标方式寻找状态,一旦位置不对或者 Hooks 放在了条件中,就无法正确找到对应位置的值。
|
||||
|
||||
而 Vue Function API 中的 Hooks 可以放在任意位置、任意命名、被条件语句任意包裹的,因为其并不会触发 `setup` 的更新,只在需要的时候更新自己的引用值即可,而 Template 的重渲染则完全继承 Vue 2.0 的依赖收集机制,它不管值来自哪里,只要用到的值变了,就可以重新渲染了。
|
||||
|
||||
**不会再每次渲染重复调用,减少 GC 压力。**
|
||||
|
||||
这确实是 React Hooks 的一个问题,所有 Hooks 都在渲染闭包中执行,每次重渲染都有一定性能压力,而且频繁的渲染会带来许多闭包,虽然可以依赖 GC 机制回收,但会给 GC 带来不小的压力。
|
||||
|
||||
而 Vue Hooks 只有一个引用,所以存储的内容就非常精简,也就是占用内存小,而且当值变化时,也不会重新触发 `setup` 的执行,所以确实不会造成 GC 压力。
|
||||
|
||||
**必须要总包裹 `useCallback` 函数确保不让子元素频繁重渲染。**
|
||||
|
||||
React Hooks 有一个问题,就是完全依赖 Immutable 属性。**而在 Function Component 内部创建函数时,每次都会创建一个全新的对象,这个对象如果传给子组件,必然导致子组件无法做性能优化。** 因此 React 采取了 `useCallback` 作为优化方案:
|
||||
|
||||
```jsx
|
||||
const fn = useCallback(() => /* .. */, [])
|
||||
```
|
||||
|
||||
只有当第二个依赖参数变化时才返回新引用。但第二个依赖参数需要 lint 工具确保依赖总是正确的(关于为何要对依赖诚实,感兴趣可以移步 [精读《Function Component 入门》 - 永远对依赖诚实](https://github.com/dt-fe/weekly/blob/v2/104.%E7%B2%BE%E8%AF%BB%E3%80%8AFunction%20Component%20%E5%85%A5%E9%97%A8%E3%80%8B.md#%E6%B0%B8%E8%BF%9C%E5%AF%B9%E4%BE%9D%E8%B5%96%E9%A1%B9%E8%AF%9A%E5%AE%9E))。
|
||||
|
||||
回到 Vue 3.0,由于 `setup` 仅执行一次,因此函数本身只会创建一次,不存在多实例问题,不需要 `useCallback` 的概念,更不需要使用 [lint 插件](https://www.npmjs.com/package/eslint-plugin-react-hooks) 保证依赖书写正确,这对开发者是实实在在的友好。
|
||||
|
||||
**不需要使用 `useEffect` `useMemo` 等进行性能优化,所有性能优化都是自动的。**
|
||||
|
||||
这也是实在话,毕竟 Mutable + 依赖自动收集就可以做到最小粒度的精确更新,根本不会触发不必要的 Rerender,因此 `useMemo` 这个概念也不需要了。
|
||||
|
||||
而 `useEffect` 也需要传递第二个参数 “依赖项”,在 Vue 中根本不需要传递 “依赖项”,所以也不会存在用户不小心传错的问题,更不需要像 React 写一个 lint 插件保证依赖的正确性。(这也是笔者想对 React Hooks 吐槽的点,React 团队如何保障每个人都安装了 lint?就算装了 lint,如果 IDE 有 BUG,导致没有生效,随时可能写出依赖不正确的 “危险代码”,造成比如死循环等严重后果)
|
||||
|
||||
# 4. 总结
|
||||
|
||||
通过对比 Vue Hooks 与 React Hooks 可以发现,Vue 3.0 将 Mutable 特性完美与 Hooks 结合,规避了一些 React Hooks 的硬伤。所以我们可以说 Vue 借鉴了 React Hooks 的思想,但创造出来的确实一个更精美的艺术品。
|
||||
|
||||
但 React Hooks 遵循的 Immutable 也有好的一面,就是每次渲染中状态被稳定的固化下来了,不用担心状态突然变更带来的影响(其实反而要注意状态用不变更带来的影响),对于数据记录、程序运行的稳定性都有较高的可预期性。
|
||||
|
||||
最后,对于喜欢 Mutable 的开发者,Vue 3.0 是你的最佳选择,基于 React + Mutable 搞的一些小轮子做到顶级可能还不如 Vue 3.0。对于 React 开发者来说,坚持你们的 Immutable 信仰吧,Vue 3.0 已经将 Mutable 发挥到极致,只有将 React Immutable 特性发挥到极致才能发挥 React 的最大价值。
|
||||
|
||||
> 讨论地址是:[精读《Vue3.0 Function API》 · Issue #173 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/173)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -4,7 +4,7 @@
|
||||
|
||||
# 1 引言
|
||||
|
||||
<img src="assets/11/coffee.jpg" width="500" alt="logo" />
|
||||
<img src="https://img.alicdn.com/imgextra/i2/O1CN01JC1TZ51Nxn24teojP_!!6000000001637-2-tps-1024-1296.png" width="500" alt="logo" />
|
||||
|
||||
梵高这幅画远景漆黑一片,近景的咖啡店色彩却反差很大,他只是望着黑夜中温暖的咖啡馆,交织着矛盾与孤独。代码不可能没有 BUG,调试与开发也始终交织在一起,我们在这两种矛盾中不断成长。
|
||||
|
||||
@@ -62,7 +62,7 @@ Chrome Dev Tools 非常强大,[dev-tips](https://umaar.com/dev-tips/) 列出
|
||||
|
||||
### 移动端控制台
|
||||
|
||||
- [Chrome远程调试](https://developers.google.com/web/tools/chrome-devtools/remote-debugging/webviews) app 支持后,连接 usb 或者局域网,即可通过 Dev Tools 调试 webview 页面。
|
||||
- [Chrome 远程调试](https://developers.google.com/web/tools/chrome-devtools/remote-debugging/webviews) app 支持后,连接 usb 或者局域网,即可通过 Dev Tools 调试 webview 页面。
|
||||
- [Weinre](http://people.apache.org/~pmuellr/weinre/docs/latest/Home.html) 通过页面加载脚本,与 pc 端调试器通信。
|
||||
- 通过内嵌控制台解决,比如 [eruda](http://eruda.liriliri.io/) [VConsole](https://github.com/WechatFE/vConsole)
|
||||
- [Rosin](http://alloyteam.github.io/Rosin/) fiddler 的一个插件,协助移动页面调试。
|
||||
@@ -105,7 +105,7 @@ Css 不像 Js 一样方便分析规则是否存在冗余,Chrome 帮我们做
|
||||
|
||||
Chrome 会记录最后插入的 5 个元素,分别以 `$0` ~ `$4` 的方式在控制台直接输出。
|
||||
|
||||
<img src="assets/11/last-item.png" width="500" alt="last-items" />
|
||||
<img src="https://img.alicdn.com/imgextra/i4/O1CN01xsKHb822gkXhDDcCA_!!6000000007150-2-tps-417-516.png" width="500" alt="last-items" />
|
||||
|
||||
### Console.table
|
||||
|
||||
@@ -0,0 +1,128 @@
|
||||
# 1. 引言
|
||||
|
||||
前端展望的文章越来越不好写了,随着前端发展的深入,需要拥有非常宽广的视野与格局才能看清前端的未来。
|
||||
|
||||
笔者根据自身经验,结合下面几篇文章发表一些总结与感悟:
|
||||
|
||||
- [A Look at JavaScript’s Future](https://www.toptal.com/javascript/predicting-javascript-future)
|
||||
- [前端开发 20 年变迁史](https://mp.weixin.qq.com/s/yNg7Q0XNLJMnqffTIJhNUg)
|
||||
- [前端开发编程语言的过去、现在和未来](https://johnhax.net/2019/fe-lang/article1)
|
||||
- [绕过技术纷争,哪些技术决定前端开发者的未来?](https://mp.weixin.qq.com/s?__biz=MzUxMzcxMzE5Ng==&mid=2247491704&idx=1&sn=95ad66f7fe606801cdac74e296a41783)
|
||||
- [未来前端的机会在哪里?](https://mp.weixin.qq.com/s?__biz=MzIzOTU0NTQ0MA==&mid=2247490769&idx=1&sn=7ee6e01045a6fe7e15f16aa33afcc2ad&chksm=e92921dede5ea8c8e93489271e8877d2e8688bd511b32e22c287b6c468904c5466b40f6a2bec&xtrack=1&scene=90&subscene=93&sessionid=1562200039&clicktime=1562)
|
||||
|
||||
读完这几篇文章可以发现,即便是最资深的前端从业者,每个人看前端未来也有不同的侧重点。这倒不是因为视野的局限,而是现在前端领域太多了,专精其中某几个领域就足够了,适量比全面更好。
|
||||
|
||||
同时前端底层也在逐渐封闭,虽然目睹了前端几十年变迁的开发者仍会对一些底层知识津津乐道,但通往底层的大门已经一扇扇逐渐关闭了,将更多的开发者挤到上层区域建设,所以仅学会近几年的前端知识依然能找到不错的工作。
|
||||
|
||||
然而上层建设是不封顶的,有人看到了山,有人看到了星球,不同业务环境,不同视野的人看到的东西都不同。
|
||||
|
||||
有意思是的国内和国外看到前端未来的视角也不同:国内看到的是追求更多的参与感、影响力,国外看到的是对新特性的持续跟进。
|
||||
|
||||
# 2. 精读
|
||||
|
||||
前端可以从多个角度理解,比如规范、框架、语言、社区、场景以及整条研发链路。
|
||||
|
||||
看待前端未来的角度随着视野不同也会有变化,比如 Serverless 是未来,务实的思考是:前端在 Serverless 研发链路中仅处于使用方,并不会因为用了 Serverless 而提升了技术含量。更高格局的思考是:怎么推动 Serverless 的建设,不把自己局限在前端。
|
||||
|
||||
所以当我们读到不同的人对前端理解的时候,有人站在一线前端研发的角度,有人站在全栈的角度,也有人站在业务负责人的角度。其实国内前端发展也到了这个阶段,老一辈的前端开拓者们已经进入不同的业务领域,承担着更多不同的职能分工,甚至是整个大业务线的领导者,这说明两点:
|
||||
|
||||
1. 前辈已经用行动指出了前端突破天花板的各种方向。
|
||||
2. 同是前端未来展望,不同的文章侧重的格局不同,两个标题相同的文章内容可能大相径庭。
|
||||
|
||||
笔者顺着这些文章分析角度,发表一些自己的看法。
|
||||
|
||||
## 框架
|
||||
|
||||
在前端早期,也就是 1990 年浏览器诞生的时候,JS 没有良好的设计,浏览器也没有全面的实现,框架还没出来,浏览器之间就打起来了。
|
||||
|
||||
这也给前端发展定了一个基调:凭实力说话。
|
||||
|
||||
后面诞生的 Prototype、jquery 都是为了解决时代问题而诞生的,所以有种时代造就前端框架的感觉。
|
||||
|
||||
但到了最近几年,React、Angular、Vue 大有前端框架引领新时代的势头,前端要做的不再是填坑,而是模式创新。国内出现的小程序浪潮是个意料之外的现象,虽然群雄割据为开发者适配带来了一定成本,但本质上是中国在前端底层领域争取话语权的行为,而之所以各大公司不约而同的推出自己的小程序,则是商业、经济发展到了这个阶段的自然产物。
|
||||
|
||||
在原生开发领域,像 RN、Flutter 也是比较靠谱的移动端开发框架,RN 就长在 React 上,而 Flutter 的声明式 UI 也借鉴了前端框架的思路。每个框架都想往其他框架的领域渗透,所以标准总是很相近,各自的特色并没有宣传的那么明显,这个阶段只选用一种框架是明智的选择,未来这些框架之间会有更多使用场景争夺,但更多的是融合,推动新的开发方式提高生产力。
|
||||
|
||||
在数据驱动 UI 的方式上,具有代表性的是 React 的 Immutable 模式与 Vue 的 MVVM 观察者模式,前者模式虽然新颖,但是符合 JS 语言自然运行机制,Vue 的 MVVM 模式也相当好,特别是 Vue3.0 的 API 巧妙的解决了 React Hooks 无法解决的难题。如果 Vue 继续保持蓬勃的发展势头,未来前端 MVVM 模式甚至可能标准化,那么 Vue 是作为标准化的事实规范,还是和 JQuery 一样的命运,还需观察。
|
||||
|
||||
## 语言
|
||||
|
||||
JS 语言本身有满多缺陷的,但通过 babel 前端工程师可以提前享受到大部分新特性,这在很大程度上抵消了早期语言设计带来的问题。
|
||||
|
||||
横向对比来看,我们还可以把编程语言分为:前端语言、后端语言、能编译到 JS 的语言。
|
||||
|
||||
之所以有 “能编译到 JS 的语言” 这一类,是因为 JS Runtime 几乎是前端跨平台的通用标准,能编译到 JS 就代表了可跨平台,然而现在 “能编译到 JS 的语言” 除了紧贴 JS 做类型增强的 TS 外,其他并没有火起来,有工具链生态不匹配的原因,也有各大公司之间利益争夺的原因。
|
||||
|
||||
后端语言越来越贴场景化,比如 Go 主打轻量级高并发方案,Python 以其易用性占领了大部分大数据、人工智能的运算场景。
|
||||
|
||||
与此对应的是前端语言的同质化,前端语言绑定在前端框架的趋势越来越明显,比如 IOS 平台只能用 OC 和 Swift,安卓只能用 JAVA 和 Kotlin,Flutter 只支持 Dart,与其说这些语言更适合这些平台特性,不如说背后是谷歌、苹果、微软等巨头对平台生态掌控权的争夺。Web 与移动端要解决的问题是类似的:如何高效管理 UI 状态,现在大部分都采用数据驱动的思路,通过 JSX 或 Template 的方式描述出 UI DSL(更多可参考 [前端开发编程语言的过去、现在和未来](https://johnhax.net/2019/fe-lang/article1) UI DSL 一节)、以及性能提升:渲染和计算分离(这里又分为并发与调度两种实现思路,目的和效果是类似的)。
|
||||
|
||||
所以编程语言的未来也没什么悬念,前端领域如果有的选就用 JS,没得选只能依附所在平台绑定的语言,而前端语言最近正在完成一轮升级大迁徙:JS -> TS,JAVA -> Kotlin,OC -> Swift,前端语言的特性、易用性正在逐步趋同。需要说明的是,如果仅了解这些语言的语法,对编程能力是毫无帮助的,了解平台特性,解决业务问题,提供更好的交互体验才是前端应该不断追求的目标,随着前端、Native 开发者之间的流动,前端领域语言层面差异会会来越小,大家越关注上层,越倾向抹平语言差异,甚至可能 All in JS,这不是因为 JS 有多大野心,而是因为在解决的问题趋同、业务优先的大背景下,大家都需要减少语言不通带来的障碍,最好的办法就是统一语言,从人类语言的演变就可以发现,要解决的问题趋同(人类交流)、与国家绑定的小众语言一直都有生存空间、语法大同小异,但不同语言都有一定自己的特色(比如法语表意更精确)、跨语言学习成本高,所以当国际化协作频繁时,一定会催生一套官方语言(英语),而使用基数大的语言可能会发展为通用国际语言(中文)。
|
||||
|
||||
将编程语言的割裂、统一比作人类语言来看,就能理解现状,和未来发展趋势了。
|
||||
|
||||
## 可视化
|
||||
|
||||
前面也说过,前端的底层在逐渐封闭,而可视化就是前端的上层。
|
||||
|
||||
所以笔者很少提到工程化,原因就是未来前端开发者接触工程化的机会越来越少,工程化机制也越来越完善,前端会逐渐回归到自己的本质 - 人机交互,而交互的重要媒介就是图形,无论组件库还是智能化设计稿 To Code 都为了解放简单、模式化的交互工作,专业前端将更多聚集到图形化领域。
|
||||
|
||||
图形和数据是分不开的,所以图形化还要考虑性能问题与数据转换。
|
||||
|
||||
可视化是对性能要求最高的,因此像 web worker、GPU 加速都是常见处理手段,WASM 技术也会用到可视化中。具体到某个图表或大屏的性能优化,还会涉及数据抽样算法,分层渲染等,仅仅性能优化领域就有不少探索的空间。性能问题一般还伴随着数据量大,所以数据序列化方案也要一并考虑。
|
||||
|
||||
可视化图形学是非常学术的领域,从图形语法到交互语法,从一图一做的简单场景,到可视化分析场景的灵活拓展能力,再到探索式分析的图形语法完备性要求,可视化库想要一层层支持不同业务场景的需求,要有一个清晰的分层设计。
|
||||
|
||||
仅可视化的图形学领域,就足够将所有时间投入了,未来做可视化的前端会越来越专业,提供的工具库接口也越来越有一套最佳实践沉淀,对普通前端越来越友好。
|
||||
|
||||
BI 可视化分析就是前端深造的一个方向,跟随 BI 发展阶段,对前端的要求也在不断变化:工程化、组件化、搭建技术、渲染引擎、可视化、探索式、智能化,跟上产品对技术能力的要求,其实是相当有挑战性的。
|
||||
|
||||
## 编辑器
|
||||
|
||||
编辑器方向主要有 IDE(Web IDE)、富文本编辑器。
|
||||
|
||||
**IDE 方向** 国产做的比较好的是 HBuilder,国际上做的比较好的是 VSCode,由于微软还同时推出了 Web 版 MonacoEditor,让 Web IDE 开发的门槛大大降低。
|
||||
|
||||
作为使用者,现在和未来的主流可能都是微软系,毕竟微软在操作系统、IDE 方面人才储备和经验积累很多。但随着云服务的变迁,引导着开发方式升级,IDE 游戏规则可能迎来重大改变 - 云化。云化使得作为开发者拥有更多竞争的机会,因为云上 IDE 市场现在还是蓝海,现在很多创业公司和大公司内部都在走这个方向,这标志着中国计算机技术往更底层的技术发展,未来会有更多的话语权。
|
||||
|
||||
从发展阶段来说,前端也发展到了 Web IDE 这个时代。对大公司来说,内部有许许多多割裂的工程化孤岛,不仅消耗大量优秀的前端同学去维护,也造成内部物料体系、工程体系难以打通,阻碍了内部技术流通,而云 IDE 天生的中心化环境管理可以解决这个问题,同时还能带来抹平计算机环境差异、统一编译环境、源码不落盘、甚至实现自动的多人协作也成为了可能,而云 IDE 因为在云上,也不止于 IDE,还可以很方便的集成流程,将研发全链路打通,因此在阿里内部也成为了今年四大方向之一。
|
||||
|
||||
所以今年可以明显看到的是,前端又在逐步替代低水平重复的 UI 设计,从设计稿生成代码,到研发链路上云,这种顶层设计正在进一步收窄前端底层建设,所以未来会有更多专业前端涌入可视化领域。
|
||||
|
||||
**富文本编辑器方向** 是一个重要且小众的领域,老牌做的较好的是 UEditor 系列,现在论体验和周边功能完善度,做得最好的是语雀编辑器。开源也有很多优秀的实现,比如 Quill、DraftJS、Slate 等等,但现在富文本编辑器核心能力是功能完备性(是否支持视频、脑图、嵌入)、性能、服务化功能打通了多少(是否支持在线解析 pdf、ppt 等文件)、交互自然程度(拷贝内容的智能识别)等等。如果将眼光放到全球,那国外有大量优秀富文本编辑器案例,比如 Google Docs、Word Online、iCloud Pages 等等。
|
||||
|
||||
最好用的富文本编辑器往往不开源,因为投入的技术研发成本是巨大的,本身这项技术就是一个产品,卖点就是源码。
|
||||
|
||||
富文本编辑器功能强度可以分为三个级别:L0~L2:
|
||||
|
||||
- L0:利用浏览器自带的输入框,主要指 `contenteditable` 实现。
|
||||
- L1:在 L0 的基础上通过 DOM API 自主实现增删改的功能,自定义能力非常强。
|
||||
- L2:从输入框、光标开始自主研发,完全不依赖浏览器特性,如果研发团队能力强,可以实现任何功能,典型产品比如 Google Docs。
|
||||
|
||||
无论国内外都鲜有进入 L2 强度的产品,除了超级大公司或者主打编辑器的创业公司。
|
||||
|
||||
所以编辑器方向中,无论 IDE 方向,还是富文本编辑器方向,都值得深入探索,其中 IDE 方向更偏工程化一些,考验体系化思维,编辑器方向更偏经验与技术,考验基本功和架构设计能力。
|
||||
|
||||
## 智能化
|
||||
|
||||
笔者认为智能化离前端这个工种是比较远的,智能化最终服务前后端,给前后端开发效率带来一个质的提升,而在此之前,作为前端从业者无非有两种选择:加入智能化开拓者队伍,或者准备好放弃可能被智能化替代的工作内容,积极投身于智能化解放开发者双手后,更具有挑战性的工作。这种挑战性的工作恰好包括了上面分析过的四个点:语言、框架、可视化、编辑器。
|
||||
|
||||
类比商业智能化,商业智能化包括网络协同和数据智能,也就是大量的网络协同产生海量数据,通过数据智能算法促进更好的算法模型、更高效的网络协同,形成一个反馈闭环。前端智能化也是类似,不管是自动切图、生成图片、页面,或者自动生成代码,都需要算法和前端工程师之间形成协同关系,并完成一个高效的反馈闭环,算法将是前端工程师手中的开发利器,且越规模化的使用功效越大。
|
||||
|
||||
另一种智能化方向是探索 BI 与可视化结合的智能化,通过功能完备的底层图表库,与后端通用 Cube 计算模型,形成一种探索式分析型 BI 产品,Tableau 就是典型的案例,在这个智能化场景中,需要对数据、产品、可视化全面理解的综合性人才,是前端职业生涯另一个突破点。
|
||||
|
||||
# 3. 总结
|
||||
|
||||
本文列举的五点显然不能代表前端的全貌,还遗漏了太多方面,比如工程化、组件化、Serverless 等,但 **语言、框架、可视化、编辑器、智能化** 这五个点是笔者认为前端,特别是国内前端值得持续发力,可以做深的点,成为任何一个领域的专家都足以突破前端工程师成长的天花板。
|
||||
|
||||
最后,前端是最贴近业务的技术之一,业务的未来决定了前端的未来,创造的业务价值决定了前端的价值,从现在开始锻炼自己的商业化思考能力与产品意识,看得懂业务,才能看到未来。
|
||||
|
||||
> 讨论地址是:[精读《前端未来展望》 · Issue #178 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/178)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,303 @@
|
||||
# 1. 引言
|
||||
|
||||
[javascript-knowledge-reading-source-code](https://www.smashingmagazine.com/2019/07/javascript-knowledge-reading-source-code/) 这篇文章介绍了阅读源码的重要性,精读系列也已有八期源码系列文章,分别是:
|
||||
|
||||
- [精读《Immer.js》源码](https://github.com/dt-fe/weekly/blob/v2/048.%E7%B2%BE%E8%AF%BB%E3%80%8AImmer.js%E3%80%8B%E6%BA%90%E7%A0%81.md)
|
||||
- [精读《sqorn 源码》](https://github.com/dt-fe/weekly/blob/v2/073.%E7%B2%BE%E8%AF%BB%E3%80%8Asqorn%20%E6%BA%90%E7%A0%81%E3%80%8B.md)
|
||||
- [精读《Epitath 源码 - renderProps 新用法》](https://github.com/dt-fe/weekly/blob/v2/075.%E7%B2%BE%E8%AF%BB%E3%80%8AEpitath%20%E6%BA%90%E7%A0%81%20-%20renderProps%20%E6%96%B0%E7%94%A8%E6%B3%95%E3%80%8B.md)
|
||||
- [精读《Htm - Hyperscript 源码》](https://github.com/dt-fe/weekly/blob/v2/082.%E7%B2%BE%E8%AF%BB%E3%80%8AHtm%20-%20Hyperscript%20%E6%BA%90%E7%A0%81%E3%80%8B.md)
|
||||
- [精读《React PowerPlug 源码》](https://github.com/dt-fe/weekly/blob/v2/092.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20PowerPlug%20%E6%BA%90%E7%A0%81%E3%80%8B.md)
|
||||
- [精读《syntax-parser 源码》](https://github.com/dt-fe/weekly/blob/v2/093.%E7%B2%BE%E8%AF%BB%E3%80%8Asyntax-parser%20%E6%BA%90%E7%A0%81%E3%80%8B.md)
|
||||
- [精读《react-easy-state 源码》](https://github.com/dt-fe/weekly/blob/v2/098.%E7%B2%BE%E8%AF%BB%E3%80%8Areact-easy-state%20%E6%BA%90%E7%A0%81%E3%80%8B.md)
|
||||
- [精读《Inject Instance 源码》](https://github.com/dt-fe/weekly/blob/v2/110.%E7%B2%BE%E8%AF%BB%E3%80%8AInject%20Instance%20%E6%BA%90%E7%A0%81%E3%80%8B.md)
|
||||
|
||||
笔者自己的感悟是,读过大量源码的程序员有以下几个特质:
|
||||
|
||||
1. 思考具有系统性,主要体现在改一处代码模块时,会将项目所有文件串联起来整体考虑,提前评估影响面。
|
||||
2. 思考具有前瞻性,对已实现的方案可以快速评价所处阶段(临时 or 标准 or 可拓展),将边界情况提前解决,将框架 BUG 降低到最小程度。
|
||||
3. 代码实现更优雅,有大量源码经验做支撑,解决同样问题时,这些程序员可以用更短的行数、更合适的三方库解决问题,代码可读性更好,模块拆分更合理,更利于维护。
|
||||
|
||||
既然阅读源码这么重要,那么怎么才能读好源码呢?本周精读的文章就是一篇方法论文章,告诉你如何更好的阅读源码。
|
||||
|
||||
# 2. 概述
|
||||
|
||||
原文分三个部分:阅读源码的好处、阅读源码的技巧、以及 Redux Connect 的案例研究。
|
||||
|
||||
## 阅读源码的好处
|
||||
|
||||
阅读源码有助于理解抽象的概念,比如虚拟 DOM;有助于做方案调研,而不仅仅只看 Github star 数量;了解优秀框架目录结构的设计;看到一些陌生的工具函数,还可能激发你对 JS 规范的查阅,这种问题驱动的方式也是笔者推荐的 JS 规范学习方式。
|
||||
|
||||
## 阅读源码的技巧
|
||||
|
||||
最好的阅读源码方式是看文章,如果源码的作者有写源码解读文章,这就是最省力的方式。虽然直接看代码可以了解到所有细节,但当你不清楚设计思路时,仅看源码可能会找不到方向,而读源码的最终目的是找到核心的设计理念,如果一个框架没有自己核心设计理念,这个框架也不值得诞生,更不值得被阅读。如果框架的作者已经将框架核心理念写成了文章,那读文章就是最佳方案。
|
||||
|
||||
还有一种方式是断点,写一个最小程序,在框架执行入口出打下断点,然后按照执行路径一步步理解。虽然执行路径中会存在大量无关的函数干扰精力,但如果你足够有耐心,当断点走完时一定会有所收获。
|
||||
|
||||
原文还提到了一种看源码方式,即没有目的的寻宝。在寻找框架主要思路的过程中,遇到一些有意思的函数,可以停下来仔细阅读,可能会发现一些对你有启发的代码片段。
|
||||
|
||||
## Redux Connect 案例研究
|
||||
|
||||
原文以 Redux Connect 作为案例介绍研究思路。
|
||||
|
||||
首先看到 Connect 的功能 “包装组件” 后,就要问自己两个问题:
|
||||
|
||||
1. Connect 是如何实现包装组件后原样返回组件,但却增强组件功能的?(高阶组件知识)
|
||||
2. 了解这个设计模式后,如何利用已有的文档实现它?
|
||||
|
||||
通过创建一个使用 Connect 的基本程序:
|
||||
|
||||
```js
|
||||
class MarketContainer extends Component {
|
||||
|
||||
}
|
||||
|
||||
const mapDispatchToProps = dispatch => {
|
||||
return {
|
||||
updateSummary: (summary, start, today) => dispatch(updateSummary(summary, start, today))
|
||||
}
|
||||
}
|
||||
|
||||
export default connect(null, mapDispatchToProps)(MarketContainer);
|
||||
```
|
||||
|
||||
比如从生成 connect 函数的 [createConnect](https://github.com/reduxjs/react-redux/blob/master/src/connect/connect.js#L46) 我们就可以学习到 [Facade Pattern](http://jargon.js.org/_glossary/FACADE_PATTERN.md) - 门面模式。
|
||||
|
||||
从 `createConnect` 函数调用处:
|
||||
|
||||
```js
|
||||
export function createConnect({
|
||||
connectHOC = connectAdvanced,
|
||||
mapStateToPropsFactories = defaultMapStateToPropsFactories,
|
||||
mapDispatchToPropsFactories = defaultMapDispatchToPropsFactories,
|
||||
mergePropsFactories = defaultMergePropsFactories,
|
||||
selectorFactory = defaultSelectorFactory
|
||||
} = {})
|
||||
```
|
||||
|
||||
我们可以学习到解构默认函数参数的知识点。
|
||||
|
||||
总之,在学习源码的过程中,可以了解到一些新的 JS 特性,一些设计模式,这些都是额外的宝藏,不断理解并学会运用到自己写的框架里,就实现了源码学习的目的。
|
||||
|
||||
# 3. 精读
|
||||
|
||||
原文介绍了学习源码的两个技巧,并利用 Redux Connect 实例说明了源码学习过程中可以学到许多周边知识,都让我们受益匪浅。
|
||||
|
||||
笔者结合之前写过的八篇源码分析文章,把最重要的设计思路提取出来,以实际的例子展示阅读源码能给我们思维带来哪些帮助。
|
||||
|
||||
## Immerjs 源码的精华
|
||||
|
||||
Immer 可以让我们以 Mutable 的方式更新对象,最终得到一个 Immutable 对象:
|
||||
|
||||
```js
|
||||
this.setState(produce(state => (state.isShow = true)))
|
||||
```
|
||||
|
||||
> 详细源码解读可以阅读 [这里](https://github.com/dt-fe/weekly/blob/v2/048.%E7%B2%BE%E8%AF%BB%E3%80%8AImmer.js%E3%80%8B%E6%BA%90%E7%A0%81.md#3-%E7%B2%BE%E8%AF%BB)。
|
||||
|
||||
核心思路是利用 Proxy 把脏活累活做掉。上面的例子中,`state` 已经是一个代理(Proxy)对象,通过自定义 `setting` 不断递归进行浅拷贝,最后返回一个新引用的顶层对象作为 `produce` 的返回值。
|
||||
|
||||
从 Immerjs 中,我们学到了 Proxy 可以化腐朽为神奇的用法,比看任何 Proxy 介绍文章都直观。
|
||||
|
||||
## sqorn 源码的精华
|
||||
|
||||
sqorn 是一个 sql orm,举例来看:
|
||||
|
||||
```js
|
||||
const sq = require("sqorn-pg")();
|
||||
|
||||
const Person = sq`person`,
|
||||
Book = sq`book`;
|
||||
|
||||
// SELECT
|
||||
const children = await Person`age < ${13}`;
|
||||
// "select * from person where age < 13"
|
||||
```
|
||||
|
||||
> 详细源码解读可以阅读 [这里](https://github.com/dt-fe/weekly/blob/v2/073.%E7%B2%BE%E8%AF%BB%E3%80%8Asqorn%20%E6%BA%90%E7%A0%81%E3%80%8B.md#3-%E7%B2%BE%E8%AF%BB)
|
||||
|
||||
核心思路是在链式调用过程中创建 context 存储结构,并在链式调用的时候不断填充 context 信息,最终拿到的是一个结构化 context 对象,生成 sql 语句也就简单了。
|
||||
|
||||
从 sqorn 中,我们学到了如何实现链式调用 `init().a().b().c().print()` 最后拿到一个综合的结果,原理是内部维护了一个不断修改的对象。不论前端 React Vue 还是后端框架 Koa 等,一般都有内置的 context,一般实现这种优雅语法的框架内部都会维护 context。
|
||||
|
||||
## Epitath 源码的精华
|
||||
|
||||
Epitath 在 React Hooks 之前出来,解决了高阶函数地狱的问题:
|
||||
|
||||
```js
|
||||
const App = epitath(function*() {
|
||||
const { count } = yield <Counter />
|
||||
const { on } = yield <Toggle />
|
||||
|
||||
return (
|
||||
<MyComponent counter={count} toggle={on} />
|
||||
)
|
||||
})
|
||||
|
||||
<App />
|
||||
```
|
||||
|
||||
> 详细源码解读可以阅读 [这里](https://github.com/dt-fe/weekly/blob/v2/075.%E7%B2%BE%E8%AF%BB%E3%80%8AEpitath%20%E6%BA%90%E7%A0%81%20-%20renderProps%20%E6%96%B0%E7%94%A8%E6%B3%95%E3%80%8B.md#3-%E7%B2%BE%E8%AF%BB)
|
||||
|
||||
其核心是利用 `generator` 的迭代,将 React 组件的平级结构还原成嵌套结构,将嵌套写法打平了:
|
||||
|
||||
```plain
|
||||
yield <A>
|
||||
yield <B>
|
||||
yield <C>
|
||||
// 等价于
|
||||
<A>
|
||||
<B>
|
||||
<C />
|
||||
</B>
|
||||
</A>
|
||||
```
|
||||
|
||||
从 epitath 中,我们了解到 `generator` 原来可以这么用,正因为其执行是多次迭代的,因此我们可以利用这个特性,改变代码运行结构。
|
||||
|
||||
## Htm - Hyperscript 源码的精华
|
||||
|
||||
Htm 将模版语法很自然的融入到了 html 中:
|
||||
|
||||
```js
|
||||
html`
|
||||
<div class="app">
|
||||
<${Header} name="ToDo's (${page})" />
|
||||
<ul>
|
||||
${todos.map(
|
||||
todo => html`
|
||||
<li>${todo}</li>
|
||||
`
|
||||
)}
|
||||
</ul>
|
||||
<button onClick=${() => this.addTodo()}>Add Todo</button>
|
||||
<${Footer}>footer content here<//>
|
||||
</div>
|
||||
`;
|
||||
```
|
||||
|
||||
> 详细源码解读可以阅读 [这里](https://github.com/dt-fe/weekly/blob/v2/082.%E7%B2%BE%E8%AF%BB%E3%80%8AHtm%20-%20Hyperscript%20%E6%BA%90%E7%A0%81%E3%80%8B.md#3-%E7%B2%BE%E8%AF%BB)
|
||||
|
||||
其核心是怎么根据模版拿到 dom 元素的 AST?拿到 AST 后就方便生成后续内容了。
|
||||
|
||||
作者的办法是:
|
||||
|
||||
```js
|
||||
const TEMPLATE = document.createElement("template");
|
||||
TEMPLATE.innerHTML = str;
|
||||
```
|
||||
|
||||
这样 TEMPLATE 就自带了 AST 解析,这是利用浏览器自带的 AST 解析拿到了 AST。从 Htm 中,我们学到了 `innerHTML` 可以生成标准 AST,所以只要有浏览器运行环境,需要拿 AST 的时候,不需要其他库,`innerHTML` 就是最好的方案。
|
||||
|
||||
## React PowerPlug 源码的精华
|
||||
|
||||
React PowerPlug 是一个利用 render props 进行状态管理的工具库。
|
||||
|
||||
它可以在 JSX 中对任意粒度插入状态管理:
|
||||
|
||||
```js
|
||||
<Value initial="React">
|
||||
{({ value, set, reset }) => (
|
||||
<>
|
||||
<Select
|
||||
label="Choose one"
|
||||
options={["React", "Preact", "Vue"]}
|
||||
value={value}
|
||||
onChange={set}
|
||||
/>
|
||||
<Button onClick={reset}>Reset to initial</Button>
|
||||
</>
|
||||
)}
|
||||
</Value>
|
||||
```
|
||||
|
||||
> 详细源码解读可以阅读 [这里](https://github.com/dt-fe/weekly/blob/v2/092.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20PowerPlug%20%E6%BA%90%E7%A0%81%E3%80%8B.md#2-%E7%B2%BE%E8%AF%BB)
|
||||
|
||||
这个库的核心就是利用 render props 解决 JSX 局部状态管理的痛点,通过读源码了解 render props 的使用方式是这个源码带给你的最大价值。
|
||||
|
||||
## syntax-parser 源码的精华
|
||||
|
||||
syntax-parser 是一个 JS 版语法解器生成器,笔者也是作者,使用方式:
|
||||
|
||||
```js
|
||||
import { createParser, chain, matchTokenType, many } from "syntax-parser";
|
||||
|
||||
const root = () => chain(addExpr)(ast => ast[0]);
|
||||
|
||||
const addExpr = () =>
|
||||
chain(matchTokenType("word"), many(addPlus))(ast => ({
|
||||
left: ast[0].value,
|
||||
operator: ast[1] && ast[1][0].operator,
|
||||
right: ast[1] && ast[1][0].term
|
||||
}));
|
||||
|
||||
const addPlus = () =>
|
||||
chain("+"), root)(ast => ({
|
||||
operator: ast[0].value,
|
||||
term: ast[1]
|
||||
}));
|
||||
|
||||
const myParser = createParser(
|
||||
root, // Root grammar.
|
||||
myLexer // Created in lexer example.
|
||||
);
|
||||
```
|
||||
|
||||
> 详细源码解读可以阅读 [这里](https://github.com/dt-fe/weekly/blob/v2/093.%E7%B2%BE%E8%AF%BB%E3%80%8Asyntax-parser%20%E6%BA%90%E7%A0%81%E3%80%8B.md#2-%E7%B2%BE%E8%AF%BB)
|
||||
|
||||
syntax-parser 的核心是利用双向链表实现了可回溯的语法解析器,了解了这个库,你可以自己实现 JS 调用堆栈,并在任意时候返回某个之前的执行状态重新执行。同时这个库的源码也会加强你对链表的理解,以及拓展你对链表使用场景的想象。
|
||||
|
||||
## react-easy-state 源码的精华
|
||||
|
||||
react-easy-state 利用 Proxy 创建了一个简易的全局数据流管理方式:
|
||||
|
||||
```js
|
||||
import React from "react";
|
||||
import { store, view } from "react-easy-state";
|
||||
|
||||
const counter = store({ num: 0 });
|
||||
const increment = () => counter.num++;
|
||||
|
||||
export default view(() => <button onClick={increment}>{counter.num}</button>);
|
||||
```
|
||||
|
||||
> 详细源码解读可以阅读 [这里](https://github.com/dt-fe/weekly/blob/v2/098.%E7%B2%BE%E8%AF%BB%E3%80%8Areact-easy-state%20%E6%BA%90%E7%A0%81%E3%80%8B.md)
|
||||
|
||||
react-easy-state 利用了 [observer-util](https://github.com/nx-js/observer-util) 实现主要功能,从中我们能学到最有价值的就是 Proxy 与 React 结合的设计理念,即利用 `getter` `setter` 实现数据与视图的双向绑定,或者叫依赖追踪,更多细节就不在这里展开,感兴趣可以阅读笔者之前写的 [抽丝剥茧,实现依赖追踪](https://github.com/dt-fe/weekly/blob/master/35.%E7%B2%BE%E8%AF%BB%E3%80%8Adob%20-%20%E6%A1%86%E6%9E%B6%E5%AE%9E%E7%8E%B0%E3%80%8B.md#%E6%8A%BD%E4%B8%9D%E5%89%A5%E8%8C%A7%E5%AE%9E%E7%8E%B0%E4%BE%9D%E8%B5%96%E8%BF%BD%E8%B8%AA) 一节。
|
||||
|
||||
## Inject Instance 源码的精华
|
||||
|
||||
inject-instance 是一个 Class 实现依赖注入的库:
|
||||
|
||||
```js
|
||||
import {inject} from 'inject-instance'
|
||||
import B from './B'
|
||||
|
||||
class A {
|
||||
@inject('B') private b: B
|
||||
public name = 'aaa'
|
||||
|
||||
say() {
|
||||
console.log('A inject B instance', this.b.name)
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
> 详细源码解读可以阅读 [这里](https://github.com/dt-fe/weekly/blob/v2/110.%E7%B2%BE%E8%AF%BB%E3%80%8AInject%20Instance%20%E6%BA%90%E7%A0%81%E3%80%8B.md#2-%E7%B2%BE%E8%AF%BB)
|
||||
|
||||
主要对我们有两个启发,第一可以利用装饰器为对象存储一些额外信息,这些信息在必要的时候我们可以用到;第二是依赖注入并不复杂,通过提前实例化后,可以解决循环依赖的问题,即所有循环依赖问题都可以通过加一个父级解决。
|
||||
|
||||
# 4. 总结
|
||||
|
||||
阅读代码不是目的,读懂源码背后要表达的核心设计思路才是目的。比如写脚手架,阅读了大量脚手架源码的人写出的代码,与一个没有经验的人写出的代码会有天壤之别,这之间的差距就是对一些设计模式、三方库、结构设计的经验差距。
|
||||
|
||||
只学习理论太空洞,只看代码又太局限,学会从代码中看出理论才是最佳学习方式。
|
||||
|
||||
> 讨论地址是:[精读《源码学习》 · Issue #179 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/179)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,96 @@
|
||||
# 1. 引言
|
||||
|
||||
Node12 发布有几个月了,让我们跟随 [Nodejs 12](https://blog.logrocket.com/node-js-12/) 一起看看 Node12 带来了哪些改变。
|
||||
|
||||
# 2. 概述
|
||||
|
||||
Node12 与以往的版本不同,带来了许多重大升级,包括更多 V8 特性,Http 解析速度的提升,启动速度的提升,更好的诊断报告、内置堆分析工具,ESM 模块的更新等。
|
||||
|
||||
## V8 引擎升级
|
||||
|
||||
V8 升级带来了如下几个特性:
|
||||
|
||||
- [zero-cost async 堆栈信息](https://v8.dev/blog/v8-release-72#async-stack-traces) 原生支持了 async 堆栈信息,不会添加额外运行时内容。
|
||||
- [参数数量不匹配时性能优化](https://v8.dev/blog/v8-release-74#faster-calls-with-arguments-mismatch) 即便参数传递多了或少了,现在都几乎不会影响 Node 的执行速度。
|
||||
- [更快的 async](https://v8.dev/blog/v8-release-73#faster-await) async /await 已经比 promises 快了两个 microticks。
|
||||
- [更快的 Js 解析速度](https://v8.dev/blog/v8-release-72#javascript-parsing) 网页中的 V8 引擎一般花费 9.5% 时间在 JS 解析上,经过解析加速后,现在花费在 JS 解析上的时间降低到平均 7.5%。
|
||||
|
||||
可见 V8 引擎的升级不仅给 Node12 带来了福音,也会一定程度上提升网页的运行效率。
|
||||
|
||||
## TLS 1.3 更好的安全性
|
||||
|
||||
随着 Node12 的发布,TLS 从 1.2 升级到了 1.3,更安全且更易配置。通过使用 TLS 1.3,Node 程序可以减少 Https 握手所需时间来提升请求性能。
|
||||
|
||||
## 默认堆被正确配置了
|
||||
|
||||
以前默认堆大小需要通过 `-max-old-space-size` 设置,而且默认值是一个固定值,现在这个默认值可以根据可用内存动态分配,这样当内存较小时,Node 不会让内存移除而报错,而是主动终止自己的进程。
|
||||
|
||||
## 默认的 http 解析器变为 llhttp
|
||||
|
||||
nodejs 的 [http-parser](https://github.com/nodejs/http-parser) 已经非常难以维护和优化了,因此 [llhttp](https://github.com/nodejs/llhttp#readme) 这个库,比 http-parser 快 156%,更重要的是,在 Node12 中,将默认解析器切换到了 llhttp。
|
||||
|
||||
## 提供诊断报告
|
||||
|
||||
Node12 有一项实验功能,根据用户需求提供诊断报告,包括崩溃、性能下降、内存泄露、CPU 使用高等等。
|
||||
|
||||
## 堆内存 dump
|
||||
|
||||
在以前,如果要将堆内存生成 dump 文件,需要在生产环境安装额外的模块,而 Node12 集成了这个功能。
|
||||
|
||||
## 更好的原生模块支持
|
||||
|
||||
C++ 拓展 [N-API](https://nodejs.org/api/n-api.html#n_api_n_api) 升级到版本 4,同时一个原生模块可以被 C++ 编写并发布到 npm,就像一个普通 JS 模块一样被引用。不过要注意一些区别:
|
||||
|
||||
| | | JS 模块 | 原生拓展 |
|
||||
| --- | -------------------------------------- | ------- | ------------------ |
|
||||
| 1. | ... 需要编译 | 否 | 如果预编译了则不用 |
|
||||
| 2. | ... 是否可以运行在所有平台 | 是 | 如果预编译了则可以 |
|
||||
| 3. | ... 是否兼容所有 Node 版本 | 是 | 否 |
|
||||
| 4. | ... 会被加载多次 | 是 | 否 |
|
||||
| 5. | ... 如果没有明确使用多线程,则线程安全 | 是 | 否 |
|
||||
| 6. | ... 可以被销毁 | 是 | 否 |
|
||||
|
||||
## Worker 被正式启用了
|
||||
|
||||
`--experimental-worker` 实验开关已取消,默认支持 `worker_threads`。
|
||||
|
||||
要注意的是,执行 CPU 密集型任务时适合用 worker(大量计算),而执行 I/O 密集型任务时,Worker 反而没有 Node 内置的 I/O 操作性能好(读写文件)。
|
||||
|
||||
## 启动速度优化
|
||||
|
||||
通过在构建时提前为内置库生成代码缓存,最终使启动时间加快 30%。
|
||||
|
||||
## 支持 ES6 module
|
||||
|
||||
Node12 对 ES6 module 的支持依然处于实验阶段,需要通过 `--experimental-modules` 开启。
|
||||
|
||||
简单来说,就是支持了 Import Export 语法,不需要再转成 `require` 了!如果在 `package.json` 增加 `"type": "module"` 的配置,Node 将按照 ES6 module 方式处理。
|
||||
|
||||
## 新的编译器和平台要求
|
||||
|
||||
由于升级到新的 V8 引擎以及内部改造,因此 Node12 在 Mac 与 Windows 之外的平台上,需要至少 GCC6 和 glibc 2.17。
|
||||
|
||||
# 3. 精读
|
||||
|
||||
对于 V8 引擎升级、TLS 升级、堆配置自动化、http-parser 升级到 llhttp、启动速度优化都属于被动优化,代码无需改动,只要升级 Node 版本就可以享受。
|
||||
|
||||
支持 ES6 module 这个特性其实比较鸡肋,毕竟源码用 Ts 写的话,这些升级并不会对源码产生影响。
|
||||
|
||||
`worker_threads` 可以被默认启用,就像以前支持 `async/await` 一样,会带来 Nodejs 多线程更广泛的使用。
|
||||
|
||||
Node12 更新了 V8 引擎,随着 V8 的更新,很多 ES 新规范也落地了,比如 Class 成员函数、私有成员变量等等。
|
||||
|
||||
# 4. 总结
|
||||
|
||||
Nodejs 仅有 10 年历史,但现在越来越被开发者欢迎,因为它可以让 JS 运行在服务端,是扩大 JS 生态的重要一环。从 Node 更新历史中可以看到,性能和语法能力稳步提升,一些服务端环境需要的诊断报告、堆栈分析能力都在逐渐完善,社区上也有 Alinode 与 egg、express、koa 等好用的服务框架,相对于前端翻天覆地的变化,对 Node 的评价只有一个字:稳。
|
||||
|
||||
|
||||
> 讨论地址是:[精读《Nodejs V12》 · Issue #184 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/184)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,541 @@
|
||||
# 1. 引言
|
||||
|
||||
Tableau 探索式分析功能非常强大,各种功能组合似乎有着无限的可能性。
|
||||
|
||||
今天笔者会分析这种探索式模型解题思路,一起看看这种探索式分析功能是如何做到的。
|
||||
|
||||
# 2. 精读
|
||||
|
||||
要掌握探索式分析,先要掌握探索式分析背后的思维模型。
|
||||
|
||||
## 理解数据
|
||||
|
||||
有分析意义的数据一般是表结构,即分为行与列,列定义了数据含义,行则构成了数据明细。
|
||||
|
||||
当我们将数据作为 “原材料” 使用时,需要将这些明细数据封装为 “数据集” 的概念来理解,数据集概念中,数据就是一个个字段,对于字段,要理解 “维度” 与 “度量” 这两个概念。
|
||||
|
||||
### 维度
|
||||
|
||||
维度是不能被计数的字段,一般为字符串或离散的值,用来描述数据的维度。
|
||||
|
||||
### 度量
|
||||
|
||||
度量是可以被计数的字段,一般为数字、日期等连续的值,用来描述数据的量。
|
||||
|
||||
<img width=172 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566632483137-9e0268d9-f890-45e6-a3e5-805355b35af9.png#align=left&display=inline&height=464&name=image.png&originHeight=1096&originWidth=406&size=83329&status=done&width=172">
|
||||
|
||||
我们首先要将数据集字段归类到维度与度量,才能提高数据分析的效率。**数据分析就是从不同维度下看度量值**,先想清楚要看的是什么数据,比如销量还是利润?这些字段都属于度量,然后想一想要怎么看这些度量,是看总数、拆解到年看、还是按地区看呢?这些字段都属于维度。
|
||||
|
||||
**维度和度量是可以单独看的,如果单看维度,那只能看这个维度的明细,比如看 订单日期 这个字段**:
|
||||
|
||||
<img width=190 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566633158647-cba541bd-673c-498c-95e6-53c89346c458.png#align=left&display=inline&height=149&name=image.png&originHeight=298&originWidth=380&size=24178&status=done&width=190">
|
||||
|
||||
需要注意的时,维度与度量字段还可以分为 **连续** 与 **离散** 。
|
||||
|
||||
### 连续
|
||||
|
||||
值是连续关系,即任意两个值之间可以计算差值。
|
||||
|
||||
### 离散
|
||||
|
||||
值是离散关系,即任意两个值之间无法计算差值,无法以连续的方式去理解。
|
||||
|
||||
**一般来说,维度字段都是离散的,度量字段都是连续的。**从字段类型意义上也能得出相同的结论:维度字段一般为字符串或日期类型,字符串类型都是离散的,度量字段一般为数字类型,数字天生就可以连续。
|
||||
|
||||
值得注意的是,连续与离散其实与字段类型、维度度量并无关系,比如维度的日期字段就是可连续的,而就算是字符串类型,也可以以字符串长度等方式 “定义” 一种连续的计算方式。对数字类型的度量字段来说,我们也可以忽略数字之间的联系,将数字看待为字符串,这样数字之间就是离散的。
|
||||
|
||||
**上图的 “离散方式看日期” 就是看维度的直观方式,但仍可以用 “连续方式看日期”:**
|
||||
|
||||
<img width=309 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566633194083-b17c1c2c-7023-47cd-a94c-48d57fd37217.png#align=left&display=inline&height=308&name=image.png&originHeight=616&originWidth=618&size=37644&status=done&width=309">
|
||||
|
||||
离散方式下单看维度只有一条条数据,数据间并无排序规则,而以连续方式看维度,维度就会以某种方式排序:比如上图以时间类型进行排序。此时展示方式也从表格切换为了柱状图,因为表格适合展示离散数据,柱状图的一根柱子就可以展示连续数据。
|
||||
|
||||
单看度量时,由于 **度量要依附于维度展示**,因此仅有度量时,只能看这个度量的 **聚合** 概念:
|
||||
|
||||
<img width=200 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566633468748-6ffb22b0-8c8d-4f6c-bdb6-a16616e29e70.png#align=left&display=inline&height=107&name=image.png&originHeight=214&originWidth=400&size=15238&status=done&width=200">
|
||||
|
||||
如上图所示,单看销量这个度量字段时,我们只能将数据集中所有销量字段聚合在一起来看,**但这种聚合方式也可以分成若干种计算类型 - 求和、平均值、中位数、计数、计数去重、最小值、最大值、方差等等:**
|
||||
|
||||
<img width=414 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566633611811-f0bef366-b9ca-47dd-adbc-4e2d311f52de.png#align=left&display=inline&height=502&name=image.png&originHeight=1004&originWidth=828&size=228956&status=done&width=414">
|
||||
|
||||
这些能力之间都是 “正交” 的,即单看度量这一个字段,可以以这么多种类型进行计算,那么按维度拆分后,度量依然可以享受如上不同的计算方式。
|
||||
|
||||
**也可以用连续方式看度量:**
|
||||
|
||||
<img width=184 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566633797820-b7980691-1be7-4644-a321-cac98cc36e5f.png#align=left&display=inline&height=304&name=image.png&originHeight=608&originWidth=368&size=23542&status=done&width=184">
|
||||
|
||||
与连续-维度不同,连续-度量图形中除了最后一个值,其他过渡数值都是无效的,因为连续-度量只有一个值。连续-维度也要注意,由于以连续的方式画出图形,中间不存在的点也被 “无缝连接” 了。
|
||||
|
||||
数据之间也可以存在父子级关系,有父子级关系就可以进行上卷下钻了,这种父子级关系被称为 “层系字段”:
|
||||
|
||||
<img width=209 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566634402929-9e23bff4-4810-4827-bf3b-c6af9ef617ea.png#align=left&display=inline&height=217&name=image.png&originHeight=434&originWidth=418&size=33356&status=done&width=209">
|
||||
|
||||
上图的 Orders 就是一个层系字段。层系字段是几个字段的排序组合,**由上到下依次构成下钻关系,从下到上则是上卷的关系。**
|
||||
|
||||
### 层系
|
||||
|
||||
**只有维度字段才能有层系,**因为度量是不能被拆分的,只有维度才可以被拆分。
|
||||
|
||||
维度的拆分可以是有逻辑含义的,也可以是任意的。
|
||||
|
||||
**有逻辑含义的层系**
|
||||
|
||||
最典型有逻辑含义的层系字段就是时间了。一个好的 BI 系统识别到日期字段后,应该将拿到的日期字段进行归类,比如判断日期字段粒度到天,则自动生成一个日期层系字段,自动聚合到年,并允许用户随意切换:
|
||||
|
||||
<img width=277 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566634723539-8f80cdd3-f8af-41a2-9e89-db94ecfa3200.png#align=left&display=inline&height=161&name=image.png&originHeight=322&originWidth=554&size=51469&status=done&width=277">
|
||||
|
||||
如果数据集字段值精确到月,则层系只能最多展开到月。
|
||||
|
||||
日期层系的逻辑含义在于,年、季度、月、天这种下钻关系是天然从大到小的关系,符合自然理解。
|
||||
|
||||
**任意层系**
|
||||
|
||||
如果层系字段不代表日期,就只能以业务含义组合层系字段了。**比如可以将层系按照 订单日期 -> 商品 ID -> 运货日期的方式组合:**
|
||||
|
||||
<img width=624 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566634964577-6dad1f7c-b01b-419a-8b7c-6e0832d6c8b6.png#align=left&display=inline&height=132&name=image.png&originHeight=308&originWidth=1454&size=41917&status=done&width=624">
|
||||
|
||||
这种下钻方式,可以看到每个订单日期下有哪些商品,每个商品分别运货日期是什么。
|
||||
|
||||
**也可以按照商品 ID 拆分出不同的订单日期与运货日期,这种层系组合方式就是以商品 ID 为主要视角:**
|
||||
|
||||
<img width=622 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566635114693-57a2b260-d7cc-4945-9050-361ce4608e09.png#align=left&display=inline&height=129&name=image.png&originHeight=302&originWidth=1456&size=44825&status=done&width=622">
|
||||
|
||||
可以看到,不同思维角度会按照不同的方式组合层系。比如一家大公司要查看财务问题,维度有:BU、日期,度量有:销量。
|
||||
|
||||
那么有两种下钻方式:BU -> 日期、日期 -> BU。无论哪种下钻方式,都能看到每个 BU 按日期销量的明细,但 BU -> 日期 能看到每个 BU 按日期聚合的总销量,而 日期 -> BU 能看到不同日期按 BU 聚合的总销量,前者更易对比出 BU 之间差异,后者更易对比出日期之间的差异。
|
||||
|
||||
## 理解配置
|
||||
|
||||
配置是探索式分析的入口,要理解分析模型首先得理解配置模型。
|
||||
|
||||
Table 主要配置分为行、列、标记与筛选。通过这四个配置区域可以组合成千变万化的数据洞察模型。既然如此,让我们看看这种配置思路是什么,以及为何这四种配置相互组合就能覆盖整个探索式分析场景?
|
||||
|
||||
我们不需要考虑三维数据分析场景,因为三维透视的关系,图形丢失了精确大小关系,没有精度的数据是没有分析价值的。由于在二位平面中分析数据,**大部分图表都可以用 “行、列” 方式进行配置**。
|
||||
|
||||
**也许有人会问,为什么不用维度与度量替代行列呢**?这是一个很好的问题,有数据分析经验的人会站在维度与度量角度思考问题,因此对于任意图表,只要配置维度、度量即可呀?笔者从三个方面说说自己的理解:
|
||||
|
||||
1. 探索式分析思路中,不关心图表是什么,也不关心图表如何展示,因此图表是千变万化的,比如折线图可以横过来,条形图也可以变成柱状图,因此 **你将维度放到列,就是一个柱状图,你将维度放到行,就是一个条形图** 。
|
||||
2. 将精力真正放到你要拖拽的字段上。由于字段已经有维度、度量的区别,配置区域就不要再限定维度与度量了,减少理解成本。
|
||||
3. 维度与度量可以同时放在行或列上,这是探索式分析的另一个精髓能力,看下图:
|
||||
|
||||
<img width=306 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566636365926-c5d37423-0e32-4382-ae7d-2b9760caeb97.png#align=left&display=inline&height=435&name=image.png&originHeight=1240&originWidth=872&size=94620&status=done&width=306">
|
||||
|
||||
做探索式分析功能时,要跳出思维定式:**为什么条形图的纵轴不能放维度呢?**如上图所示,如果行拖拽了两个不同的度量,那么可以出现两条线或者双轴图,但当拖拽一个维度一个度量时,可以对图表进行 **分面** ,比如观察 2013 ~ 2016 年不同顾客对销量的贡献。
|
||||
|
||||
### 行
|
||||
|
||||
表格类的行、图表类的纵轴。一般建议放置度量字段。
|
||||
|
||||
### 列
|
||||
|
||||
表格类的列、图表类的横轴。一般建议放置维度字段。
|
||||
|
||||
如上所示,无论行还是列,都可以进行任意维度度量组合,且字段数量不限,而且可以在任何层级进行下钻。**对图表来说,多个维度时需要进行分面处理:**
|
||||
|
||||
<img width=476 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566637370597-d52b7677-9ec4-40f3-aa54-a0382ac56de1.png#align=left&display=inline&height=428&name=image.png&originHeight=1448&originWidth=1612&size=106528&status=done&width=476">
|
||||
|
||||
如上图所示,将列放置两个维度字段成为柱状图,那么横轴就要同时表示两个维度,如上图所示。如果横轴还有更多的维度,可以再不断对横轴进行拆分。
|
||||
|
||||
横轴(列)多维度字段的顺序也会影响图表的展现。**上图最后一个字段是 Category 默认是离散的,所以这个离值就决定了图表使用柱状图,图表类型由维度周最后一个字段连续或离散决定。**
|
||||
|
||||
比如我们对调 Order Date 与 Category 会怎样?
|
||||
|
||||
<img width=476 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566637657990-0387a37c-f4dc-45ca-a53a-aa10b4573318.png#align=left&display=inline&height=420&name=image.png&originHeight=1456&originWidth=1620&size=137950&status=done&width=467">
|
||||
|
||||
我们得到了三个不同类目近 12 个月的趋势,之所以是折线图,因为图表的维度轴(列)是连续的。**如果我们对 Order Date 进行天级别的下钻:**
|
||||
|
||||
<img width=462 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566637772126-a9825860-4851-41ae-a56d-df984ea49b4c.png#align=left&display=inline&height=328&name=image.png&originHeight=1462&originWidth=2062&size=128020&status=done&width=462">
|
||||
|
||||
可以看到,**下钻功能本质上就是维度轴支持对多个维度字段拆分处理。只要图表支持了维度轴任意维度字段的分面展示,那么配置端就可以将下钻按照拖了多个字段的方式去理解了。**
|
||||
|
||||
**如果我们将折线图切换为表格,会发生什么?**
|
||||
|
||||
<img width=578 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566637986444-1a78b31f-6bb6-4c3e-b69b-0bd5a32c399f.png#align=left&display=inline&height=211&name=image.png&originHeight=738&originWidth=2018&size=111516&status=done&width=578">
|
||||
|
||||
我们会发现,原本存在于列的 Category 被自动挪到了行,原本存在于行的 Sales 被挪到了 “标记” 区域。在正式介绍 “标记” 区域前,先理解一下为何会发生这种转变:
|
||||
|
||||
**表格类组件是双维度组件,折线图是单维度组件。** 也就是表格的行与列都是维度,而折线图横轴作为维度后,纵轴就要作为度量。上面的例子中,折线图维度有两个字段,虽然通过分面方式渲染出来了,但当切换为支持双维度的表格后, **可以将多余的一个维度挪到表格组件另一个维度区域中**。
|
||||
|
||||
而表格行与列都是维度的情况下,单元格的值就需要用 “标记” 中文本来表示,因此原折线图的度量字段自动转移到了 “标记” 区域。
|
||||
|
||||
### 标记
|
||||
|
||||
标记区域也采取字段拖拽的方式,即对字段进行标记。
|
||||
|
||||
标记区域分为 **颜色、大小、标签、详细信息、工具提示、路径。**标记正如其名,是作用于图表上的标记,**即不会对图表框架有实质性影响的辅助标记信息。**
|
||||
|
||||
对不同图表来说,影响最大的是行与列,它能决定用什么图表,如何拆分数据。而标记往往是改变图表中辅助性元素,比如文字或者颜色等等。
|
||||
|
||||
#### 工具提示
|
||||
|
||||
不影响任何图像显示,仅仅在提示信息中新增字段信息。
|
||||
|
||||
**对图表来说,指的是 Tooltip 提示信息增加对应的字段:**
|
||||
|
||||
<img width=424 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566655533184-4ea4560f-8fef-40aa-9910-c301842c53b4.png#align=left&display=inline&height=363&name=image.png&originHeight=1000&originWidth=1168&size=91870&status=done&width=424">
|
||||
|
||||
从上图可以看到,利润字段放在工具提示区域,则图表的 Tooltip 会新增利润这个字段的信息。**值得关注的是,Tableau 所有图表都支持 Tooltip 包括表格:**
|
||||
|
||||
<img width=623 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566655642537-e7a18aa6-f619-45c4-b2b3-f95274d40107.png#align=left&display=inline&height=157&name=image.png&originHeight=374&originWidth=1480&size=42938&status=done&width=623">
|
||||
|
||||
这保证了配置统一,行为统一。
|
||||
|
||||
#### 大小
|
||||
|
||||
控制图表大小。
|
||||
|
||||
对于线图,控制线的粗细;对于气泡图控制气泡大小;对于柱状图控制柱子粗细;但是对面积图与表格没有明显作用。这得益于 Tableau 将每个图表大小属性尽可能抽象出来。
|
||||
|
||||
<img width=360 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566655966495-9241a848-b8c0-48b7-b0a4-8fbcc44ff58c.png#align=left&display=inline&height=273&name=image.png&originHeight=748&originWidth=988&size=58386&status=done&width=360">
|
||||
|
||||
<img width=360 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566656245320-7f29da9d-363f-4fd3-95f3-15b0ec2a3522.png#align=left&display=inline&height=223&name=image.png&originHeight=982&originWidth=1602&size=99303&status=done&width=364">
|
||||
|
||||
#### 文本
|
||||
|
||||
即直接展示在图表上的文本。
|
||||
|
||||
对普通图表来说,文本体现为 Label,即直接展示在图表上的文字。比如柱状图默认是没有 Label 文字的,要将对应字段拖拽到文本标记上才会出现。
|
||||
|
||||
<img width=404 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566656520351-588602a5-db01-4e46-bfdd-6f771353d7a8.png#align=left&display=inline&height=379&name=image.png&originHeight=934&originWidth=996&size=77362&status=done&width=404">
|
||||
|
||||
这体现出与普通报表构思的不同。对普通报表来说,Label 是通过一个勾选项开启的,Label 对应的值就是图表度量这个字段的值。而 Tableau 将标签值以字段方式开放拖拽,就有了展示与值分开的可能性,可适用范围更广。
|
||||
|
||||
> 有人觉得长度和数字一定要对应上,这也是对数据理解不同导致的。Tableau 将文本(标签)列在标记里,说明文本和颜色、大小一样,都是一种附加的信息展示维度,很多时候不需要两种方式展示同一种信息,反而需要图形以更多方式以不同维度展示信息。
|
||||
|
||||
#### 颜色
|
||||
|
||||
控制图表的颜色。
|
||||
|
||||
比如在度量为销量时,可以将利润作为颜色,甚至再将折扣作为文本,通过一个折线图同时看多种度量信息:
|
||||
|
||||
<img width=386 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566656981186-8f2441d6-78d0-4d34-af7f-139b0f21cb30.png#align=left&display=inline&height=344&name=image.png&originHeight=888&originWidth=996&size=82343&status=done&width=386">
|
||||
|
||||
与之对比,我们可以将利润放在右 Y 轴作为双轴图达到相同的效果:
|
||||
|
||||
<img width=439 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566657023624-c01b0008-e7d7-4991-99c1-beddc8c72762.png#align=left&display=inline&height=319&name=image.png&originHeight=886&originWidth=1218&size=112190&status=done&width=439">
|
||||
|
||||
**标记就是为了在不增加行、列字段数量基础上,通过颜色、大小、标签、工具提示等维度展示出额外信息。**
|
||||
|
||||
#### 详细信息
|
||||
|
||||
如果将度量拖拽到详细信息,会发现完全没有作用。因为 “详细信息” 只有拖拽维度字段才生效。“详细信息” 其实是用作下钻的,拖拽一个维度字段后,可以按照这个维度进行下钻。
|
||||
|
||||
<img width=533 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566657906186-3348cdf7-823f-4111-9685-dbf5fb05c0f8.png#align=left&display=inline&height=376&name=image.png&originHeight=1054&originWidth=1496&size=102786&status=done&width=533">
|
||||
|
||||
如上图所示,将销售按照产品线拆解成三条线。但这三条线无法分辨,因此可以使用颜色来拆分维度:
|
||||
|
||||
<img width=533 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566657988073-e8e50316-feb2-4c7f-98dc-45f4a2ffd624.png#align=left&display=inline&height=372&name=image.png&originHeight=1052&originWidth=1510&size=112469&status=done&width=534">
|
||||
|
||||
这样就能将拆解的内容按不同颜色展示。因此, **对标记作用的字段如果是维度字段,且作用于颜色、大小、标签、详细信息时,会额外进行维度进行拆解,并对拆解后的内容进行颜色或大小区分。**
|
||||
|
||||
相信读到这里会有个疑问:按照维度进行拆解与维度拖拽多个字段进行字段有什么区别?我们试一下看看效果,将产品类目维度拖拽到销量所在的行,对销量进行销量维度的拆分:
|
||||
|
||||
<img width=570 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566658461645-fbcc1b14-0111-47b1-b643-d23f36f96ef2.png#align=left&display=inline&height=512&name=image.png&originHeight=1058&originWidth=1178&size=92443&status=done&width=570">
|
||||
|
||||
**可以看到,在行、列进行的多维度拆分使用的是分面策略,而在标记中对维度进行拆分使用的是单图表多轴方式来实现。**
|
||||
|
||||
除此之外的区别在于,在标记进行的维度拆分默认作用于度量,而行列上的多维度拆分可以任意作用于维度或度量。
|
||||
|
||||
> 同时配置端要限制 **能拆分的只有维度或离散状态的度量** ,也就是只有离散状态的字段可以被拆分。如上图所示,我们不能将 Category 拖拽到 Sales 右侧,除非将 Sales 设置为离散类型。
|
||||
> Tips:Tables 对维度与度量分别分配了蓝色、绿色,当我们将绿色度量字段设置为离散类型时,这个度量字段会变成蓝色,也就是当作了维度字段进行处理。
|
||||
|
||||
最后,标记区域不仅能拖拽字段,还可以单击后修改详细配置,比如修改颜色详细配置:
|
||||
|
||||
<img width=220 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566658916573-5c989763-bd8f-4f2d-8f57-9f52b9c39b20.png#align=left&display=inline&height=448&name=image.png&originHeight=896&originWidth=442&size=39310&status=done&width=221">
|
||||
|
||||
或者对工具提示的 Tooltip 内容进行定制:
|
||||
|
||||
<img width=557 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566658941101-e4eac6aa-d4f1-4397-9be2-ccc424211f00.png#align=left&display=inline&height=319&name=image.png&originHeight=910&originWidth=1590&size=207889&status=done&width=557">
|
||||
|
||||
### 筛选器
|
||||
|
||||
Tableau 将所有筛选条件都收敛到筛选器中,我们可以通过拖拽字段的方式对某个字段进行筛选:
|
||||
|
||||
<img width=635 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566659069046-3e4f195e-1c9d-492d-bfe7-6f6d89997692.png#align=left&display=inline&height=210&name=image.png&originHeight=494&originWidth=1494&size=138806&status=done&width=635">
|
||||
|
||||
如上图所示,比如只看办公用品与科技产品。但其实除了这个通用功能之外,Tableau 还支持更强大的图表交互功能,即点击或圈选图表后,可以对选中的点(字段值)进行保留或排除:
|
||||
|
||||
<img width=606 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566659178209-134b5fc5-b067-4481-bf99-ed36c8c458c7.png#align=left&display=inline&height=198&name=image.png&originHeight=442&originWidth=1350&size=55242&status=done&width=606">
|
||||
|
||||
**当我们选择排除这几个点时,会自动生成一份对维度字段的筛选条件排除掉选中日期,所以图表是完全数据驱动的:** 一般来说
|
||||
|
||||
<img wdith=576 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566659259441-22ef9da8-e3bc-4cef-b32e-c538c1dfe3e0.png#align=left&display=inline&height=268&name=image.png&originHeight=696&originWidth=1494&size=189252&status=done&width=576">
|
||||
|
||||
如果属性存在下钻关系会如何呢?无论是行列中对维度的下钻,还是通过标记对维度进行了拆解,筛选都是对 **字段层系** 生效的:
|
||||
|
||||
<img width=575 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566659420072-3e6e41f4-bc99-4d7d-a93f-553abe429a94.png#align=left&display=inline&height=169&name=image.png&originHeight=442&originWidth=1504&size=155974&status=done&width=575">
|
||||
|
||||
如上图所示,对下钻后的字段进行筛选,**那么筛选条件也会自动构造出临时的字段层系,并对这个临时层系进行筛选。** 可以看到,我们不仅能在字段配置区动态组成层系字段,在筛选器中也可以生成临时层系进行筛选,我们需要支持任意层系组合的字段,并作用于筛选器、行列,甚至是标记上。
|
||||
|
||||
顺带一提,我们还可以对设置了筛选的字段层系组合拖拽到任意地方使用:
|
||||
|
||||
<img width=393 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566659649713-3428813a-d156-4c80-935f-e40de333a8fe.png#align=left&display=inline&height=434&name=image.png&originHeight=1050&originWidth=950&size=88795&status=done&width=393">
|
||||
|
||||
要处理这种场景,**我们需要让所有字段都拥有筛选能力**,普通字段等于没有筛选条件,我们也可以对一个包含了筛选条件的字段拖拽到任何位置作用。
|
||||
|
||||
刚才是对维度进行的筛选,有没有对度量进行筛选的场景呢?有,但我们只能手动将度量字段拖拽到筛选器位置进行手动筛选:
|
||||
|
||||
<img width=613 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566659919516-77548c29-7c02-4857-9eec-fb1465826f9a.png#align=left&display=inline&height=312&name=image.png&originHeight=832&originWidth=1636&size=86512&status=done&width=613">
|
||||
|
||||
如果我们进行图表内的圈选操作,增加的筛选条件一定是按维度来的:
|
||||
|
||||
<img width=613 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566659955376-66830503-bce1-443d-ab98-9fbc90e54fdb.png#align=left&display=inline&height=273&name=image.png&originHeight=756&originWidth=1694&size=80004&status=done&width=612">
|
||||
|
||||
这么理解这一行为:维度是离散的,勾选操作能表达的含义有限,比如勾选折线图的某些点,如何知道我们要勾选的是维度的那几个月,还是度量的利润范围呢?
|
||||
|
||||
<img width=613 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566660078571-ecf7c466-44c1-46a5-9ef0-d3692bf22fb8.png#align=left&display=inline&height=555&name=image.png&originHeight=1468&originWidth=1620&size=113222&status=done&width=613">
|
||||
|
||||
**由于最终勾选操作落地在点上,而不是区间上(连续值也不适合进行圈选),所以默认按对维度进行筛选是最准确的理解。**如果上图的操作意图中,你想勾选的不是 6~12 月的区间,而是销量在 13k ~ 45.5k,则需要手动拖拽利润字段,并精确输入筛选范围:
|
||||
|
||||
<img width=482 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566660226577-102ca29f-b6ef-43a7-860a-041b04274da8.png#align=left&display=inline&height=353&name=image.png&originHeight=774&originWidth=1056&size=81734&status=done&width=482">
|
||||
|
||||
值得注意的是,对连续型度量进行筛选前,还可选择聚合方式:比如对求和的值进行范围筛选,或者对最大值进行范围筛选,功能十分强大。
|
||||
|
||||
## 理解图表
|
||||
|
||||
图表是数据可视化的载体,只有数据与配置,没有各式各样的图表,很难产生直观的数据洞察。
|
||||
|
||||
可以说, **按照探索式分析的思路,当配置好数据与配置后,可以有多种可视化载体去展示这种配置信息。** 比如行、列分别拖拽了日期与销量,那么折线图、表格、散点图、柱状图都可以满足需求,但如果行所在的字段是离散的,那么折线图、散点图就不适合了,这就需要图表推荐功能根据配置推荐合适的图形展示。
|
||||
|
||||
Tableau 内置的图表分为 N 大类 - **表格、地图、柱折面饼、散点/象限图** 、以及直方图、盒须图、甘特图、靶心图等。可见分析数据,不需要太多种类可视化展现方式,但对于每个图表组件来说,都需要修炼深厚的内功,做好一个表格、折线图并不简单。
|
||||
|
||||
### 行与列
|
||||
|
||||
表格、地图、柱折面饼、散点/象限图等都可以用行与列描述基本架构:
|
||||
|
||||
- 表格天然拥有行与列,对调后则代表转置。表格的行与列必须是维度字段,如果拖拽度量字段上去会自动切换为其他图表,再切回来则会把度量字段挪动到 “文本” 标记区域中。
|
||||
- 地图行与列就是经纬度,当维度字段放到 “详细信息” 时,根据地理映射表转化为经纬度自动生成经纬度放在行与列。
|
||||
- 柱折面饼、散点/象限图都是直角坐标系的图形,以维度字段作为维度轴,以度量字段作为度量轴。
|
||||
|
||||
#### 行列的下钻
|
||||
|
||||
在行或列存在多个维度字段时,图表要进行相应下钻。表格对于行下钻如下图所示:
|
||||
|
||||
<img width=529 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566699040802-40a23a43-7a23-43d1-9d06-27a6413803e8.png#align=left&display=inline&height=314&name=image.png&originHeight=856&originWidth=1440&size=106220&status=done&width=529">
|
||||
|
||||
**上图也可以理解为展示出 Order Date 与 Order ID 的明细数据,按照 Order Date 分组且列合并。** 下钻就是一步步接近明细数据的过程,但目的不是为了看明细表,而是看某些维度下按其他维度拆分的详细信息。
|
||||
|
||||
图表下钻和表格思路是一致的:
|
||||
|
||||
<img width=529 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566699822756-b087948b-3104-4bd4-a76b-1cb2067edd65.png#align=left&display=inline&height=335&name=image.png&originHeight=1338&originWidth=2114&size=109757&status=done&width=529">
|
||||
|
||||
对于维度轴多维度下钻,将每个维度轴下钻到更细粒度。图表在行与列同时下钻时,与表格的表现稍有不同。仅从轴来看拆解方式是相同的,内部展示了多套轴:
|
||||
|
||||
<img width=667 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566700041429-03bcb68a-dd00-4cab-a256-f37234bb2300.png#align=left&display=inline&height=423&name=image.png&originHeight=1350&originWidth=2128&size=155697&status=done&width=667">
|
||||
|
||||
**可以认为,当行或列上最后一个字段为度量时,就会切换为图表展示,因为图表适合展示连续状态。** 如果排除上图蓝色区域,剩下的区域就是个交叉表,交叉表只是行与列同时存在维度字段的场景,仅有行或列时就变成了普通表格;而图形的下钻和表格下钻机理相同,只是把 “单元格” 的文本换成了柱子或线。
|
||||
|
||||
**所以对任何图表的下钻,都是对轴的下钻,** 相同的是单元格属性永远不会改变,表格的单元格是文本,图形单元格是图形,一个简单折线图可以理解为对整体行与列单元格进行 “连续打通”:
|
||||
|
||||
<img width=406 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566700448492-a7b96c99-b600-41b0-9159-e88412f4402b.png#align=left&display=inline&height=329&name=image.png&originHeight=1342&originWidth=1654&size=105794&status=done&width=406">
|
||||
|
||||
如果继续对行列添加维度进行下钻,其实是对轴进行下钻。**排除度量字段不看,就是一个交叉表的下钻过程,如下图所示蓝色框圈住的部分就是一组大的单元格**:
|
||||
|
||||
<img width=629 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566700520147-c644eae8-8c04-4c7d-82aa-b5e4e1c2e4d8.png#align=left&display=inline&height=467&name=image.png&originHeight=1340&originWidth=1806&size=163645&status=done&width=629">
|
||||
|
||||
由于最后一个字段是度量,因此在叶子结点的展开就不是表格模式的单元格,而是连续的线条了。
|
||||
|
||||
经过上面的总结,我们要意识到,在探索式分析场景对行列的下钻,表格与图表的逻辑是通用的,实现时也要整体考虑。**将轴功能抽离成通用部分来做,表格与图表的区别只是对最后一个字段单元格是离散处理还是连续处理。**
|
||||
|
||||
#### 层系的下钻
|
||||
|
||||
<img width=528 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566699587535-dd5e11f6-6fd2-42ce-be2b-e01d7dee650a.png#align=left&display=inline&height=300&name=image.png&originHeight=818&originWidth=1438&size=102881&status=done&width=528">
|
||||
|
||||
层系字段下钻与拖多个字段表现一致,但由于存在父子关系,因此在图表上可以展现出 “展开” “收起” 按钮,点击后并不是对图表本身进行操作,而是发送一个事件对 “行” 进行操作,最后通过数据驱动完成展开或收起动作。
|
||||
|
||||
#### 不适合行列的图表
|
||||
|
||||
饼图就不适合行列,因为饼图是根据离散维度进行拆分,扇叶大小可以由一个度量字段决定,因此对饼图来说,行就对应到 “颜色”、列就对应到新增的 “角度” 这个标记:
|
||||
|
||||
<img width=336 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566704242607-bab5e722-d27c-4ad5-8518-b470fddbf9da.png#align=left&display=inline&height=279&name=image.png&originHeight=558&originWidth=672&size=50344&status=done&width=336">
|
||||
|
||||
#### 没有维度轴的图表
|
||||
|
||||
只有行配置的图形推荐用表格,但柱状图、折线图也可以支持这种情况,只要把横轴忽略即可:
|
||||
|
||||
<img width=300 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566706245345-61b365db-793a-4d15-9677-b4e332381bda.png#align=left&display=inline&height=312&name=image.png&originHeight=912&originWidth=878&size=53419&status=done&width=300">
|
||||
|
||||
从样式上来看没有横轴,其实这种情况是把所有维度的横轴都聚合后的表现。
|
||||
|
||||
### 连续与离散值
|
||||
|
||||
我们分别看看连续与离散作用于维度和度量时的区别。
|
||||
|
||||
#### 作用于度量
|
||||
|
||||
图表要能适配对连续或离散值的处理。比如对销量来说,如果切换为离散值,则当成字符串展示:
|
||||
|
||||
<img width=632 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566662092893-32545363-82da-498a-868f-18a59bb41c24.png#align=left&display=inline&height=141&name=image.png&originHeight=472&originWidth=2122&size=63869&status=done&width=632">
|
||||
|
||||
如果将销量切换为连续值,则单元格就要使用线条长度代表值的大小,**即连续性的值要能够产生 “对比感”:**
|
||||
|
||||
<img width=632 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566662072534-23177d9d-f32c-4aa2-bea4-8fef0ab6e3c2.png#align=left&display=inline&height=161&name=image.png&originHeight=534&originWidth=2106&size=58097&status=done&width=635">
|
||||
|
||||
上图组件是表格,本身适合展示离散值,但可以看到对连续值展示做了适配。对于适合展示连续值的图形,则无法做离散适配:
|
||||
|
||||
<img width=200 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566703397222-9da012d8-9d13-4378-9d5a-50903f3ba777.png#align=left&display=inline&height=253&name=image.png&originHeight=976&originWidth=772&size=48952&status=done&width=200">
|
||||
|
||||
比如这个柱状图,如果将销量切换为离散,则会自动切换到表格,因为对于双离散值用柱折面饼展示是无意义的。
|
||||
|
||||
#### 作用于维度
|
||||
|
||||
如上图所示,就是维度使用了离散字段的例子,由于维度是离散的,因此使用柱状图展示,因为柱子间也是隔离的。
|
||||
|
||||
**对于连续型字段作用于维度,默认适合散点图,因为散点图的行与列都是度量,适合作为默认推荐:**
|
||||
|
||||
<img width=283 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566703779092-ce78066e-75ec-4b89-9fc1-f44c135e5b5d.png#align=left&display=inline&height=312&name=image.png&originHeight=1154&originWidth=1048&size=66333&status=done&width=283">
|
||||
|
||||
但能用散点图的就也能用线图, **当维度是连续日期字段时,适合用折线图而不是散点图。**因为日期虽然连续,但 **本身不适合做比较** ,因此作为一种连续型维度展示比较合适;而散点图两个轴都适合连续型度量,因此不适合方日期这种连续型维度字段。
|
||||
|
||||
<img width=406 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566703754082-6ec2f472-ea42-4003-aab3-c07f47b8a340.png#align=left&display=inline&height=289&name=image.png&originHeight=1166&originWidth=1636&size=96183&status=done&width=406">
|
||||
|
||||
当然也具备将折线图随时切换为散点图的能力,但这种图形没有什么业务价值:
|
||||
|
||||
<img width=406 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566704003468-7ba3e545-9abf-470f-841d-44dd42e1f754.png#align=left&display=inline&height=292&name=image.png&originHeight=1178&originWidth=1654&size=97442&status=done&width=410">
|
||||
|
||||
因此我们对折线图进行标记:行适合连续型维度字段,对散点图进行标记:行列都适合连续型度量字段,就可以根据配置 **实现推荐图表的功能**。
|
||||
|
||||
### 标记
|
||||
|
||||
除了饼图支持 “角度”、线图支持 “路径” 这些特殊标记外,所有图表都支持下面五种通用标记:“工具提示”、“大小”、“文本”、“颜色”、“详细信息”。
|
||||
|
||||
**工具提示** 比较简单,所有图表都支持鼠标 Hover 后弹出 Tooltip 即可,并且这个 Tooltip 允许自定义和拓展工具提示字段。
|
||||
|
||||
**大小** 则只有折、柱、散三种图支持,因为这三种图分别有可以描述的大小的线条粗细、柱子宽度、圆圈半径。
|
||||
|
||||
**文本** 对应柱折面饼的 Label、对应表格,矩形树状图,地图的 **单元格内容。**
|
||||
|
||||
**颜色、详细信息** 则比较特殊,下面详细说明:
|
||||
|
||||
**拖拽已有字段到详细信息 - 没有任何效果:**
|
||||
|
||||
<img width=476 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566705683330-21e04dfb-41f7-45dc-92b8-69dab98bf009.png#align=left&display=inline&height=249&name=image.png&originHeight=740&originWidth=1416&size=73008&status=done&width=476">
|
||||
|
||||
因为本身就在看这个字段的详细信息,因此没有效果。
|
||||
|
||||
**但如果拖拽已有字段到颜色,则可以根据数值大小或分类进行按颜色区分:**
|
||||
|
||||
<img width=479 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566705734424-b2bc735d-35fa-4cf9-8b67-e24e3dccd0f5.png#align=left&display=inline&height=250&name=image.png&originHeight=736&originWidth=1412&size=76772&status=done&width=479">
|
||||
|
||||
等于开启了图表筛选功能,当颜色筛选条件字段是连续型时,出现筛选滑块,**是离散型时,出现图例:**
|
||||
|
||||
<img wdith=479 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566705795546-6a5e79b7-b32a-4c37-90bc-43926a3a6283.png#align=left&display=inline&height=245&name=image.png&originHeight=720&originWidth=1408&size=80186&status=done&width=480">
|
||||
|
||||
**如果拖拽字段不存在于行和列上,对于度量字段,会根据值进行颜色排序(度量拖拽到详细信息依然没有效果):**
|
||||
|
||||
<img width=479 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566705874311-ebc4ec5d-021f-4601-9f8d-d5becfa9b1ce.png#align=left&display=inline&height=244&name=image.png&originHeight=720&originWidth=1422&size=79431&status=done&width=482">
|
||||
|
||||
如上图所示,我们可以从长度看利润,从颜色深度看销量。
|
||||
|
||||
**如果拖拽字段不存在于行和列上,且是维度字段,则会先进行维度拆分,之后如果选择的是 “颜色” 标记区域,还会对同一组的拆分标记颜色区分。**
|
||||
|
||||
**由于标记区域对维度的拆分是不分行于列的,因此每个图表会根据自身情况进行合适的拆分。**
|
||||
|
||||
比如条形图如果按某个新维度拆分,则会采取 “堆积柱状图” 的策略:
|
||||
|
||||
<img width=471 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566706116218-919d2ce7-3fb2-4a32-8624-a3f6cb3122fb.png#align=left&display=inline&height=327&name=image.png&originHeight=986&originWidth=1422&size=117354&status=done&width=471">
|
||||
|
||||
如果是折线图,则会采取 “多条线” 的策略:
|
||||
|
||||
<img width=471 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566706404581-01866c81-0553-4245-9b56-176bc5708bfe.png#align=left&display=inline&height=319&name=image.png&originHeight=960&originWidth=1416&size=127313&status=done&width=471">
|
||||
|
||||
如果是散点图,只要将拆分后多出来的点打散出来即可。由于散点图的维度拆分不像折线图和柱状图可以分段,因此如果不采用按颜色打散,是无法分辨分组的:
|
||||
|
||||
<img width=471 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566706443331-c817102a-5134-493f-bddf-04fc73f9548f.png#align=left&display=inline&height=319&name=image.png&originHeight=958&originWidth=1414&size=107140&status=done&width=471">
|
||||
|
||||
之所以说探索式分析的复杂度很高,是因为其可能性公式为:
|
||||
|
||||
**字段 x 离散连续 x 行列 x 行列下钻 x 标记种类 x 筛选 x 图表**
|
||||
|
||||
这种组合的笛卡尔积几乎是无穷无尽的。
|
||||
|
||||
### 轴交互
|
||||
|
||||
图表一些特定功能是隐藏在轴交互里的。拿折线图来说,一共有 5 个拖拽交互位置,如下图所示:
|
||||
|
||||
<img width=439 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566706982072-996f5f6e-b922-40ec-8066-761857fb2e30.png#align=left&display=inline&height=354&name=image.png&originHeight=1324&originWidth=1642&size=100488&status=done&width=439">
|
||||
|
||||
一般这些区域是用来拖拽度量字段的,所以如果拖拽了维度字段过来,最终会被归类到行列或标记上。
|
||||
|
||||
#### 拖拽维度
|
||||
|
||||
**维度拖拽到底部 1 区域等于替换列字段** :
|
||||
|
||||
<img width=195 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566707169109-6e38483a-123a-4064-81ff-fd0ed82010ed.png#align=left&display=inline&height=344&name=image.png&originHeight=1010&originWidth=572&size=44840&status=done&width=195">
|
||||
|
||||
**维度拖拽到图表中 4 区域等于拖到了颜色标记** :
|
||||
|
||||
<img width=387 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566707229005-d6ed84f8-8639-4dc6-96b0-ae2bebe70dc0.png#align=left&display=inline&height=331&name=image.png&originHeight=974&originWidth=1138&size=111933&status=done&width=387">
|
||||
|
||||
**维度拖拽到左侧 3 区域等于对行进行下钻:**
|
||||
|
||||
<img width=406 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566707279972-a22eb90b-2ebc-4727-911c-10c1d329a06c.png#align=left&display=inline&height=285&name=image.png&originHeight=1012&originWidth=1444&size=106415&status=done&width=406">
|
||||
|
||||
同理拖拽到最上面区域等于对列进行下钻。
|
||||
|
||||
#### 拖拽度量
|
||||
|
||||
让我们看看拖拽度量时的情况。度量能拖拽的范围更多。**比如拖拽到右轴 5 区域,则形成了双轴图:**
|
||||
|
||||
<img width=447 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566707391460-e528c513-bc22-4b02-9717-e9339b83d419.png#align=left&display=inline&height=360&name=image.png&originHeight=994&originWidth=1234&size=120248&status=done&width=447">
|
||||
|
||||
**拖拽到左侧 2 区域则表示在图中额外增加一个轴:**
|
||||
|
||||
<img width=571 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566707459746-8af4aa6e-acf4-4600-8fce-32c5fbe3400c.png#align=left&display=inline&height=333&name=image.png&originHeight=1020&originWidth=1748&size=126450&status=done&width=571">
|
||||
|
||||
要注意的是,上图的行显示 “度量值”,这是个特殊的字段,并通过筛选器筛选出拖拽的两个字段 Profit 和 Sales。除了拖拽以外,还可以通过将左侧 “度量值” 字段直接拖入行实现:
|
||||
|
||||
<img width=579 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566707593546-3670ea98-6e42-4fd2-8438-402c42c318d6.png#align=left&display=inline&height=275&name=image.png&originHeight=1042&originWidth=2190&size=243455&status=done&width=579">
|
||||
|
||||
如上图所示,将度量值放到行,并按度量名称进行颜色标记,就得到了拖拽度量到左侧 2 区域的效果。 **这也说明了所有图表交互最终都是通过映射到配置完成,所有能拖拽的操作都可以通过配置配出来** 。
|
||||
|
||||
对表格来说,能拖拽的区域是行、列、单元格:
|
||||
|
||||
<img width=521 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566707733747-55ea9f8c-d2c2-4766-b7b1-57d7abb351d2.png#align=left&display=inline&height=132&name=image.png&originHeight=358&originWidth=1416&size=29996&status=done&width=521">
|
||||
|
||||
拖拽到行或列于拖拽到字段配置区域的行或列没有区别,拖拽到单元格等于拖拽到文本标记区域。通过图表于配置区域结合的方式,即便不完全理解配置的人也可以通过将字段拖拽到图表上得到直观的操作感。
|
||||
|
||||
### 点击、圈选交互
|
||||
|
||||
所有图表都支持点击、圈选的方式选中 “点”。对表格来说,点就是单元格:
|
||||
|
||||
<img width=505 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566707894327-f5b88abb-d84e-4839-9c48-5fbbc9ccd929.png#align=left&display=inline&height=128&name=image.png&originHeight=356&originWidth=1408&size=42932&status=done&width=505">
|
||||
|
||||
对柱状图来说,点就是柱子:
|
||||
|
||||
<img width=307 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566707923552-680d890f-bc57-4692-b29e-ae787522bfb6.png#align=left&display=inline&height=268&name=image.png&originHeight=972&originWidth=1114&size=85024&status=done&width=307">
|
||||
|
||||
|
||||
对折线图来说,点就是节点:
|
||||
|
||||
<img width=427 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566707968058-fd8a598a-48fe-45c8-99f9-94c09f686435.png#align=left&display=inline&height=189&name=image.png&originHeight=640&originWidth=1428&size=59096&status=done&width=421">
|
||||
|
||||
对饼图来说,点就是扇叶:
|
||||
|
||||
<img width=374 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566707997384-1f1e4755-0863-48de-8abc-f56ae9feaad1.png#align=left&display=inline&height=169&name=image.png&originHeight=338&originWidth=748&size=26955&status=done&width=374">
|
||||
|
||||
所有的点被选中后都有基本高亮功能,最重要的是能对选中的点进行保留、排除、局部排序等等。
|
||||
|
||||
**比如我们可以对上图饼图选中的几个扇形区域进行从小到大排序:**
|
||||
|
||||
<img width=316 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566708115948-0dc7a73e-97bd-4099-b8bc-12dc16f56501.png#align=left&display=inline&height=243&name=image.png&originHeight=568&originWidth=740&size=48022&status=done&width=316">
|
||||
|
||||
我们也可以排除某些点,这个在配置章节有提到过,这个操作最终将转化为新增筛选条件:
|
||||
|
||||
<img width=283 src="https://cdn.nlark.com/yuque/0/2019/png/201572/1566708205782-b74a2d1f-8141-4a05-bea4-8824240a5e67.png#align=left&display=inline&height=280&name=image.png&originHeight=658&originWidth=666&size=52520&status=done&width=283">
|
||||
|
||||
最后,选中状态在单图表中看似只有高亮效果,但是在多图表联动时,高亮的选中区域会组成一个临时的筛选条件,作用于所有相同数据集的图表,并对这些图表的筛选结果做高亮处理。
|
||||
|
||||
# 3. 总结
|
||||
|
||||
理解了探索模型对数据、配置、图表的理解,就能学会探索式思维分析数据,对制作探索式 BI 也有借鉴意义。
|
||||
|
||||
> 讨论地址是:[精读《Tableau 探索式模型》 · Issue #199 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/199)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,111 @@
|
||||
> 作者:五灵
|
||||
|
||||
本周工作中遇到类似颜色主题的问题,在查资料的时候,看到这个视频,觉得讲得很清楚,而且趣味性丰富,所以想拿出来讲讲这个很有意思的主题。
|
||||
|
||||
视频链接: [CSSconf EU 2018 | Dag-Inge Aas & Ida Aalen: Generating Colors with JS and CSS Custom Properties](https://www.youtube.com/watch?v=zi6L0ZqrKfA)
|
||||
|
||||
## 1. 精读
|
||||
|
||||
### CSS 变量
|
||||
|
||||
CSS 变量及 CSS Variables(Custom Properties),目前几乎都已经被主流浏览器所支持,但是估计还有一部分读者不熟悉这个功能,简单列举一下使用方法:
|
||||
|
||||
```css
|
||||
:root {
|
||||
--bg-color: brown; // 定义颜色变量
|
||||
}
|
||||
.btn {
|
||||
// 直接使用颜色预定义的颜色变量
|
||||
background-color: var(--bg-color);
|
||||
}
|
||||
```
|
||||
|
||||
### Web 内容无障碍指南的对比度
|
||||
|
||||
Web 内容无障碍指南的对比度指的是 W3C 组织发布的 [《Web Content Accessibility Guidelines (WCAG)》](https://www.w3.org/TR/WCAG/#glossary),这个指南中涵盖了让 Web 内容更易于访问的各种建议,其中针对网页的颜色对比度发布了规范。
|
||||
|
||||
在 Chrome 中对于颜色编辑的时候,打开颜色选择器也会看到当前颜色的对比度值(Contrast ratio)。
|
||||
|
||||
|
||||
|
||||
网页颜色的对比度值在 1:1 到 21:1 之间,文本和图像文本的的对比度最小值为 4.5:1,也就是说低于这个值得对比度都不符合标准。 我们看一下列举的几种颜色对比度,对比度越高,也越有利于阅读。对比度越低,对于一些存在视力障碍或色觉缺陷的用户,可能就无法阅读。
|
||||
|
||||
|
||||
|
||||
### 演讲中的颜色解决方案
|
||||
|
||||
演讲在最开始首先讲了挪威的一个法律,不符合 Web 内容无障碍指南的站点在挪威是非法的,所以挪威的 Web 开发者非常注重站点的内容无障碍。
|
||||
|
||||
首先讲了使用 css 变量的方式,支持各种颜色主题的切换。 利用 js 去设置颜色变量,支持主题的颜色切换。
|
||||
|
||||
但是紧接着就提出了问题,如果用户可以随意切换颜色主题背景色,那一些按钮的文字可读性如何去保障呢?如果用户选择了与按钮颜色想接近的背景色,我们又该怎么处理了,紧接着这个演讲给出了根据明度决定按钮文字颜色是黑色还是白色的方案。
|
||||
|
||||
- 根据明度决定是黑色还是白色
|
||||
|
||||
具体代码如下,大致原理是把彩色转为灰度的颜色,有一个著名的心理学公式:`Gray = R*0.299 + G*0.587 + B*0.114`,然后在根据颜色灰度决定使用黑色的主题还是白色的主题。
|
||||
|
||||
```javascript
|
||||
if (red*0.299 + green*0.587 + blue*0.114) > 186 use #000000 else use #ffffff
|
||||
```
|
||||
|
||||
|
||||
|
||||
可读性的问题解决了,但是紧接着又遇到了一个问题,如果用户选取的颜色很浅呢,与背景颜色的对比度小于 4.5,该怎么处理呢。
|
||||
|
||||
|
||||
|
||||
- 寻找对比度更强的颜色,增强可读性
|
||||
|
||||
演讲中给出的解决方法是不断的加深当前用户选择的颜色,循环获取到对比度最高的同色系颜色。代码如下:
|
||||
|
||||
|
||||
|
||||
获取了一个更深的颜色后,通过给按钮加一个外边框的方式,优化整体的可读性。
|
||||
|
||||

|
||||
|
||||
文章最后还介绍了,通过给定一个主题色,获取第二第三主题色的方式,通过将颜色放到 HSL 的颜色轮上,转动 hue 的值 60 度,得到一个新的第二主题色。不过演讲者也没有说清楚为什么要这么做,只是说了这么做是出于经验,觉得这样能够得到一个恰当的主题色盘。
|
||||
|
||||
### 衍生的纯 css 解决方案
|
||||
|
||||
演讲中提供颜色变更的解决方案基本都是基于 JS 计算的,后来有人在 [css-tricks](https://css-tricks.com/switch-font-color-for-different-backgrounds-with-css/) 抛出一篇文章说,这个功能基于 css 就可以完全实现,其实关于颜色的原理都是一致的,只是觉得这个实现更加 magic,但是功能都能够完全满足。比如这篇文章中,关于根据明度决定按钮文字是黑色还是白色的代码如下:
|
||||
|
||||
```css
|
||||
:root {
|
||||
--light: 80;
|
||||
/* 文字颜色变化的临界值 */
|
||||
--threshold: 60;
|
||||
}
|
||||
.btn {
|
||||
/* 会被解析成黑色或者白色 */
|
||||
--switch: calc((var(--light) - var(--threshold)) * -100%);
|
||||
color: hsl(0, 0%, var(--switch));
|
||||
}
|
||||
```
|
||||
|
||||
### 可视化图表对于颜色的应用
|
||||
|
||||
在可视化图表当中,对于颜色的应用要比 Web 要谨慎的多。我们在做 Web 开发的时候,也不妨来看一下可视化图表当中对于颜色应用的一些规范。在可视化图表中,选择的颜色不可以过于随意,每次颜色的变更都是图表信息的改变,都为图表增加了新的数据,图表的每一种颜色也是要表达的信息。列举一些图表中的颜色使用规范,比如:
|
||||
|
||||
1. 不建议使用多种颜色表达同种数据
|
||||
2. 在多条行图表中,不要使用不同的颜色或颜色轮中对立面的颜色。颜色对比过强会使读者无法专心于数据。
|
||||
3. 一般而言,应避免颜色的主体性表现,避免使用具有特殊意义的颜色。比如使用红色和绿色表示销售额的变化。
|
||||
|
||||
当然对于可视化图表来说,并不是遵循了一些色彩使用的准则,就可以得到一个优雅呈现的可视化图表。注重图表呈现的最重要的视觉元素,在视觉信息角度减少用户,减少用户视觉疲劳也很重要。
|
||||
|
||||
## 3. 相关链接
|
||||
|
||||
CSS 前景背景自动配色技术简介: [https://www.zhangxinxu.com/wordpress/2018/11/css-background-color-font-auto-match/](https://www.zhangxinxu.com/wordpress/2018/11/css-background-color-font-auto-match/)<br />
|
||||
纯 css 解决方案:[https://css-tricks.com/switch-font-color-for-different-backgrounds-with-css/](https://css-tricks.com/switch-font-color-for-different-backgrounds-with-css/)<br />
|
||||
获取颜色的 Demo: [https://confrere.com/a11y/test/](https://confrere.com/a11y/test/)<br />
|
||||
颜色色盘推荐的文章:[https://blog.graphiq.com/finding-the-right-color-palettes-for-data-visualizations-fcd4e707a283](https://blog.graphiq.com/finding-the-right-color-palettes-for-data-visualizations-fcd4e707a283)
|
||||
|
||||
> 讨论地址是:[精读《使用 css 变量生成颜色主题》 · Issue #203 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/203)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,79 @@
|
||||
> 作者:五灵
|
||||
|
||||
## 简介
|
||||
|
||||
其实关于前端深水区的讨论,已经有了很多,也有了很多相关的文章。我也想借这篇关于深水区的讨论文章,讲一下自己对于深水区的理解。
|
||||
原文链接:[技术路线:前端开发已进入深水区](https://www.yuque.com/sxc/front/kvokg4)
|
||||
|
||||
本期精读,[@camsong](https://github.com/camsong)、[@arcthur](https://github.com/arcthur)、[@ascoders](https://github.com/ascoders) 都有贡献观点。
|
||||
|
||||
## 概述
|
||||
|
||||
原文对于深水区的想法,讲的很清楚,还是建议读者去读一下原文。
|
||||
对比 2010 年,整个前端生态已经翻新了好几遍,直到近几年的 Node BFF、IDE Cloud,抑或是客户端 AI,还是 Serverless 的建设,前端想要深度参与的话,单纯依靠原来的 HTML/CSS/JS 三件套技能也远远不够了。再抛开技术,整个互联网创业生态也重构了好几遍。无论是技术层面还是意识层面,如今的前端开发已经进入深水区。
|
||||
|
||||
- 深水区需要哪些技能
|
||||
|
||||
深水区需要是四个核心能力,分别是:技术、产品、业务和管理能力。
|
||||
- 面对深水压力不需紧张
|
||||
其实何止前端开发,整个技术行业都已步入深水区,只是前端工程师的感知来的晚一些而已。只要把眼光投向深水区,问题就会一个接一个的浮上来,当越来越多问题浮起来的时候,就是你慢慢沉向深水区的时候,这时候不需要太过紧张。
|
||||
|
||||
## 精读
|
||||
|
||||
深水区的理解首先需要达成一致,并不只是一个维度的加深,而是全方位多方面的困难同时加击,压强升高、光线减少、温度剧变等等。
|
||||
|
||||
对应到文中总结的解法就是需要『技术创新、流程优化、团队合作、影响大盘、驱动业务、商业决策和团队管理』。但你展开想一下,把这个角色换成后端、无线端、甚至是 UED,是不是也能完美匹配。所以这些能力应该是技术人员发展到一定程度面临的普遍问题而不仅仅是前端。
|
||||
|
||||
但这些能力是否有个更好的概括?当然有,就是明确一个方向并带领一群人完成目标并实线商业价值。这其实就是商业或者说业务的整个运作过程。
|
||||
|
||||
这其实也在抛一个命题,前端发展到一定程度就一定要转业务吗?
|
||||
是也不是。当然要转,但并不是全转。全转业务你过去的积累有什么用?不转业务单纯前端能发挥的影响力就会受限。所以答案是利用前端技术优势同时补充业务能力推动商业流程。
|
||||
|
||||
所以此文并不是严格上讲前端技术的深水区,或者作者肯定认为他能接触的前端技术已经到瓶颈,且没有想到突破口。
|
||||
|
||||
怎么去定义深水区,@流形 认为是需要建立技术壁垒或学术壁垒。当我们看待一向技术,如果在投入一到两年就可以对齐,那么显然技术本身的深度是可观的,如果是十年才能对齐,这时候除了会影响经济或政治外,不会有人会去重做,只能使用。用另一个类似的概念反摩尔定律来对应深水区说,每隔两年,技术不能显著带来效能的成倍提升。
|
||||
|
||||
### 深水区值得关注的方向
|
||||
|
||||
#### 业务领导力
|
||||
|
||||
也就是原文提到的 “技术创新、流程优化、团队合作、影响大盘、驱动业务、商业决策、团队管理” 等能力,一个拥有领导力的人发挥的价值远超自身孤立的价值。
|
||||
|
||||
#### 业务价值
|
||||
|
||||
发挥业务价值是技术人的最终目标,比如数据库技术想发挥业务价值,就要做到高效、稳定,价值越大往往技术难度就越大。
|
||||
|
||||
值得庆幸的是,前端的业务价值与技术难度往往不成正比,有时候将客户的业务场景固化成一套模版,整合起来赋能给更多客户,这等于将商业模型作为能力赋予了其他客户,但本身并没有用到一些高级技术。前端能做的不仅是内部提效和外部体验,因为前端是人机交互的入口,才有机会将业务思考打包到代码中,直接透出给客户。
|
||||
|
||||
#### 端技术的发展
|
||||
|
||||
1. 数字孪生。那么在端上的仿真能力需要大幅提高,那么结合模型自动生成,不同物体的建模能力等都是很大挑战
|
||||
2. 虚拟实现。这点上就不赘述,从 FB 重点发展 Oculus,微软发展 HoloLens 可以看到这个趋势,从互动的未来来看,这不是终局,但是最适合今天要突破的技术。
|
||||
3. 可视分析。数据在人类面前还是过分难懂,结合数据的分析系统在各行各业正在渗透,端上结合可视化的能力就显得非常重要。
|
||||
4. 更多的,像边缘计算,前端安全等领域都是非常深入的领域。
|
||||
这些问题,已经不是一年就能完全突破的,需要 3-5 年,甚至 10 年时间。
|
||||
|
||||
#### 前端深入体系
|
||||
|
||||
1. 但对于我所处的大数据环境来说,确实接触了前端技术深水区。来源于端计算能力 + 网络基建 + 大数据的爆炸式增长。
|
||||
编辑器:复杂的开发离不开代码,前端们一直孜孜不倦的把 IDE 引入 web,VS Code 做了很成功的尝试但还是需要一层壳套着。且对于大数据处理这样的领域,需要定制的能力远超过通用的 Manaco editor 等能提供。
|
||||
2. 表格类数据处理能力:比尔盖茨最引以为豪的微软软件是 Excel。你永远不知道 Excel 有多少种酷的用法来解决用户问题。能否把 Excel 引入到 web?同时对数百万条数据做交叉分析,这对性能和架构都有很大的挑战。
|
||||
3. 可视化数据展现:大数据的一个典型特征就是价值稀疏性,如何把蕴含的价值展现出来,需要了解图形学、统计学、交互色彩等各种能力。大学老师教的内容终于能派生用场了。
|
||||
|
||||
## 总结
|
||||
|
||||
在局部领域前端已经有可能深入,当然前端技能上说这些也不能用 HTML, CSS, JS 来解决,需要开发者有深入学科的背景。但今天前端面向还是产品功能的需要,在端上更强调的还是产品功能为主。我们做一款复杂产品,更多还会在工程上纠结。如果没在功能的深入性上思考更多,以对应真正技术发展,那么深水区还远。
|
||||
|
||||
正如前面所说,深水区会压强升高、光线减少、温度剧变,需要自己发光发热和更多的坚持。
|
||||
|
||||
跨过深水区,让其他人处在浅水区就能做事,这或许就是你走出深水区的标志。就像 Alan Perlis 说的一句话『简单不先于复杂,而是在复杂之后』,也许未来看来你今天挣扎的深水区只是个小泥坑。
|
||||
|
||||
> 讨论地址是:[精读《前端深水区》 · Issue #193 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/193)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -107,7 +107,7 @@ connect(props => ({
|
||||
|
||||
## HOC 的具体实践
|
||||
|
||||
HOC 在真实场景下的运行非常多,之前笔者在 [基于Decorator的组件扩展实践](https://zhuanlan.zhihu.com/p/22054582) 一文中也提过使用高阶组件将更细粒度的组件组合成 Selector 与 Search。结合精读文章,这次让我们通过 Form 组件的抽象来表现 HOC 具有的良好扩展机制。
|
||||
HOC 在真实场景下的运行非常多,之前笔者在 [基于 Decorator 的组件扩展实践](https://zhuanlan.zhihu.com/p/22054582) 一文中也提过使用高阶组件将更细粒度的组件组合成 Selector 与 Search。结合精读文章,这次让我们通过 Form 组件的抽象来表现 HOC 具有的良好扩展机制。
|
||||
|
||||
Form 中会包含各种不同的组件,常见的有 Input、Selector、Checkbox 等等,也会有根据业务需求加入的自定义组件。Form 灵活多变,从功能上看,表单校验可能为单组件值校验,也可能为全表单值校验,可能为常规检验,比如:非空、输入限制,也可能需要与服务端配合,甚至需要根据业务特点进行定制。从 UI 上看,检验结果显示的位置,可能在组件下方,也可能是在组件右侧。
|
||||
|
||||
@@ -115,7 +115,7 @@ Form 中会包含各种不同的组件,常见的有 Input、Selector、Checkbo
|
||||
|
||||

|
||||
|
||||
至于 HOC 在 Form 上的具体实现,首先将表单中的组件(Input、Selector...)与相应 validator 与组件值回调函数名(trigger)传入 Decorator,将 validator 与 trigger 相绑定。Decorator 完成了各种不同组件与 Form 内置 Store 间 value 的传递、校验功能的抽象,即精读文章中提到 Props Proxy 方式的其中两种作用:**提取state** 与 **操作props**
|
||||
至于 HOC 在 Form 上的具体实现,首先将表单中的组件(Input、Selector...)与相应 validator 与组件值回调函数名(trigger)传入 Decorator,将 validator 与 trigger 相绑定。Decorator 完成了各种不同组件与 Form 内置 Store 间 value 的传递、校验功能的抽象,即精读文章中提到 Props Proxy 方式的其中两种作用:**提取 state** 与 **操作 props**
|
||||
|
||||
```javascript
|
||||
function formFactoryFactory({
|
||||
@@ -0,0 +1,290 @@
|
||||
## 简介
|
||||
|
||||
React 16.8 于 2019.2 正式发布,这是一个能提升代码质量和开发效率的特性,笔者就抛砖引玉先列出一些实践点,希望得到大家进一步讨论。
|
||||
|
||||
然而需要理解的是,没有一个完美的最佳实践规范,对一个高效团队来说,稳定的规范比合理的规范更重要,因此这套方案只是最佳实践之一。
|
||||
|
||||
## 精读
|
||||
|
||||
### 环境要求
|
||||
|
||||
- 拥有较为稳定且理解函数式编程的前端团队。
|
||||
- 开启 ESLint 插件:[eslint-plugin-react-hooks](https://www.npmjs.com/package/eslint-plugin-react-hooks)。
|
||||
|
||||
### 组件定义
|
||||
|
||||
Function Component 采用 `const` + 箭头函数方式定义:
|
||||
|
||||
```tsx
|
||||
const App: React.FC<{ title: string }> = ({ title }) => {
|
||||
return React.useMemo(() => <div>{title}</div>, [title]);
|
||||
};
|
||||
|
||||
App.defaultProps = {
|
||||
title: 'Function Component'
|
||||
}
|
||||
```
|
||||
|
||||
上面的例子包含了:
|
||||
|
||||
1. 用 `React.FC` 申明 Function Component 组件类型与定义 Props 参数类型。
|
||||
2. 用 `React.useMemo` 优化渲染性能。
|
||||
3. 用 `App.defaultProps` 定义 Props 的默认值。
|
||||
|
||||
#### FAQ
|
||||
|
||||
> 为什么不用 React.memo?
|
||||
|
||||
推荐使用 `React.useMemo` 而不是 `React.memo`,因为在组件通信时存在 `React.useContext` 的用法,这种用法会使所有用到的组件重渲染,只有 `React.useMemo` 能处理这种场景的按需渲染。
|
||||
|
||||
> 没有性能问题的组件也要使用 useMemo 吗?
|
||||
|
||||
要,考虑未来维护这个组件的时候,随时可能会通过 `useContext` 等注入一些数据,这时候谁会想起来添加 `useMemo` 呢?
|
||||
|
||||
> 为什么不用解构方式代替 defaultProps?
|
||||
|
||||
虽然解构方式书写 `defaultProps` 更优雅,但存在一个硬伤:对于对象类型每次 Rerender 时引用都会变化,这会带来性能问题,因此不要这么做。
|
||||
|
||||
### 局部状态
|
||||
|
||||
局部状态有三种,根据常用程度依次排列: `useState` `useRef` `useReducer` 。
|
||||
|
||||
#### useState
|
||||
|
||||
```tsx
|
||||
const [hide, setHide] = React.useState(false);
|
||||
const [name, setName] = React.useState('BI');
|
||||
```
|
||||
|
||||
状态函数名要表意,尽量聚集在一起申明,方便查阅。
|
||||
|
||||
#### useRef
|
||||
|
||||
```tsx
|
||||
const dom = React.useRef(null);
|
||||
```
|
||||
|
||||
`useRef` 尽量少用,大量 Mutable 的数据会影响代码的可维护性。
|
||||
|
||||
但对于不需重复初始化的对象推荐使用 `useRef` 存储,比如 `new G2()` 。
|
||||
|
||||
#### useReducer
|
||||
|
||||
局部状态不推荐使用 `useReducer` ,会导致函数内部状态过于复杂,难以阅读。 `useReducer` 建议在多组件间通信时,结合 `useContext` 一起使用。
|
||||
|
||||
#### FAQ
|
||||
|
||||
> 可以在函数内直接申明普通常量或普通函数吗?
|
||||
|
||||
不可以,Function Component 每次渲染都会重新执行,常量推荐放到函数外层避免性能问题,函数推荐使用 `useCallback` 申明。
|
||||
|
||||
### 函数
|
||||
|
||||
所有 Function Component 内函数必须用 `React.useCallback` 包裹,以保证准确性与性能。
|
||||
|
||||
```tsx
|
||||
const [hide, setHide] = React.useState(false);
|
||||
|
||||
const handleClick = React.useCallback(() => {
|
||||
setHide(isHide => !isHide)
|
||||
}, [])
|
||||
```
|
||||
|
||||
`useCallback` 第二个参数必须写,[eslint-plugin-react-hooks](https://www.npmjs.com/package/eslint-plugin-react-hooks) 插件会自动填写依赖项。
|
||||
|
||||
### 发请求
|
||||
|
||||
发请求分为操作型发请求与渲染型发请求。
|
||||
|
||||
#### 操作型发请求
|
||||
|
||||
操作型发请求,作为回调函数:
|
||||
|
||||
```tsx
|
||||
return React.useMemo(() => {
|
||||
return (
|
||||
<div onClick={requestService.addList} />
|
||||
)
|
||||
}, [requestService.addList])
|
||||
```
|
||||
|
||||
#### 渲染型发请求
|
||||
|
||||
渲染型发请求在 `useAsync` 中进行,比如刷新列表页,获取基础信息,或者进行搜索, **都可以抽象为依赖了某些变量,当这些变量变化时要重新取数** :
|
||||
|
||||
```tsx
|
||||
const { loading, error, value } = useAsync(async () => {
|
||||
return requestService.freshList(id);
|
||||
}, [requestService.freshList, id]);
|
||||
```
|
||||
|
||||
### 组件间通信
|
||||
|
||||
简单的组件间通信使用透传 Props 变量的方式,而频繁组件间通信使用 `React.useContext` 。
|
||||
|
||||
以一个复杂大组件为例,如果组件内部拆分了很多模块, **但需要共享很多内部状态** ,最佳实践如下:
|
||||
|
||||
#### 定义组件内共享状态 - store.ts
|
||||
|
||||
```tsx
|
||||
export const StoreContext = React.createContext<{
|
||||
state: State;
|
||||
dispatch: React.Dispatch<Action>;
|
||||
}>(null)
|
||||
|
||||
export interface State {};
|
||||
|
||||
export interface Action { type: 'xxx' } | { type: 'yyy' };
|
||||
|
||||
export const initState: State = {};
|
||||
|
||||
export const reducer: React.Reducer<State, Action> = (state, action) => {
|
||||
switch (action.type) {
|
||||
default:
|
||||
return state;
|
||||
}
|
||||
};
|
||||
```
|
||||
|
||||
#### 根组件注入共享状态 - main.ts
|
||||
|
||||
```tsx
|
||||
import { StoreContext, reducer, initState } from './store'
|
||||
|
||||
const AppProvider: React.FC = props => {
|
||||
const [state, dispatch] = React.useReducer(reducer, initState);
|
||||
|
||||
return React.useMemo(() => (
|
||||
<StoreContext.Provider value={{ state, dispatch }}>
|
||||
<App />
|
||||
</StoreContext.Provider>
|
||||
), [state, dispatch])
|
||||
};
|
||||
```
|
||||
|
||||
#### 任意子组件访问/修改共享状态 - child.ts
|
||||
|
||||
```tsx
|
||||
import { StoreContext } from './store'
|
||||
|
||||
const app: React.FC = () => {
|
||||
const { state, dispatch } = React.useContext(StoreContext);
|
||||
|
||||
return React.useMemo(() => (
|
||||
<div>{state.name}</div>
|
||||
), [state.name])
|
||||
};
|
||||
```
|
||||
|
||||
如上解决了 **多个联系紧密组件模块间便捷共享状态的问题** ,但有时也会遇到需要共享根组件 Props 的问题,**这种不可修改的状态不适合一并塞到 `StoreContext` 里**,我们新建一个 `PropsContext` 注入根组件的 Props:
|
||||
|
||||
```tsx
|
||||
const PropsContext = React.createContext<Props>(null)
|
||||
|
||||
const AppProvider: React.FC<Props> = props => {
|
||||
return React.useMemo(() => (
|
||||
<PropsContext.Provider value={props}>
|
||||
<App />
|
||||
</PropsContext.Provider>
|
||||
), [props])
|
||||
};
|
||||
```
|
||||
|
||||
#### 结合项目数据流
|
||||
|
||||
参考 [react-redux hooks](https://github.com/reduxjs/react-redux/blob/master/docs/api/hooks.md)。
|
||||
|
||||
### debounce 优化
|
||||
|
||||
比如当输入框频繁输入时,为了保证页面流畅,我们会选择在 `onChange` 时进行 `debounce` 。然而在 Function Component 领域中,我们有更优雅的方式实现。
|
||||
|
||||
> 其实在 Input 组件 `onChange` 使用 `debounce` 有一个问题,就是当 Input 组件 **受控** 时, `debounce` 的值不能及时回填,导致甚至无法输入的问题。
|
||||
|
||||
我们站在 Function Component 思维模式下思考这个问题:
|
||||
|
||||
1. React [scheduling](https://github.com/dt-fe/weekly/blob/v2/099.%E7%B2%BE%E8%AF%BB%E3%80%8AScheduling%20in%20React%E3%80%8B.md) 通过智能调度系统优化渲染优先级,我们其实不用担心频繁变更状态会导致性能问题。
|
||||
2. 如果联动一个文本还觉得慢吗? `onChange` 本不慢,大部分使用值的组件也不慢,没有必要从 `onChange` 源头开始就 `debounce` 。
|
||||
3. 找到渲染性能最慢的组件(比如 iframe 组件),**对一些频繁导致其渲染的入参进行 `useDebounce`** 。
|
||||
|
||||
下面是一个性能很差的组件,引用了变化频繁的 `text` (这个 `text` 可能是 `onChange` 触发改变的),我们利用 `useDebounce` 将其变更的频率慢下来即可:
|
||||
|
||||
```typescript
|
||||
const App: React.FC = ({ text }) => {
|
||||
// 无论 text 变化多快,textDebounce 最多 1 秒修改一次
|
||||
const textDebounce = useDebounce(text, 1000)
|
||||
|
||||
return useMemo(() => {
|
||||
// 使用 textDebounce,但渲染速度很慢的一堆代码
|
||||
}, [textDebounce])
|
||||
};
|
||||
```
|
||||
|
||||
使用 `textDebounce` 替代 `text` 可以将渲染频率控制在我们指定的范围内。
|
||||
|
||||
### useEffect 注意事项
|
||||
|
||||
事实上,`useEffect` 是最为怪异的 Hook,也是最难使用的 Hook。比如下面这段代码:
|
||||
|
||||
```tsx
|
||||
useEffect(() => {
|
||||
props.onChange(props.id)
|
||||
}, [props.onChange, props.id])
|
||||
```
|
||||
|
||||
如果 `id` 变化,则调用 `onChange`。但如果上层代码并没有对 `onChange` 进行合理的封装,导致每次刷新引用都会变动,则会产生严重后果。我们假设父级代码是这么写的:
|
||||
|
||||
```tsx
|
||||
class App {
|
||||
render() {
|
||||
return <Child id={this.state.id} onChange={id => this.setState({ id })} />
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
这样会导致死循环。虽然看上去 `<App>` 只是将更新 id 的时机交给了子元素 `<Child>`,但由于 `onChange` 函数在每次渲染时都会重新生成,因此引用总是在变化,就会出现一个无限死循环:
|
||||
|
||||
新 `onChange` -> `useEffect` 依赖更新 -> `props.onChange` -> 父级重渲染 -> 新 `onChange`...
|
||||
|
||||
想要阻止这个循环的发生,只要改为 `onChange={this.handleChange}` 即可,**`useEffect` 对外部依赖苛刻的要求,只有在整体项目都注意保持正确的引用时才能优雅生效。**
|
||||
|
||||
然而被调用处代码怎么写并不受我们控制,这就导致了不规范的父元素可能导致 React Hooks 产生死循环。
|
||||
|
||||
因此在使用 `useEffect` 时要注意调试上下文,注意父级传递的参数引用是否正确,如果引用传递不正确,有两种做法:
|
||||
|
||||
1. 使用 [useDeepCompareEffect](https://github.com/streamich/react-use/blob/master/docs/useDeepCompareEffect.md) 对依赖进行深比较。
|
||||
2. 使用 `useCurrentValue` 对引用总是变化的 props 进行包装:
|
||||
|
||||
```tsx
|
||||
function useCurrentValue<T>(value: T): React.RefObject<T> {
|
||||
const ref = React.useRef(null);
|
||||
ref.current = value;
|
||||
return ref;
|
||||
}
|
||||
|
||||
const App: React.FC = ({ onChange }) => {
|
||||
const onChangeCurrent = useCurrentValue(onChange)
|
||||
};
|
||||
```
|
||||
|
||||
`onChangeCurrent` 的引用保持不变,但每次都会指向最新的 `props.onChange`,从而可以规避这个问题。
|
||||
|
||||
## 总结
|
||||
|
||||
如果还有补充,欢迎在文末讨论。
|
||||
|
||||
如需了解 Function Component 或 Hooks 基础用法,可以参考往期精读:
|
||||
|
||||
- [精读《React Hooks》](https://github.com/dt-fe/weekly/blob/v2/079.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20Hooks%E3%80%8B.md)
|
||||
- [精读《怎么用 React Hooks 造轮子》](https://github.com/dt-fe/weekly/blob/v2/080.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%80%8E%E4%B9%88%E7%94%A8%20React%20Hooks%20%E9%80%A0%E8%BD%AE%E5%AD%90%E3%80%8B.md)
|
||||
- [精读《useEffect 完全指南》](https://github.com/dt-fe/weekly/blob/v2/096.%E7%B2%BE%E8%AF%BB%E3%80%8AuseEffect%20%E5%AE%8C%E5%85%A8%E6%8C%87%E5%8D%97%E3%80%8B.md)
|
||||
- [精读《Function Component 入门》](https://github.com/dt-fe/weekly/blob/v2/104.精读《Function%20Component%20入门》.md)
|
||||
|
||||
> 讨论地址是:[精读《React Hooks 最佳实践》 · Issue #202 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/202)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,175 @@
|
||||
## 简介
|
||||
|
||||
商业智能(Business Intelligence)简称 BI,即通过数据挖掘与分析找到商业洞察,助力商业成功。
|
||||
|
||||
一个完整的 BI 链路包含数据采集、数据清洗、数据挖掘、数据展现,其本质是对数据进行多维分析。前端的主要工作在数据展现环节,由于展示方式繁多、分析模型复杂且数据量大,前端环节的复杂度很高。
|
||||
|
||||
在 BI 做前端非常有挑战,开发者需要充分理解数据概念,而本身复杂度较高的可视化建站也只是 BI 的基础能力,想要建设 BI 的上层能力,比如探索式分析和数据洞察,都需要在前后端引入更复杂的计算模型。
|
||||
|
||||
本文作为一个引子,简单介绍笔者做 BI 的经验,后面如果有机会再写一个系列文章对细节进行阐述。
|
||||
|
||||
## 精读
|
||||
|
||||
国内目前处于 BI 1.0 阶段,也就是报表阶段,因此笔者将阐述这个阶段 BI 的核心开发概念。
|
||||
|
||||
> BI 2.0 探索式分析阶段是国内数据分析最前沿领域,这部分等开发完成后再分享。
|
||||
|
||||
BI 1.0 阶段的核心概念包括 **数据集、渲染引擎、数据模型、可视化** 这四个技术模块。
|
||||
|
||||
### 数据集
|
||||
|
||||
数据集即数据的集合,在 BI 领域更多指一种标准化的数据结构。
|
||||
|
||||
任何数据都可以封装成数据集,比如 txt 文本、excel、mysql 数据库等等。
|
||||
|
||||
数据集的基本形态是二维表格,列头表示字段,每一行就是一份数据,数据展示就是通过对这些数据字段进行多维度分析。
|
||||
|
||||
#### 数据集导入
|
||||
|
||||
一般来说数据集导入有两种方式,分别是本地文件上传与数据库链接。本地文件上传又分为多种文件类型处理,比如对 excel 的解析,可能还包括数据清洗;数据库链接分析可视化导入与 SQL 输入。
|
||||
|
||||
可视化导入需要提前对数据库进行结构分析,绘制出表结构与字段结构,不用理解 SQL 也可以进行可视化操作。
|
||||
|
||||
SQL 输入可以利用 [monaco-editor](https://github.com/microsoft/monaco-editor) 等 web 代码编辑器作为输入框,最好能结合智能提示提高 sql 编写效率。sql 智能提示可以参考往期精读 [精读《手写 SQL 编译器 - 智能提示》](https://github.com/dt-fe/weekly/blob/v2/085.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E6%99%BA%E8%83%BD%E6%8F%90%E7%A4%BA%E3%80%8B.md)。
|
||||
|
||||
#### 数据集建模
|
||||
|
||||
数据集建模一般包含 **维度度量建模、字段配置、层系建模**。
|
||||
|
||||
维度度量建模需要智能分析出字段属于维度还是度量,一般会结合字段实际的值或者字段名来智能判断字段类型,如果数据库信息中已存储了字段类型,就可以 100% 准确归类。
|
||||
|
||||
字段配置即对字段进行增删或修改,还可以新增聚合字段或对比字段。
|
||||
|
||||
聚合字段是指将一个字段表达式封装为一个新字段,这里也会用到一个简单的 sql 编辑器,只需要支持四则运算、字段提示、以及一些基本函数的组合即可。
|
||||
|
||||
对比字段是指新增的字段是基于已有字段在某个时间周期内的对比,比如对 UV 字段的年同比就可以封装为一个对比字段。对比字段在前端技术上没有什么难度,仅需理解概念即可。
|
||||
|
||||
### 渲染引擎
|
||||
|
||||
渲染引擎包括了对报表进行编辑与渲染的引擎,理论上可以合二为一。
|
||||
|
||||
渲染引擎的重要模块包括:画布拖拽、组件编辑、事件中心。
|
||||
|
||||
画布拖拽其实包含了组件自定义开发流程,到 CDN 发布、CDN 加载、组件拖拽、画布排版等一系列技术点,每个点展开都有写不完的细节,但好在这套功能属于通用建站基础功能点,本文就不再赘述。
|
||||
|
||||
组件编辑中,基本属性的编辑与属于通用建站领域的表单模型范畴,一般通过 UISchema 来描述通用表单,这块也不再赘述。组件编辑的另一部分就是数据编辑,这部分在后面数据模型章节里详细讲。
|
||||
|
||||
事件中心是渲染引擎部分,此功能在编辑状态需要禁用。这个功能可以实现图表联动、上卷下钻等数据能力。一个通用事件中心一般包括 **事件触发** 与 **事件响应** 两部分,基本结构如下:
|
||||
|
||||
```typescript
|
||||
interface Event {
|
||||
trigger:
|
||||
| {
|
||||
type: 'callback';
|
||||
callbackName: string;
|
||||
}
|
||||
| {
|
||||
type: 'listener';
|
||||
eventName: string;
|
||||
}
|
||||
| {
|
||||
type: 'system';
|
||||
name: string;
|
||||
};
|
||||
|
||||
action:
|
||||
| {
|
||||
type: 'dispatch';
|
||||
eventName: string;
|
||||
}
|
||||
| {
|
||||
type: 'jumpUrl';
|
||||
url: string;
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
`trigger` 即事件触发,包括基本的系统事件 `system`,比如定时器或者初始化自动触发;组件的回调 `callback` 比如当按钮被点击时;事件监听 `listener` 比如另一个事件被触发时,这个事件可能来自于 `action`。
|
||||
|
||||
`action` 即事件响应,包括基本的事件触发 `dispatch`,可以触发其他事件,可以构成一个事件链路;其他的 `action` 就是数据相关,可以用来做条件联动、字段联动、数据集联动等等,因为实现各异这里不做介绍。
|
||||
|
||||
事件机制还需要支持值传递,即事件触发源的值可以传递到事件响应方。值传递可以在触发源内部进行,比如当触发源是回调函数时,函数参数就自然作为值传递过去,触发源通过 `...args` 方式接收。
|
||||
|
||||
#### 数据钻取
|
||||
|
||||
配置了层系的字段都可以进行数据钻取。层系可以在数据集配置,也可以在报表编辑页配置,可以理解为一个顺序有关的文件夹,将文件夹作为字段使用时,默认生效的是第一个子元素,之后可以按照顺序分别进行下钻。
|
||||
|
||||
比如 “地区” 层系包含了国家、省、市、区,那么就可以按照这个层级进行数据上卷下钻。
|
||||
|
||||
如果一个字段是层系字段,图表需要有对应的操作区域进行上卷下钻,数据编辑区域也可以进行同样操作。数据钻取的计算过程不在图表内部处理,而是触发一个状态后,由渲染引擎将这个层系字段实例状态改为下钻到第 N 层,并且每下钻一次就多拿到一列的数据,由图表组件进行下钻展示。
|
||||
|
||||
一般来说下钻后数据仍是全量的,有时候为了避免数据量过大,比如在柱状图点击某个柱子进行下钻,只想看这个柱子下钻后的数据:比如 2017、2018、2019 年三年的数据,下钻到月后数据量是 3 x 12 = 36 条,但如果仅在 2019 年进行下钻,只想看 2019 年的 12 条数据,可以转化为下钻 + 筛选条件的模式:全局下钻展开后 36 条,在 2019 年上点击下钻后,增加一个筛选条件(年 = 2019),这样就达到了效果,整个流程对图表组件是无感知的。
|
||||
|
||||
### 数据模型
|
||||
|
||||
与通用表单模型 UISchema 相对应,数据模型笔者称之为 CubeSchema,因为 BI 领域对数据的多维处理模型成为 Cube 立方体,数据配置即表示如何对这个立方体进行查询,因此其配置表单成为 CubeSchema。
|
||||
|
||||
不管是探索式分析还是 BI 1.0 的报表阶段,数据模型的基本概念是通用的(探索式分析固定了行列,且增加了标记):将字段放置到不同的区域,这些区域的划分方式可以按照功能:横轴、纵轴;按照概念:维度、度量;按照探索分析思路:固化为行、列等等。
|
||||
|
||||
这块可能涉及到的技术点有:拖拽、批量选择+拖拽、双击后按照维度度量自动添加、图表切换后区域字段自动迁移、对字段拖拽的系列配置:限制数量、限制类型、限制数据集、是否重复等等。
|
||||
|
||||
拖拽可以用 [react-beautiful-dnd](https://github.com/atlassian/react-beautiful-dnd) 等库,与渲染引擎拖拽方案基本类似,遇到有层系的数据集还需支持嵌套层级的拖拽。
|
||||
|
||||
图表切换后字段迁移,可以将每个拖拽区域设置若干类型:
|
||||
|
||||
```json
|
||||
{
|
||||
"dataType": ["dimension"]
|
||||
}
|
||||
```
|
||||
|
||||
这样在切换后,维度类型的字段可以自动迁移到维度类型区域,如果对应区域字段数量达到了 `limit` 限制,就继续填充到下一个区域,直到字段用尽或区域填充完为止。
|
||||
|
||||
如果在探索式分析场景里,需要提前对字段进行维度度量建模,在切换时按照图表情况进行相应的处理。比如折线图切换到表格的情况:折线图是天然一个维度(主轴) + N 个度量的场景,表格是天然两个维度(行、列)+ 1 个度量的场景(也可以支持多个,对单元格进行再切分即可),那么从折线图切换到表格时,度量就会落到标记的文本区域;如果从拥有行和列的表格切换到柱状图(之所以无法切换到折线图,是因为表格的度量值一般是离散的,而折线图度量值一般是连续的),表格的行与列的字段会落到柱状图的维度轴,表现效果是对维度轴进行下钻。
|
||||
|
||||
> [精读《Tableau 探索式模型》](https://github.com/dt-fe/weekly/blob/v2/117.%E7%B2%BE%E8%AF%BB%E3%80%8ATableau%20%E6%8E%A2%E7%B4%A2%E5%BC%8F%E6%A8%A1%E5%9E%8B%E3%80%8B.md) 了解更多探索式分析。
|
||||
|
||||
数据模型还包括数据分析相关配置,比如设置对比字段,或者均值线等分析功能。这些数据计算工作放在后端,前端需要将配置项整理到取数接口中,并按照数据驱动的方式展现。
|
||||
|
||||
对于对比字段等 “拓展字段” 的分析功能,可以拓展通用取数接口,图表组件无感知,相当于多添加了几个隐藏字段;去特殊值等对标准数据进行操作的情况图表组件也无需感知。
|
||||
|
||||
聚类、均值线等需要图表组件额外展示的部分抽象为一套固定的数据格式透传给图表组件,由图表组件自行处理。
|
||||
|
||||
可以看出来,都是取数 + 展示,普通的前端业务与 BI 业务开发的区别:
|
||||
|
||||
普通前端业务是以业务逻辑为核心的,根据业务需要确定接口格式;BI 业务是以数据为核心的,围绕数据计算模型确定一套固定的接口格式,取数不依赖组件,所有组件对标准数据都有对应的展现。
|
||||
|
||||
### 可视化
|
||||
|
||||
与普通可视化组件不同,BI 可视化组件需要对接 CubeSchema 模型,同时还要支持 **大数据性能优化、边界数据展示优化、交互响应**。
|
||||
|
||||
对接 CubeSchema 即统一对接二维表格的数据,大部分组件都是二维以上结构展示,因此对接起来并不困难,有一些一维数据结构的组件比如单指标块就要舍弃其中的某一维,需要确定一套规则。
|
||||
|
||||
二维以上部分是较为通用的,虽然计算模型是基于 Cube N 维的,但组件可以通过标准轴进行多维度展开,或者说下钻来实现类似效果。对于折线图来说,轴的含义有限,可以用分面的方式展示多维数据。当然也有一些组件只适合展示特定维度数量的数据。
|
||||
|
||||
#### 大数据性能优化
|
||||
|
||||
可视化组件特别需要关注性能优化,因为 BI 查询出的数据量可能非常大,特别是多层下钻或基于地理的数据。
|
||||
|
||||
技术手段包括 GPU 渲染、缓存 canvas、多线程运算等,业务手段包括数据抽样、按需渲染可视区域、限制数据条数等等。
|
||||
|
||||
#### 边界数据展示优化
|
||||
|
||||
永远不知道数据集会给出怎样的数据,因此 BI 边界情况特别多,可能点非常密集,也可能丢失一些数据导致渲染异常。图表组件需要利用避让算法将密集的数据打散或着色,目的是为了容易阅读,对于丢失的异常数据也要有保护性的补全机制。
|
||||
|
||||
#### 交互响应
|
||||
|
||||
包括上卷下钻、点选、圈选、高亮等交互操作,这些操作反馈到渲染引擎导致数据变化并将新的数据灌入图表组件。
|
||||
|
||||
业务逻辑上这些交互操作并不复杂,难点在使用的可视化库是否有这个能力,以及如何统一交互行为。
|
||||
|
||||
## 总结
|
||||
|
||||
BI 领域的四大方向:数据集、渲染引擎、数据模型与可视化都有许多可以做深的技术点,每一块都需要深入沉淀几年技术经验才能做好,需要大量优秀人才通力协作才有可能做好。
|
||||
|
||||
目前我们在阿里数据中台正在打造一款面向未来的优秀 BI 工具,如果 BI 领域让你觉得有挑战,随时欢迎你的加入,联系邮箱:ziyi.hzy@alibaba-inc.com
|
||||
|
||||
> 讨论地址是:[精读《前端与 BI》 · Issue #208 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/208)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,486 @@
|
||||
## 1 引言
|
||||
|
||||
在写这次精读之前,我想谈谈前端精读可以为读者带来哪些价值,以及如何评判这些价值。
|
||||
|
||||
前端精读已经写到第 123 篇了,大家已经不必担心它突然停止更新,因为我已养成每周写一篇文章的习惯,而读者也养成了每周看一篇的习惯。所以我想说的其实是一种更有生命力的自媒体运作方式,定期更新。一个定期更新的专栏比一个不不定期更新的专栏更有活力,也更受读者喜爱,因为读者能看到文章之间的联系,跟随作者一起成长。个人学习也是如此,养成定期学习的习惯,比在培训班突击几个月更有用,学会在生活中规律的学习,甚至好过读几年名牌大学。
|
||||
|
||||
前端精读想带给读者的不仅是一篇篇具体的内容和知识,知识是无穷无尽的,几万篇文章也说不完,但前端精读一直沿用了“引言-概述-精读-总结”这套学习模式,无论是前端任何领域的问题,还是对人生和世界的思考都可以套用,希望能为读者提供一套学习思维框架,让你能学习到如何找到好的文章,以及如何解读它。
|
||||
|
||||
至今已经选择了许多源码解读的题材,与培训思维的源码解读不同,我希望你不要带着面试的目的学习源码,因为这样会让你只局限在 react、vue 这种热门的框架上。前端精读选取的框架类型之所以广泛,是希望你能静下心来,吸取不同框架风格与作者的优势,培养一种优雅编码的气质。
|
||||
|
||||
进入正题,这次选择的文章 [《用 Babel 创造自定义 JS 语法》](https://lihautan.com/creating-custom-javascript-syntax-with-babel/) 也是培养编码气质的一类文章,虽然对你实际工作用处不大,但这篇文章可以培养几个程序员梦寐以求的能力:深入理解 Babel、深入理解框架拓展机制。理解一个复杂系统或培养框架思维不是一朝一夕的,但持续阅读这种文章可以让你越来越接近掌握它。
|
||||
|
||||
之所以选择 Babel,是因为 Babel 处理的一直是语法树相关的底层逻辑,编译原理是程序世界的基座之一,拥有很大的学习价值。所以我们的目的并不是像文章标题说的 - 创造一个自定义 JS 语法,因为你创造的语法只会让 JS 复杂体系更加混乱,但可以让你理解 Babel 解析标准 JS 语法的原理,以及看待新语法提案时,拥有从实现层面思考的能力。
|
||||
|
||||
最后,不必多说,能重温 Babel 经典的插件机制,你可以发现 Babel 的插件拓展机制和 Antrl4 很像,在设计业务模块拓展方案时也可以作为参考。
|
||||
|
||||
## 2 概述
|
||||
|
||||
我们要利用 Babel 实现 `function @@` 的新语法,用 `@@` 装饰的函数会自动柯里化:
|
||||
|
||||
```js
|
||||
// '@@' makes the function `foo` curried
|
||||
function @@ foo(a, b, c) {
|
||||
return a + b + c;
|
||||
}
|
||||
console.log(foo(1, 2)(3)); // 6
|
||||
```
|
||||
|
||||
可以看到,`function @@ foo` 描述的函数 `foo` 支持 `foo(1, 2)(3)` 这种柯里化调用。
|
||||
|
||||
实现方式分为两步:
|
||||
|
||||
1. Fork babel 源码。
|
||||
2. 创建一个 babel 转换器插件。
|
||||
|
||||
不要畏惧这些步骤,“如果你读完了这篇文章,你将成为同事眼中的 Babel 大神” - 原文。
|
||||
|
||||
首先 Fork babel 源码到本地,执行下面的命令可以初始化并编译 babel:
|
||||
|
||||
```bash
|
||||
$ make bootstrap
|
||||
$ make build
|
||||
```
|
||||
|
||||
babel 使用 [Makefile](https://opensource.com/article/18/8/what-how-makefile) 执行编译命令,并且采用 monorepo 管理,我们这次要关心的是 `package/babel-parser` 这个模块。
|
||||
|
||||
### 词法
|
||||
|
||||
首先要了解词法知识,更详细的可以阅读原文或精读之前的一篇系列文章:[精读《词法分析》](https://github.com/dt-fe/weekly/blob/v2/064.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E8%AF%8D%E6%B3%95%E5%88%86%E6%9E%90%E3%80%8B.md)。
|
||||
|
||||
要解析语法,首先要进行词法分析。任何语法输入都是一个字符串,比如 `function @@ foo(a, b, c)`,词法分析就是要将这个长度为 24 的字符拆分为一个个有语义的单词片段:`function` `@@` `foo` `(` `a` ..
|
||||
|
||||
由于 `@@` 是我们创造的语法,所以我们第一个任务就是让 babel 词法分析可以识别它。
|
||||
|
||||
下面是 `package/babel-parser` 的文件结构:
|
||||
|
||||
```text
|
||||
- src/
|
||||
- tokenizer/
|
||||
- parser/
|
||||
- plugins/
|
||||
- jsx/
|
||||
- typescript/
|
||||
- flow/
|
||||
- ...
|
||||
- test/
|
||||
```
|
||||
|
||||
可以看到,分为词法分析 `tokenizer`,语法分析 `parser`,以及支持一些特殊语法的插件,以及测试用例 `test`。
|
||||
|
||||
推荐使用 **Test-driven development (TDD) - 测试驱动开发的方式**,就是先写测试用例,再根据测试用例开发。这种开发方式在后端或者 babel 这种底层框架很常见,因为 TDD 方式开发的逻辑能保证测试用例 100% 覆盖,同时先看测试用例也是个很好的切面编程思维。
|
||||
|
||||
```js
|
||||
// packages/babel-parser/test/curry-function.js
|
||||
|
||||
import { parse } from '../lib';
|
||||
|
||||
function getParser(code) {
|
||||
return () => parse(code, { sourceType: 'module' });
|
||||
}
|
||||
|
||||
describe('curry function syntax', function() {
|
||||
it('should parse', function() {
|
||||
expect(getParser(`function @@ foo() {}`)()).toMatchSnapshot();
|
||||
});
|
||||
});
|
||||
```
|
||||
|
||||
可以利用 jest 直接测试这段代码:
|
||||
|
||||
```bash
|
||||
BABEL_ENV=test node_modules/.bin/jest -u packages/babel-parser/test/c
|
||||
```
|
||||
|
||||
结果会出现如下报错:
|
||||
|
||||
```text
|
||||
SyntaxError: Unexpected token (1:9)
|
||||
|
||||
at Parser.raise (packages/babel-parser/src/parser/location.js:39:63)
|
||||
at Parser.raise [as unexpected] (packages/babel-parser/src/parser/util.js:133:16)
|
||||
at Parser.unexpected [as parseIdentifierName] (packages/babel-parser/src/parser/expression.js:2090:18)
|
||||
at Parser.parseIdentifierName [as parseIdentifier] (packages/babel-parser/src/parser/expression.js:2052:23)
|
||||
at Parser.parseIdentifier (packages/babel-pars
|
||||
```
|
||||
|
||||
第 9 个字符就是 `@`,说明程序现在还不支持函数前面的 `@` 解析。我们还可以在错误堆栈中找到报错位置,并把当前 Token 与下一个 Token 打印出来:
|
||||
|
||||
```js
|
||||
// packages/babel-parser/src/parser/expression.js
|
||||
|
||||
parseIdentifierName(pos: number, liberal?: boolean): string {
|
||||
if (this.match(tt.name)) {
|
||||
// ...
|
||||
} else {
|
||||
console.log(this.state.type); // current token
|
||||
console.log(this.lookahead().type); // next token
|
||||
throw this.unexpected();
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
`this.state.type` 代表当前 Token,`this.lookahead().type` 表示下一个 Token。`lookahead` 是词法分析的专有词,表示向后查看。打印之后,我们会发现输出了两个 `@` Token:
|
||||
|
||||
```js
|
||||
TokenType {
|
||||
label: '@',
|
||||
// ...
|
||||
}
|
||||
```
|
||||
|
||||
下一步,我们需要让 babel 词法分析识别 `@@` 这个 Token。首先需要注册这个 Token:
|
||||
|
||||
```js
|
||||
// packages/babel-parser/src/tokenizer/types.js
|
||||
|
||||
export const types: { [name: string]: TokenType } = {
|
||||
// ...
|
||||
at: new TokenType('@'),
|
||||
atat: new TokenType('@@'),
|
||||
};
|
||||
```
|
||||
|
||||
注册了之后,我们要在遍历 Token 时增加判断 “如果当前字符是 `@` 且下一个字符也是 `@`,则整体构成了 `@@` Token 并且光标向后移动两格”:
|
||||
|
||||
```js
|
||||
// packages/babel-parser/src/tokenizer/index.js
|
||||
|
||||
getTokenFromCode(code: number): void {
|
||||
switch (code) {
|
||||
// ...
|
||||
case charCodes.atSign:
|
||||
// if the next character is a `@`
|
||||
if (this.input.charCodeAt(this.state.pos + 1) === charCodes.atSign) {
|
||||
// create `tt.atat` instead
|
||||
this.finishOp(tt.atat, 2);
|
||||
} else {
|
||||
this.finishOp(tt.at, 1);
|
||||
}
|
||||
return;
|
||||
// ...
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
再次运行测试文件,输出变成了:
|
||||
|
||||
```js
|
||||
// current token
|
||||
TokenType {
|
||||
label: '@@',
|
||||
// ...
|
||||
}
|
||||
|
||||
// next token
|
||||
TokenType {
|
||||
label: 'name',
|
||||
// ...
|
||||
}
|
||||
```
|
||||
|
||||
到这一步,已经能正确解析 `@@` Token 了。
|
||||
|
||||
## 语法
|
||||
|
||||
词法已经可以将 `@@` 解析为 `atat` Token,下一步我们就要利用这个 Token,让生成的 AST 结构中包含柯里化函数的信息,并利用 babel 插件在解析时实现柯里化功能。
|
||||
|
||||
首先我们可以在 [Babel AST explorer](https://lihautan.com/babel-ast-explorer/#?eyJiYWJlbFNldHRpbmdzIjp7InZlcnNpb24iOiI3LjYuMCJ9LCJ0cmVlU2V0dGluZ3MiOnsiaGlkZUVtcHR5Ijp0cnVlLCJoaWRlTG9jYXRpb24iOnRydWUsImhpZGVUeXBlIjp0cnVlfSwiY29kZSI6ImZ1bmN0aW9uICogZm9vKCkge30ifQ==) 看到 AST 解析的结构,我们拿 generator 函数测试,因为这个函数结构与柯里化函数类似:
|
||||
|
||||
|
||||
|
||||
可以看到,babel 通过 `generator` `async` 属性来标识函数是否为 generator 或者 async 函数。同理,增加一个 `curry` 属性就可以实现第一步了:
|
||||
|
||||
|
||||
|
||||
要实现如上效果,只需在词法分析 `parser/statement` 文件的 `parseFunction` 处新增 `atat` 解析即可:
|
||||
|
||||
```js
|
||||
// packages/babel-parser/src/parser/statement.js
|
||||
|
||||
export default class StatementParser extends ExpressionParser {
|
||||
// ...
|
||||
parseFunction<T: N.NormalFunction>(
|
||||
node: T,
|
||||
statement?: number = FUNC_NO_FLAGS,
|
||||
isAsync?: boolean = false
|
||||
): T {
|
||||
// ...
|
||||
node.generator = this.eat(tt.star);
|
||||
node.curry = this.eat(tt.atat);
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
`eat` 是吃掉的意思,实际上可以理解为吞掉这个 Token,这样做有两个效果:1. 为函数添加了 `curry` 属性 2. 吞掉了 `@@` 标识,保证所有 Token 都被识别是 AST 解析正确的必要条件。
|
||||
|
||||
关于递归下降语法分析的更多知识,可以参考 [精读《手写 SQL 编译器 - 语法分析》](https://github.com/dt-fe/weekly/blob/v2/066.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%89%8B%E5%86%99%20SQL%20%E7%BC%96%E8%AF%91%E5%99%A8%20-%20%E8%AF%AD%E6%B3%95%E5%88%86%E6%9E%90%E3%80%8B.md),或者阅读原文。
|
||||
|
||||
我们再次执行测试函数,发现测试通过了,一切都在预料中。
|
||||
|
||||
## babel 插件
|
||||
|
||||
现在我们得到了标记了 `curry` 的 AST,那么最后需要一个 babel 解析插件,实现柯里化。
|
||||
|
||||
首先我们通过修改 babel 源码的方式实现的效果,是可以转化为自定义 babel parser 插件的:
|
||||
|
||||
```js
|
||||
// babel-plugin-transformation-curry-function.js
|
||||
|
||||
import customParser from './custom-parser';
|
||||
|
||||
export default function ourBabelPlugin() {
|
||||
return {
|
||||
parserOverride(code, opts) {
|
||||
return customParser.parse(code, opts);
|
||||
},
|
||||
};
|
||||
}
|
||||
```
|
||||
|
||||
这样就可以实现修改 babel 源码一样的效果,这也是做框架常用的插件机制。
|
||||
|
||||
其次我们要理解如何实现柯里化。柯里化可以通过柯里函数包装后实现:
|
||||
|
||||
```js
|
||||
function currying(fn) {
|
||||
const numParamsRequired = fn.length;
|
||||
function curryFactory(params) {
|
||||
return function (...args) {
|
||||
const newParams = params.concat(args);
|
||||
if (newParams.length >= numParamsRequired) {
|
||||
return fn(...newParams);
|
||||
}
|
||||
return curryFactory(newParams);
|
||||
}
|
||||
}
|
||||
return curryFactory([]);
|
||||
}
|
||||
|
||||
// from
|
||||
function @@ foo(a, b, c) {
|
||||
return a + b + c;
|
||||
}
|
||||
|
||||
// to
|
||||
const foo = currying(function foo(a, b, c) {
|
||||
return a + b + c;
|
||||
})
|
||||
```
|
||||
|
||||
柯里化函数通过构造参数数量相关的递归,当参数传入不足时返回一个新函数,并持久化之前传入的参数,最后当参数齐全后一次性调用函数。
|
||||
|
||||
我们需要做的是,将 `@@ foo` 解析为 `currying()` 函数包裹后的新函数。
|
||||
|
||||
下面就是我们熟悉的 babel 插件部分了:
|
||||
|
||||
```js
|
||||
// babel-plugin-transformation-curry-function.js
|
||||
|
||||
export default function ourBabelPlugin() {
|
||||
return {
|
||||
// ...
|
||||
visitor: {
|
||||
FunctionDeclaration(path) {
|
||||
if (path.get('curry').node) {
|
||||
// const foo = curry(function () { ... });
|
||||
path.node.curry = false;
|
||||
path.replaceWith(
|
||||
t.variableDeclaration('const', [
|
||||
t.variableDeclarator(
|
||||
t.identifier(path.get('id.name').node),
|
||||
t.callExpression(t.identifier('currying'), [
|
||||
t.toExpression(path.node),
|
||||
])
|
||||
),
|
||||
])
|
||||
);
|
||||
}
|
||||
},
|
||||
},
|
||||
};
|
||||
}
|
||||
```
|
||||
|
||||
`FunctionDeclaration` 就是 AST 的 visit 钩子,这个钩子在执行到函数时被触发,我们通过 `path.get('curry')` 拿到 **柯里化函数**,并利用 `replaceWith` 将这个函数构造为一个被 `currying` 函数包裹的新函数。
|
||||
|
||||
剩下最后一个问题:`currying` 函数源码放在哪里。
|
||||
|
||||
第一种方式,创建类似 `babel-plugin-transformation-curry-function` 这样的插件,在 babel 解析时将 `currying` 函数注册到全局,这是全局思维的方案。
|
||||
|
||||
第二种是模块化解决方案,创建一个自定义的 `@babel/helpers`,注册一个 `currying` 标识:
|
||||
|
||||
```js
|
||||
// packages/babel-helpers/src/helpers.js
|
||||
helpers.currying = helper("7.6.0")`
|
||||
export default function currying(fn) {
|
||||
const numParamsRequired = fn.length;
|
||||
function curryFactory(params) {
|
||||
return function (...args) {
|
||||
const newParams = params.concat(args);
|
||||
if (newParams.length >= numParamsRequired) {
|
||||
return fn(...newParams);
|
||||
}
|
||||
return curryFactory(newParams);
|
||||
}
|
||||
}
|
||||
return curryFactory([]);
|
||||
}
|
||||
`;
|
||||
```
|
||||
|
||||
在 visit 函数使用 `addHelper` 方式拿到 `currying`:
|
||||
|
||||
```js
|
||||
path.replaceWith(
|
||||
t.variableDeclaration('const', [
|
||||
t.variableDeclarator(
|
||||
t.identifier(path.get('id.name').node),
|
||||
t.callExpression(this.addHelper("currying"), [
|
||||
t.toExpression(path.node),
|
||||
])
|
||||
),
|
||||
])
|
||||
);
|
||||
```
|
||||
|
||||
这样在 babel 转换后,就会自动 import helper,并引用 helper 中导出的 `currying`。
|
||||
|
||||
最后原文末尾留下了一些延伸阅读内容,感兴趣的同学可以 [点击到原文](https://lihautan.com/creating-custom-javascript-syntax-with-babel/)。
|
||||
|
||||
## 3 精读
|
||||
|
||||
读完这篇文章,相信你不仅对 babel 插件有了更深刻的认识,而且还掌握了如何为 js 添加新语法这种黑魔法。
|
||||
|
||||
我来帮你从 babel 这篇文章总结一些编程模型和知识点,借助 babel 创造自定义语法的实例,加深对它们的理解。
|
||||
|
||||
### TDD
|
||||
|
||||
Test-driven development 即测试驱动的开发模式。
|
||||
|
||||
从文章的例子可以看出,创造一个新语法,可以先在测试用例先写上这个语法,通过执行测试命令通过报错堆栈一步步解决问题。这种方式开发可以让测试覆盖率更高,目的更专注,更容易保障代码质量。
|
||||
|
||||
### 联想编程
|
||||
|
||||
联想编程不属于任何编程模型,但从简介的思路来看,作者把 “为 babel 创建一个新 js 语法” 看作一种探案式探索过程,通过错误堆栈和代码阅读,一步一步通过合理联想实现最终目的。
|
||||
|
||||
在 AST 那一节,还借助了 [Babel AST explorer](https://lihautan.com/babel-ast-explorer/#?eyJiYWJlbFNldHRpbmdzIjp7InZlcnNpb24iOiI3LjYuMCJ9LCJ0cmVlU2V0dGluZ3MiOnsiaGlkZUVtcHR5Ijp0cnVlLCJoaWRlTG9jYXRpb24iOnRydWUsImhpZGVUeXBlIjp0cnVlfSwiY29kZSI6ImZ1bmN0aW9uICogZm9vKCkge30ifQ==) 工具查看 AST 结构,通过联想到 generator 函数找到类似的 AST 结构,并找到拓展 AST 的突破口。
|
||||
|
||||
随着解决问题的不同,联想方式也不同,如果能够举一反三,对不同场景都能合理的联想,才算是具备了技术专家的软素质。
|
||||
|
||||
### 词法、语法分析
|
||||
|
||||
词法、语法分析属于编译原理的知识,理解词法拆分、递归下降,可以帮助你技术走的更深。
|
||||
|
||||
不论是 Babel 插件的使用、还是 Babel 增加自定义 JS 语法,都要具备基本编译原理知识。编译原理知识还能帮助你开发在线编辑器,做智能语法提示等等。
|
||||
|
||||
### 插件机制
|
||||
|
||||
如下是 babel 自定义 parser 的插件拓展方式:
|
||||
|
||||
```js
|
||||
export default function ourBabelPlugin() {
|
||||
return {
|
||||
parserOverride(code, opts) {
|
||||
return customParser.parse(code, opts);
|
||||
},
|
||||
};
|
||||
}
|
||||
```
|
||||
|
||||
这只是插件拓展的一种,有申明式,也有命令式;有用 JS 书写的,也有用 JSON 书写的。babel 选择了通过对象方式拓展,是比较适合对 AST 结构统一处理的。
|
||||
|
||||
做框架首先要确定接口规范,比如 parser,先按照接口规范实现一套官方解析,对接时按照接口进行对接,就可以自然而然被用户自定义插件替代了。
|
||||
|
||||
可以参考的文章: [精读《插件化思维》](https://github.com/dt-fe/weekly/blob/v2/053.%E7%B2%BE%E8%AF%BB%E3%80%8A%E6%8F%92%E4%BB%B6%E5%8C%96%E6%80%9D%E7%BB%B4%E3%80%8B.md)
|
||||
|
||||
### 柯里化
|
||||
|
||||
柯里化是面试经常考察的一个知识点,我们能学到的有两点:理解递归、理解如何将函数变成柯里化。
|
||||
|
||||
这里再拓展一下,我们还可以想到 JS 尾递归优化。如何快速写一个支持尾递归的函数?
|
||||
|
||||
```js
|
||||
const fn = tailCallOptimize(() => {
|
||||
if ( /* xxx */ ) {
|
||||
fn()
|
||||
}
|
||||
})
|
||||
```
|
||||
|
||||
通过封装 `tailCallOptimize` 函数,可以很方便的构造一个支持尾递归的函数,这个函数可以这么写:
|
||||
|
||||
```js
|
||||
export function tailCallOptimize<T>(f: T): T {
|
||||
let value: any;
|
||||
let active = false;
|
||||
const accumulated: any[] = [];
|
||||
return function accumulator(this: any) {
|
||||
accumulated.push(arguments);
|
||||
if (!active) {
|
||||
active = true;
|
||||
while (accumulated.length) {
|
||||
value = (f as any).apply(this, accumulated.shift());
|
||||
}
|
||||
active = false;
|
||||
return value;
|
||||
}
|
||||
};
|
||||
}
|
||||
```
|
||||
|
||||
感兴趣的读者可以在评论里解释一下这个函数的原理。
|
||||
|
||||
### AST visit
|
||||
|
||||
遍历 AST 树常采用的方案是做一个遍历器 visitor,所以在遍历过程中进行拓展常采用 babel 这种方式:
|
||||
|
||||
```js
|
||||
return {
|
||||
// ...
|
||||
visitor: {
|
||||
FunctionDeclaration(path) {
|
||||
if (path.get('curry').node) {
|
||||
// const foo = curry(function () { ... });
|
||||
path.node.curry = false;
|
||||
path.replaceWith(
|
||||
t.variableDeclaration('const', [
|
||||
t.variableDeclarator(
|
||||
t.identifier(path.get('id.name').node),
|
||||
t.callExpression(t.identifier('currying'), [
|
||||
t.toExpression(path.node),
|
||||
])
|
||||
),
|
||||
])
|
||||
);
|
||||
}
|
||||
},
|
||||
},
|
||||
};
|
||||
```
|
||||
|
||||
`visitor` 下每一个 key 名都是遍历过程中的拓展点,比如上面的例子,我们可以对函数定义位置进行拓展和改写。
|
||||
|
||||
### 内置函数注册
|
||||
|
||||
babel 提供了两种内置函数注册方式,一种类似 polyfill,在全局注册 window 级的变量,另一种是模块化的方式。
|
||||
|
||||
除此之外,可以学习的是 babel 通过 `this.addHelper("currying")` 这种插件拓展方式,在编译后会自动从 helper 引入对应的模块,前提是 `@babel/helper` 需要注册 `currying` 这个 helper。
|
||||
|
||||
babel 将编译过程隐藏了起来,通过一些高度封装的函数调用,以较为语义化方式书写插件,这样写出来的代码也容易理解。
|
||||
|
||||
## 4 总结
|
||||
|
||||
《用 Babel 创造自定义 JS 语法》这篇文章虽然说的是 babel 相关知识,但可以从中提取到许多通用知识,这就是现在还去理解 babel 的原因。
|
||||
|
||||
从某个功能点为切面,走一遍框架的完整流程是一种高效的进阶学习方式,如果你也有看到类似这样的文章,欢迎推荐出来。
|
||||
|
||||
> 讨论地址是:[精读《用 Babel 创造自定义 JS 语法》 · Issue #210 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/210)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,372 @@
|
||||
## 1 引言
|
||||
|
||||
Flex 与 Grid 相比就像功能键盘和触摸屏。触摸屏的控制力相比功能键盘来说就像是降维打击,因为功能键盘只能上下左右控制(x、y 轴),而触摸屏打破了布局障碍,直接从(z 轴)触达,这样 **无论 UI 内部布局再复杂,都可以通过 touch 直接定位。**
|
||||
|
||||
Flex 是一维布局方式,我们需要不断嵌套 Div 才能形成复杂结构,而一旦布局产生了变化,原有嵌套结构如果不能 “兼容变化” 到新结构,代码就需要重构。而 Grid 就像触摸屏一样,可以二维布局,即便布局方式做了翻天覆地的调整,也仅需少量修改就能适配。
|
||||
|
||||
这就是这次精读 [用 css grid 重新思考布局](https://www.freecodecamp.org/news/css-grid-changes-how-we-can-think-about-structuring-our-content/) 的原因,理解这个革命性布局技术给布局,甚至代码逻辑组织带来的变化。
|
||||
|
||||
## 2 概述
|
||||
|
||||
作者首先抛出了 Flex 的问题,其实是 `block` `float` `flex` 这三种布局模式的通病:
|
||||
|
||||
- 布局结构由 Div 层级结构描述,导致 Div 层级复杂且遇到结构变更时难以维护。
|
||||
- 定制能力弱。Flex 布局有一些不受控制的智能设定,比如宽度 50% 的子元素会被同级元素挤到 50% 以下,这种智能化在某些场景是需要的,但由于没有提供像 Grid 的 `minmax` 之类的 API,所以定制型不足。
|
||||
|
||||
|
||||
|
||||
举个例子,上图的结构用 Flex 描述可能是这样的:
|
||||
|
||||
```html
|
||||
<div class="card">
|
||||
<div class="profile-sidebar">
|
||||
<img src="https://i.pravatar.cc/125?image=3" alt="" class="profile-img" />
|
||||
<ul class="social-list">
|
||||
<li>
|
||||
<a href="#" class="social-link"
|
||||
><i class="fab fa-dribbble-square"></i
|
||||
></a>
|
||||
</li>
|
||||
<li>
|
||||
<a href="#" class="social-link"
|
||||
><i class="fab fa-facebook-square"></i
|
||||
></a>
|
||||
</li>
|
||||
<li>
|
||||
<a href="#" class="social-link"
|
||||
><i class="fab fa-twitter-square"></i
|
||||
></a>
|
||||
</li>
|
||||
</ul>
|
||||
</div>
|
||||
<div class="profile-body">
|
||||
<h2 class="profile-name">Ramsey Harper</h2>
|
||||
<p class="profile-position">Graphic Designer</p>
|
||||
<p class="profile-info">
|
||||
Lorem ipsum dolor sit amet consectetur adipisicing elit. Facere a tempore,
|
||||
dignissimos odit accusantium repellat quidem, sit molestias dolorum
|
||||
placeat quas debitis ipsum esse rerum?
|
||||
</p>
|
||||
</div>
|
||||
</div>
|
||||
```
|
||||
|
||||
利用 HTML 嵌套结构,我们将图形纵向分成两大块,然后在每块内部继续嵌套划分布局,这是最经典的布局行为了。
|
||||
|
||||
|
||||
|
||||
样式文件里,我们需要对每层布局进行描述,同时支持多分辨率弹性布局,包括顶层 `card` 容器在内的一些样式需要做一定调整:
|
||||
|
||||
```scss
|
||||
.card {
|
||||
width: 80%;
|
||||
margin: 0 auto;
|
||||
display: flex;
|
||||
flex-direction: column;
|
||||
max-width: 600px;
|
||||
background: #005e9b;
|
||||
flex-basis: 250px;
|
||||
color: white;
|
||||
padding: 2em;
|
||||
text-align: center;
|
||||
}
|
||||
|
||||
.profile-info {
|
||||
font-weight: 300;
|
||||
opacity: 0.7;
|
||||
}
|
||||
|
||||
.profile-sidebar {
|
||||
margin-right: 2em;
|
||||
text-align: center;
|
||||
}
|
||||
|
||||
.profile-name {
|
||||
letter-spacing: 1px;
|
||||
font-size: 2rem;
|
||||
margin: 0.75em 0 0;
|
||||
line-height: 1;
|
||||
}
|
||||
|
||||
.profile-name::after {
|
||||
content: "";
|
||||
display: block;
|
||||
width: 2em;
|
||||
height: 1px;
|
||||
background: #5bcbf0;
|
||||
margin: 0.5em auto 0.65em;
|
||||
opacity: 0.25;
|
||||
}
|
||||
|
||||
.profile-position {
|
||||
text-transform: uppercase;
|
||||
font-size: 0.875rem;
|
||||
letter-spacing: 3px;
|
||||
margin: 0 0 2em;
|
||||
line-height: 1;
|
||||
color: #5bcbf0;
|
||||
}
|
||||
|
||||
.profile-img {
|
||||
max-width: 100%;
|
||||
border-radius: 50%;
|
||||
border: 2px solid white;
|
||||
}
|
||||
|
||||
.social-list {
|
||||
list-style: none;
|
||||
justify-content: space-evenly;
|
||||
display: flex;
|
||||
min-width: 125px;
|
||||
max-width: 175px;
|
||||
margin: 0 auto;
|
||||
padding: 0;
|
||||
}
|
||||
|
||||
.social-link {
|
||||
color: #5bcbf0;
|
||||
opacity: 0.5;
|
||||
}
|
||||
|
||||
.social-link:hover,
|
||||
.social-link:focus {
|
||||
opacity: 1;
|
||||
}
|
||||
|
||||
.bio {
|
||||
padding: 2em;
|
||||
display: flex;
|
||||
flex-direction: column;
|
||||
justify-content: center;
|
||||
}
|
||||
|
||||
@media (min-width: 450px) {
|
||||
.bio {
|
||||
text-align: left;
|
||||
max-width: 350px;
|
||||
}
|
||||
}
|
||||
|
||||
.bio-title {
|
||||
color: #0090d1;
|
||||
font-size: 1.25rem;
|
||||
letter-spacing: 1px;
|
||||
text-transform: uppercase;
|
||||
line-height: 1;
|
||||
margin: 0;
|
||||
}
|
||||
|
||||
.bio-body {
|
||||
color: #555;
|
||||
}
|
||||
|
||||
.profile {
|
||||
display: flex;
|
||||
align-items: flex-start;
|
||||
}
|
||||
|
||||
@media (min-width: 450px) {
|
||||
.card {
|
||||
flex-direction: row;
|
||||
text-align: left;
|
||||
}
|
||||
|
||||
.profile-name::after {
|
||||
margin-left: 0;
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
让我们看看 Grid 是怎么做的吧!Grid 有许多 API,我们重点看 `grid-template-areas` 这个属性,利用它,我们可以不关心模块的 HTML 结构,直接平铺方式描述:
|
||||
|
||||
```html
|
||||
<div class="card">
|
||||
<img src="https://i.pravatar.cc/125?image=3" alt="" class="profile-img" />
|
||||
<ul class="social-list">
|
||||
<li>
|
||||
<a href="#" class="social-link"><i class="fab fa-dribbble-square"></i></a>
|
||||
</li>
|
||||
<li>
|
||||
<a href="#" class="social-link"><i class="fab fa-facebook-square"></i></a>
|
||||
</li>
|
||||
<li>
|
||||
<a href="#" class="social-link"><i class="fab fa-twitter-square"></i></a>
|
||||
</li>
|
||||
</ul>
|
||||
<h2 class="profile-name">Ramsey Harper</h2>
|
||||
<p class="profile-position">Graphic Designer</p>
|
||||
<p class="profile-info">
|
||||
Lorem ipsum dolor sit amet consectetur adipisicing elit. Facere a tempore,
|
||||
dignissimos odit accusantium repellat quidem, sit molestias dolorum placeat
|
||||
quas debitis ipsum esse rerum?
|
||||
</p>
|
||||
</div>
|
||||
```
|
||||
|
||||
可以看到,使用 Grid 可以将 UI 结构与 HTML 结构分离,HTML 结构仅描述包含关系,我们只需在样式文件中描述具体 UI 结构。
|
||||
|
||||
样式文件只截取 Grid 相关部分:
|
||||
|
||||
```scss
|
||||
.card {
|
||||
width: 80%;
|
||||
margin: 0 auto;
|
||||
display: flex;
|
||||
flex-direction: column;
|
||||
max-width: 600px;
|
||||
background: #005e9b;
|
||||
flex-basis: 250px;
|
||||
color: white;
|
||||
padding: 2em;
|
||||
text-align: left;
|
||||
|
||||
display: grid;
|
||||
grid-template-columns: 1fr 3fr;
|
||||
grid-column-gap: 2em;
|
||||
grid-template-areas:
|
||||
"image name"
|
||||
"image position"
|
||||
"social description";
|
||||
}
|
||||
|
||||
.profile-name {
|
||||
grid-area: name;
|
||||
}
|
||||
.profile-position {
|
||||
grid-area: position;
|
||||
}
|
||||
.profile-info {
|
||||
grid-area: description;
|
||||
}
|
||||
.profile-img {
|
||||
grid-area: image;
|
||||
}
|
||||
.social-list {
|
||||
grid-area: social;
|
||||
}
|
||||
```
|
||||
|
||||
可以看到,`grid-template-areas` 是进一步抽象的语法,将页面结构通过直观的文本描述,无论是理解还是修改都更为轻松。
|
||||
|
||||
这种描述方式适配不同分辨率下也具有优势,只要重组 `grid-template-areas` 即可:
|
||||
|
||||
```scss
|
||||
@media (min-width: 600px) {
|
||||
.card {
|
||||
text-align: left;
|
||||
grid-template-columns: 1fr 3fr;
|
||||
grid-template-areas:
|
||||
"image name"
|
||||
"image position"
|
||||
"social description";
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
归根结底,Grid 通过二维结构描述,将子元素布局控制收到了父级,使布局描述更加直观。
|
||||
|
||||
最后作者也提到,Flex 依然有使用场景,即简单的一维结构,或者 `space-between` 等 Flex 独有语法的情况。因此推荐整体、复杂的二维布局采用 Grid,一维的简单布局采用 Flex。
|
||||
|
||||
## 3 精读
|
||||
|
||||
Grid 的布局思路给了我很多启发,HTML 结构与 UI 结构的分离有助于减少 DIV 的层级结构,使代码看上去更清晰。
|
||||
|
||||
也许有人会疑惑,Grid 无非将 HTML 布局部分功能挪到了 CSS,整体复杂度应该不变。其实,从 `grid-template-areas` 这个 API 可以看到,Grid 不仅仅将布局功能抽到 CSS 中,更是将布局描述进行了一层抽象,使代码更易维护。
|
||||
|
||||
### 抽象,再抽象
|
||||
|
||||
为什么 Grid 可以对布局进行抽象?因为 Grid 将二维结构都掌握在手中,得到了更大的布局能力,才能进一步将结构化语法抽象为字符串的描述。
|
||||
|
||||
抽象的好处是不言而喻的,你觉得一堆嵌套的 DIV 与下面的代码,哪个更易读呢?
|
||||
|
||||
```scss
|
||||
.card {
|
||||
grid-template-areas:
|
||||
"image name"
|
||||
"image position"
|
||||
"social description";
|
||||
}
|
||||
```
|
||||
|
||||
这就是抽象的好处,一般来说,代码抽象程度越高就越易读,越易维护。
|
||||
|
||||
再看一个 Chrome Grid 插件,将 Grid 可视化显示出来,并可以以 UI 方式进行调整:
|
||||
|
||||
|
||||
|
||||
UI 是对文本的再抽象,同时可以规避一些不可能存在的语法,比如:
|
||||
|
||||
```scss
|
||||
.card {
|
||||
grid-template-areas:
|
||||
"image name"
|
||||
"image position"
|
||||
"social image";
|
||||
}
|
||||
```
|
||||
|
||||
布局只能以凸多边形方式拓展,不可能分离,也不可能突然插入一个其他模块而变成凹多边形。因此 UI 可以将这个错误规避,并简化为横竖多条线的方式对 UI 进行划分,显然这种描述方式效率更高。
|
||||
|
||||
不得不说,Grid 以及图形化插件的探索,是布局领域的一大进步,是不断抽象的尝试,要解决的问题只有一个:如何提供一种更直观的描述 UI 的方式。
|
||||
|
||||
### 布局对模块化的影响
|
||||
|
||||
Grid 将布局方式提高了一个维度,会直接影响到 JS 模块化方式。
|
||||
|
||||
尤其是以 JSX 组织代码的情况下,一个模块等于 UI + JS,通过嵌套方式的布局会让我们更倾向于站在 UI 视角划分模块。
|
||||
|
||||

|
||||
|
||||
比如对于上图模块,如果用 Flex 方式布局,我们可能会首先创建模块 X 作为左侧容器,子元素是 A 和 B,创建模块 Y 作为右侧容器,子元素是 C 以及新容器 Z,Z 容器的子元素是 D 和 E。
|
||||
|
||||
如果你的第一印象是这么组织代码,不得不承认模块化会受到布局方式的影响。虽然许多时候这样划分是正确的,但当这 5 个模块各自没有关联时,我们创建的容器 X、Y、Z 就失去了复用性,在新的组合场景我们又要重新组合一遍。
|
||||
|
||||
但是在 Grid 语法中,我们不需要 X、Y、Z,只需要用 [css grid generator](https://cssgrid-generator.netlify.com/) 按照上图的方式拖拖拽拽即可自动生成如下布局代码:
|
||||
|
||||
```scss
|
||||
.parent {
|
||||
display: grid;
|
||||
grid-template-columns: 3fr repeat(2, 1fr);
|
||||
grid-template-rows: repeat(5, 1fr);
|
||||
grid-column-gap: 0px;
|
||||
grid-row-gap: 0px;
|
||||
}
|
||||
|
||||
.div1 {
|
||||
grid-area: 1 / 1 / 3 / 2;
|
||||
}
|
||||
.div2 {
|
||||
grid-area: 3 / 1 / 6 / 2;
|
||||
}
|
||||
.div3 {
|
||||
grid-area: 1 / 2 / 2 / 4;
|
||||
}
|
||||
.div4 {
|
||||
grid-area: 2 / 2 / 6 / 3;
|
||||
}
|
||||
.div5 {
|
||||
grid-area: 2 / 3 / 6 / 4;
|
||||
}
|
||||
```
|
||||
|
||||
其实 `grid-template-columns` `grid-template-rows` 组合起来使用比 `grid-template-areas` 更强大,但是纯代码方式描述没有 `grid-template-areas` 直观,可是配合一些可视化系统就非常直观了:
|
||||
|
||||

|
||||
|
||||
将 A ~ E 这 5 个模块布局抽出来后,它们之间的关系就打平了,我们可以完全从逻辑视角审视如何做模块化了。
|
||||
|
||||
## 4 总结
|
||||
|
||||
CSS Grid 本质上是一种二维布局的语法,相比 [Block](https://www.w3schools.com/Css/css_inline-block.asp)、[Flex](https://www.w3schools.com/Css/css3_flexbox.asp) 等一维布局方案,多了一个维度可以同时从行与列角度定义布局,因此派生出 `grid-template-areas` 等语法,整体上更内聚更直观,抽象度也更高了。
|
||||
|
||||
理解了这些也就理解了布局未来的发展方向,**让布局与 Dom 分离** 一直是前端的一个梦想,开发 UI 部分时,只需关心页面由哪些模块组成,去实现这些模块就行了,而不需要关心模块之间应该如何组合。在描述组合时,可以通过可视化或比较抽象的字符串描述布局的结构,并对应到写好的模块上,这样的代码维护性远高于用 DIV 描述结构的方案。
|
||||
|
||||
> 讨论地址是:[精读《用 css grid 重新思考布局》 · Issue #211 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/211)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,136 @@
|
||||
## 1 引言
|
||||
|
||||
函数式语言在深度学习领域应用很广泛,因为函数式与深度学习模型的契合度很高,[The Beauty of Functional Languages in Deep Learning — Clojure and Haskell](https://www.welcometothejungle.co/fr/articles/btc-deep-learning-clojure-haskell) 就很好的诠释了这个道理。
|
||||
|
||||
通过这篇文章可以加深我们对深度学习与函数式编程的理解。
|
||||
|
||||
## 2 概述与精读
|
||||
|
||||
深度学习是机器学习中基于人工神经网络模型的一个分支,通过模拟多层神经元的自编码神经网络,将特征逐步抽象化,这需要多维度、大数据量的输入。[TensorFlow](https://www.tensorflow.org/) 和 [PyTorch](https://pytorch.org/) 是比较著名的 Python 深度学习框架,同样 [Keras](https://blog.rstudio.com/2017/09/05/keras-for-r/) 在 R 语言中也很著名。然而在生产环境中,基于 **性能和安全性** 的考虑,一般会使用函数式语言 [Clojure](https://www.clojure.org/) 或 [Haskell](https://www.haskell.org/)。
|
||||
|
||||
在生产环境中,可能要并发出里几百万个参数,因此面临的挑战是:如何高效、安全的执行这些运算。
|
||||
|
||||
**所以为什么函数式编程语言可以胜任深度学习的计算要求呢?** 深度学习的计算模型本质上是数学模型,而数学模型本质上和函数式编程思路是一致的:数据不可变且函数间可以任意组合。这意味着使用函数式编程语言可以更好的表达深度学习的计算过程,因此更容易理解与维护,同时函数式语言内置的 Immutable 数据结构也保障了并发的安全性。
|
||||
|
||||
另外函数式语言的函数之间都是相互隔离的,即便在多线程环境下也不会发生竞争和死锁的情况,函数式编程语言会自动处理这些情况。
|
||||
|
||||
比如说 [Clojure](https://www.clojure.org/),**它甚至可在两个同时修改同一引用的程序并发运行时,自动重试其中之一,而不需要手动加锁**:
|
||||
|
||||
```clojure
|
||||
(import ‘(java.util.concurrent Executors))
|
||||
(defn test-stm [nitems nthreads niters]
|
||||
(let [refs (map ref (repeat nitems 0))
|
||||
pool (Executors/newFixedThreadPool nthreads)
|
||||
tasks (map (fn [t]
|
||||
(fn []
|
||||
(dotimes [n niters]
|
||||
(dosync
|
||||
(doseq [r refs]
|
||||
(alter r + 1 t))))))
|
||||
(range nthreads))]
|
||||
(doseq [future (.invokeAll pool tasks)]
|
||||
(.get future))
|
||||
(.shutdown pool)
|
||||
(map deref refs)))
|
||||
(test-stm 10 10 10000) -> (550000 550000 550000 550000 550000 550000 550000 550000 550000 550000)
|
||||
```
|
||||
|
||||
上面的代码创建了引用(refs),同时创建了多个线程自增这个引用对象,按理说每个线程都修改这个引用会导致竞争状态出现,但从结果来看是正常的,说明 Clojure 引擎在执行时会自动解决这个问题。实际上当两个线程出现竞争而失败时,Clojure 会自动重试其中之一。
|
||||
|
||||
> [原文介绍](https://clojure.org/about/concurrent_programming)
|
||||
|
||||
**Clojure 的另一个优势是并行效率高:**
|
||||
|
||||
```clojure
|
||||
(defn calculate-pixels-2 []
|
||||
(let [n (* *width* *height*)
|
||||
work (partition (/ n 16) (range 0 n))
|
||||
result (pmap (fn [x]
|
||||
(doall (map
|
||||
(fn [p]
|
||||
(let [row (rem p *width*) col (int (/ p *height*))]
|
||||
(get-color (process-pixel (/ row (double *width*)) (/ col (double *height*))))))
|
||||
x)))
|
||||
work)]
|
||||
(doall (apply concat result))))
|
||||
```
|
||||
|
||||
使用 `partition` 结合 `pmap` 可以使并发效率达到最大化,也就是 CPU 几乎都消耗在实际计算上,而不是并行的任务管理与上下文切换。Clojure 凭借 `partition` 对计算进行分区,采取分而治之并对分区计算结果进行合并的思路优化了并发性能。
|
||||
|
||||
> [原文介绍](http://www.fatvat.co.uk/2009/05/jvisualvm-and-clojure.html)
|
||||
|
||||
Clojure 另一个特性是函数链式调用:
|
||||
|
||||
```clojure
|
||||
;; pipe arg to function
|
||||
(-> "x" f1) ; "x1"
|
||||
|
||||
;; pipe. function chaining
|
||||
(-> "x" f1 f2) ; "x12"
|
||||
```
|
||||
|
||||
其中 `(-> "x" f1 f2)` 等价于 `f2(f1("x"))`,这种描述不仅更简洁清晰,也更接近于实际数学模型。
|
||||
|
||||
> [原文介绍](http://xahlee.info/clojure/clojure_function_chaining.html)
|
||||
|
||||
最后,Clojure 还具备计算安全性,计算过程不会修改已有的数据,因此在神经网络的任何一层的原始值都会保留,每层计算都可以独立运行且函数永远幂等。
|
||||
|
||||
[Haskell](https://www.haskell.org/) 也有独特的优势,**它具有类型推断、惰性求值等特性**,被认为更适合用于机器学习。
|
||||
|
||||
类型推断即 Haskell 类型都是静态的,如果试图赋予错误的类型会报错。
|
||||
|
||||
Haskell 的另一个优势是可以非常清晰的描述数学模型。
|
||||
|
||||
想想一般数学模型是怎么描述函数的:
|
||||
|
||||
```text
|
||||
fn =>
|
||||
f1 = 1
|
||||
f2 = 9
|
||||
f3 = 16
|
||||
n > 2, fn = 3fn-3 + 2fn-2 + fn-1
|
||||
```
|
||||
|
||||
一般语言用 `if-else` 描述等价关系,但 Haskell 可以几乎原汁原味的还原函数定义过程:
|
||||
|
||||
```haskell
|
||||
solve :: Int -> Interger
|
||||
solve 1 = 1
|
||||
solve 2 = 9
|
||||
solve 3 = 16
|
||||
solve n = 3 * solve (n - 3) + 2 * solve (n - 2) + solve (n - 1)
|
||||
```
|
||||
|
||||
这使得阅读 Haskell 代码和阅读数学公式一样轻松。
|
||||
|
||||
> [原文](https://blog.jle.im/entry/purely-functional-typed-models-1.html)
|
||||
|
||||
Haskell 另一个优势是惰性求值,即计算会在真正用到时才进行,而不会在计算前提前消费掉,比如:
|
||||
|
||||
```haskell
|
||||
let x = [1..]
|
||||
let y = [2,4 ..]
|
||||
head (tail tail( (zip x y)))
|
||||
```
|
||||
|
||||
可以看到,`x` 与 `y` 分别是 `1,2,3,4,5,6...` 与 `2,4,6,8...` 的无限数组,而 `zip` 函数将其整合为一个新数组 `(1,2),(2,4),(3,6),(4,8)...` 这也是无限数组,如果将 `zip` 函数执行完那么程序就会永远执行下去。但 Haskell 却不会陷入死循环,而是直接输出第一位数字 `1`。这就是惰性计算的特性,无论数组有多长,只有真正用到某项时才对其进行计算,所以哪怕初始数据量或计算量很大,实际消耗的运算资源只取决于这次计算实际用到的部分。
|
||||
|
||||
由于深度学习数据量巨大,惰性求值可以忽略海量数据输入,大大提升计算性能。
|
||||
|
||||
## 3 总结
|
||||
|
||||
本文介绍了为什么深度学习更适合使用函数式语言,以及介绍了 Clojure 与 Haskell 语言的共性:安全性、高性能,以及各自独有的特性,证明了为何这两种语言更适合用在深度学习中。
|
||||
|
||||
在前端领域说到函数式或函数之美,大部分时候想到的是 Class Component 与 Function Component 的关系,这个理解是较为片面的。通过本文我们可以了解到,函数式的思想与数学表达式思想如出一辙,以写数学公式的思维方式写代码,就是一种较好的函数式编程思路。
|
||||
|
||||
函数式应该只有表达式,没有语句,这是因为函数式是为了处理运算而诞生的,因此很适合用在深度学习领域。
|
||||
|
||||
> 讨论地址是:[精读《深度学习 - 函数式之美》 · Issue #212 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/212)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,309 @@
|
||||
## 1 引言
|
||||
|
||||
[Nuxt](https://github.com/nuxt/nuxt.js) 是基于 Vue 的前端开发框架,这次我们通过 [Introduction toNuxtJS](https://www.youtube.com/watch?v=NS0io3Z75GI) 视频了解框架特色以及前端开发框架的基本要素。
|
||||
|
||||
> nuxt 与 [next](https://github.com/zeit/next.js) 结构很像,可以结合在一起看
|
||||
|
||||
视频介绍了 NuxtJs 的安装、目录结构、页面路由、导航模版、asyncData、meta、vueX。
|
||||
|
||||
这是一个入门级视频,所以上面所列举的特征都是一个前端开发框架的最核心的基本要素。一个前端开发框架,安装、目录结构、页面路由、导航模版一定是最要下功夫认真设计的。
|
||||
|
||||
asyncData 和 Vuex 都在解决数据问题,meta 则是通过约定语法控制网页 meta 属性,这部分值得与 React 体系做对比,在精读部分再展开。
|
||||
|
||||
Nuxtjs 前端开发框架不仅提供了脚手架的基本功能,还对项目结构、代码做了约定,以减少代码量。从这点可以看出,脚手架永远围绕两个核心目标:**让每一行源码都在描述业务逻辑;让每个项目结构都相同且易读**。
|
||||
|
||||
20 年前,几百行 HTML、Css、Js 代码就能完成一个完整的项目,只需要遵守 W3C 的基本规范就足够了,每一个项目代码都简单清晰,而且由于没有复杂的业务逻辑,导致代码结构也非常简单。但现在前端项目复杂度逐渐升高,一个大型项目源码数量可能达到几十万行、几百万行,这是 W3C 规范没有设想到的,因此出现了各种工程化与模块化方案解决这个复杂度问题,也引发了各个框架间约定的割裂,且设计合理程度各不相同。
|
||||
|
||||
Nuxtjs 等框架要做的就是定义支持现代大型项目的前端研发标准,这个规范具有网络效应,即用的人越多,价值越大。
|
||||
|
||||
接下来我们进入正题,看看 Nuxt 脚手架定义了怎样的开发规范。
|
||||
|
||||
## 2 概述
|
||||
|
||||
### 安装
|
||||
|
||||
使用 `npx create-nuxt-app app-name` 创建新项目。这个命令与 `create-react-app` 一样,区别主要是模版以及配置不同。
|
||||
|
||||
这个命令本质上是拉取一个模版到本地,并安装 `nuxt` 系列脚本作为项目依赖,并自动生成一系列 npmScripts:
|
||||
|
||||
```json
|
||||
{
|
||||
"scripts": {
|
||||
"dev": "nuxt",
|
||||
"build": "nuxt build",
|
||||
"start": "nuxt start",
|
||||
"generate": "nuxt generate",
|
||||
"lint": "eslint --ext .js,.vue --ignore-path .gitignore .",
|
||||
"test": "jest"
|
||||
},
|
||||
"dependencies": {
|
||||
"nuxt": "^2.0.0"
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
之后即可通过 `npm start` 等命令开发项目,对大部分项目来说,npmScripts 启动是最能达成共识的。
|
||||
|
||||
这种安装方式另一个好处是,依赖都被安装在了本地,即开发环境 100% 内置在项目中。Nuxt 没有采用全局 cli 命令方式执行,第一是 npmScripts 更符合大家通用习惯,不需要记住不同脚手架繁琐的名称与不同约定的启动命令,第二是全局脚手架一旦进行不兼容升级,老项目就面临维护难题。
|
||||
|
||||
### 目录结构
|
||||
|
||||
```text
|
||||
├── .nuxt
|
||||
├── layouts
|
||||
├── pages
|
||||
├── store
|
||||
├── assets
|
||||
├── static
|
||||
├── middleware
|
||||
├── plugins
|
||||
├── nuxt.config.js
|
||||
```
|
||||
|
||||
**pages**
|
||||
|
||||
页面文件存放的目录,路径 + 文件名即路由名,关于更多约定路由的信息,在下一节页面路由详细说明。
|
||||
|
||||
**layouts**
|
||||
|
||||
模版文件存放的目录,文件名即模版名,页面可以通过定义模版在选择使用的模版。
|
||||
|
||||
**store**
|
||||
|
||||
全局数据流目录,在 vueX 章节介绍。
|
||||
|
||||
**assets**、**static**
|
||||
|
||||
分别存放不需被编译的资源文件与非 `.vue` 的静态文件,比如 scss 文件。
|
||||
|
||||
由于 `.vue` 文件集成了 html、js、css,因此一般不会再额外定义样式文件在 static 文件夹中。
|
||||
|
||||
当然,这是 Vue 生态的特别之处,在 React 生态中会存在大量 `.scss` 文件混杂在各个目录中,比较影响阅读。
|
||||
|
||||
**middleware**、**plugins**
|
||||
|
||||
中间件与插件,这两个目录是可选的,作为一种定制化拓展能力。
|
||||
|
||||
**.nuxt**
|
||||
|
||||
为实现约定路由等便捷功能,启动项目时需要自动生成一些文件作为真正项目入口,这些文件就存储在 `.nuxt` 目录下,gitingore 且无需手动修改。
|
||||
|
||||
**nuxt.config.js**
|
||||
|
||||
nuxt 使用 js 文件作为配置文件,比 json 配置文件拓展性更好一些,这个文件也是整个项目唯一的配置文件。
|
||||
|
||||
基本上 **pages**、**layouts**、**store**、**assets**、以及唯一的配置文件基本成为现代前端开发框架的标配。
|
||||
|
||||
### 页面路由
|
||||
|
||||
nuxt 支持约定路由:
|
||||
|
||||
```text
|
||||
├── pages
|
||||
│ ├── home.vue
|
||||
│ └── index.vue
|
||||
```
|
||||
|
||||
上述目录结构描述了两个路由:`/` 与 `/home`。
|
||||
|
||||
也支持参数路由,只要以下划线作为前缀命名文件,就定义了一个动态参数路由:
|
||||
|
||||
```text
|
||||
├── pages
|
||||
│ ├── videos
|
||||
│ │ └── _id.vue
|
||||
```
|
||||
|
||||
`/videos/*` 都会指向这个文件,且可以通过 `$route.params.id` 拿到这个 url 参数。
|
||||
|
||||
另一个特性是嵌套路由:
|
||||
|
||||
```text
|
||||
├── pages
|
||||
│ ├── videos
|
||||
│ │ └── index.vue
|
||||
│ └── videos.vue
|
||||
```
|
||||
|
||||
`videos.vue` 与 `videos/index.vue` 都指向 `/videos` 这个路由,如果这两个文件同时存在,那么外层的 videos 就会作为外层拦截所有 `/videos` 文件夹下的路由,可以通过 `nuxt-child` 透出子元素:
|
||||
|
||||
```html
|
||||
# pages/videos.vue
|
||||
<template>
|
||||
<div>
|
||||
videos
|
||||
<nuxt-child />
|
||||
</div>
|
||||
</template>
|
||||
```
|
||||
|
||||
### 导航模版
|
||||
|
||||
页面公共逻辑,比如导航条可以放在模版里,模版的目录在 `layouts` 文件夹下。
|
||||
|
||||
默认 `layouts/default.vue` 对所有页面生效,但也可以创建例如 `layouts/videos.vue` 特殊导航文件,在 `pages/` 页面文件通过如下申明指定使用这个模版:
|
||||
|
||||
```html
|
||||
<script>
|
||||
export default {
|
||||
layout: "videos"
|
||||
};
|
||||
</script>
|
||||
```
|
||||
|
||||
### asyncData
|
||||
|
||||
`asyncData` 是 nuxt 支持的异步取数函数,可以替代 `data`。
|
||||
|
||||
`data` 函数:
|
||||
|
||||
```html
|
||||
<script>
|
||||
export default {
|
||||
data() {
|
||||
return {};
|
||||
}
|
||||
};
|
||||
</script>
|
||||
```
|
||||
|
||||
对于异步场景,可以用 `asyncData` 替代:
|
||||
|
||||
```html
|
||||
<script>
|
||||
export default {
|
||||
async asyncData() {
|
||||
return await fetch("/");
|
||||
}
|
||||
};
|
||||
</script>
|
||||
```
|
||||
|
||||
### meta
|
||||
|
||||
nuxt 允许在 `.vue` 页面文件自定义 head 标签信息:
|
||||
|
||||
```html
|
||||
<script>
|
||||
export default {
|
||||
headr() {
|
||||
return {
|
||||
title: "",
|
||||
meta: {
|
||||
charset: "utf-8"
|
||||
}
|
||||
};
|
||||
}
|
||||
};
|
||||
</script>
|
||||
```
|
||||
|
||||
这是开发框架提供的特性,不过在 React 体系下可以通过 `useTitle` 等自定义 Hooks 解决此问题,将框架功能降维到代码功能,会更容易理解些。
|
||||
|
||||
### vueX
|
||||
|
||||
nuxt 集成了 [vuex](https://github.com/vuejs/vuex),在 `store/` 文件夹下创建数据模型:
|
||||
|
||||
```js
|
||||
export const state = () => ({
|
||||
videos: [],
|
||||
currentVideo: {}
|
||||
})
|
||||
|
||||
export const mutations = {
|
||||
SET_VIDEOS (state, videos) {
|
||||
state.videos = videos
|
||||
}
|
||||
SET_CURRENT_VIDEO (state, video) {
|
||||
state.currentVideo = video
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
接下来就能在 `pages` 文件夹下的页面组件使用了:
|
||||
|
||||
```html
|
||||
<script>
|
||||
import { mapState } from "vuex";
|
||||
|
||||
export default {
|
||||
async fetch({ $axios, params, store }) {
|
||||
const reponse = await $axios.get(`/videos/${params.id}`);
|
||||
const video = response.data.data.arrtibutes;
|
||||
store.commit("SET_CURRENT_VIDEO", video);
|
||||
}
|
||||
};
|
||||
</script>
|
||||
```
|
||||
|
||||
将 `return` 替换为 `store.commit` 即可,更多语法可以参考 [vuex 文档](https://github.com/vuejs/vuex)。
|
||||
|
||||
## 3 精读
|
||||
|
||||
Nuxtjs 框架做了几件事情:
|
||||
|
||||
1. 统一执行命令。
|
||||
2. 统一开发框架。
|
||||
3. 统一目录与代码规范。
|
||||
4. 内置公共 utils 函数。
|
||||
|
||||
### 统一执行命令
|
||||
|
||||
命令行是所有开发者每天都要用上十几次甚至几十次的场景,试想一下团队中项目分别有如下这么多不同的启动命令会怎么样?
|
||||
|
||||
1. npm start.
|
||||
2. monkey dev.
|
||||
3. npm run ng.
|
||||
4. npm run bootstrap & banana start.
|
||||
5. ...
|
||||
|
||||
我永远不知道下一个项目该如何启动,这大大降低了开发效率。更严重的是,有的项目可以通过 `npm run docs` 查看文档,有的项目不能;有的项目 `npm run build` 可以触发编译,有的项目却无需编译,等等,所谓的环境不一致或者说迁移成本,学习成本,都是由最开始负责搭建项目脚手架的同学对架构设计不一致导致的,**然而没有必须用 `monkey dev` 才能运行起来的项目,但项目却可能因为被设计为 `monkey dev` 启动而显得与其他项目格格不入,甚至难以统一维护。**
|
||||
|
||||
Nuxtjs 等前端开发框架统一执行命令就是为了解决这个问题,统一开发者习惯需要很长的时间周期,但这个趋势不可挡。
|
||||
|
||||
### 统一开发框架
|
||||
|
||||
**虽然现在 React、Vue、Angular 框架各有利弊,但如果一个团队的项目同时使用了两个以上的框架,没有人会觉得这是一件好事。**
|
||||
|
||||
诚然每个框架都有自己的特点,在不同维度都一些优势,但三大框架能并存,说明各自都没有绝对的杀手锏来消灭对方。
|
||||
|
||||
对开源来说,多元化是活力的源动力,但对一家公司来说,多元化就是一场灾难,至今没有一个框架敢说自己的优势是 “与其他框架混合使用可以提升整体开发效率”。
|
||||
|
||||
前端开发框架要解决的最重要问题也是这一点,无论如何只能选择一种开发框架,Nuxtjs 选择了 Vue,Nextjs 选择了 React。
|
||||
|
||||
### 统一目录与代码规范
|
||||
|
||||
目录和代码规范不会从根本上影响项目的通用性,因为不同的目录结构可以通过映射来兼容,不同的代码规范不会影响代码执行。所以目录与代码规范真正影响的是一个程序员对项目的 “解码成本”。
|
||||
|
||||
所谓解码成本,就是程序员理解项目逻辑所需要的成本。如果你是一个销售主管,让团队周报统一用一种格式汇总绝对比 “用自己喜欢的方式汇总” 效率高,而对编程也一样,一个完全不同的目录结构和代码规范对程序员来说是巨大的阅读阻碍,甚至可能引发恶心反应。
|
||||
|
||||
所以不同的目录结构和代码规范是没有必要的壁垒,除非你的团队已经对某种规范产生达成了牢固的共识,否则最好和其他团队共享相同的目录结构与代码规范。改变代码规范是一件很难得事情,但只要不同规范的团队间产生了长期合作关系,规范统一就势必会被提上议程,那么为何不能在公司层面早一点达成共识,提前消除这种痛苦呢?
|
||||
|
||||
所以统一目录与代码规范是前端开发框架需要优先确定的,很多时候不要去质疑为什么目录叫 `layouts` 而不叫 `layout`,因为这个规范背后形成的协同网络规模越大,叫什么名字就越不重要。
|
||||
|
||||
### 内置公共 utils 函数
|
||||
|
||||
让业务开发更聚焦,还可以通过抽取通用的逻辑的方式解决,但需要解决两个问题:
|
||||
|
||||
1. 虽然将公共函数抽成 npm 包可以解决代码复用问题,但关键是怎么保证你的代码能被别人复用?
|
||||
2. 如何让业务通用的 utils 代码有效沉淀并从项目中移除?
|
||||
|
||||
脚手架内置公共 utils 函数就为了解决这个问题。上面几个小节解决了通用命令、框架、规范,但实际代码中,`router` `history` `fetch` `store` 等等概念也都是可以统一的,**没有一个项目必须用定制的 `fetch` 函数才能取数,但一开始就定制了 `fetch` 会导致耦合了不可预期的、没有必要的业务逻辑,成为理解与提效的阻碍。**
|
||||
|
||||
所以统一这些能统一的包,是进一步提效的关键。也许有人会觉得断了自己造轮子的路,但就像我们如今都不会重写浏览器内核逻辑一样,稳定的逻辑不仅带来了全行业的提效,还催生了前端岗位带来大量的就业,同样的,统一底层通用函数,其实是断了无意义产出这条路,每个人都有追求更高价值事情的权利,不要把自己困在反复造 `fetch` 函数这个低水平的活里。
|
||||
|
||||
## 4 总结
|
||||
|
||||
如果一个项目没有使用类似 Nuxtjs 开发框架,它面临的不仅仅是技术选型不统一的问题,久而久之这种项目势必成为 **代码孤岛**,当尘封在代码仓库几年后,一系列文档工具链接都失效后,就成为谁也不想碰,不敢碰的高危代码。
|
||||
|
||||
所以我们今天不仅要看到 Nuxtjs 提供的能力对项目开发有多么便捷,更要看到这类框架带来的协同效应有多么巨大,如果它不能成为整个前端的标准,至少要成为你们公司,或者你们团队的标准。
|
||||
|
||||
> 讨论地址是:[精读《Nuxtjs》 · Issue #213 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/213)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,702 @@
|
||||
## 1 引言
|
||||
|
||||
[React Conf 2019](https://www.youtube.com/watch?v=RCiccdQObpo) 在今年 10 月份举办,内容质量还是一如既往的高,如果想进一步学习前端或者 React,这个大会一定不能错过。
|
||||
|
||||
希望前端精读成为你学习成长路上的布道者,所以本期精读就介绍 React Conf 2019 - Day1 的相关内容。
|
||||
|
||||
总的来看,React Conf 今年的内容视野更广了,不仅仅有技术内容,还有宣扬公益、拓展到移动端、后端,最后还有对 web 发展的总结与展望。
|
||||
|
||||
前端世界正变得越来越复杂,可以看到大家对未来都充满了希望,永不停歇的探索精神是这场大会的主旋律。
|
||||
|
||||
## 2 概述 & 精读
|
||||
|
||||
本期大会思想、设计上的内容较多,具体实现层内容较少,因为行业领导者需要引领规范,而真正技术价值在于思维模型与算法,理解了解题思路,实现它其实并不难。
|
||||
|
||||
### 开发者体验与用户体验
|
||||
|
||||
- 开发者体验:DX(develop experience)
|
||||
- 用户体验:UX(user experience)
|
||||
|
||||
技术人解决的问题总是围绕 DX 与 UX,而一般来说,优化了 DX 往往会带来 UX 的提升,这是因为一个解决开发者体验的技术创新往往也会带来用户体验的升级,至少也能让开发者有更好的心情、更充足的时间做出好产品。
|
||||
|
||||
如何优化开发者体验呢?
|
||||
|
||||
**易上手**
|
||||
|
||||
React 确实致力于解决这个问题,因为 React 实际上是一个开发者桥梁,无论你开发 web、ios 还是单片机,都可以通过一套统一的语法去实现。React 是一个协议标准(读到 reactReconciler 章节会更有体感),React 像 HTML,但 React 不止能构建 HTML 应用,React 希望构建一切。
|
||||
|
||||
**高效开发**
|
||||
|
||||
React 解决调试、工具问题,让开发者更高效的完成工作,这也是开发者体验重要组成部分。
|
||||
|
||||
**弹性**
|
||||
|
||||
React 编写的程序拥有良好可维护性,包括数据驱动、模块化等等特征都是为了更好服务于不同规模的团队。
|
||||
|
||||
对于 UX 问题,React 也有 Concurrent mode、Suspense 等方案。
|
||||
|
||||
虽然 React 还不完美,但 React 致力于解决 DX 与 UX 的目标和效果都是我们有目共睹的,更好的 DX、UX 一定是前端技术未来发展的大趋势。
|
||||
|
||||
### 样式方案
|
||||
|
||||
Facebook 使用 css-in-js,而今年的 React conf 给出了一种技术方案,将 413 kb 的样式文件体积降低到 74kb!
|
||||
|
||||
一步步了解这个方案,从用法开始:
|
||||
|
||||
```tsx
|
||||
const styles = stylex.create({
|
||||
blue: { color: "blue" },
|
||||
red: { color: "red" }
|
||||
});
|
||||
|
||||
function MyComponent(props) {
|
||||
return <span className={styles("blue", "red")}>I'm red now!</span>;
|
||||
}
|
||||
```
|
||||
|
||||
如上是这个方案的写法,通过 `stylex.create` 创建样式,通过 `styles()` 使用样式。
|
||||
|
||||
**主题方案**
|
||||
|
||||
如果使用 CSS 变量定义主题,那么换肤就可以由最外层 `class` 轻松决定了:
|
||||
|
||||
```scss
|
||||
.old-school-theme {
|
||||
--link-text: blue;
|
||||
}
|
||||
|
||||
.text-link {
|
||||
color: var(--link-text);
|
||||
}
|
||||
```
|
||||
|
||||
字体颜色具体的值由外层 `class` 决定,因此外层的 `class` 就可以控制所有子元素的样式:
|
||||
|
||||
```html
|
||||
<div class="old-school-theme">
|
||||
<a class="text-link" href="...">
|
||||
I'm blue!
|
||||
</a>
|
||||
</div>
|
||||
```
|
||||
|
||||
将其封装成 React 组件,也不需要用 `context` 等 JS 能力,而是包裹一层 `class` 即可。
|
||||
|
||||
```tsx
|
||||
function ThemeProvider({ children, theme }) {
|
||||
return <div className={themes[theme]}>{children}</div>;
|
||||
}
|
||||
```
|
||||
|
||||
**图标方案**
|
||||
|
||||
下面是设计师给出的 svg 代码:
|
||||
|
||||
```tsx
|
||||
<svg viewBox="0 0 100 100">
|
||||
<path d="M9 25C8 25 8..." />
|
||||
</svg>
|
||||
```
|
||||
|
||||
将其包装为 React 组件:
|
||||
|
||||
```tsx
|
||||
function SettingsIcon(props) {
|
||||
return (
|
||||
<SVGIcon viewBox="0 0 100 100" {...props}>
|
||||
<path d="M9 25C8 25 8..." />
|
||||
</SVGIcon>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
结合上面提到的主题方案,就可以控制 svg 的主题颜色。
|
||||
|
||||
```tsx
|
||||
const styles = stylex.create({
|
||||
primary: { fill: "var(--primary-icon)" },
|
||||
gighlight: { fill: "var(--highlight-icon)" }
|
||||
});
|
||||
|
||||
function SVGIcon(color, ...props) {
|
||||
return (
|
||||
<svg>
|
||||
{...props}
|
||||
className={styles({
|
||||
primary: color === "primary",
|
||||
highlight: color === "highlight"
|
||||
})}
|
||||
{children}
|
||||
</svg>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
**减少样式大小的秘密**
|
||||
|
||||
```tsx
|
||||
const styles = stylex.create({
|
||||
blue: { color: "blue" },
|
||||
default: { color: "red", fontSize: 16 }
|
||||
});
|
||||
|
||||
function MyComponent(props) {
|
||||
return <span className={styles("default", props.isBlue && "blue")} />;
|
||||
}
|
||||
```
|
||||
|
||||
对于上述样式文件代码,最终会编译成 `c1`、`c2`、`c3` 三个 `class`:
|
||||
|
||||
```scss
|
||||
.c1 {
|
||||
color: blue;
|
||||
}
|
||||
.c2 {
|
||||
color: red;
|
||||
}
|
||||
.c3 {
|
||||
font-size: 16px;
|
||||
}
|
||||
```
|
||||
|
||||
出乎意料的是,并没有根据 `blue` 和 `default` 生成对应的 `class`,而是根据实际样式值生成 `class`,这样做有什么好处呢?
|
||||
|
||||
首先是加载顺序,`class` 生效的顺序与加载顺序有关,而按照样式值生成的 `class` 可以精确控制样式加载顺序,使其与书写顺序对应:
|
||||
|
||||
```tsx
|
||||
// 效果可能是 blue 而不是 red
|
||||
<div className="blue red" />
|
||||
|
||||
// 效果一定是 red,因为 css-in-js 在最终编排 class 时,虽然两种样式都存在,但书写顺序导致最后一个优先级最高,
|
||||
// 合并的时候就会舍弃失效的那个 class
|
||||
<div className={styles('blue', 'red')} />
|
||||
```
|
||||
|
||||
这么做永远不会出现头疼的样式覆盖问题。
|
||||
|
||||
更重要的是,随着样式文件的增多,`class` 总量会减少。这是因为新增的 `class` 涵盖的属性可能已经被其他 `class` 写到并生成了,此时会直接复用对应属性生成的 `class` 而不会生成新的:
|
||||
|
||||
```tsx
|
||||
<Component1 className=".class1"/>
|
||||
<Component2 className=".class2"/>
|
||||
```
|
||||
|
||||
```scss
|
||||
.class1 {
|
||||
background-color: mediumseagreen;
|
||||
cursor: default;
|
||||
margin-left: 0px;
|
||||
}
|
||||
.class2 {
|
||||
background-color: thistle;
|
||||
cursor: default;
|
||||
justify-self: flex-start;
|
||||
margin-left: 0px;
|
||||
}
|
||||
```
|
||||
|
||||
正如这个 Demo 所示,正常情况的 `class1` 与 `class2` 存在许多重复定义的属性,但换成 css-in-js 的方案,编译后的效果等价于将 `class` 复用并拆解了:
|
||||
|
||||
```tsx
|
||||
<Component1 classNames=".classA .classB .classD">
|
||||
|
||||
<Component2 classNames=".classA .classC .classD .classE">
|
||||
```
|
||||
|
||||
```scss
|
||||
.classA {
|
||||
cursor: default;
|
||||
}
|
||||
.classB {
|
||||
background-color: mediumseagreen;
|
||||
}
|
||||
.classC {
|
||||
background-color: thistle;
|
||||
}
|
||||
.classD {
|
||||
margin-left: 0px;
|
||||
}
|
||||
.classE {
|
||||
justify-self: flex-start;
|
||||
}
|
||||
```
|
||||
|
||||
这种方式不仅节省空间、还能自动计算样式优先级避免冲突,并将 413 kb 的样式文件体积降低到 74kb。
|
||||
|
||||
### 字体大小方案
|
||||
|
||||
`rem` 的好处是相对的字体大小,使用 `rem` 作为单位可以很方便实现网页字体大小的切换。
|
||||
|
||||
但问题是现在工业设计都习惯了以 px 作为单位,所以一种全新的编译方案产生了:在编译阶段将 `px` 自动转换成 `rem`。
|
||||
|
||||
这等于让以 `px` 为单位的字体大小可以跟随根节点字体大小随意缩放。
|
||||
|
||||
### 代码检测
|
||||
|
||||
静态检测类型错误、拼写错误、浏览器兼容问题。
|
||||
|
||||
在线检测 dom 节点元素问题,比如是否有可访问性,比如替代文案 aria-label。
|
||||
|
||||
### 提升加载速度
|
||||
|
||||
普通网页的加载流程是这样的:
|
||||
|
||||

|
||||
|
||||
先加载代码,然后会渲染页面,在渲染的同时发取数请求,等取数完成后才能渲染出真实数据。
|
||||
|
||||
那么如何改善这个情况呢?首先是预取数,提前解析出请求并在脚本加载的同时取数,可以节省大量时间:
|
||||
|
||||
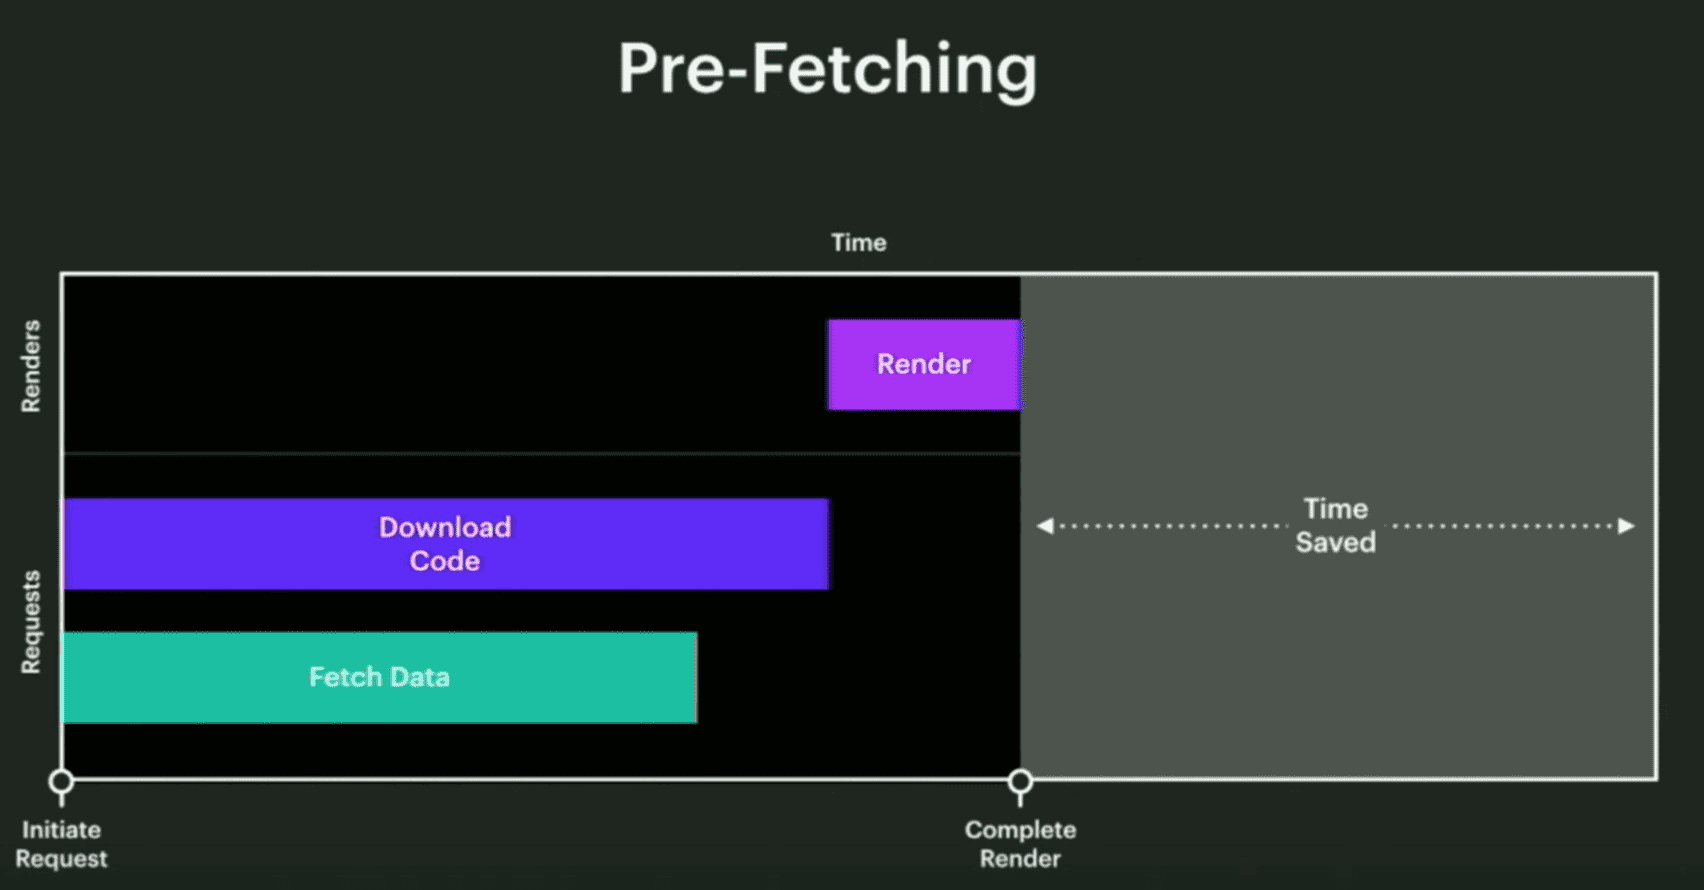
|
||||
|
||||
那么下载的代码可以再拆分吗?注意到并不是所有代码都作用于 UI 渲染,我们可以将模块分为 `ImportForDisplay` 与 `importForAfterDisplay` :
|
||||
|
||||

|
||||
|
||||
这样就可以优先加载与 UI 相关的代码,其余逻辑代码在页面展示出之后再加载:
|
||||
|
||||

|
||||
|
||||
这样可以实现源码分段加载,并分段渲染:
|
||||
|
||||

|
||||
|
||||
对取数来说也是如此,并不是所有取数都是初始化渲染阶段必须用上的。可以通过 `relay` 的特性 `@defer` 标记出可以延迟加载的数据:
|
||||
|
||||
```relay
|
||||
fragment ProfileData on User {
|
||||
classNameprofile_picture { ... }
|
||||
|
||||
...AdditionalData @defer
|
||||
}
|
||||
```
|
||||
|
||||
这下取数也可以分段了,首屏的数据会优先加载:
|
||||
|
||||

|
||||
|
||||
利用 `relay` 还可以以数据驱动方式结合代码拆分:
|
||||
|
||||
```relay
|
||||
... on Post {
|
||||
... on PhotoPost {
|
||||
@module('PhotoComponent.js')
|
||||
photo_data
|
||||
}
|
||||
|
||||
... on VideoPost {
|
||||
@module('VideoComponent.js')
|
||||
video_data
|
||||
}
|
||||
|
||||
... on SongPost {
|
||||
@module('SongComponent.js')
|
||||
song_data
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
这样首屏数据中也只会按需加载用到的部分,请求时间可以再次缩短:
|
||||
|
||||

|
||||
|
||||
可以看到,与 relay 结合可以进一步优化加载性能。
|
||||
|
||||
### 加载体验
|
||||
|
||||
可以 `React.Suspense` 与 `React.lazy` 动态加载组件。通过 `fallback` 指定元素的占位图可以提升加载体验:
|
||||
|
||||
```tsx
|
||||
<React.Suspense fallback={<MyPlaceholder />}>
|
||||
<Post>
|
||||
<Header />
|
||||
<Body />
|
||||
<Reactions />
|
||||
<Comments />
|
||||
</Post>
|
||||
</React.Suspense>
|
||||
```
|
||||
|
||||
`Suspense` 可以被嵌套,资源会按嵌套顺序加载,保证一个自然的视觉连贯性。
|
||||
|
||||
### 智能文档
|
||||
|
||||
通过解析 Markdown 自动生成文档大家已经很熟悉了,也有很多现成的工具可以用,但这次分享的文档系统有意思之处在于,可以动态修改源码并实时生效。
|
||||
|
||||

|
||||
|
||||
不仅如此,还利用了 Typescript + MonacoEditor 在网页上做语法检测与 API 自动提示,这种文档体验上升了一个档次。
|
||||
|
||||
虽然没有透露技术实现细节,但从热更新的操作来看像是把编译工作放在了浏览器 web worker 中,如果是这种实现方式,原理与 [CodeSandbox 实现原理](https://segmentfault.com/a/1190000019679430) 类似。
|
||||
|
||||
### GraphQL and Stuff
|
||||
|
||||
这一段在安利利用接口自动生成 Typescript 代码提升前后端联调效率的工具,比如 go2dts。
|
||||
|
||||
我们团队也开源了基于 swagger 的 Typescript 接口自动生成工具 [pont](https://github.com/alibaba/pont),欢迎使用。
|
||||
|
||||
### React Reconciler
|
||||
|
||||
这是知识密度最大的一节,介绍了如何使用 React Reconclier。
|
||||
|
||||
React Reconclier 可以创建基于任何平台的 React 渲染器,也可以理解为通过 React Reconclier 可以创建自定义的 ReactDOM。
|
||||
|
||||
比如下面的例子,我们尝试用自定义函数 `ReactDOMMini` 渲染 React 组件:
|
||||
|
||||
```jsx
|
||||
import React from "react";
|
||||
import logo from "./logo.svg";
|
||||
import ReactDOMMini from "./react-dom-mini";
|
||||
import "./App.css";
|
||||
|
||||
function App() {
|
||||
const [showLogo, setShowLogo] = React.useState(true);
|
||||
|
||||
let [color, setColor] = React.useState("red");
|
||||
React.useEffect(() => {
|
||||
let colors = ["red", "green", "blue"];
|
||||
let i = 0;
|
||||
let interval = setInterval(() => {
|
||||
i++;
|
||||
setColor(colors[i % 3]);
|
||||
}, 1000);
|
||||
|
||||
return () => clearInterval(interval);
|
||||
});
|
||||
|
||||
return (
|
||||
<div
|
||||
className="App"
|
||||
onClick={() => {
|
||||
setShowLogo(show => !show);
|
||||
}}
|
||||
>
|
||||
<header className="App-header">
|
||||
{showLogo && <img src={logo} className="App-logo" alt="logo /" />}
|
||||
// 自创语法
|
||||
<p bgColor={color}>
|
||||
Edit <code>src/App.js</code> and save to reload.
|
||||
</p>
|
||||
<a
|
||||
className="App-link"
|
||||
href="https://reactjs.org"
|
||||
target="_blank"
|
||||
rel="noopener noreferrer"
|
||||
>
|
||||
Learn React{" "}
|
||||
</a>
|
||||
</header>
|
||||
</div>
|
||||
);
|
||||
}
|
||||
|
||||
ReactDOMMini.render(<App />, codument.getElementById("root"));
|
||||
```
|
||||
|
||||
`ReactDOMMini` 是利用 `ReactReconciler` 生成的自定义组件渲染函数,下面是完整的代码:
|
||||
|
||||
```typescript
|
||||
import ReactReconciler from "react-reconciler";
|
||||
|
||||
const reconciler = ReactReconciler({
|
||||
createInstance(
|
||||
type,
|
||||
props,
|
||||
rootContainerInstance,
|
||||
hostContext,
|
||||
internalInstanceHandle
|
||||
) {
|
||||
const el = document.createElement(type);
|
||||
|
||||
["alt", "className", "href", "rel", "src", "target"].forEach(key => {
|
||||
if (props[key]) {
|
||||
el[key] = props[key];
|
||||
}
|
||||
});
|
||||
|
||||
// React 事件代理
|
||||
if (props.onClick) {
|
||||
el.addEventListener("click", props.onClick);
|
||||
}
|
||||
|
||||
// 自创 api bgColor
|
||||
if (props.bgColor) {
|
||||
el.style.backgroundColor = props.bgColor;
|
||||
}
|
||||
|
||||
return el;
|
||||
},
|
||||
|
||||
createTextInstance(
|
||||
text,
|
||||
rootContainerInstance,
|
||||
hostContext,
|
||||
internalInstanceHandle
|
||||
) {
|
||||
return document.createTextNode(text);
|
||||
},
|
||||
|
||||
appendChildToContainer(container, child) {
|
||||
container.appendChild(child);
|
||||
},
|
||||
appendChild(parent, child) {
|
||||
parent.appendChild(child);
|
||||
},
|
||||
appendInitialChild(parent, child) {
|
||||
parent.appendChild(child);
|
||||
},
|
||||
|
||||
removeChildFromContainer(container, child) {
|
||||
container.removeChild(child);
|
||||
},
|
||||
removeChild(parent, child) {
|
||||
parent.removeChild(child);
|
||||
},
|
||||
insertInContainerBefore(container, child, before) {
|
||||
container.insertBefore(child, before);
|
||||
},
|
||||
insertBefore(parent, child, before) {
|
||||
parent.insertBefore(child, before);
|
||||
},
|
||||
|
||||
prepareUpdate(
|
||||
instance,
|
||||
type,
|
||||
oldProps,
|
||||
newProps,
|
||||
rootContainerInstance,
|
||||
currentHostContext
|
||||
) {
|
||||
let payload;
|
||||
if (oldProps.bgColor !== newProps.bgColor) {
|
||||
payload = { newBgCOlor: newProps.bgColor };
|
||||
}
|
||||
return payload;
|
||||
},
|
||||
commitUpdate(
|
||||
instance,
|
||||
updatePayload,
|
||||
type,
|
||||
oldProps,
|
||||
newProps,
|
||||
finishedWork
|
||||
) {
|
||||
if (updatePayload.newBgColor) {
|
||||
instance.style.backgroundColor = updatePayload.newBgColor;
|
||||
}
|
||||
}
|
||||
});
|
||||
|
||||
const ReactDOMMini = {
|
||||
render(wahtToRender, div) {
|
||||
const container = reconciler.createContainer(div, false, false);
|
||||
reconciler.updateContainer(whatToRender, container, null, null);
|
||||
}
|
||||
};
|
||||
|
||||
export default ReactDOMMini;
|
||||
```
|
||||
|
||||
笔者拆解一下说明:
|
||||
|
||||
React 之所以具备跨平台特性,是因为其渲染函数 `ReactReconciler` **只关心如何组织组件与组件间关系,而不关心具体实现**,所以会暴露出一系列回调函数。
|
||||
|
||||
**创建实例**
|
||||
|
||||
由于 React 组件本质是一个描述,即 `tag` + 属性,所以 `Reconciler` 不关心元素是如何创建的,需要通过 `createInstance` 拿到组件基本属性,在 Web 平台利用 DOM API 实现:
|
||||
|
||||
```typescript
|
||||
createInstance(
|
||||
type,
|
||||
props,
|
||||
rootContainerInstance,
|
||||
hostContext,
|
||||
internalInstanceHandle
|
||||
) {
|
||||
const el = document.createElement(type);
|
||||
|
||||
["alt", "className", "href", "rel", "src", "target"].forEach(key => {
|
||||
if (props[key]) {
|
||||
el[key] = props[key];
|
||||
}
|
||||
});
|
||||
|
||||
// React 事件代理
|
||||
if (props.onClick) {
|
||||
el.addEventListener("click", props.onClick);
|
||||
}
|
||||
|
||||
// 自创 api bgColor
|
||||
if (props.bgColor) {
|
||||
el.style.backgroundColor = props.bgColor;
|
||||
}
|
||||
|
||||
return el;
|
||||
}
|
||||
```
|
||||
|
||||
之所以说 React 对 DOM 事件都做了一层代理,是因为 JSX 的所有函数都没有真正透传给 DOM,而是通过类似 `el.addEventListener("click", props.onClick)` 的方式代理实现的。
|
||||
|
||||
而自定义这个函数,我们甚至能创建例如 `bgColor` 这种特殊语法,只要解析引擎实现了这个语法的 Handler。
|
||||
|
||||
除此之外,还有 **创建、删除实例** 的回调函数,我们都要利用 DOM 平台的 API 重新实现一遍,这样不仅可以实现对浏览器 API 的兼容,还可以对接到比如 react-native 等非 WEB 平台。
|
||||
|
||||
**更新组件**
|
||||
|
||||
实现了 `prepareUpdate` 与 `commitUpdate` 才能完成组件更新。
|
||||
|
||||
`prepareUpdate` 返回的 `payload` 被 `commitUpdate` 函数接收到,并根据接收到的信息决定如何更新实例节点。这个实例节点就是 `createInstance` 回调函数返回的对象,所以如果在 WEB 环境返回的 instance 就是 DOMInstance,后续所有操作都使用 DOMAPI。
|
||||
|
||||
总结一下:`react` 主要用平台无关的语法生成具有业务含义的 AST,而利用 `react-reconciler` 生成的渲染函数可以解析这个 AST,并提供了一系列回调函数实现完整的 UI 渲染功能,`react-dom` 现在也是基于 `react-reconciler` 写的。
|
||||
|
||||
### 图标体积优化
|
||||
|
||||
Facebook 团队通过优化,将图标大小从 4046.05KB 降低到了 132.95kb,体积减少了惊人的 96.7%,减少体积占总包体积的 19.6%!
|
||||
|
||||
实现方式很简单,下面是原始图标使用的代码:
|
||||
|
||||
```jsx
|
||||
<FontAwesomeIcon icon="coffee" />
|
||||
<Icon icon={["fab", "twitter"]} />
|
||||
<Button leftIcon="user" />
|
||||
<FeatureGroup.Item icon="info" />
|
||||
<FeatureGroup.Item icon={["fail", "info"]} />
|
||||
```
|
||||
|
||||
在编译期间通过 AST 分析,将所有字符串引用换成了图标实例的引用,利用 webpack 的 tree-shaking 功能实现按需加载,从而删除了没有使用到的图标。
|
||||
|
||||
```jsx
|
||||
import {faCoffee,faInfo,faUser} from "@fontawesome/free-solid-svg-icons"
|
||||
import {faTwitter} from '@fontawesome/free-brands-svg-icons'
|
||||
import {faInfo as faInfoFal} from '@fontawesome/pro-light-svg-icons'
|
||||
|
||||
<FontAwesomeIcon icon={faCoffee} />
|
||||
<Icon icon={faTwitter} />
|
||||
<Button leftIcon={faUser} />
|
||||
<FeatureGroup.Item icon={faInfo} />
|
||||
<FeatureGroup.Item icon={faInfoFal} />
|
||||
```
|
||||
|
||||
[替换工具](https://github.com/skovy/font-awesome-codemod) 的链接放出来了,感兴趣的同学可以点进去了解更多。
|
||||
|
||||
这也从某种意义上说明了 iconFont 注定被淘汰,因为字体文件目前无法按需加载,只有全部使用 SVG 图标的项目才能使用这种优化。
|
||||
|
||||
### Git & Github
|
||||
|
||||
这一节介绍了基本 Git 知识以及 Github 用法,笔者略过比较水的部分,直接列出两个可能你不知道的点:
|
||||
|
||||
**干预 Github 项目主要语言检测**
|
||||
|
||||
如果你提交的代码包含许多自动生成的文件,可能你实际使用的语言不会被 Github 解析为主要语言,这时候可以通过 `.gitattributes` 文件忽略指定文件夹的检测:
|
||||
|
||||
```text
|
||||
static/* linguist-vendored
|
||||
```
|
||||
|
||||
这样语言文件占比统计就会忽略 `static/` 文件夹。
|
||||
|
||||
**Git hooks 的技巧**
|
||||
|
||||
以下是几个比较具有启发的点,我们可以利用 Git hooks 做点什么:
|
||||
|
||||
- 阻止提交到 master。
|
||||
- 在 commit 之前执行 prettier/eslint/jest 检测。
|
||||
- 检测代码规范、合并冲突、检测是否有大文件。
|
||||
- commit 成功后给出提示或记录到日志。
|
||||
|
||||
但 Git hooks 仍然有局限性:
|
||||
|
||||
- 容易被绕过:--no-verifuy --no-merge --no-checkout ---force。
|
||||
- 本地 hooks 无法提交,导致项目开发规则可能不尽相同。
|
||||
- 无法替代 CI、服务端分支保护、Code Review。
|
||||
|
||||
可以畅想一下,在 WebIDE 环境可以通过自定义 git 命令禁止检测绕过,自然解决第二条环境不一致的问题。
|
||||
|
||||
### GraphQL + Typescript
|
||||
|
||||
GraphQL 是没有类型支持的,如果要手动创建一遍类型文件是非常痛苦的:
|
||||
|
||||
```typescript
|
||||
interface GetArticleData {
|
||||
getArticle: {
|
||||
id: number;
|
||||
title: string;
|
||||
};
|
||||
}
|
||||
|
||||
const query = graphql(gql`
|
||||
query getArticle {
|
||||
article {
|
||||
id
|
||||
title
|
||||
}
|
||||
}
|
||||
`);
|
||||
|
||||
apolloClient.query<GetArticleData>(query);
|
||||
```
|
||||
|
||||
同样的代码分散在两处维护一定会带来问题,我们可以利用比如 `typed-graphqlify` 这种库解决类型问题:
|
||||
|
||||
```typescript
|
||||
import { params, types, query } from "typed-graphqlify";
|
||||
|
||||
const getArticleQuery = {
|
||||
article: params({
|
||||
id: types.number,
|
||||
title: types.string
|
||||
})
|
||||
};
|
||||
|
||||
const gqlString = query("getUser", getUserQuery);
|
||||
```
|
||||
|
||||
只要一遍定义就可以自动生成 GQLString,并且拿到 Typescript 类型。
|
||||
|
||||
### React 文档国际化
|
||||
|
||||
即便是谷歌翻译也不是很靠谱,国际化文档还是要靠人肉,[Nat Alison](https://github.com/tesseralis) 利用 Github 充分发动各国人民的力量,共同打造了一个个 reactjs group 下的国际化仓库。
|
||||
|
||||
国际化仓库命名规则是 `reactjs/xx.reactjs.org`,比如简体中文的国际化仓库是:https://github.com/reactjs/zh-hans.reactjs.org
|
||||
|
||||
从仓库的 readme 可以看到维护规则是这样的:
|
||||
|
||||
- 请 fork 这个仓库。
|
||||
- 基于 fork 后的仓库中 master 分支拉取一个新的分支(名字自取)。
|
||||
- 翻译(校对)你所选择的文章,提交到新的分支。
|
||||
- 此时提交 Pull Request 到该仓库。
|
||||
- 会有专人 Review 该 Pull Request,当两人以上通过该 Pull Request 时,你的翻译将被合并到仓库中。
|
||||
- 删除你所创建的分支(如继续参与,参考同步流程)。
|
||||
|
||||
之后定期从 React 官方文档项目拉取最新代码即可保持文档的同步更新。
|
||||
|
||||
### 你需要 redux 吗?
|
||||
|
||||
关于数据流的话题目前没有什么新意,但这次 React Conf 关于数据流总结的算是比较真诚的,总结了以下几个点:
|
||||
|
||||
1. 全局数据流现在不是必须的,比如 Redux,但也不能说完全不能用,至少在全局状态较为复杂时有必要使用。
|
||||
2. 不要只使用一种数据流方案,根据状态的作用域确定方案比较好。
|
||||
3. 工程技术与科学不同,工程世界没有最好的方案,只有更好的方案。
|
||||
4. 就算有了完美方案也不要停止学习的步伐,总会有新知识产生。
|
||||
|
||||
### web 历史
|
||||
|
||||
很精彩的演讲,不过新鲜内容并不多,比较有感触一点是:以前的网页地址对应到的是服务器磁盘的某个具体文件,比如早期 php 应用,现在后端不再是文件化而是服务化了,这层抽象让服务端摆脱了对文件结构的依赖,可以构建更多复杂动态逻辑,也支持了前后端分离的技术方案。
|
||||
|
||||
## 3 总结
|
||||
|
||||
这届 React Conf 让我们看到前端更多的可能性,我们不仅要关注技术实现细节,更要关注行业标准以及团队愿景。
|
||||
|
||||
React 团队的愿景是让 React 包罗万象,提升全球开发者的开发体验、提升全球产品的用户体验,基于这个目标,React Conf 自然不能只包含 DOM Diff、Reconciler 等等技术细节,更需要展示 React 如何帮助全球开发者,如何让这些开发者帮助到用户,如何推动行业标准的演进,如何让 React 打破国界、语言的壁垒。
|
||||
|
||||
相比其他前端大会非常多的干货来说,React Conf 虽然显得主题比较杂,但这正是人文情怀的体现,我相信只有带着更高的使命愿景,真诚帮助他人的技术团队才可以走得更远。
|
||||
|
||||
> 讨论地址是:[精读《React Conf 2019 - Day1》 · Issue #214 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/214)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,630 @@
|
||||
## 1 引言
|
||||
|
||||
这是继 [精读《React Conf 2019 - Day1》](https://github.com/dt-fe/weekly/blob/v2/127.%E7%B2%BE%E8%AF%BB%E3%80%8AReact%20Conf%202019%20-%20Day1%E3%80%8B.md) 之后的第二篇,补充了 React Conf 2019 第二天的内容。
|
||||
|
||||
## 2 概述 & 精读
|
||||
|
||||
第二天的内容更为精彩,笔者会重点介绍比较干货的部分。
|
||||
|
||||
### Fast refresh
|
||||
|
||||
[Fast refresh](https://facebook.github.io/react-native/docs/fast-refresh) 是更好的 react-hot-loader 替代方案,目前仅支持 react-native 平台,很快就会支持 react-dom 平台。
|
||||
|
||||
相比不支持 Function component、无法错误恢复、更新经常失灵的 hot reloading 来说,fast refresh 还拥有以下几个优点:
|
||||
|
||||
- 状态保持。
|
||||
- 支持 Function Component Hooks。
|
||||
- 更快的更新速度。
|
||||
|
||||
Fast refresh 更新速度更快,是基于 Function Component 生成了 “签名”,从而最大成都避免销毁重渲染,尽可能保持对组件的 rerender 刷新。下面介绍签名机制的工作原理。
|
||||
|
||||
Fast refresh 对每个 Function component 都生成了一份专属签名,用以描述这个组件核心状态,当这个核心状态改变时,就只能销毁重渲染了,但对于不触及核心的修改就能进行代价非常小的 rerender。
|
||||
|
||||
这个签名包含了 hooks 和参数名:
|
||||
|
||||
```js
|
||||
// signature: "useState{isLoggedIn}"
|
||||
|
||||
function ExampleComponent() {
|
||||
const [isLoggedIn, setIsLoggedIn] = useState(true);
|
||||
}
|
||||
```
|
||||
|
||||
比如当参数名变更时,这个组件的逻辑已发生改动,此时只能销毁并重渲染了。因此实际上通过对签名的对比来判断是否要销毁并重刷新组件:
|
||||
|
||||
```js
|
||||
// signature: "useState{isLoggedOut}"
|
||||
|
||||
function ExampleComponent() {
|
||||
const [isLoggedOut, setIsLoggedOut] = useState(true);
|
||||
}
|
||||
```
|
||||
|
||||
同理,当 hooks 从 `useState` 改成了 `useReducer`,签名也会发生变化从而导致彻底的重渲染。
|
||||
|
||||
但除此之外,**比如对样式的修改、Dom 结构的修改都不会触发签名的变化**,从而保证了 “对不触及逻辑的改动进行高效的轻量 renreder”。
|
||||
|
||||
然而 Fast refresh 也有如下局限性:
|
||||
|
||||
- 还不能友好支持 Class component。
|
||||
- 混合导出 React 和非 React 组件时无法精确的 hot reload。
|
||||
- 更高的内存要求。
|
||||
|
||||
可以看到,Fast Refresh 随着功能推广与内置,现在已经覆盖了 Facebook 95% 以上 hot reload 场景了:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1bjm1mYr1gK0jSZR0XXbP8XXa-1598-1018.png">
|
||||
|
||||
这部分内容不仅揭开了 hot reload 技术内幕,还对其功能进行了进一步优化,2019 年的 React 开发体系已经进入精细化阶段。
|
||||
|
||||
### 重写 React devtools
|
||||
|
||||
React devtools 的更新终于被正式介绍了,本来笔者以为新的 devtools 只是支持了 hooks,但听完分享后发现还有更多有用的改进,包括:
|
||||
|
||||
- 更高的性能。
|
||||
- 更多特性支持。
|
||||
- 更好用户体验。
|
||||
|
||||
**找到节点渲染链路**
|
||||
|
||||
并不是每个 React 节点都参与渲染,新版 React devtools 可以展示出 rendered by:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1OSWomV67gK0jSZPfXXahhFXa-2354-668.png">
|
||||
|
||||
**调试 Suspense**
|
||||
|
||||
在 Day1 中讲到的 Suspense 特性可以在 React devtools 调试了:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1W790m4D1gK0jSZFsXXbldVXa-1816-660.png">
|
||||
|
||||
通过点击时钟 icon,可以模拟 Suspense 处于 pendding 或 ready 状态。
|
||||
|
||||
**增强调试能力**
|
||||
|
||||
可以通过点击直接跳转到组件源码:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1IBK1m4n1gK0jSZKPXXXvUXXa-1806-772.png">
|
||||
|
||||
最新版已增强至点击按钮后直接通过 Source 打开源码位置,**这样可以快速通过 UI 寻找到代码**。同时还可以看到,通过点击 debugger 按钮将当前组件信息打到控制台调试。
|
||||
|
||||
除此之外还可以动态修改组件的 props 与 hook state,大大增强了调试能力。
|
||||
|
||||
**profiler**
|
||||
|
||||
分析工具也得到了增强,现在可以看到每个组件被渲染了几次以及重新渲染的原因:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1cla1m7P2gK0jSZPxXXacQpXa-1824-690.png">
|
||||
|
||||
比如上图组件被渲染了 4 次,主要有两个原因:Hooks 改变与 Props 改变。
|
||||
|
||||
除此之外,还优化了更多细节体验,比如高亮搜索、HOC 的展示优化、嵌套层级过多时不会占用过多的横向宽度等等。
|
||||
|
||||
### react codemod
|
||||
|
||||
codemod 是一个代码重构的方式,通过 AST 方式精准触达代码,我们可以认为 codemod 是一个更聪明的“查找/替换”。
|
||||
|
||||
codemod 主要有以下三种使用方式:
|
||||
|
||||
- 重命名。
|
||||
- 代码排序。
|
||||
- 一定程度的代码替换。
|
||||
|
||||
接下来就讲到 [react codemod](https://github.com/reactjs/react-codemod) 了,它是 react 场景的 codemod 解决方案,facebook 是这么使用 react codemod 的:
|
||||
|
||||
- 迁移 facebook 代码。
|
||||
- 涉及几万个组件。
|
||||
- 修复了 3500 个文件的 React.PropTypes。
|
||||
- 修复了 8500 个文件的生命周期 unsafe。
|
||||
- 修复了 20000 个文件的 createClass 转 JSX。
|
||||
|
||||
使用方式:
|
||||
|
||||
```bash
|
||||
npx react-codemod React-PropTypes-to-prop-types
|
||||
```
|
||||
|
||||
可以看到,通过 cli 对文件进行一次性重构处理。除此之外,再列举几种使用场景:
|
||||
|
||||
- create-element-to-jsx 将 `React.createElement` 转换为 JSX。
|
||||
- error-boundaries 将 `unstable_handleError` 改为 `componentDidCatch`。
|
||||
- findDOMNode 将 `React.createClass` 中 `this.getDOMNode()` 改为 `React.findDOMNode`。
|
||||
- sort-comp 将 Class Component 生命周期按照规范排序,[eslint-plugin-react](https://github.com/yannickcr/eslint-plugin-react/blob/master/docs/rules/sort-comp.md) 插件也有相同能力。
|
||||
|
||||
理论上来讲,所有 codemode 做的事情都可以替换为 eslint 的 autofix 来完成,比如 sort-comp 就同时被 codemode 和 eslint 支持。
|
||||
|
||||
### Suspense
|
||||
|
||||
要理解 Suspense,就要理解 Suspense 与普通 loading 有什么区别。
|
||||
|
||||
从代码角度来说,Suspense 可以类比为 `try/catch` 的体验。为了简化代码复杂度,我们可以用 `try/catch` 包裹代码,从而简化 try 区块代码复杂度,并将兜底代码放在 catch 区块:
|
||||
|
||||
```js
|
||||
try {
|
||||
// 只要考虑正确情况
|
||||
} catch {
|
||||
// 错误时 fallback
|
||||
}
|
||||
```
|
||||
|
||||
Suspense 也一样,它在渲染 React 组件时如果遇到了 Promise 抛出的 Error,就会进入 `fallback`,所以 `fallback` 含义是 Loading 中状态:
|
||||
|
||||
```jsx
|
||||
<Suspense fallback={<Spinner />}>
|
||||
<ProfilePage />
|
||||
</Suspense>
|
||||
```
|
||||
|
||||
与此同时,实际业务组件中的取数也不需要担心取数是否正在进行中,只要直接处理拿到数据的情况就好了:
|
||||
|
||||
```jsx
|
||||
function ProfileDetails() {
|
||||
// 直接使用 user,不用担心失败。
|
||||
const user = resource.user.read();
|
||||
return <h1>{user.name}</h1>;
|
||||
}
|
||||
```
|
||||
|
||||
进一步的,如果要处理组件渲染的异常,再使用 `ErrorBoundary` 包裹即可,此时的 `fallback` 含义是组件加载异常的错误状态:
|
||||
|
||||
```jsx
|
||||
function Home(props) {
|
||||
return (
|
||||
<ErrorBoundary fallback={<ErrorMessage />}>
|
||||
<Suspense fallback={<Placeholder />}>
|
||||
<Composer />
|
||||
</Suspense>
|
||||
</ErrorBoundary>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
Suspense 模式的取数好处是 “fetch on render”,即渲染与取数同时进行,而普通模式的取数是 “fetch after render”,即渲染完成后再通过 `useEffect` 取数,此时取数时机已晚。
|
||||
|
||||
**队列加载**
|
||||
|
||||
假设 `Composer` 与 `NewsFeed` 组件内部都通过 `useQuery` 取数,那么并行取数时加载机制如下:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1AonZm7L0gK0jSZFtXXXQCXXa-1770-778.png">
|
||||
|
||||
这可能有两个问题:组件内部加载顺序不统一与组件间加载顺序不统一。
|
||||
|
||||
如果组件内部有图片,可能图片与组件渲染实际不一致,此时可以利用 Suspense 统一 hold 所有子组件的特性,将图片加载改为 Suspense 模式:
|
||||
|
||||
```jsx
|
||||
<div>
|
||||
<YourImage src={uri} alt={...} />
|
||||
<MoreComposer />
|
||||
</div>
|
||||
```
|
||||
|
||||
同一个 Suspense 可以等待所有子元素都 Ready 后才会一把渲染出 UI,因此可以看到网页被一次性刷新而不是分部刷新。
|
||||
|
||||
第二个问题是组件间加载顺序不统一,可能导致先渲染了文章内容,再渲染出文章头部,此时如果区块高度不固定,文章头部可能会撑开,导致文章内容下移,用户的阅读体验会遭到打断。可以通过 `suspense ordering` 解决这个问题:
|
||||
|
||||
```jsx
|
||||
function Home(props) {
|
||||
return (
|
||||
<SuspenseList revealOrder="forwards">
|
||||
<Suspense fallback={<ComposerFallback />}>
|
||||
<Composer />
|
||||
</Suspense>
|
||||
<Suspense fallback={<FeedFallback />}>
|
||||
<NewsFeed />
|
||||
</Suspense>
|
||||
</SuspenseList>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
比如 `forwards` 表示从上到下,那么一定会先渲染头部再渲染文章内容,这样文章内容就不会都抖动了。
|
||||
|
||||
### Render as you fetch
|
||||
|
||||
相比 “fetch on render”,更高级别的优化是 “Render as you fetch”,即取数在渲染时机之前。
|
||||
|
||||
比如页面路由的跳转、Hover 到一个区块,此时如果取数由这个动作触发,就可以再次将取数时机提前,Facebook 为此创造了一个新的 Hook:`usePreloadedQuery`。
|
||||
|
||||
用法是,在某个事件中取数,比如点击页面跳转按钮时,通过 `preloadQuery` 预取数,得到的结果并不是取数结果,而是一个标识,在渲染组件中,把这个标识传给 `usePreloadedQuery` 可以拿到真实取数结果:
|
||||
|
||||
```js
|
||||
// 组件 A 的 onClick
|
||||
const reference = preloadQuery(query, variables);
|
||||
// 组件 B 的 render
|
||||
const data = usePreloadedQuery(query, reference);
|
||||
```
|
||||
|
||||
可以看到,取数真正触发的时机在渲染函数执行之前,所以在 `usePreloadedQuery` 调用时取数肯定已经在路上,甚至已经完成。相比之下,普通的 `useQuery` 函数存在下面几个问题:
|
||||
|
||||
- 由于取数过程存在状态变化,可能导致组件在 “取数无意义” 状态下重新渲染多次。
|
||||
- 可能取数还未完成就触发重渲染。
|
||||
- 没有取消的机制,没有清除结果的机制。
|
||||
- 没有办法唯一标识组件。
|
||||
|
||||
preloadQuery 的好处就是将取数时机与 UI 分离,这样可以更细粒度的控制逻辑:
|
||||
|
||||
- 调用 preloadQuery 时:
|
||||
- 在组件销毁时取消取数。
|
||||
- 有新取数触发时取消取数。
|
||||
- 销毁一些轮询机制。
|
||||
- 渲染组件调用 usePreloadedQuery 时:
|
||||
- 不会再触发取数,不会触发意外的 re-render。
|
||||
- 不需要清空,因为取数不在这里发起。
|
||||
- 不需要清理轮询。
|
||||
|
||||
可见 preloadQuery 相比 useQuery 的确有了一些体验提升,然而这个优化比较追求极致,对大部分国内项目来说可能还走不到 facebook 这么极致的性能优化,所以投入产出比显得不是那么高,而且这个开发方式对开发者不是太友好,因为它让请求的时机割裂到两个模块中。
|
||||
|
||||
但毕竟用户体验是大于开发者体验的,React 尽量通过提高开发者体验来间接提高用户体验,使双方都满意,但像 preloadQuery 就无法两者兼顾了,为了用户体验可以适当的降低一些开发者体验。
|
||||
|
||||
### 如何维护代码
|
||||
|
||||
这个分享讲述了如何提升代码维护效率,毕竟一个月后可能连自己写的代码都看不懂了。[hydrosquall](http://github.com/hydrosquall) 通过类比地图的方式解释了程序员是如何维护代码的。
|
||||
|
||||
首先看我们是如何认路的。认路分为三个层次:
|
||||
|
||||
- 随意走走。
|
||||
- 通过一些地标判断方向。
|
||||
- 有方向的寻路。
|
||||
- 通过跟随同伴或者了解更多本地信息找到目的地。
|
||||
- 地图。
|
||||
- 通过 GPS 定位。
|
||||
- 通过模拟地图方式指出路线。
|
||||
|
||||
可以看到这三种方式是逐层递进的,那么类比到代码就有意思了:
|
||||
|
||||
- 随意走走(滚动查看源代码 + ctrl/f 查找代码 + grep 搜索)。
|
||||
- 入口(找到入口节点,查看数据结构)。
|
||||
- 标记(查看代码注释、查看 README)。
|
||||
- 发信号弹(断点、console.log 等调试行为)
|
||||
- 找到方向。
|
||||
- git blame 查看 owner,或直接根据文档找到 codeowners。
|
||||
- 地图。
|
||||
- 幸运的话你可以找到一份架构流程图。
|
||||
|
||||
可以看到,地图有几种抽象层次,比如忽略了细节的纽约地铁线路图:
|
||||
|
||||
<img width=400 src="https://img.alicdn.com/tfs/TB14k7pmYr1gK0jSZR0XXbP8XXa-1014-702.png">
|
||||
|
||||
或者是包含丰富地面信息的地铁线路图:
|
||||
|
||||
<img width=400 src="https://img.alicdn.com/tfs/TB1Sbwpm.T1gK0jSZFrXXcNCXXa-692-750.png">
|
||||
|
||||
抽象到什么层次取决于用户使用的场景,那么代码抽象也是如此。[hydrosquall](http://github.com/hydrosquall) 做了一个工具自动分析出代码调用关系:[js-callgraph](https://github.com/persper/js-callgraph)
|
||||
|
||||

|
||||
|
||||
这就像路牌一样,可以更高效的看出代码结构,也包括了数据流结构,由于篇幅限制,感兴趣的同学可以看 [原视频](https://youtu.be/JDDxR1a15Yo?t=6579) 了解更多。
|
||||
|
||||
### 写作与写代码
|
||||
|
||||
本章讲了写作(小说)与写代码的关联,总结出如下几个重点:
|
||||
|
||||
- 写小说和写代码都是创造行为。
|
||||
- 写代码需要抽象思维,写小说也要有抽象思维构造人物和情节。
|
||||
- Show, don't tell,写作天然就是申明式的,和数据驱动很相似。
|
||||
|
||||
更多可以去看 [原视频](https://youtu.be/JDDxR1a15Yo?t=9135)。
|
||||
|
||||
### 移动端动画最佳实践
|
||||
|
||||
首先要使用一个真实的手机设备调试,否则可能出现 PC Chrome 一切正常,而手机上实际效果性能很差的情况!
|
||||
|
||||
**手势下拉退出**
|
||||
|
||||
利用 [react-spring](https://github.com/react-spring/react-spring) 和 [react-use-gesture](react-use-gesture) 做一个下滑消失的 Demo:
|
||||
|
||||
```jsx
|
||||
import { animated, useSpring } from "react-spring";
|
||||
import { useDrag } from "react-use-gesture";
|
||||
|
||||
const [{ y }, set] = useSpring(() => {
|
||||
y: 0;
|
||||
});
|
||||
```
|
||||
|
||||
首先定义一个 `y` 纵向位置,通过 `useDrag` 将拖拽操作与 UI 绑定,通过回调将其与 `y` 数据绑定:
|
||||
|
||||
```js
|
||||
const bind = useDrag(({ last, movement: [, movementY], memo = y.value }) => {
|
||||
if (last) {
|
||||
// 拖拽结束时,如果偏移量超过 50 则效果和结束一样,直接将 y 设置为 100
|
||||
const notificationClosed = movementY > 50;
|
||||
|
||||
return set({
|
||||
y: notificationClosed ? 100 : 0,
|
||||
onReset: notificationClosed && removeNotification
|
||||
});
|
||||
}
|
||||
|
||||
// y 的位置区间在 0~100
|
||||
set([{ y: clamp(0, 100, memo + movementY) }]);
|
||||
|
||||
return memo;
|
||||
});
|
||||
```
|
||||
|
||||
将 `useDrag` 与 `y` 绑定后,就可以用在 UI 组件上了:
|
||||
|
||||
```jsx
|
||||
<StyledNotification
|
||||
as={animated.div}
|
||||
onTouchStart={bind().onTouchStart}
|
||||
style={{
|
||||
opacity: y.interpolate([0, 100], [1, 0]),
|
||||
transform: y.interpolate(y => `translateY(${y}px)`)
|
||||
}}
|
||||
/>
|
||||
```
|
||||
|
||||
将 `opacity` 与 `transform` 与位置 `y` 绑定就可以做出下拉消失的效果。
|
||||
|
||||
**滑动的洞见**
|
||||
|
||||
接着讲到了滑动的三个洞见:
|
||||
|
||||
1. 要立刻响应,任何延迟都会造成用户额外精神负担。
|
||||
2. 滚动速度衰减可以提升用户体验:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1HocDm1H2gK0jSZJnXXaT1FXa-1348-878.gif">
|
||||
|
||||
接着我们需要预测用户的意图,比如在一个类似微信消息列表页左右滑动时:
|
||||
|
||||
- 是否想取消手势交互?
|
||||
- 是否想展示出更多交互按钮?
|
||||
- 是否想删除所有内容?
|
||||
|
||||
这需要更多设计思考。
|
||||
|
||||
1. 橡皮筋滚动,即列表页可以一直向下拉,上面部分像橡皮筋一样可以被拉出空白页的效果。
|
||||
|
||||
在设计手势动画时要考虑三个要点:
|
||||
|
||||
- 使用移动增量作为手势动画的基准点。
|
||||
- 动画和手势应该随时可以被中断,通过 springs 即可实现。
|
||||
- 完成手势后的动画速度应该与手势速度相当,这样视觉体验更自然。
|
||||
|
||||
最后提到了动画兼容性与性能,比如尽量只使用 `transform` 与 `opacity` 可以保证移动端的流畅度,不同移动设备的默认手势效果不同,最好通过 `touch-action` 禁用默认行为以达到更好的兼容性与效果。
|
||||
|
||||
### 唱片与 React
|
||||
|
||||
J.Dash 拥有十年软件开发经验,同时也卖过很多唱片,他介绍了唱片行业与软件开发的共同点。
|
||||
|
||||
唱片行业需要音乐编排能力,这与编码能力类似,都存在良好的设计模式,并且需要团队合作,开发过程中会遇到一些痛苦的经历,但最终完成音乐和项目时都会获得满足的喜悦。
|
||||
|
||||
### 函数式编程
|
||||
|
||||
> Declaratives UIs are the future, and the future is Comonadic. - Phil Freeman
|
||||
|
||||
申明式 UI 是未来,未来则是 Comonadic。
|
||||
|
||||
所谓申明式 UI 可以用下面的公式表达:
|
||||
|
||||
```js
|
||||
type render = (state: State) => View;
|
||||
```
|
||||
|
||||
然后用一段公式介绍了 Comonadic:
|
||||
|
||||
```js
|
||||
class Functor w => Comonad w where
|
||||
extract :: w a -> a
|
||||
duplicate :: w a -> w (w a)
|
||||
extend :: (w a -> a) -> w a -> w b
|
||||
```
|
||||
|
||||
用 JS 版本做一个解释:
|
||||
|
||||
```js
|
||||
const Store = ({ state, render }) => ({
|
||||
extend: f => Store({ state, render: state => f(Store({ state, render })) }),
|
||||
extract: () => render(state)
|
||||
});
|
||||
```
|
||||
|
||||
`extract` 调用后会进行申明式渲染 UI,即 `render(state)`。
|
||||
|
||||
`extend` 表示拓展,接收一个拓展函数作为参数,返回一个新的 Store 对象。这个拓展函数可以拿到 `state`、`render` 并返回新的 `state` 作为 `extract` 时 `render` 的输入。使用例子是这样的:
|
||||
|
||||
```jsx
|
||||
const App = Store({
|
||||
state: { msg: "World" },
|
||||
render: ({ msg }) => <p>Hello {msg}</p>
|
||||
});
|
||||
|
||||
App.extend(({ state }) =>
|
||||
state.msg === "World" ? { msg: "ReactConf" } : state
|
||||
).extract(); // <p> Hello ReactConf </p>
|
||||
```
|
||||
|
||||
然而尴尬的是,笔者看了很久也没看懂 `Store` 函数,最后运行了一下发现这个 Demo 抛出了异常 😂。
|
||||
|
||||
下面是笔者稍微修改后的例子,至少能跑起来:
|
||||
|
||||
```js
|
||||
const Store = ({ state, render }) => ({
|
||||
extend: f => Store({ state, render: state => render(f({ state, render })) }),
|
||||
extract: () => render(state)
|
||||
});
|
||||
|
||||
const app = Store({
|
||||
state: { msg: "Hello World" },
|
||||
render: ({ msg }) => console.log("render " + msg)
|
||||
});
|
||||
|
||||
app
|
||||
.extend(({ state }) => {
|
||||
return { msg: state.msg + " extend1" };
|
||||
})
|
||||
.extend(({ state }) => {
|
||||
return { msg: state.msg + " extend2" };
|
||||
})
|
||||
.extract(); // render Hello World extend2 extend1
|
||||
```
|
||||
|
||||
然而作者的意思仍是未解之谜,希望对函数式了解的同学可以在评论区指点一下。
|
||||
|
||||
### wick editor
|
||||
|
||||
[wick editor](https://www.wickeditor.com/) 是一个开源的动画、游戏制作软件。
|
||||
|
||||
wick editor 是一个动画制作工具,但拓展了一些 js 编程能力,因此可以很好的将动画与游戏结合在一起:
|
||||
|
||||
<img width=300 src="https://img.alicdn.com/tfs/TB1hLJpnbr1gK0jSZR0XXbP8XXa-1766-1002.png">
|
||||
|
||||
演讲介绍了 wick editor 的演化过程:
|
||||
|
||||
从很简陋的 MVP 版本开始(1 周)
|
||||
|
||||
<img width=300 src="https://img.alicdn.com/tfs/TB11sdsneL2gK0jSZFmXXc7iXXa-1192-764.png">
|
||||
|
||||
到 Pre-Alpha(4 月)
|
||||
|
||||
<img width=300 src="https://img.alicdn.com/tfs/TB1TMJnnXY7gK0jSZKzXXaikpXa-1306-858.png">
|
||||
|
||||
Alpha(5 月)
|
||||
|
||||
<img width=300 src="https://img.alicdn.com/tfs/TB1608pnoD1gK0jSZFGXXbd3FXa-1794-1186.png">
|
||||
|
||||
Beta(1.5 年)
|
||||
|
||||
<img width=300 src="https://img.alicdn.com/tfs/TB1CKJpnoD1gK0jSZFGXXbd3FXa-1274-854.png">
|
||||
|
||||
重点是 1.0 版本采用 React 重写了!继 Beta 之后又经历了 1 年:
|
||||
|
||||
<img width=300 src="https://img.alicdn.com/tfs/TB1ZZhrneH2gK0jSZFEXXcqMpXa-906-596.png">
|
||||
|
||||
这个团队最棒的地方是,将游戏与教育结合,针对不同场景做了很多用户调研并根据反馈持续改进。
|
||||
|
||||
### React Select
|
||||
|
||||
[react-select](https://github.com/JedWatson/react-select) 的作者 [Jed Watson](https://github.com/JedWatson) 被请来啦。作为一个看上去很简单组件(select)的开发者,却拥有如此大的关注量(1.8w star),那作者有着怎样的心路历程呢?
|
||||
|
||||
react-select 看似简单的名字背后其实有挺多的功能,比如作者列举了一些功能层面的内容:
|
||||
|
||||
- autocomplete - 输入时搜索。
|
||||
- 单、多选。
|
||||
- focus 管理。
|
||||
- 下拉框层级与位置,比如可以放在根 DOM 节点,也可以作为当前节点的子元素。
|
||||
- 异步下拉框内容。
|
||||
- 键盘、触控。
|
||||
- Createble,即在搜索时如果没有内容可以动态创建。
|
||||
- 等等。
|
||||
|
||||
<img width=300 src="https://img.alicdn.com/tfs/TB1RYS1mubviK0jSZFNXXaApXXa-1166-226.png">
|
||||
|
||||
在设计层面:
|
||||
|
||||
- 申明式。
|
||||
- 可以被定制。
|
||||
- 性能要求。
|
||||
- 等等。
|
||||
|
||||
随着 Star 逐渐上涨,越来越多的需求被提出,核心库代码量越来越大,甚至许多需求之间都是相互冲突的,而且作者每天都会被上百个 Issue 与 PR 吵醒。做一个业务 Select 可能只要 5 分钟,但做一个开源 Select 却要 5 年,原因是一个简单的 Select 如何满足所有不同业务场景?这绝对是个巨大的挑战。
|
||||
|
||||
比如用户即需要受控也要非受控的组件,如何满足好这个需求同时又让代码更可维护呢?
|
||||
|
||||
假设我们拥有一个受控的组件 `SelectComponent`,那么它的主要 props 是 `value` 与 `onChange`,如果要拓展成一个既支持 `defaultValue`(非受控)又支持 `value`(受控)的组件,我们可以创建一个 `manageState` 组件对 `SelectComponent` 进行封装:
|
||||
|
||||
```jsx
|
||||
const manageState = SelectComponent => ({
|
||||
value: valueProps,
|
||||
onChange: onChangeProp,
|
||||
defaultValue,
|
||||
...props
|
||||
}) => {
|
||||
const [valueState, setValue] = useState(defaultValue);
|
||||
|
||||
const value = valueProps !== undefined ? valueProps : valueState;
|
||||
|
||||
const onChange = (newValue, actionMeta) => {
|
||||
if (typeof onChangeProp === "function") {
|
||||
onChangeProp(newValue, actionMeta);
|
||||
}
|
||||
setValue(newValue);
|
||||
};
|
||||
|
||||
return <SelectComponent {...props} value={value} onChange={onChange}>
|
||||
};
|
||||
```
|
||||
|
||||
这样就可以组合为一个受控/非受控的综合 Select 组件:
|
||||
|
||||
```js
|
||||
import BaseSelect from "./Select";
|
||||
import manageState from "./manageState";
|
||||
|
||||
export default manageState(Select);
|
||||
```
|
||||
|
||||
同理对异步的封装也可以放在 `makeAsync` 函数中:
|
||||
|
||||
```jsx
|
||||
const makeAsync = SelectComponent => ({
|
||||
getOptions,
|
||||
defaultOptions,
|
||||
...props
|
||||
}) => {
|
||||
const [options, setOptions] = useState(defaultOptions);
|
||||
const [isLoading, setIsLoading] = useState(false);
|
||||
|
||||
const onInputChange = async newValue => {
|
||||
setIsLoading(true);
|
||||
const newOptions = await getOptions(newValue);
|
||||
setIsLoading(false);
|
||||
setOptions(newOptions);
|
||||
};
|
||||
|
||||
return (
|
||||
<SelectComponent
|
||||
{...props}
|
||||
options={options}
|
||||
isLoading={isLoading}
|
||||
onInputChange={onInputChange}
|
||||
/>
|
||||
);
|
||||
};
|
||||
```
|
||||
|
||||
可以看到,`SelectComponent` 是一个完全受控的数据驱动的 UI,无论是 `manageState` 还是 `makeAsync` 都是对数据处理的拓展,所以这三者之间才可以融洽的组合:
|
||||
|
||||
```js
|
||||
import BaseSelect from "./Select";
|
||||
import manageState from "./manageState";
|
||||
import makeAsync from "./async";
|
||||
|
||||
export default manageState(Select);
|
||||
|
||||
export const AsyncSelect = manageState(makeAsync(Select));
|
||||
```
|
||||
|
||||
后面还有一些风格化、开源协作的思考,这里就不展开了,对这部分感兴趣的同学可以查看原视频了解更多。
|
||||
|
||||
### React + 政府财政透明项目
|
||||
|
||||
usaspending.gov 这个网站使用 React 建设,可以查看美国政府支持财政的明细,通过流畅的体验让更多用户可以了解国家财政支出,进一步推动财政支出的透明化。由于并不涉及前端技术的介绍,主要是产品介绍,因此精读就不详细展开了。
|
||||
|
||||
顺便说一句,智能分析数据就用 [QuickBI](https://www.alibabacloud.com/zh/product/quickbi),QuickBI 是我们团队研发的一款智能 BI 服务平台,如果你将美国政府的财政支持作为数据集输入,你会分析得更透彻。
|
||||
|
||||
### React + 星舰模拟器
|
||||
|
||||
最后介绍的是使用 React 制作的星舰模拟器,看上去像一个游戏:
|
||||
|
||||
<img width=500 src="https://img.alicdn.com/tfs/TB1HrxAneL2gK0jSZPhXXahvXXa-1946-1104.png">
|
||||
|
||||
有星系图、船体、驾驶员信息、武器装备、燃料、通信等等内容。甚至可以模拟太空驾驶,进行任务,可以实时多人协同。对太空迷们的吸引力很大,感兴趣的同学建议直接观看 [视频](https://youtu.be/JDDxR1a15Yo?t=28638)。
|
||||
|
||||
## 3 总结
|
||||
|
||||
第二天的内容非常全面,涉及了 React API、开发者周边、codemod 工具、代码维护、写作/音乐与代码、动画、函数式编程、看似简单的 React 组件、使用 React 制作的各种脑洞大开的项目,等等。
|
||||
|
||||
React Conf 要展示的是一个完整的 React 世界,第一天提到了 React 是一个桥梁,正因为这个桥梁,连接了各行各业不同的人群以及不同的项目,大家都有一个共同的语言:React。
|
||||
|
||||
"We not only react code, but react the world"。
|
||||
|
||||
> 讨论地址是:[精读《React Conf 2019 - Day2》 · Issue #217 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/217)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -1,6 +1,6 @@
|
||||
# 1 引言
|
||||
|
||||
<img src="assets/13/logo.jpeg" width="500" alt="logo" />
|
||||
<img src="https://img.alicdn.com/imgextra/i2/O1CN014VGV7a1x3ILYqK9OD_!!6000000006387-2-tps-1024-732.png" width="500" alt="logo" />
|
||||
|
||||
javascript 的 this 是个头痛的话题,本期精读的文章更是引出了一个观点,避免使用 this。我们来看看是否有道理。
|
||||
|
||||
@@ -53,7 +53,7 @@ getName(person3) // Name: Sarah Doe
|
||||
getGreetingCallback(person3)('Jeff') // Hello Jeff, I'm Sarah Doe
|
||||
```
|
||||
|
||||
<img src="assets/13/1.png" width="500" alt="demo1" />
|
||||
<img src="https://img.alicdn.com/imgextra/i3/O1CN017Kw37u1oOyYHXGlqC_!!6000000005216-2-tps-1338-338.png" width="500" alt="demo1" />
|
||||
|
||||
这样 person 实例是个纯对象,没有将方法挂载到原型链上,简单易懂。
|
||||
|
||||
@@ -215,7 +215,7 @@ var bar = foo.bind(obj)
|
||||
bar()
|
||||
```
|
||||
|
||||
### 3.2.2 es6绑定
|
||||
### 3.2.2 es6 绑定
|
||||
|
||||
这种情况类似使用箭头函数创建成员变量,以下方式等于创建了没有挂载到原型链的匿名函数,因此 this 不会丢失。
|
||||
|
||||
@@ -0,0 +1,262 @@
|
||||
## 1 引言
|
||||
|
||||
搭配了合适的设计模式的代码,才可拥有良好的可维护性,[The Benefits of Orthogonal React Components](https://dmitripavlutin.com/orthogonal-react-components/) 这篇文章就重点介绍了正交性原理。
|
||||
|
||||
所谓正交,即模块之间不会相互影响。想象一个音响的音量与换台按钮间如果不是正交关系,控制音量同时可能影响换台,这样的设备很难维护:
|
||||
|
||||
<img width=400 src="https://img.alicdn.com/tfs/TB1dczIpQL0gK0jSZFtXXXQCXXa-1000-993.png">
|
||||
|
||||
前端代码也一样,UI 与数据处理逻辑分离就是一种符合正交原则的设计,这样有利于长期代码质量维护。
|
||||
|
||||
## 2 概述
|
||||
|
||||
一个拥有良好正交性的 React App 会按照如下模块分离设计:
|
||||
|
||||
1. UI 元素(展示型组件)。
|
||||
2. 取数逻辑(fetch library, REST or GraphQL)。
|
||||
3. 全局状态管理(redux)。
|
||||
4. 持久化(local storage, cookies)。
|
||||
|
||||
文中通过两个例子说明。
|
||||
|
||||
### 让组件与取数逻辑正交
|
||||
|
||||
比如一个展示雇员列表组件 `<EmployeesPage>`:
|
||||
|
||||
```jsx
|
||||
import React, { useState } from "react";
|
||||
import axios from "axios";
|
||||
import EmployeesList from "./EmployeesList";
|
||||
|
||||
function EmployeesPage() {
|
||||
const [isFetching, setFetching] = useState(false);
|
||||
const [employees, setEmployees] = useState([]);
|
||||
|
||||
useEffect(function fetch() {
|
||||
(async function() {
|
||||
setFetching(true);
|
||||
const response = await axios.get("/employees");
|
||||
setEmployees(response.data);
|
||||
setFetching(false);
|
||||
})();
|
||||
}, []);
|
||||
|
||||
if (isFetching) {
|
||||
return <div>Fetching employees....</div>;
|
||||
}
|
||||
return <EmployeesList employees={employees} />;
|
||||
}
|
||||
```
|
||||
|
||||
这样设计看上去没问题,但其实违背了正交原则,因为 `EmployeesPage` 既负责渲染 UI 又关心取数逻辑。正交的写法如下:
|
||||
|
||||
```jsx
|
||||
import React, { Suspense } from "react";
|
||||
import EmployeesList from "./EmployeesList";
|
||||
|
||||
function EmployeesPage({ resource }) {
|
||||
return (
|
||||
<Suspense fallback={<h1>Fetching employees....</h1>}>
|
||||
<EmployeesFetch resource={resource} />
|
||||
</Suspense>
|
||||
);
|
||||
}
|
||||
|
||||
function EmployeesFetch({ resource }) {
|
||||
const employees = resource.employees.read();
|
||||
return <EmployeesList employees={employees} />;
|
||||
}
|
||||
```
|
||||
|
||||
**`Suspense` 将 loading 状态剥离到父级组件,因此子组件只需要关心如何用数据,不需关心如何取数据(以及 loading 态)。**
|
||||
|
||||
### 让组件与滚动监听正交
|
||||
|
||||
比如一个滚动到一定距离就出现 "jump to top" 的组件 `<ScrollToTop>`,可能会这么实现:
|
||||
|
||||
```jsx
|
||||
import React, { useState, useEffect } from "react";
|
||||
|
||||
const DISTANCE = 500;
|
||||
|
||||
function ScrollToTop() {
|
||||
const [crossed, setCrossed] = useState(false);
|
||||
|
||||
useEffect(function() {
|
||||
const handler = () => setCrossed(window.scrollY > DISTANCE);
|
||||
handler();
|
||||
window.addEventListener("scroll", handler);
|
||||
return () => window.removeEventListener("scroll", handler);
|
||||
}, []);
|
||||
|
||||
function onClick() {
|
||||
window.scrollTo({
|
||||
top: 0,
|
||||
behavior: "smooth"
|
||||
});
|
||||
}
|
||||
|
||||
if (!crossed) {
|
||||
return null;
|
||||
}
|
||||
return <button onClick={onClick}>Jump to top</button>;
|
||||
}
|
||||
```
|
||||
|
||||
可以看到,在这个组件中,按钮与滚动状态判断逻辑混合在了一起。如果我们将 “滚动到一定距离就渲染 UI” 抽象成通用组件 `IfScrollCrossed` 呢?
|
||||
|
||||
```jsx
|
||||
import { useState, useEffect } from "react";
|
||||
|
||||
function useScrollDistance(distance) {
|
||||
const [crossed, setCrossed] = useState(false);
|
||||
|
||||
useEffect(
|
||||
function() {
|
||||
const handler = () => setCrossed(window.scrollY > distance);
|
||||
handler();
|
||||
window.addEventListener("scroll", handler);
|
||||
return () => window.removeEventListener("scroll", handler);
|
||||
},
|
||||
[distance]
|
||||
);
|
||||
|
||||
return crossed;
|
||||
}
|
||||
|
||||
function IfScrollCrossed({ children, distance }) {
|
||||
const isBottom = useScrollDistance(distance);
|
||||
return isBottom ? children : null;
|
||||
}
|
||||
```
|
||||
|
||||
有了 `IfScrollCrossed`,我们就能专注写 “点击按钮跳转到顶部” 这个 UI 组件了:
|
||||
|
||||
```jsx
|
||||
function onClick() {
|
||||
window.scrollTo({
|
||||
top: 0,
|
||||
behavior: "smooth"
|
||||
});
|
||||
}
|
||||
|
||||
function JumpToTop() {
|
||||
return <button onClick={onClick}>Jump to top</button>;
|
||||
}
|
||||
```
|
||||
|
||||
最后将他们拼装在一起:
|
||||
|
||||
```jsx
|
||||
import React from "react";
|
||||
|
||||
// ...
|
||||
|
||||
const DISTANCE = 500;
|
||||
|
||||
function MyComponent() {
|
||||
// ...
|
||||
return (
|
||||
<IfScrollCrossed distance={DISTANCE}>
|
||||
<JumpToTop />
|
||||
</IfScrollCrossed>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
这么做,我们的 `<JumpToTop>` 与 `<IfScrollCrossed>` 组件就是正交关系,而且逻辑更清晰。不仅如此,这样的抽象使 `<IfScrollCrossed>` 可以被其他场景复用:
|
||||
|
||||
```jsx
|
||||
import React from "react";
|
||||
|
||||
// ...
|
||||
|
||||
const DISTANCE_NEWSLETTER = 300;
|
||||
|
||||
function OtherComponent() {
|
||||
// ...
|
||||
return (
|
||||
<IfScrollCrossed distance={DISTANCE_NEWSLETTER}>
|
||||
<SubscribeToNewsletterForm />
|
||||
</IfScrollCrossed>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
### Main 组件
|
||||
|
||||
上面例子中,`<MyComponent>` 就是一个 Main 组件,Main 组件封装一些脏逻辑,即它要负责不同模块的组装,而这些模块之间不需要知道彼此的存在。
|
||||
|
||||
一个应用会存在多个 Main 组件,它们负责拼装各种作用域下的脏逻辑。
|
||||
|
||||
### 正交设计的好处
|
||||
|
||||
- **容易维护:** 正交组件逻辑相互隔离,不用担心连带影响,因此可以放心大胆的维护单个组件。
|
||||
- **易读:** 由于逻辑分离导致了抽象,因此每个模块做的事情都相对单一,很容易猜测一个组件做的事情。
|
||||
- **可测试:** 由于逻辑分离,可以采取逐个击破的思路进行单测。
|
||||
|
||||
### 权衡
|
||||
|
||||
如果不采用正交设计,因为模块之间的关联导致应用最终变得难以维护。但如果将正交设计应用到极致,可能会多处许多不必要的抽象,这些抽象的复用仅此一次,造成过度设计。
|
||||
|
||||
## 3 精读
|
||||
|
||||
正交设计一定程度可以理解为合理抽象,完全不抽象与过度抽象都是不可取的,因此列举了四块需要抽象的要点:UI 元素、取数逻辑、全局状态管理、持久化。
|
||||
|
||||
全局状态管理注入到组件,就是一种正交的抽象模式,即组件不用关心数据从哪来,而直接使用数据,而数据管理完全交由数据流层管理。
|
||||
|
||||
取数逻辑往往是可能被忽略的一环,无论是像原文中直接关心到 `fetch` 方法的 UI 组件,还是利用取数工具库关心了 `loading` 状态:
|
||||
|
||||
```jsx
|
||||
import useSWR from "swr";
|
||||
|
||||
function Profile() {
|
||||
const { data, error } = useSWR("/api/user", fetcher);
|
||||
|
||||
if (error) return <div>failed to load</div>;
|
||||
if (!data) return <div>loading...</div>;
|
||||
return <div>hello {data.name}!</div>;
|
||||
}
|
||||
```
|
||||
|
||||
虽然将取数生命周期封装到自定义 hook `useSWR` 中,但 `error` 信息对 UI 组件来说就是一个脏数据:**这让这个 UI 组件不仅要渲染数据,还要担心取数是否会失败,或者是否在 loading 中。**
|
||||
|
||||
好在 Suspense 模式解决了这个问题:
|
||||
|
||||
```jsx
|
||||
import { Suspense } from "react";
|
||||
import useSWR from "swr";
|
||||
|
||||
function Profile() {
|
||||
const { data } = useSWR("/api/user", fetcher, { suspense: true });
|
||||
return <div>hello, {data.name}</div>;
|
||||
}
|
||||
|
||||
function App() {
|
||||
return (
|
||||
<Suspense fallback={<div>loading...</div>}>
|
||||
<Profile />
|
||||
</Suspense>
|
||||
);
|
||||
}
|
||||
```
|
||||
|
||||
这样 `<Profile>` 只要专注于做数据渲染,而不用担心 `useSWR('/api/user', fetcher, { suspense: true })` 这个取数过程发生了什么、是否取数失败、是否在 `loading` 中。因为取数状态由 `Suspense` 管理,而取数是否意外失败由 `ErrorBoundary` 管理。
|
||||
|
||||
合理的抽象使组件逻辑变得更简单,从而组件嵌套使用使不用担心额外影响。尤其在大型项目中,不要担心正交抽象会使本来就很多的模块数量再次膨胀,因为相比于维护 100 个相互影响,内部逻辑复杂的模块,维护 200 个职责清晰,相互隔离的模块也许会更轻松。
|
||||
|
||||
## 4 总结
|
||||
|
||||
从正交设计角度来看,`Hooks` 解决了状态管理与 UI 分离的问题,`Suspense` 解决了取数状态与 UI 分离的问题,`ErrorBoundary` 解决了异常与 UI 分离的问题。
|
||||
|
||||
在你看来,React 还有哪些逻辑需要与 UI 分离?分别使用哪些方法呢?欢迎留言。
|
||||
|
||||
> 讨论地址是:[精读《正交的 React 组件》 · Issue #221 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/221)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||
@@ -0,0 +1,207 @@
|
||||
## 1 引言
|
||||
|
||||
[尤雨溪](https://github.com/yyx990803) 在 2019 JSConf 的分享 [Seeking the Balance in Framework Design](https://www.youtube.com/watch?v=ANtSWq-zI0s) 十分精彩,道出了如何进行合理的前端框架设计与框架选型。
|
||||
|
||||
正如所说,框架对比不能只停留在 Star 数量、Npm 下载量、Stackoverflow 问题量这些简单的数据对比,而要深入到技术细节进行比较。比较框架有多种不同维度,这次分享就从服务范围、渲染机制、状态机制这三个维度进行对比。
|
||||
|
||||
## 2 概述
|
||||
|
||||
这次分享的精彩之处在于不偏不倚的站在客观立场分析了框架各维度好的一面与坏的一面,从中我们不仅能学习到一些框架知识,还能培养思辨能力。
|
||||
|
||||
### 服务范围
|
||||
|
||||
服务范围是个比较难翻译的单词,在原 PPT 中用了 “Scope” 这个单词表示,可以理解为 “作用域、框架的承诺功能范围、服务配套齐全程度”。比如提供的是一个工具库还是整体框架,插件管理是集中式还是依赖生态。
|
||||
|
||||
React 是典型的小服务范围框架,核心包只实现了基本功能,而其他生态基本靠社区拓展;Angular 是典型大服务范围框架,官方对所有业务场景都做了最佳实践能力覆盖;Vue 处在中间区域,通过功能分层,既拥有小服务范围的能力,又可以搭配官方插件实现更多场景化能力。
|
||||
|
||||
#### 小服务范围优势
|
||||
|
||||
**概念少,易上手**
|
||||
|
||||
小的服务范围代表了小的学习成本,因为暴露的基本能力较少,概念也会比较少,对新人上手比较友好。
|
||||
|
||||
**生态繁荣,百花齐放**
|
||||
|
||||
由于很多功能没有被官方实现,社区就有机会填补这些空白,因此会冒出许多第三方库,而且一旦做得好,就有机会成为 “事实标准”,因此开发者会更加积极参与到社区开发,自己做的框架 “上升空间” 也非常大。
|
||||
|
||||
同时,社区的力量会导致多元化,因此整体生态完整度与创新性都会非常亮眼,而且具有持续迭代的能力。
|
||||
|
||||
**核心维护成本低**
|
||||
|
||||
官方维护的核心代码较少,因此维护成本大大降低,而且官方可以将精力放在更多核心能力增强上,比如 Suspense 等,而不是将精力消耗在生态插件上。
|
||||
|
||||
#### 小服务范围的劣势
|
||||
|
||||
**复杂场景要引入新概念**
|
||||
|
||||
复杂场景无法支持时,就要引入新的概念解决,这导致后续技术选型可能产生分歧,并带来持续的新概念理解成本。
|
||||
|
||||
**非官方的开发模式逐渐产生**
|
||||
|
||||
随着时间的流逝,会逐渐涌出一些新的设计模式,成为当下几乎是必不可少的方案,但却不会出现在官方文档中,造成选型时的疑惑。Redux 就是一个例子。
|
||||
|
||||
**生态变化快,碎片化且持续流失**
|
||||
|
||||
非官方的生态也意味着不稳定,而且缺乏统一的管理,碎片化的模块之间可能经常出现不兼容的问题。
|
||||
|
||||
而且任何模块都可能被时代无情的淘汰,就像 Flux 到 Redux 再到 Hooks,带来额外的迁移成本和认知成本。谁也不希望自己的项目架构 “变得过时”,或者随时面临被新架构取代的风险,但第三方社区几乎一定代表未来会出现一种模式取代现有模式,只是时间早晚而已。
|
||||
|
||||
#### 大服务范围的优势
|
||||
|
||||
**大部分业务场景都被内置解决**
|
||||
|
||||
减少不必要的技术方案调研与纷争,大服务范围的框架内置的方案就能解决几乎 100% 业务问题,团队再也不会为通用架构问题烦恼了。
|
||||
|
||||
**生态稳定、连贯**
|
||||
|
||||
稳定是指,官方维护作为背书,几乎不会存在一些生态包突然不维护、与已有版本不兼容、被植入恶意程序等等意外情况。
|
||||
|
||||
连贯是指,官方会统一考虑一个改动在所有生态插件造成的影响,并以一个最合理的思路做整体改造,生态包无论是接口还是兼容性都不需要担心,设计思路也会一脉相承。
|
||||
|
||||
#### 大服务范围的劣势
|
||||
|
||||
**前期上手成本高**
|
||||
|
||||
全家桶的概念导致上手难度偏高,因为必须理解所有内置概念后才能开始项目。
|
||||
|
||||
**如果内置模块无法满足业务,会觉得有些死板**
|
||||
|
||||
一旦发生内置功能无法满足业务的场景,就很难拓展了,因为 all in one 的思路本质上就是排斥自定义拓展的,这点从 [angular-cli](https://github.com/angular/angular-cli) 就能看出来。
|
||||
|
||||
之所以觉得死板,是因为这种情况没办法用优雅的方式解决,只能在现有约束的框架内通过某些 “Hack” 方式解决,自然会有种死板的感觉。
|
||||
|
||||
#### 中等服务范围的优势
|
||||
|
||||
**分层设计,允许新特性渐进加入**
|
||||
|
||||
Vue 通过分层设计做到了折中,即官方还是会维护生态,只不过生态不是必须的,可以按需使用。这样做的好处是兼顾了一些优势。
|
||||
|
||||
**低学习门槛**
|
||||
|
||||
与小服务范围框架一样,对于核心包来说学习成本都比较低。
|
||||
|
||||
**依然有最佳实践解决所有业务问题**
|
||||
|
||||
和大服务范围框架一样,拥有全套官方最佳实践,但不内置,不强求一定要使用,因此你可以按需使用。
|
||||
|
||||
#### 中等服务范围的劣势
|
||||
|
||||
**维护成本高**
|
||||
|
||||
和大服务范围框架一样,虽然生态不强求,但毕竟官方还是要持续维护的,因此维护成本高的问题依然存在。
|
||||
|
||||
**生态多样性不高**
|
||||
|
||||
虽然生态是按需的,但毕竟中等服务范围的框架官方会实现一套标准生态插件,这会极大影响社区生态的发展空间,导致 “非官方插件没人愿意做”,因此生态多样性会差一些。
|
||||
|
||||
### 渲染机制
|
||||
|
||||
渲染机制区别主要在 JSX vs Template 之间,不同的表达方式之间还是存在一些很本质的区别,然而正如一开始所说,无法一言蔽之,必须从多个角度拆解的看。
|
||||
|
||||
#### JSX 的优势
|
||||
|
||||
**纯 JS 表达 UI**
|
||||
|
||||
单这一点就非常重要了,满足了 All In Js 的幻想。毕竟 Html、Css 相比 Js 来说,模块化能力和灵活性都很弱,将其都收敛到 Js 不仅表达方式更统一,更重要的是都获得了与 Js 一样的模块化、灵活性、Typescript 支持等能力。
|
||||
|
||||
**视图即数据**
|
||||
|
||||
将视图看作一种数据,让针对视图的逻辑测试成为可能。
|
||||
|
||||
同时也将视图概念泛化了,因为数据是平台无关的,一份描述视图的 DSL 可以运行在任何平台。
|
||||
|
||||
#### JSX 的劣势
|
||||
|
||||
**开销大**
|
||||
|
||||
页面节点越多,Diff 开销就越大。
|
||||
|
||||
**动态渲染很难性能优化**
|
||||
|
||||
由于所有 DOM 节点都是动态生成,因此无法根据初始状态结构进行安全的优化。相比之下,Template 模式可以确定哪部分属于变量,哪部分是固定的,对固定部分的 Diff 检测都可以跳过。
|
||||
|
||||
**动态调度虽然改善了性能,但依赖更重的运行时**
|
||||
|
||||
React ConcurrentMode 是一个调度优化器,但实现的逻辑也比较复杂,加重了运行时负担。
|
||||
|
||||
#### Template 的优势
|
||||
|
||||
**原生性能**
|
||||
|
||||
由于 Template 对节点进行直接渲染,因此与原生性能一致。
|
||||
|
||||
**Runtime 更小**
|
||||
|
||||
由于不需要额外优化,运行时代码会小很多。
|
||||
|
||||
#### Template 的劣势
|
||||
|
||||
**被 Template 语法约束,且无法拓展**
|
||||
|
||||
对于 Template 不支持的,只能选择接受,因为除了框架自己,没有人能拓展 Template 的特性。当遇到一些非常动态场景,但 Template 不支持的情况,只能选择接受,并用比较 Hack 的方式绕过解决,除此之外别无他法。
|
||||
|
||||
**模版冗长**
|
||||
|
||||
JSX 可以利用循环语句或者变量赋值进行模版区块的复用,但 Template 模式每次新模版都要一行一行的打出来,这种冗长的开发体验不太友好。
|
||||
|
||||
**运行时解析开销或者依赖编译期逻辑**
|
||||
|
||||
要么通过编译器预先生成 AST,要么运行时动态将 Template 解析成 AST,无论哪种方案都有额外的开销,一种是工程依赖的开销,一种是运行时动态解析的性能开销。
|
||||
|
||||
#### VDom + Template 的特色
|
||||
|
||||
Vue 在 Template 基础上支持了虚拟 DOM,因此兼具两者特色。
|
||||
|
||||
性能上,在编译时就进行 AST 解析,减少了运行时解析开销。
|
||||
|
||||
功能上,支持模版与 JSX 两种语法。
|
||||
|
||||
### 状态机制
|
||||
|
||||
状态机制 [尤雨溪](https://github.com/yyx990803) 在 JSConf 提到要单独拆出来讲,因为内容较多,时间可能不够,本次精读也限于篇幅原因略过:
|
||||
|
||||
- Mutable vs Immutable。
|
||||
- 依赖追踪 vs 脏检测。
|
||||
- 响应式 vs 模拟响应式。
|
||||
|
||||
显然,状态机制方案更是仁者见仁智者见智的事情,同样得从多个维度进行独立分析,并根据实际业务场景具体选择。
|
||||
|
||||
最后,意识到没有一个绝对均衡的框架设计方案,因为在工程领域,没有最好只有更好。
|
||||
|
||||
## 3 精读
|
||||
|
||||
我们再延伸谈一谈为什么框架设计要寻找平衡点。
|
||||
|
||||
**框架设计没有银弹**
|
||||
|
||||
与数学公式不同,框架设计甚至整个工程技术设计都没有所谓的真理,所谓条条大路通罗马,实现同一个技术目标的众多方案之间也许就是平行关系,可以根据不同维度列出一二三的对比,但无法得出一个总的结论,孰优孰劣。
|
||||
|
||||
**使用场景不同**
|
||||
|
||||
不同使用场景决定了对框架诉求的不同。
|
||||
|
||||
比如开发非常定制、炫酷的可视化大屏,那么前端开发框架基本也用不上,因为关注点不会聚焦在项目路由、UI 描述、甚至是数据流,而是聚焦在性能、图形渲染等问题。解决这些领域的框架可能是 虚幻 4、Unity 等游戏引擎,但普通的前端开发框架绝不会涉足这种领域,框架一定要确定自己功能范围。
|
||||
|
||||
即便仅局限在 Web 领域,也需要考虑是否要支持非 Web 场景,那么将 HTML 抽象成一个通用 DSL 就可能是一种选择,但非 Web 领域毕竟不是主打业务领域,在这种业务场景周边生态维护可能就比较少,这也是需要取舍的地方。
|
||||
|
||||
**使用的人不同**
|
||||
|
||||
不同团队对框架的要求也不同。
|
||||
|
||||
刚起步的小团队可能更需要保姆式的框架,因为这样最节省人力成本。对于规模较大的团队,希望对框架拥有较大定制能力时,小服务范围的框架可能更受青睐。当然框架作者可以像 Vue 一样做出渐进式官方能力增强方案,以此满足不同需求的用户,但毕竟也不能将生态完全交给社区,还是要做取舍。
|
||||
|
||||
所以当遇到更新更酷的框架时,需要冷静思考的不只是这个框架带来的收益与花费的迁移成本哪个更高,以及团队能否接受这套框架的开发习惯,更需要思考的是这个框架自身做了哪些权衡,如果这些权衡与 React、Vue、Angular 类似,那么仅仅变化了语法或者语言的改动其实意义不大,此时需要慎重考虑。
|
||||
|
||||
## 4 总结
|
||||
|
||||
这次没有提到的状态机制对比,你能分别列举出优缺点吗?欢迎留言。
|
||||
|
||||
> 讨论地址是:[精读《寻找框架设计的平衡点》 · Issue #223 · dt-fe/weekly](https://github.com/dt-fe/weekly/issues/223)
|
||||
|
||||
**如果你想参与讨论,请 [点击这里](https://github.com/dt-fe/weekly),每周都有新的主题,周末或周一发布。前端精读 - 帮你筛选靠谱的内容。**
|
||||
|
||||
> 关注 **前端精读微信公众号**
|
||||
|
||||
<img width=200 src="https://img.alicdn.com/tfs/TB165W0MCzqK1RjSZFLXXcn2XXa-258-258.jpg">
|
||||
|
||||
> 版权声明:自由转载-非商用-非衍生-保持署名([创意共享 3.0 许可证](https://creativecommons.org/licenses/by-nc-nd/3.0/deed.zh))
|
||||